

Përshëndetje, Habr.
Së fundi kam në lidhje me parametrat që ne si ekip shpesh përdorim për Kafka Producer dhe Consumer, për t'u afruar me dorëzimin e garantuar. Në këtë artikull dëshiroj të tregoj se si organizuam riprocesimin e një ngjarjeje të marrë nga Kafka, si rezultat i papërshtatshmërisë së një sistemi të jashtëm.
Aplikacionet moderne funksionojnë në një mjedis shumë të komplikuar. Logjika e biznesit, e mbështjellë në një grumbull teknologjik modern, që punon në një imazh Docker, i menaxhuar nga një orkestrator si Kubernetes ose OpenShift, dhe që komunikon me aplikacione të tjera ose zgjidhje enterprise përmes një vargu ruterash fizik dhe virtual. Në një mjedis të tillë, gjithmonë mund të ndodhin probleme, prandaj riprocesimi i ngjarjeve në rastin e papërshtatshmërisë së një prej sistemeve të jashtme është një pjesë e rëndësishme e proceseve tona të biznesit.
Si ishte para Kafka
Më parë në projekt, ne përdorim IBM MQ për dorëzimin e mesazheve në mënyrë asinkrone. Kur ndodhte ndonjë gabim gjatë punës së shërbimit, mesazhi i marrë mund të vendosej në radhën e mesazheve të vdekura (DLQ) për shqyrtim të mëtejshëm. DLQ krijohej pranë radhës hyrëse, dhe kalimi i mesazhit ndodhte brenda IBM MQ.
Nëse gabimi kishte një natyrë të përkohshme dhe ne mund ta përcaktonim këtë (për shembull, ResourceAccessException gjatë një thirrjeje HTTP ose MongoTimeoutException gjatë një kërkese në MongoDb), atëherë strategjia e ripërsëritjeve hynte në fuqi. Pavarësisht nga ndarjet e logjikës së aplikacionit, mesazhi i origjinës transferohej ose në radhën sistemike për dërgim të vonuar, ose në një aplikacion të veçantë, i cili u krijua vite më parë për ripërsëritjen e mesazheve. Në këtë rast, në kokën e mesazhit shkruhej numri i ripërsëritjes, i lidhur me intervalin e vonesës ose me fundin e strategjisë në nivelin e aplikacionit. Nëse arrijmë fundin e strategjisë, por sistemi i jashtëm ende nuk është i disponueshëm, atëherë mesazhi do të vendoset në DLQ për shqyrtim manual.
Kërkimi i zgjidhjes
, mund të gjejmë këtë . Nëse e shkurtojmë, propozohet të krijohet një temë për çdo interval vonese dhe të implementohen në anën e aplikacionit Consumer që do të lexojnë mesazhet me vonesën e nevojshme.
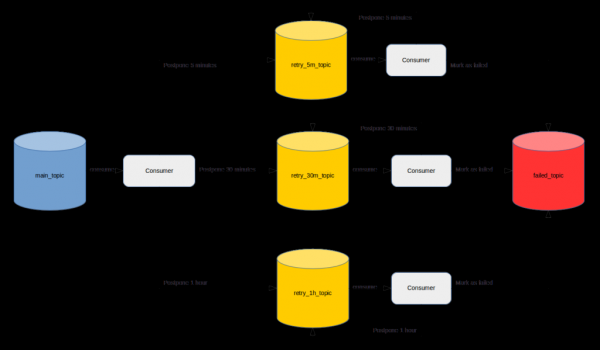
Megjithëse ka një numër të madh komentesh pozitive, më duket se nuk është krejtësisht e suksesshme. Së pari, sepse zhvilluesi, përveç realizimit të kërkesave të biznesit, do të duhet të shpenzojë shumë kohë për të realizuar mekanizmin e përshkruar.
Për më tepër, nëse menaxhimi i qasjes është i aktivizuar në klasterin Kafka, do t'i duhet të investojë një kohë për të krijuar temat dhe për të siguruar qasjet e nevojshme për to. Në përveçim të kësaj, do të duhet të zgjidhni parametrin e duhur retention.ms për çdo nga temat e riprovimit, në mënyrë që mesazhet të dërgohen përsëri dhe të mos humbasin. Zbatimi dhe kërkesa e qasjeve do të duhet të përsëritet për çdo shërbim ekzistues ose të ri.
Tani le të shohim se cilat mekanizma për përpunimin e përsëritur të mesazheve na ofron spring-i në përgjithësi dhe spring-kafka në veçanti. Spring-kafka ka një varësi tranzitive mbi spring-retry, i cili ofron abstraksione për menaxhimin e politikat e BackOff. Kjo është një mjet mjaft fleksibël, por një nga disavantazhet e tij të rëndësishme është ruajtja e mesazheve për ripërpunim në memorjen e aplikacionit. Kjo do të thotë se rinisja e aplikacionit për shkak të azhurnimit ose gabimeve gjatë përdorimit do të çojë në humbjen e të gjithë mesazheve që presin për ripërpunim. Duke qenë se ky pikë është kritik për sistemin tonë, ne nuk e konsideruam më tej.
Vetë spring-kafka ofron disa zbatime të ContainerAwareErrorHandler, për shembull, , me ndihmën e së cilës mund të përpunoni një mesazh më vonë pa ndërruar offset në rast gabimi. Prej versionit spring-kafka 2.3, është bërë e mundur të përcaktojnë BackOffPolicy.
Ky qasje lejon që mesazhet që ripërpunohen të përjetojnë rinisjen e aplikacionit, por mekanizmi DLQ ende mungon. Ky variant ishte ai që ne zgjodhëm në fillim të vitit 2019, duke qenë optimist se DLQ nuk do të ishte e nevojshme (na ndihmoi dhe me të vërtetë nuk u nevojit për disa muaj shfrytëzimi të aplikacionit me një sistem të tillë të ripërpunimit). Gabimet temporale çonin në aktivizimin e SeekToCurrentErrorHandler. Gabimet e tjera shfaqeshin në log, çonin në ndërrimin e offset, dhe përpunimi vazhdonte me mesazhin tjetër.
Zgjidhja përfundimtare
Implementimi i bazuar në SeekToCurrentErrorHandler na shtyu të zhvillonim një mekanizëm të vetin për ri-dërgimin e mesazheve.
Së pari, ne doja të shfrytëzojmë përvojën ekzistuese dhe ta zgjeronim atë në varësi të logjikës së aplikacionit. Për një aplikacion me logjikë lineare, optimale do të ishte të ndalosh leximin e mesazheve të reja për një periudhë të vogël kohore, të caktuar në kuadër të strategjisë së ri-thirrjeve. Për aplikacionet e tjera, do të dëshironim të kishim një pikë të vetme që do të garantonte përmbushjen e strategjisë së ri-thirrjeve. Përveç kësaj, kjo pikë e vetme duhet të ketë funksionalitetin e DLQ për të dyja qasjet.
Strategjia e ri-thirrjeve duhet të ruhet në aplikacionin që përgjigjet për të marrë intervalin e ardhshëm në rast të një gabimi të përkohshëm.
Ndalesa e Consumer-it për një aplikacion me logjikë lineare
Kur punoni me spring-kafka, kodi për ndalimin e Consumer-it mund të duket diçka si kjo:
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // në DLQ
    }
Në shembullin e mësipërm, retryAt është koha kur duhet të rifilloni MessageListenerContainer-n, nëse ai është ende duke punuar. Rihapja do të ndodhë në një thread të veçantë, i nisur në TaskScheduler, implementimin e të cilit gjithashtu e ofron spring.
Vlera retryAt ne e gjejmë në këtë mënyrë:
- Kërkohet vlera e numëruesit të ri-thirrjeve.
- Në përputhje me vlerën e numëruesit, kërkohet intervali aktual i vonesës në strategjinë e ri-thirrjeve. Strategjia shpallet brenda aplikacionit, për ruajtjen e saj ne zgjodhëm formatin JSON.
- Intervali i gjetur në masivin JSON përmban numrin e sekondave, pas të cilave do të duhet të përsëritet përpunimi. Ky numër sekondash shtohet në kohën aktuale, duke formuar vlerën për retryAt.
- Nëse intervali nuk gjendet, atëherë vlera retryAt është null dhe mesazhi do të dërgohet në DLQ për shqyrtim manual.
Me këtij qasje, mbetet vetëm të ruhet numri i përpjekjeve për çdo mesazh që është tani në procesim, për shembull në memorien e aplikacionit. Ruajtja e numrit të përpjekjeve në memorien e aplikacionit nuk është kritike për këtë qasje, pasi aplikacioni me logjikë lineare nuk mund të përpunojë gjithçka. Në krahasim me spring-retry, riparagjykimi i aplikacionit nuk do të çojë në humbjen e të gjitha mesazheve për ripërpunim, por thjesht në rinisjen e strategjisë.
Kjo qasje ndihmon në lehtësimin e ngarkesës nga sistemi i jashtëm, i cili mund të jetë i paaksesueshëm për shkak të ngarkesës shumë të madhe. Në fjalë të tjera, përveç ripërpunimit, kemi arritur në implementimin e modelit .
Në rastin tonë, pragu i gabimit është vetëm 1, dhe për të minimizuar kohën e vonesës së sistemit për shkak të një ndërprerjeje të përkohshme rrjetore, ne përdorim një strategji shumë granulare të përpjekjeve të ripërsëritura me intervale të vogla vonese. Kjo mund të mos jetë e përshtatshme për të gjitha aplikacionet e grupit, prandaj raporti midis pragut të gabimit dhe madhësisë së intervalit duhet të përcaktohet duke u bazuar në karakteristikat e sistemit.
Një aplikacion të veçantë për të përpunuar mesazhet nga aplikacionet me logjikë të pabesueshme
Ja një shembull kodi që dërgon një mesazh në një aplikacion të tillë (Retryer), i cili do të kryejë ripërsëritjen në temën DESTINATION kur të arrijë koha RETRY_AT:
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
Nga shembulli duket se shumë informacion përcillet në header. Vlera RETRY_AT është e njëjtë si për mekanizmin e përsëritjes përmes ndalimit të Consumer’it. Përveç DESTINATION dhe RETRY_AT, ne kalojmë:
- GROUP_ID, për të cilin grupohen mesazhet për analizë manuale dhe thjeshtim të kërkimit.
- ORIGINAL_PARTITION, për të ruajtur të njëjtin Consumer për ripërpunim. Ky parametr mund të jetë null, në këtë rast particion i ri do të merret nga çelësi record.key() i mesazhit origjinal.
- Vlera e përditësuar COUNTER, për të ndjekur strategjinë e ripërsëritjeve.
- SEND_TO — konstant, që tregon nëse mesazhi duhet të dërgohet për ripërpunim kur arrihet RETRY_AT ose të vendoset në DLQ.
- REASON — arsyeja për të cilën përpunimi i mesazhit u ndërpre.
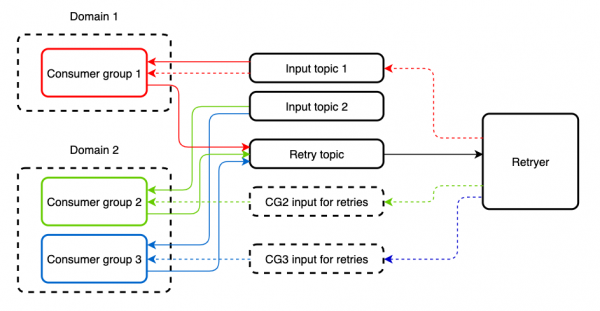
Retryer ruan mesazhet për dërgim të ripërsëritur dhe analizë manuale në PostgreSQL. Një detyrë aktivizohet sipas orarit që gjen mesazhet me RETRY_AT të kaluar dhe i dërgon ato përsëri në particionin ORIGINAL_PARTITION të temës DESTINATION me çelësin record.key().
Pas dërgimit të mesazheve, ato fshihen nga PostgreSQL. Analiza manuale e mesazheve ndodh në një UI të thjeshtë, e cila ndërvepron me Retryer përmes REST API. Karakteristikat e tij kryesore janë dërgimi përsëri ose fshirja e mesazheve nga DLQ, shikimi i informacionit për gabimin dhe kërkimi i mesazheve, për shembull, sipas emrit të gabimit.
Duke qenë se në klasteret tona është aktivizuar menaxhimi i qasjes, është e nevojshme që të kërkohet qasje shtesë në temën që dëgjon Retryer, dhe t'i jepet mundësia Retryer të shkruajë në temën DESTINATION. Kjo është e pakëndshme, por, ndryshe nga qasja me temën në interval, ne kemi një DLQ të plotë dhe një UI për menaxhimin e saj.
Ka raste kur tema hyrëse lexohet nga disa grupe të ndryshme konsumatore, aplikacionet e të cilave zbatojnë logjikë të ndryshme. Ripërpunimi i mesazhit përmes Retryer për një nga këto aplikacione do të çojë në një kopje tjetër në tjetrin. Për t'u mbrojtur nga kjo, krijojmë një temë të veçantë për ripërpunim. Tema hyrëse dhe retry-tëma mund të lexohen nga e njëjta Consumer pa ndonjë kufizim.
Në mënyrë të parazgjedhur, kjo qasje nuk ofron mundësi për një circuit breaker, megjithatë mund të shtohet në aplikacion përmes ose të riut , duke mbështjellë vendet e thirrjeve të shërbimeve të jashtme në përkatësitë përkatëse. Për më tepër, shfaqet mundësia e zgjedhjes së strategjisë për paterni, që gjithashtu mund të jetë e dobishme. Për shembull, në spring-cloud-netflix kjo mund të jetë pool me tela ose semafor.
Përfundimi
Si përfundim, ne kemi një aplikacion të veçantë që lejon përsëritjen e përpunimit të mesazheve gjatë mungesës së përkohshme të ndonjë sistemi të jashtëm.
Një nga përfitimet kryesore të aplikacionit është se ai mund të përdoret nga sistemet e jashtme që funksionojnë në të njëjtin klaster Kafka, pa pasur nevojë për ndryshime të rëndësishme nga ana e tyre! Ky aplikacion do të ketë nevojë vetëm për të marrë qasje në temën e retry-it, për të plotësuar disa këshilla Kafka dhe për të dërguar mesazhin në Retryer. Nuk ka nevojë të ngritet ndonjë infrastrukturë shtesë. Dhe për të reduktuar numrin e mesazheve që kalohen nga aplikacioni në Retryer dhe prapë, ne kemi veçuar aplikacione me logjikë linjare dhe kemi realizuar përsëritjen në to përmes ndalimit të Consumer.
Burimi: habr.com
