

Të nderuar lexues, ditë të mirë!
Detyra e ndërtimit të platformave IT për grumbullimin dhe analizën e të dhënave do të shfaqet shumë shpejt në çdo kompani, e cila ka si themel një model ofrimi shërbimesh të ngarkuar me inteligjencë ose krijimin e produkteve teknologjikisht të komplikuara. Ndërtimi i platformave analitike është një detyrë komplekse dhe e kërkueshme në punë. Megjithatë, secila detyrë mund të thjeshtohet. Në këtë artikull, do të dëshiroj të ndaj përvojën time me aplikimin e mjeteve low-code që ndihmojnë në krijimin e zgjidhjeve analitike. Kjo përvojë është arritur gjatë realizimit të disa projekteve në fushën e Big Data Solutions të kompanisë "Neoflex". Fusha e Big Data Solutions e kompanisë "Neoflex" merret që nga viti 2005 me ndërtimin e depozita dhe liqeneve të dhënash, zgjidhjen e problemeve të optimizimit të shpejtësisë së përpunimit të informacionit dhe punon mbi metodologjinë e menaxhimit të cilësisë së të dhënave.
Të evitosh grumbullimin e vetëdijshëm të të dhënave të dobëta dhe/ose të strukturuara nuk do të jetë e mundur për askënd. Me siguri, edhe nëse flasim për biznes të vogël. Sepse kur biznesi fillon të rritet, një sipërmarrës i ri do të përballet me pyetje mbi zhvillimin e një programi për besnikërinë e klientëve, do të dëshirojë të analizojë efikasitetin e pikave të shitjes, do të mendojë për reklamimin e targetuar dhe do të shqetësohet për kërkesën për produkte shtesë. Në një perspektivë të parë, problemi mund të zgjidhet "në mënyrën më të thjeshtë". Por me rritjen e biznesit, kalimi në një platformë analitike është i pashmangshëm.
Megjithatë, në cilat raste detyrat e analitikës së të dhënave mund të kalojnë në kategorinë "Shkenca e Raketes"? Për siguri, në momentin kur flitet për të dhëna vërtet të mëdha.
Për të thjeshtuar detyrën e "Shkencës së Raketes", ju mund ta hani elefantin pjesë-pjesë.
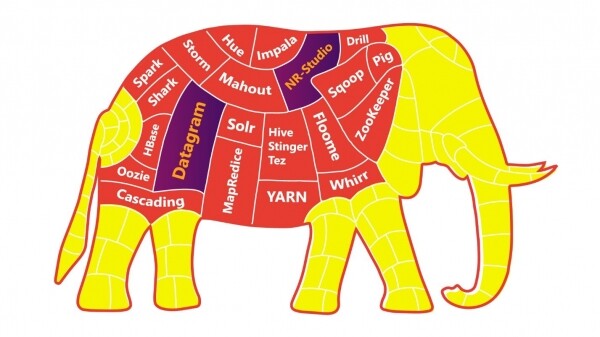
Sa më e madhe të jetë diskretizimi dhe autonomisë së aplikacioneve/servisave/mikroservisave tuaj, aq më e thjeshtë do të jetë për ju, kolegët tuaj dhe të gjithë biznesin të përtypin elefantin.
Ky postul ka arritur të gjitha klientët tanë, të cilët kanë rinovuar peizazhin e tyre duke u bazuar në praktikat inxhinierike të ekipeve DevOps.
Por edhe me një dietë "të ndara, elefantesh", ne kemi shanse të mira për "mbipërshkueshmëri" të peizazhit IT. Në këtë moment, ia vlen të ndaloni, të lehtësoni dhe të shikoni drejt platformës inxhinierike low-code.
Shumë zhvilluesve u frikson perspektiva e një ngërçi në karrierë kur kalojnë nga shkrimi i drejtpërdrejtë të kodit në "tërheqjen" e shigjetave në ndërfaqet UI të sistemeve low-code. Por shfaqja e makinave nuk çoi në zhdukjen e inxhinierëve, por nxori punën e tyre në një nivel të ri!
Le të kuptojmë pse.
Analiza e të dhënave në fushën e logjistikës, industrisë së telekomunikimeve, në fushën e kërkimeve mediale, sektori financiar, gjithmonë lidhet me pyetje të këtij lloji:
- Shpejtësia e zhvillimit të analizave të automatizuara;
- Mundësia e kryerjes së eksperimenteve pa ndikuar në flukshin kryesor të prodhimit të të dhënave;
- Saktësia e të dhënave të përgatitura;
- Gjatë ndjekjes së ndryshimeve dhe versionimit;
- Data provenance, Data lineage, CDC;
- Shpejtësia e dorëzimit të veçorive të reja në ambientin e prodhimit;
- Dhe e famshmja: kostoja e zhvillimit dhe mbështetjes.
Pra, inxhinierët kanë një numër të madh të detyrave me nivel të lartë, të cilat mund t'i realizojnë me efikasitet të mjaftueshëm vetëm pasi të shpëtojnë mendjen nga detyrat e zhvillimit me nivel të ulët.
Parakushtet për kalimin e zhvilluesve në një nivel të ri ishin evolucioni dhe digjitalizimi i biznesit. Vlera e zhvilluesve gjithashtu po ndryshon: zhvilluesit që janë në dishe të madhe janë ata që mund të thellohen në thelbin e koncepteve të biznesit që po automatizohen.
Le të bëjmë një analogji mes gjuhëve të programimit me nivel të ulët dhe atyre me nivel të lartë. Kalimi nga gjuhët me nivel të ulët në drejtim të atyre me nivel të lartë është një kalim nga shkrimi i "direktivave të drejtpërdrejta në gjuhën e harduerit" në drejtim të "direktivave në gjuhën e njerëzve". Pra, shtimi i një shtrese të caktuar të abstraksionit. Në këtë rast, kalimi në platformat low-code nga gjuhët e programimit me nivel të lartë është një kalim nga "direktivave në gjuhën e njerëzve" në drejtim të "direktivave në gjuhën e biznesit". Nëse ndodhen zhvillues që kjo e vërtetë i trishton, atëherë ata mund të kenë qenë të trishtuar që kur lindi JavaScript, në të cilën përdoren funksione për renditjen e masave. Dhe këto funksione, sigurisht, kanë një implementim të programshëm nën kapak me mjete të tjera të njëjtë të programimit me nivel të lartë.
Prandaj, low-code është vetëm shfaqja e një nivele tjetër të abstraksionit.
Përvoja praktike e përdorimit të low-code
Tema low-code është mjaft e gjerë, por tani do të doja të flas për aplikimin praktik të "konceptit me pak kod" përmes njërit prej projekteve tona.
Nënshkrimi Big Data Solutions i kompanisë "Neoflex" fokusohet kryesisht në sektorin financiar të biznesit, duke ndërtuar depo dhe liqene të dhënash dhe duke automatizuar raporte të ndryshme. Në këtë fushë, përdorimi i low-code është bërë një standard prej kohësh. Ndër mjetet e tjera low-code mund të përmendim mjete për organizimin e proceseve ETL: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Ose Oracle Apex, e cila shërben si mjedis për zhvillimin e shpejtë të ndërveprimeve për aksesin dhe redaktimin e të dhënave. Megjithatë, përdorimi i mjeteve të zhvillimit me pak kod nuk është gjithmonë i lidhur me ndërtimin e aplikacioneve të dedikuara në një teknologji komerciale me varësi të qartë nga prodhuesi.
Me ndihmën e platformave low-code, gjithashtu mund të organizoni orkestrimin e rrjedhave të të dhënave, të krijoni platforma data-science ose, për shembull, module për verifikimin e cilësisë së të dhënave.
Një nga shembujt praktik të përvojës në përdorimin e mjeteve të zhvillimit me pak kod është bashkëpunimi i "Neoflex" me kompaninë Mediascope, një nga liderët e tregut rus të kërkimeve mediatike. Një nga detyrat e biznesit të kësaj kompanie është prodhimi i të dhënave, mbi bazën e të cilave reklamuesit, platformat online, stacionet televizive, radiostacionet, agjencitë reklamimi dhe markat marrin vendime për blerjen e reklamës dhe planifikojnë të komunikojnë marketingun e tyre.
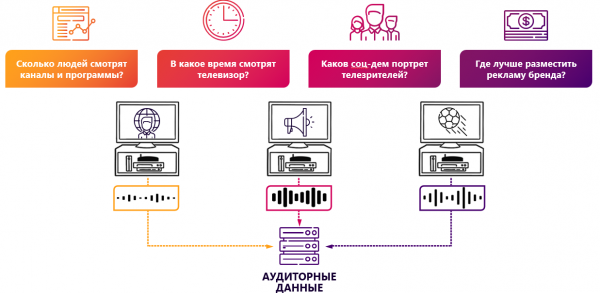
Kërkimet mediatike janë një fushë biznesi me një ngarkesë teknologjike të lartë. Njohja e video-sekvencave, grumbullimi i të dhënave nga pajisje që analizojnë shikimin, matja e aktivitetit në burimet web – të gjitha këto kërkojnë që kompania të ketë një staf të madh IT dhe një përvojë të madhe në ndërtimin e zgjidhjeve analitike. Por rritja eksponenciale e sasisë së informacionit, numrit dhe larmisë së burimeve të tij i detyron vazhdimisht industrinë IT të avancojë. Zgjidhja më e thjeshtë për të zgjeruar një platformë analitike që funksionon tashmë mund të ishte rritja e stafit IT. Por një zgjidhje shumë më efektive është përshpejtimi i procesit të zhvillimit. Një nga hapat drejt kësaj mund të jetë përdorimi i platformave low-code.
Në momentin e fillimit të projektit, kompania tashmë kishte një zgjidhje produkti funksionale. Megjithatë, realizimi i zgjidhjes në MSSQL nuk mund të përmbushte plotësisht pritjet për shkallëzimin e funksionaliteteve me ruajtjen e kostove të arsyeshme të zhvillimit.
Detyra që na u dha ishte me të vërtetë ambicioze – «Neoflex» dhe Mediascope duhej të krijonin një zgjidhje industriale për më pak se një vit, me kushtin që MVP të dilte brenda tremujorit të parë nga data e fillimit të punës.
Si themel për ndërtimin e platformës së re të të dhënave, e bazuar në llogaritjet low-code, u zgjodh stoku i teknologjisë Hadoop. Standarti i ruajtjes së të dhënave u bë HDFS me përdorimin e skedarëve në formatin parquet. Për aksesin në të dhënat që ndodhen në platformë, u përdor Hive, ku të gjitha vitrinat e disponueshme janë të paraqitura si tavolina të jashtme. Ngarkimi i të dhënave në magazinë u realizua me ndihmën e Kafka dhe Apache NiFi.
Instrumenti low-code në këtë koncept u aplikua për optimizimin e detyrës më të punës intensive në ndërtimin e platformës analitike – detyrës përllogaritjeve të të dhënave.
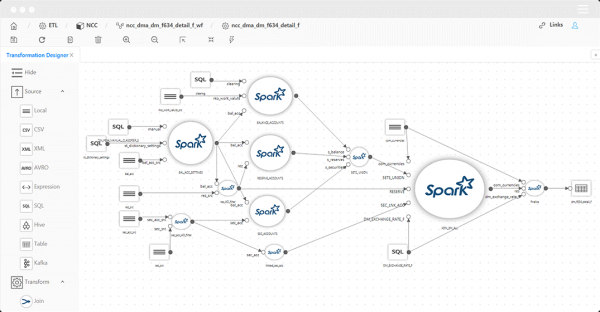
Mekanizmi kryesor për mapimin e të dhënave ishte zgjedhur instrumenti low-code Datagram. Neoflex Datagram – është një mjet për zhvillimin e transformimeve dhe rrjedhave të të dhënave.
Duke përdorur këtë mjet, mund të kaloni pa shkruar kod në Scala "me duar". Kodi Scala gjenerohet automatikisht duke përdorur qasjen Model Driven Architecture.
Avantazhi i dukshëm i këtij qasjeje është përshpejtimi i procesit të zhvillimit. Megjithatë përveç shpejtësisë, ka edhe disa përfitime të tjera:
- Shikimi i përmbajtjes dhe strukturës së burimeve/marrësve;
- Gjyqësia e origjinës së objekteve të rrjedhave të të dhënave deri në fushat individuale (lineage);
- Kryerja e pjesshme e transformimeve me shikimin e rezultateve ndërmjetëse;
- Shikimi i kodit burimor dhe korrigjimi i tij para ekzekutimit;
- Validimi automatik i transformimeve;
- Ngarkimi automatik i të dhënave 1 në 1.
Përfshira në zgjidhjet low-code për gjenerimin e transformimeve është mjaft e ulët: zhvilluesi duhet të dijë SQL dhe të ketë përvojë në përdorimin e mjeteve ETL. Megjithatë, është e rëndësishme të theksohet se gjeneratorët e transformimeve të orientuar drejt kodit nuk janë mjete ETL në kuptimin e gjerë të saj. Mjetet low-code mund të mos kenë një ambient të vetin për ekzekutimin e kodit. Kjo do të thotë se kodi i gjeneruar do të ekzekutohet në atë ambient që ishte në klasterin përpara instalimit të zgjidhjes low-code. Dhe kjo, ndoshta, është një plus tjetër për low-code. Sepse në paralel me ekipin low-code mund të punojë një ekip "klasik", që implementon funksionalitetin, për shembull, në kodin e pastër Scala. Inkludimi i ripunimeve të të dy ekipeve në prodhim do të jetë i thjeshtë dhe "pa të qepur".
Mendoj se është e rëndësishme të theksohet se përveç low-code, ekzistojnë edhe zgjidhje no-code. Dhe në thelb, këto janë gjithashtu gjëra të ndryshme. Low-code lejon më tepër zhvilluesin të ndërhyjë në kodin e gjeneruar. Në rastin e Datagram, është e mundur të shikohet dhe redaktohet kodi i gjeneruar Scala, ndërsa no-code mund të mos ofrojë këtë mundësi. Kjo diferencë është shumë e rëndësishme jo vetëm përsa i përket fleksibilitetit të zgjidhjes, por gjithashtu përsa i përket komoditetit dhe motivimit në punën e inxhinierëve të të dhënave.
Arkitektura e zgjidhjes
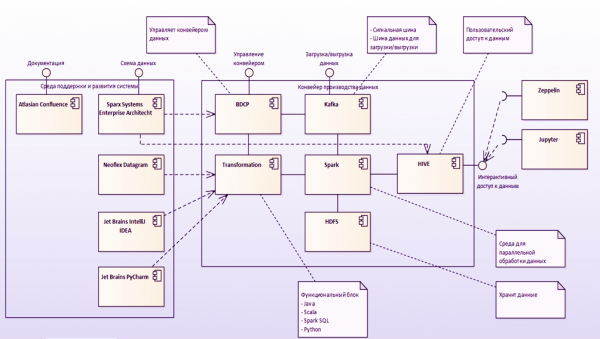
Le të përpiqemi të kuptojmë se si pikërisht një mjet low-code ndihmon në zgjidhjen e problemit të optimizimit të shpejtësisë së zhvillimit të funksionalitetit për llogaritjen e të dhënave. Fillimisht, le të shqyrtojmë arkitekturën funksionale të sistemit. Në këtë rast, shembulli është modeli i prodhimit të të dhënave për studimet mediatike.
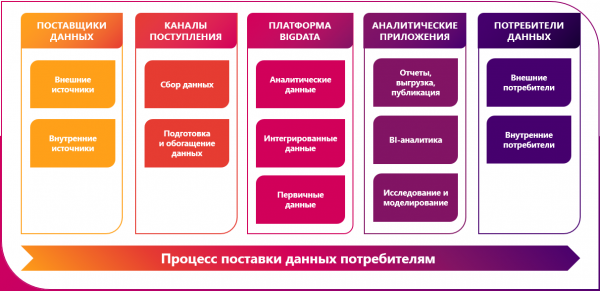
Burimet e të dhënave në rastin tonë janë mjaft heterogjene dhe të shumëllojshme:
- Pipolmetrat (TV-metrat) janë pajisje software-harduer, që lexojnë sjelljen e përdoruesve te respondentët e panelit televiziv – kush, kur dhe cilin kanal televiziv e ka shikuar në familjet që marrin pjesë në studim. Informacioni i ofruar është një rrjedhë intervalesh shikimi të transmetimit të lidhur me paketën mediatike dhe produktin medial. Të dhënat në fazën e ngarkimit në Data Lake mund të pasurohen me atribute demografike, lidhje me gjeostrate, zona orare dhe informacione të tjera të nevojshme për analizën e shikueshmërisë së produkteve mediale të caktuara. Matjet e kryera mund të përdoren për analizën ose planifikimin e fushatave reklamouese, vlerësimin e aktiviteteve dhe preferencave të audiencës, dhe krijimin e gridës televizive;
- Të dhënat mund të vijnë nga sistemet e monitorimit të transmetimit të qëndrueshëm dhe matjes së shikimit të përmbajtjes së burimeve audiovisive në internet;
- Instrumentet matëse në mjedisin web, mes të cilave janë gjithashtu numeratorët site-centric dhe user-centric. Një mjet i dhënash për Data Lake mund të jetë një shtesë e shfletuesit si research bar dhe një aplikacion celular me të instaluar; VPN.
- Të dhënat gjithashtu mund të vijnë nga platformat që konsolidohen rezultatet e mbushjes së anketimeve online dhe përfundimet e intervistave telefonike në hulumtimet e kompanisë;
- Pasurimi shtesë i liqenit të të dhënave mund të ndodhi përmes ngarkimit të informacionit nga logjet e kompanive partnere.
Implementimi as is i ngarkimit nga sistemet burimore në staging-un fillestar të të dhënave të papërpunuara mund të organizohet në mënyra të ndryshme. Nëse përdoren këto qëllime low-code, është e mundur gjenerimi automatik i skenarëve të ngarkimit bazuar në të dhënat metadatike. Në këtë rast, nuk është e nevojshme të zbresi deri në nivelin e zhvillimit të mapimeve source to target. Për të realizuar ngarkimin automatik, ne duhet të vendosim një lidhje me burimin, pas së cilës të përcaktojmë në ndërfaqen e ngarkimit listën e entiteteve që do ngarkohen. Krijimi i strukturës së katalogëve në HDFS do të ndodhë automatikisht dhe do të përputhet me strukturën e ruajtjes së të dhënave në sistemin burim.
Megjithatë, në kontekstin e këtij projekti, ne vendosëm të mos përdorim këtë mundësi të platformës low-code për shkak se kompania Mediascope ka filluar tashmë të punojë për krijimin e një shërbimi të ngjashëm me ndihmën e Nifi + Kafka.
Është e rëndësishme të theksohet se këto mjete nuk zëvendësojnë njëri-tjetrin, por më shumë plotësojnë njëri-tjetrin. Nifi dhe Kafka janë në gjendje të punojnë si në mënyrë direkte (Nifi -> Kafka), ashtu edhe në mënyrë të kundërt (Kafka -> Nifi). Platforma për hulumtimin mediatik përdori opsionin e parë të lidhjes.
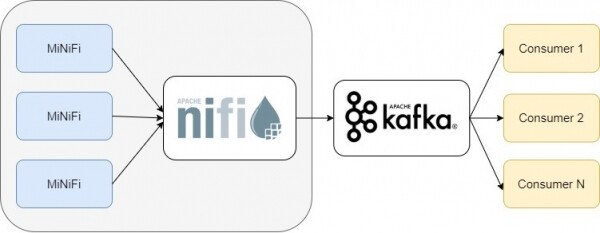
Në rastin tonë, Nifi duhej të përpunonte lloje të ndryshme të të dhënave nga sistemet burim dhe t'i dërgonte ato te brokeri Kafka. Në këtë rast, drejtimi i mesazheve në një temë të caktuar të Kafka bëhej përmes përdorimit të procesorëve Nifi PublishKafka. Orkestrimi dhe mirëmbajtja e këtyre pipeline-ve bëhet në një interfacing vizual. Mjeti Nifi dhe përdorimi i lidhjes Nifi + Kafka gjithashtu mund të quhet qasje low-code në zhvillim, me një prag të ulët hyres në teknologjitë Big Data dhe që e përshpejton procesin e zhvillimit të aplikacioneve.
Hapi tjetër në realizimin e projektit ishte përshtatja në formatin e një sloji semantik të unifikuar të të dhënave të detajuara. Nëse entiteti ka atribute historike, llogaritja bëhet në kontekstin e partition-it të shqyrtuar. Nëse entiteti nuk është historik, atëherë është opsionale ose ripërllogaritja e përmbajtjes së plotë të objektit, ose heqja përfundimisht e ripërllogaritjes së këtij objekti (për shkak të mungesës së ndryshimeve). Në këtë fazë, gjenerohen çelësa për të gjithë entitetet. Çelësat ruhen në regjistrat përkatës të master-objekteve Hbase, që përmbajnë përputhshmërinë midis çelësave në platformën analitike dhe çelësave nga sistemet burim. Konsolidimi i entiteteve atomike shoqërohet me pasurimin e rezultateve të llogaritjeve analitike të parapara. Framework-u për llogaritjen e të dhënave ishte Spark. Funksionaliteti i përshkruar për përshtatjen e të dhënave në një semantik të unifikuar ishte realizuar gjithashtu mbi bazën e hartimeve të mjeteve low-code Datagram.
Në arkitekturën e synuar duhej të sigurohej akses SQL në të dhëna për përdoruesit e biznesit. Për këtë opsion, u përdor Hive. Regjistrimi i objekteve në Hive bëhet automatikisht kur aktivizohet opsioni 'Regjistro Hive Table' në mjetin low-code.
Menaxhimi i rrjedhës së llogaritjes
Datagram ka ndërfaqe për ndërtimin e dizajneve të rrjedhave të punës. Ekzekutimi i mapimeve mund të bëhet duke përdorur planifikuesin Oozie. Në ndërfaqen e zhvilluesit për rrjedhat, është e mundur të krijoni skema të ekzekutimeve paralele, sekondare ose të varura nga kushte të caktuara për transformimin e të dhënave. Ka mbështetje për shell scripts dhe programe java. gjithashtu është e mundur përdorimi serverë Apache Livy. Apache Livy përdoret për të nisur aplikacione direkt nga mjedisi i zhvillimit.
Në rast se kompania ka një orkestrues procesesh, është e mundur të përdorim REST API për të integruar mapimet në rrjedhat ekzistuese. Për shembull, ne kemi pasur një përvojë të suksesshme në integrimin e mapimeve në Scala në orkestrues të shkruar në PLSQL dhe Kotlin. REST API i mjetit me pak kod nënkupton praninë e operacioneve të tilla si gjenerimi i vitit ekzekutues në bazë të dizajnit të mapimit, thirrjen e mapimit, thirrjen e sekuencave të mapimeve dhe, sigurisht, transmetimin e parametrave në URL për të nisur mapimet.
Bashkë me Oozie, është e mundur të organizohet rrjedha e llogarive me mjete si Airflow. Nuk do të ndalem shumë në krahasimin mes Oozie dhe Airflow, por do të thoja thjesht se në kontekstin e punëve të projektit të studimeve mediale, zgjedhja ra në favor të Airflow. Argumentet kryesore në këtë rast ishin një komunitet më aktiv që zhvillon produktin dhe një ndërfaqe + API më të zhvilluar.
Airflow është gjithashtu i mirë sepse për përshkrimin e proceseve të llogarive përdoret Python, i preferuar nga shumëkënd. Dhe në përgjithësi, nuk ka shumë platforma për menaxhimin e rrjedhave të punës me kod të hapur. Nisma dhe monitorimi i ekzekutimit të proceseve (përfshirë diagramin Gantt) thjesht shtojnë pikë në karmën e Airflow.
Formati i skedarit të konfigurimit për nisjen e mapimeve të zgjidhjeve me pak kod është spark-submit. Kjo ndodhi për dy arsye. Së pari, spark-submit lejon të niset direkt një jar-file nga konsola. Së dyti, mund të përmbajë të gjitha informacionet e nevojshme për konfigurimin e rrjedhës së punës (çka lehtëson shkrimin e skripteve që formojnë Dag).
Elementi më i shpeshtë i rrjedhës së punës Airflow në rastin tonë ishte SparkSubmitOperator.
SparkSubmitOperator lejon të nisni jar-files — mapimet e paketuar të Datagram me parametrat e inputit të formuar paraprakisht për to.
Duhet të theksohet se çdo detyrë e Airflow ekzekutohet në një ndarje të veçantë dhe nuk di asgjë rreth detyrave të tjera. Prandaj, ndërveprimi midis detyrave realizohet përmes operatorëve menaxhues, si DummyOperator ose BranchPythonOperator.
Në bashkëpunim me përdorimin e zgjidhjes low-code Datagram në lidhje me universalishtimin e skedarëve të konfigurimit (të formuar Dag), kjo solli përshpejtim dhe thjeshtim të dukshëm të procesit të zhvillimit të rrjedhave të ngarkimit të të dhënave.
Llogaritja e vitrinave
Më tepër, faza më inteligjente në prodhimin e të dhënave analitike është hapi i ndërtimit të vitrinave. Në kontekstin e një prej rrjedhave të llogaritjes së të dhënave të kompanisë kërkimore, në këtë fazë ndodh kalimi në përkthimin standard duke marrë parasysh rregullimet për shpretë të orëve lidhur me rrjetin e transmetimit. Gjithashtu është e mundur një rregullim për rrjetin lokal të transmetimit (lajmet lokale dhe reklamat). Mes të tjerash, në këtë hap bëhet ndarja e intervaleve të shikimit të vazhdueshëm të produkteve mediale sipas analizës së intervaleve të shikimit. Po ashtu këtu ndodh “pesha” e vlerave të shikimit sipas informacionit për rëndësinë e tyre (llogaritja e koeficientit të rregullimit).
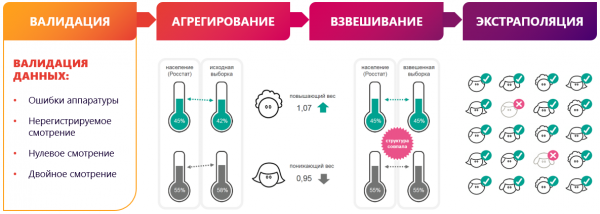
Një hap i veçantë i përgatitjes së vitrinave është validimi i të dhënave. Algoritmi i validimit është i lidhur me përdorimin e një serie modelesh shkencore matematikore. Megjithatë, përdorimi i platformës low-code lejon ndarjen e algoritmit të komplikuar në një seri mapimesh vizualisht të lexueshme. Çdo mapim kryen një detyrë të caktuar. Si rezultat, është e mundur debugging i ndërmjetëm, regjistrimi dhe vizualizimi i fazave të përgatitjes së të dhënave.
Algoritmi i validimit u vendos të diskretizohej në hapat e mëposhtëm:
- Ndërtimi i regressioneve të varësive të shikimit të televizionit në rajon me shikimin e të gjitha rrjeteve në rajon për 60 ditë.
- Llogaritja e mbetjeve të studentizuara (shkallimi i vlerave të faktuara nga ato të parashikuara nga modeli regresion) për të gjitha pikat e regresionit dhe për ditën e llogaritjes.
- Selekcioni i grupeve anomale rajon-television, ku mbetja e studentizuar e ditës së llogaritjes tejkalon normën (të vendosur nga konfigurimi i operacionit).
- Riviera e rishikuar e mbeturin e studentizuar sipas çifteve anomale rajon-rrjet për çdo respondent, i cili ka parë rrjetin në rajon me përcaktimin e kontributit të këtij respondenti (shkalla e ndryshimit të mbeturinës studentizuese) duke përjashtuar shikimin e këtij respondenti nga mostrat.
- Kërkimi i kandidatëve, përjashtimi i të cilëve e çon mbeturinën e studentizuar të ditës në normë.
Shembulli i mësipërm është një konfirmim i hipotezës se një inxhinier të dhënash ka shumë për të mbajtur mend… Dhe, nëse është vërtet "inxhinier", e jo "kodues", frika e degraduar profesionistike duke përdorur instrumente low-code duhet të largohet përfundimisht.
Çfarë tjetër mund të bëjë low-code?
Fusha e aplikimit të instrumenteve low-code për proceset paketë dhe të të dhënave pa nevojën për të shkruar kod në Scala manualisht nuk përfundon këtu.
Përdorimi i low-code në zhvillimin e datalake-ve është bërë tashmë një standard për ne. Mund të thuhet se zgjidhjet në stek Hadoop përshtaten me zhvillimin e klasikeve DWH të bazuara në RDBMS. Instrumentet me pak kod në stek Hadoop mund të zgjidhin si problemet e përpunimit të të dhënave ashtu edhe ato të ndërtimit të interface-ve përfundimtare BI. Ndërkohë, duhen vënë në dukje se BI mund të kuptohet jo vetëm si përfaqësimi i të dhënave, por edhe si redaktimi i tyre nga përdoruesit e biznesit. Ky funksionalitet shpesh përdoresh nga ne në ndërtimin e platformave analitike për sektorin financiar.
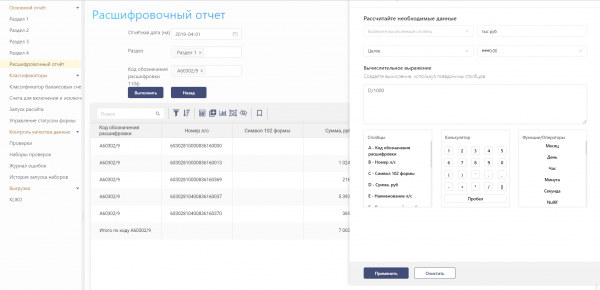
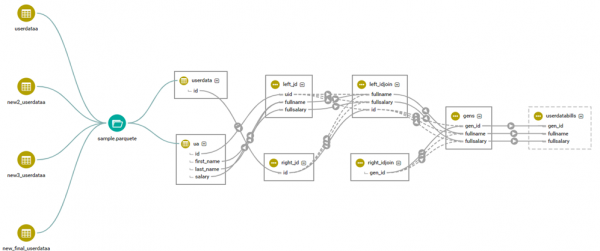
Në mesin e shumë të tjerave, me ndihmën e low-code dhe, në veçanti, Datagram, është e mundur të zgjidhet problemi i ndjekjes së origjinës së objekteve të fluksit të dhënash me atomizim deri në fushat e veçanta (lineage). Për këtë, në mjetin low-code është implementuar lidhja me Apache Atlas dhe Cloudera Navigator. Në thelb, zhvilluesi duhet të regjistrojë një grup objektesh në fjalorët e Atlas dhe të referohet në objektet e regjistruara gjatë ndërtimit të mapimeve. Mekanizmi i ndjekjes së origjinës së të dhënave ose analizohet varësitë e objekteve kursen një sasi të madhe kohe kur është e nevojshme të bëhen përmirësime në algoritmet e kalkulimit. Për shembull, gjatë ndërtimit të raporteve financiare, kjo veçori lejon që të përballojmë më lehtë periudhat e ndryshimeve të legjislacionit. Sepse, sa më mirë e kuptojmë varësinë ndërmjet formave në kontekstin e objekteve të nivelit të detajuar, aq më pak do të përballemi me difekte "të papritura" dhe do të zvogëlojmë numrin e rishikimeve.
Cilësia e të Dhënave & Low-code
Një tjetër problem që u realizua përmes mjetit low-code në projektin e kompanisë Mediascope, ishte problemi i klasës Data Quality. Karakteristika e realizimit të konveyor-it të kontrollit të të dhënave për projektin e kompanisë kërkimore ishte mungesa e ndikimit në funksionimin dhe shpejtësinë e punës së procesit kryesor të llogaritjes së të dhënave. Për të mundësuar orkestrimin e proceseve të pavarura të kontrollit të të dhënave, u përdor Apache Airflow i njohur tashmë. Me përfundimin e çdo hapi të prodhimit të të dhënave, fillimisht u iniciua një pjesë e veçantë e konveyor-it DQ.
Një praktikë e mirë konsiderohet vëzhgimi i cilësisë së të dhënave që nga momenti i lindjes së tyre në platformën analitike. Me informacionin mbi metadat, ne mund të kontrollojmë përmbushjen e kushteve bazë — not null, constraints, foreign keys që nga momenti i futjes së informacionit në nivelin fillestar. Ky funksionalitet është realizuar mbi baza të mapimeve që gjenerohen automatikisht të familjes së cilësisë së të dhënave në Datagram. Kodo-generimi në këtë rast gjithashtu mbështetet në metadat e modelit. Në projektin e kompanisë Mediascope, lidhja ndodhi me metadat e produktit Enterprise Architect.
Falë lidhjes mes mjetit low-code dhe Enterprise Architect, u gjeneruan automatikisht verifikimet e mëposhtme:
- Kontrolli i pranisë së vlerave "null" në fushat me modifikatorin "not null";
- Kontrolli i pranisë së dyfisheve të çelësit të parë;
- Kontrolli i çelësit të jashtëm të entitetit;
- Kontrolli i unikësisë së rreshtit sipas një seti fushash.
Për kontrollet më të komplikuara të disponueshmërisë dhe saktësisë së të dhënave, u krijua një mapping me Scala Expression, që merr si hyrje kodin e kontrollit nga Spark SQL, të përgatitur nga analistët në Zeppelin.
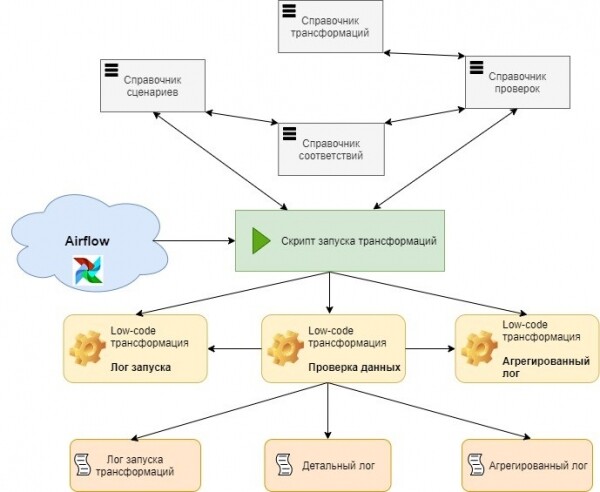
Natyrisht, duhet të arrijmë gradualisht në autogjenerimin e kontrollit. Në kuadër të projektit të përshkruar, këtyre iu parapriu hapat e mëposhtëm:
- DQ, të realizuara në notebook`at Zeppelin;
- DQ, të integruara në mapping;
- DQ në formën e mappings masive të ndara, që përmbajnë një grup të tërë kontrollesh për çdo entitet të veçantë;
- Mappings DQ universale parametrike, që marrin si hyrje informacionin për metadat dhe kontrollet biznesore.
Ndoshta, avantazhi kryesor i krijimit të një shërbimi të kontrolleve të parametrizuara është shkurtimi i kohës së dorëzimit të funksionalitetit në mjedisin prodhues. Kontrollt e reja të cilësisë mund të kalojnë modelin klasik të dorëzimit të kodit nëpërmjet mjediseve të zhvillimit dhe testimit:
- Të gjitha kontrollt e metadatanëve gjenerohen automatikisht me ndryshimin e modelit në EA;
- Kontrollt e disponueshmërisë së të dhënave (përcaktimi i pranishmërisë së çdo të dhëne në momentin e caktuar) mund të gjenerohen në bazë të një katalogu që ruan koha e pritur për shfaqjen e grupit të ardhshëm të të dhënave sipas objekteve;
- Kontrollt biznesore për saktësinë e të dhënave krijohen nga analistët në notebook`at Zeppelin. Ato dërgohen drejtpërdrejt në tabelat e konfigurimeve të modulit DQ në mjedisin prodhues.
Rreziqet e dërgimit të drejtpërdrejtë të skripteve në prodhim si të tilla nuk ekzistojnë. Edhe në rast të një gabimi sintaksor, maksimumi i asaj që na kërcënon është mosinkasimi i një kontrolli, pasi rrjedha e llogaritjes së të dhënave dhe rrjedha e nisjes së kontrolleve të cilësisë janë të ndara nga njëra-tjetra.
Në thelb, shërbimi DQ është vazhdimisht aktiv në mjedisin prodhues dhe është i gatshëm të fillojë punën në momentin e shfaqjes së grupit të ardhshëm të të dhënave.
Në përfundim
Avantazhi i përdorimit të low-code është i qartë. Zhvilluesit nuk kanë nevojë të zhvillojnë një aplikacion "nga e para". Një programues i liruar nga detyra të tjera jep rezultate më shpejt. Shpejtësia, nga ana tjetër, liron burime të tjera kohore për zgjidhjen e çështjeve të optimizimit. Prandaj, në këtë rast, mund të llogaritet në një zgjidhje më cilësore dhe më të shpejtë.
Natyrisht, low-code nuk është një panacee, dhe magia për vete nuk do të ndodhë:
- Industria e low-code po kalon një fazë "forcimi", dhe për momentin nuk ka standarde të njëllojta në industri;
- Shumë zgjidhje low-code nuk janë falas, dhe blerja e tyre duhet të jetë një hap i vetëdijshëm, që duhet të bëhet me besimin e plotë në përfitimin financiar nga përdorimi i tyre;
- Shumë zgjidhje low-code nuk e kanë gjithmonë mikpritës me GIT / SVN. Ose janë të papërshtatshme për t'u përdorur në rastin e fshehjes së kodit të gjeneruar;
- Gjatë zgjerimit të arkitekturës mund të jetë e nevojshme të rregullohet një zgjidhje low-code – çka, nga ana tjetër, provokon efektin e "varësisë nga ofruesi" të zgjidhjes low-code.
- Një nivel i duhur i sigurisë është i mundur, por shumë i lodhshëm dhe i komplikuar për tu zbatuar në motorët e sistemeve low-code. Platformat low-code duhet të zgjidhen jo vetëm mbi principin e kërkimit të përfitimit nga përdorimi i tyre. Kur bëni një zgjedhje, duhet të pyesni për praninë e funksionaliteteve të menaxhimit të aksesit dhe delegimit / eskalimit të të dhënave të identifikimit në nivelin e përgjithshëm të peizazhit IT të organizatës.
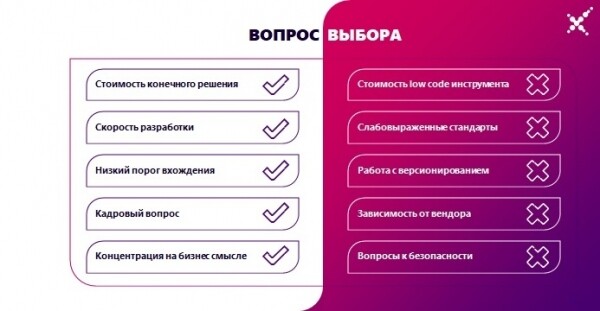
Megjithatë, nëse të gjithë disavantazhet e sistemit të zgjedhur janë të njohura për ju, dhe përfitimet nga përdorimi i tij, megjithatë, janë në shumicë dominues, atëherë kaloni në low-code pa frikë. Sidomos, sepse kalimi në të është i paevitueshëm – ashtu si çdo evolucion.
Nëse një zhvillues në një platformë low-code bën punën e tij më shpejt se dy zhvillues pa low-code, atëherë kjo i jep kompanisë një avantazh në çdo aspekt. Pragun e hyrjes në zgjidhjet low-code është më të ulët se në teknologjitë "tradicionale", dhe kjo ka një ndikim pozitiv në çështjen e mungesës së fuqisë punëtore. Përdorimi i mjeteve low-code mund të shpejtojë ndërveprimin midis ekipeve funksionale dhe të mundësojë marrjen më të shpejtë të vendimeve për saktësinë e rrugës së zgjedhur të hulumtimeve në data-science. Platforma e nivelit të ulët mund të jetë një shkak për transformimin digjital të organizatës, pasi zgjidhjet që prodhohen mund të jenë të kuptueshme për specialistët jo teknikë (veçanërisht përdoruesit e biznesit).
Nëse keni afate të shkurtra, logjikë biznesi të rënduar, mungesë expertise teknologjike, dhe ju nevojitet të shpejtoni kohën deri në treg, atëherë low-code është një nga mënyrat për të përmbushur nevojat tuaja.
Nuk duhet mohuar rëndësia e mjeteve tradicionale të zhvillimit, megjithatë, në shumë raste, aplikimi i zgjidhjeve low-code është mënyra më e mirë për të rritur efikasitetin e detyrave që po zgjidhen.
Burimi: habr.com
