

Shënim: përkthimi: ky është përkthimi i një postmortemi publik nga blogu inxhinierik i kompanisë . Në të përshkruhet problemi me conntrack në klasterin Kubernetes, i cili çoi në një ndërprerje të pjesshme të disa shërbimeve në prodhim.
Ky artikull mund të jetë i dobishëm për ata që dëshirojnë të dinë pak më shumë rreth postmortemëve ose për të parandaluar disa probleme potenciale me DNS në të ardhmen.
Kjo nuk është DNS
Nuk mund të jetë që kjo është DNS
Kjo ishte DNS
Pak rreth postmortemëve dhe proceseve në Preply
Në postmortem përshkruhet një dështim në funksionim ose ndonjë ngjarje në prodhim. Postmortemi përfshin një kronologji ngjarjesh, përshkrimin e ndikimit te përdoruesi, shkakun kryesor, veprimet dhe mësimet e nxjerra.
Në mbledhjet tona javore me pizzë, rreth ekipit teknik, ndajmë informacion të ndryshëm. Një nga pjesët më të rëndësishme të këtyre mbledhjeve janë postmortemët, të cilat shpesh shoqërohen me prezantime me slaide dhe një analizë më të thellë të incidentit që ka ndodhur. Pavarësisht se nuk 'duam' pas përfundimit të postmortemëve, përpiqemi të zhvillojmë kulturën e 'pa akuza' (). Ne besojmë se shkruajtja dhe paraqitja e postmortemëve mund të na ndihmojë (dhe jo vetëm) për të parandaluar incidente të ngjashme në të ardhmen, për këtë arsye ne ndajmë ato.
Personat e përfshirë në incident duhet të ndihen se mund të flasin në detaje rreth tij pa pasur frikë nga ndëshkimi ose hakmarrja. Asnjë përbuzje! Shkruajtja e postmortemëve nuk është një ndëshkim, por një mundësi për të mësuar për të gjithë kompaninë.
Probleme me DNS në Kubernetes. Postmortem
Data: 28.02.2020
Autorët: Amet U., Andrey S., Igor K., Alexey P.
Statusi: Përfunduar
Përmbledhje: Disponueshmëri e pjesshme e DNS (26 min) për disa shërbime në klasterin Kubernetes
Ndikimi: 15000 ngjarje janë humbur për shërbimet A, B dhe C
Shkaku kryesor: Kube-proxy nuk mundi të fshijë korrektësisht regjistrimin e vjetër nga tabela conntrack, prandaj disa shërbime vazhduan të përpiqen të lidhen me pod të paekzistueshëm.
E0228 20:13:53.795782 1 proxier.go:610] Dështoi të fshijë kube-system/kube-dns:dns endpoint connections, gabim: gabim në fshirjen e hyrjeve conntrack për UDP peer {100.64.0.10, 100.110.33.231}, gabim: komanda conntrack ktheu: ...Shkaktari: Për shkak të ngarkesës së ulët brenda klasterit Kubernetes, CoreDNS-autoscaler zvogëloi numrin e podëve në deployment nga tre në dy.
Zgjidhja: Një tjetër deploy i aplikacionit shkaktoi krijimin e nyjave të reja, CoreDNS-autoscaler shtoi më shumë pods për të shërbyer klasterin, çka shkaktoi rinovimin e tabelës conntrack
Zbulimi: Monitorimi Prometheus zbuloi një numër të madh gabimesh 5xx për shërbimet A, B dhe C dhe iniciatoi një telefonatë për inxhinierët e kujdesit
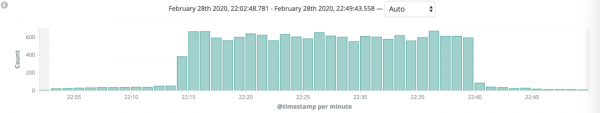
Gabimet 5xx në Kibana
Veprimet
Veprim
Lloji
Përgjegjës
Detyra
Çaktivizo autoscaler për CoreDNS
parandalimi
Amet U.
DEVOPS-695
Vendos një server DNS që ruan cache
reduktim
Max V.
DEVOPS-665
Konfiguro monitorimin e conntrack
parandalimi
Amet U.
DEVOPS-674
Mësimet e nxjerra
Çfarë shkoi mirë:
- Monitorimi funksionoi në mënyrë të qartë. Reagimi ishte i shpejtë dhe i organizuar
- Nuk u përballëm me limite në nyja
Çfarë nuk shkoi mirë:
- Akoma nuk dihet shkaku real, duket si në conntrack
- Të gjitha veprimet e korrigjojnë vetëm pasojat, jo shkakun (bugun)
- E dinim se disa herë do të kishim probleme me DNS, por nuk prioritizuam detyrat
Ku kemi pasur fat:
- Një tjetër deploy aktivizoi CoreDNS-autoscaler, i cili rinovoi tabelën conntrack
- Ky bug preku vetëm një pjesë të shërbimeve
Kronologjia (EET)
Koha
Veprim
22:13
CoreDNS-autoscaler reduktoi numrin e pods nga tre në dy
22:18
Inxhinierët e kujdesit filluan të merrnin telefonata nga sistemi i monitorimit
22:21
Inxhinierët e kujdesit filluan të hetojnë shkakun e gabimeve
22:39
Inxhinierët e kujdesit filluan të rikthejnë një nga shërbimet më të fundit në versionin e mëparshëm
22:40
Gabimet 5xx pushtuan të ndalnin shfaqjen, situata u stabilizua
- Koha deri në zbulim: 4 min
- Koha deri në veprim: 21 min
- Koha deri në korrigjim: 1 min
Informacione shtesë
- Log-et e CoreDNS:
I0228 20:13:53.507780 1 event.go:221] Event(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' reason: 'ScalingReplicaSet' Scaled down replica set coredns-6cbb6646c9 to 2 - Lidhjet për Kibana (e prerë), Grafana (e prerë)
Për të minimizuar përdorimin e procesorit, bërthama Linux përdor një gjë të tillë si conntrack. Në përmbledhje, kjo është një utilitare që mban një listë të regjistrimeve NAT, të cilat ruhen në një tabelë të veçantë. Kur mbërrin paketi tjetër nga i njëjti pod në të njëjtin pod si më parë, adresa IP përfundimtare nuk do të llogaritet sërish, por do të merret nga tabela conntrack.
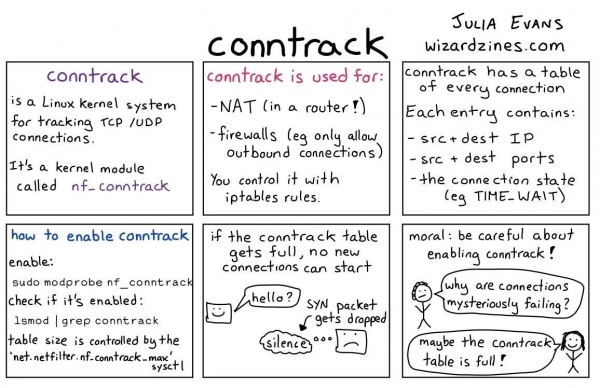
Si e drejton conntrack
Përfundime
Ky ishte një shembull i një nga postmortemët tanë me disa lidhje të dobishme. Konkretisht në këtë artikull ne ndajmë informacion që mund të jetë i dobishëm për kompani të tjera. Kjo është arsyeja pse nuk kemi frikë të bëjmë gabime dhe kjo është arsyeja pse ne e kemi bërë një nga postmortemët tanë publik. Ja disa postmortemë interesante publike:
- GitLab:
- Dropbox:
- Spotify:
- Shumë të tjerë nga dhe repositorin
- Gjithashtu postmortem publik me SRE Book
Burimi: habr.com
