

Kjo është një histori se si ne përdorim kontejnerët në ambientin produktiv, veçanërisht nën Kubernetes. Artikulli është dedikuar mbledhjes së metrike dhe logeve nga kontejnerët, si dhe ndërtimit të imazheve.
Ne jemi nga kompania fintech Exness, e cila zhvillon shërbime për tregtimin online dhe produkte fintech për B2B dhe B2C. Në R&D tonin ka shumë ekipe të ndryshme, me mbi 100 punonjës në departamentin e zhvillimit.
Ne paraqesim ekipin që është përgjegjës për platformën për mbledhjen dhe ekzekutimin e kodit nga zhvilluesit tanë. Me konkretisht, ne jemi përgjegjës për mbledhjen, ruajtjen dhe ofrimin e metrikeve, logeve dhe ngjarjeve nga aplikacionet. Aktualisht operojmë me përafërsisht tri mijë kontejnerë Docker në ambientin produktiv, mbështesim depo big data me kapacitet prej 50 TB dhe ofrojmë zgjidhje arkitektonike që ndërtohen rreth infrastrukturës tonë: Kubernetes, Rancher dhe ofrues të ndryshëm të cloud-it publik.
Motivimi ynë
Çfarë po digjet? Askush nuk mund ta përgjigjet. Ku është qendra? E kuptojmë me vështirësi. Kur ka filluar të digjet? Mund të zbulohet, por jo menjëherë.
Pse disa kontejnerë ndalen, ndërsa të tjerë bien? Cili kontejner e shkaktoi atë? Sepse nga jashtë, kontejnerët duken të njëjtë, por brenda secili ka Neo-n e vet.
Zhvilluesit tanë janë djem të aftë. Ata bëjnë shërbime të mira që sjellin fitim për kompaninë. Por ndodhin gabime, kur kontejnerët me aplikacione shkojnë në mënyrë kaotike. Një kontejner konsumon shumë CPU, një tjetër rrjetin, një i tretë operacionet e hyrjes dhe daljes, ndërsa një i katërt gjithashtu nuk dihet se çfarë bën me soketët. Të gjithë këta e dërgojnë broçkullën, dhe anija po fundoset.
Agjentët
Për të kuptuar çfarë po ndodh brenda, ne vendosëm të instalojmë agjentët direkt në kontejnerë.
Këta agjentë janë programe mbikëqyrëse, që mbajnë kontejnerët në gjendje të tillë që të mos shkatërrojnë njëri-tjettrin. Agjentët janë standardizuar, dhe kjo lejon standardizimin e qasjes për mirëmbajtjen e kontejnerëve.
Në rastin tonë, agjentët duhet të ofrojnë loge në një format standard, të etiketuar dhe me throttling. Po ashtu, ata duhet të na ofrojnë metrika standardizuar, të zgjerueshme nga ana e aplikacioneve biznesore.
Nën agjentët gjithashtu nënkuptohen utilitetet për operacion dhe mirëmbajtje, që janë të afta të funksionojnë në sisteme të ndryshme orkestrimi, duke mbështetur imazhe të ndryshme (Debian, Alpine, Centos etj.).
Së fundi, agjentët duhet të mbështesin një CI/CD të thjeshtë, që përfshin skedarë Docker. Në të kundërt, anija do të shembet, sepse kontejnerët do të fillojnë të dërgohen nëpër "binarë" të shtrembër.
Procesi i ndërtimit dhe struktura e imazhit të synuar
Për të pasur gjithçka të standardizuar dhe menaxhueshme, është e nevojshme të ndiqet një proces standard ndërtimi. Prandaj, ne vendosëm të ndërtojmë kontejnerë me kontejnerë — një recursivitet i tillë.
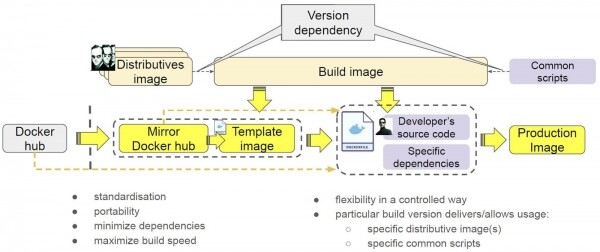
Këtu kontejnerët paraqiten si kontura të plota. Po ashtu vendosëm të futim në to distribucione, për të mos e bërë "jetën si një mollë". Pse e bëmë këtë, do ta tregojmë më poshtë.
Si rezultat, kemi krijuar një mjet ndërtimi — një kontejner të versionit të caktuar, i cili lidhet me versione të caktuara distribucionesh dhe me versione të caktuara skenesh.
Si e aplikojmë atë? Ne kemi Docker Hub, ku ndodhet kontejneri. Ne e pasqyrojmë atë brenda sistemit tonë, për të eliminuar varësitë e jashtme. Kemi krijuar një kontejner të markuar me ngjyrë të verdhë. Ne krijojmë një template për të instaluar në kontejner të gjitha distribucionet dhe skenat e nevojshme për ne. Pas kësaj, ne ndërtojmë imazhin gati për t'u përdorur: zhvilluesit e vendosin brenda kodin dhe varësitë e tyre specifike.
Çfarë është e mirë në këtë qasje?
- Së pari, kontrolli i plotë i versioneve të mjeteve të ndërtimit – kontejneri i ndërtimit, versionet e skripteve dhe distribucioneve.
- Së dyti, ne arritëm standardizimin: krijojmë modele në një mënyrë të njëjtë, imazhe ndërmjetëse dhe gati për t'u përdorur.
- Së treti, kontejnerët na ofrojnë portabilitet. Sot ne përdorim Gitlab, dhe nesër do të kalojmë në TeamCity ose Jenkins dhe do të jemi në gjendje të ekzekutojmë po ashtu kontejnerët tanë.
- Së katërti, minimizimi i varësive. Nuk e kemi vendosur rastësisht distribucionet në kontejner, sepse kjo lejon që të mos i shkarkojmë ato çdo herë nga Interneti.
- Së pesti, është rritur shpejtësia e ndërtimit – pranimi i kopjeve lokale të imazheve na lejon të mos harxhojmë kohë në shkarkim, pasi e kemi një imazh lokal.
Me fjalë të tjera, ne arritëm një proces ndërtimi të kontrollueshëm dhe fleksibël. Ne përdorim mjete të njëjta për të ndërtuar çdo kontejner me versionim të plotë.
Si funksionon procedura jonë e ndërtimit
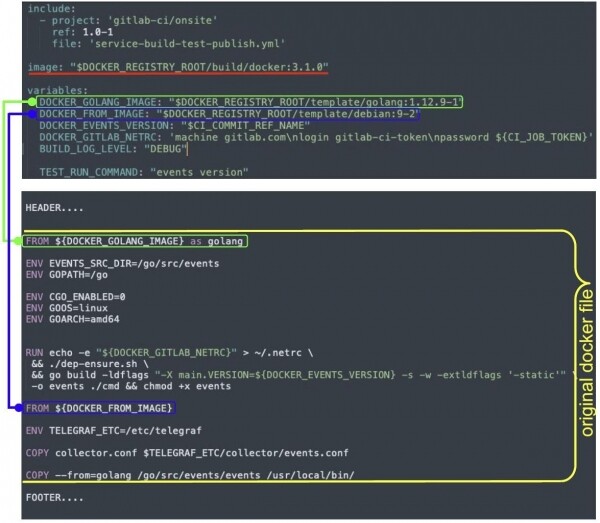
Grumbullimi aktivizohet me një komandë, procesi kryhet në imazh (i shënuar me të kuqe). Zhvilluesi ka një skedë Docker (e shënuar me të verdhë), ne e renditim atë duke zëvendësuar variablat me vlera. Ndërkohë, shtojmë header dhe footer — këto janë agjentët tanë.
Header-in e shton distribucionet nga imazhet përkatëse. Ndërsa footer-i vendos brenda shërbimet tona, konfiguron nisjen e ngarkesës punuese, regjistrimin dhe agjentët e tjerë, zëvendëson entrypoint etj.
Ne menduam për një kohë të gjatë nëse duhet të vendosim një supervizor. Në fund të fundit, vendosëm se na nevojitet. Zgjodhëm S6. Supervizori ofron menaxhimin e kontejnerit: lejon lidhjen me të në rast të rënies së procesit kryesor dhe ofron menaxhim manual të kontejnerit pa e ri-krijuar atë. Loget dhe metrikat janë procese që ekzekutohen brenda kontejnerit. Edhe ato duhet të kontrollohen në një farë mënyre, dhe ne e bëjmë këtë përmes supervizorit. Së fundi, S6 merr përsipër kryerjen e punëve të shtëpisë, përpunimin e sinjaleve dhe detyra të tjera.
Pasi aplikojmë sisteme të ndryshme orkestrimi, pas grumbullimit dhe aktivizimit, kontejneri duhet të kuptojë se në cilin mjedis ndodhet dhe të veprojë sipas situatës. Për shembull:
Kjo na lejon të grumbullojmë një imazh dhe ta aktivizojmë atë në sisteme të ndryshme orkestrimi, dhe ai do të aktivizohet duke marrë parasysh specifikat e këtij sistemi orkestrimi.
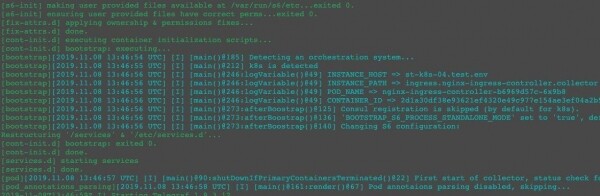
Për të njëjtin kontejner, ne marrim struktura të ndryshme procesi në Docker dhe Kubernetes:
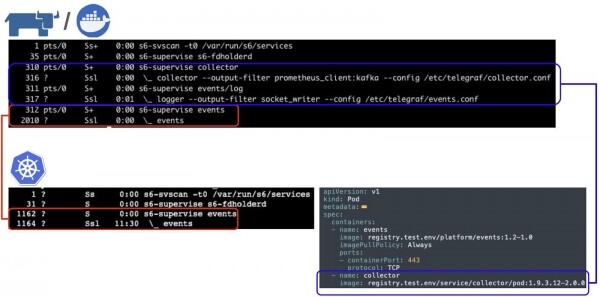
Ngarkesa ekzekutohet nën supervizorin S6. Vini re collector dhe events — këto janë agjentët tanë që përgjigjen për logët dhe metrikat. Në Kubernetes ata nuk ekzistojnë, ndërsa në Docker po. Pse?
Nëse shohim specifikimin e 'pod'-it (këtu e tutje – Kubernetes pod), do të shohim se kontejneri events ekzekutohet në podin ku ndodhet një kontejner tjetër collector, që kryen funksionin e mbledhjes së metrikave dhe logëve. Ne mund të shfrytëzojmë mundësitë e Kubernetes: aktivizimin e kontejnerëve në një pod, në një hapësirë procesi dhe/ose rrjeti të njëjtë. Në thelb, të implementojmë agjentët tanë dhe të realizojmë disa funksione. Dhe nëse ky kontejner aktivizohet në Docker, ai do të marrë të njëjtat mundësi, domethënë do të jetë në gjendje të dërgojë logë dhe metrika, pasi agjentët do të aktivizohen brenda.
Metrikat dhe logët
Dërgimi i metrikave dhe logëve është një detyrë e komplikuar. Zgjidhja e saj lidhet me disa aspekte.
Infrastruktura krijohet për të përmbushur ngarkesën e dobishme, jo për shpërndarjen masive të logëve. Pra, ky proces duhet të kryhet me kërkesa minimale për burimet e kontejnerëve. Ne përpiqemi të ndihmojmë zhvilluesit tanë: "Merrni një kontejner nga Docker Hub, hapeni, dhe ne do të mund të dërgojmë logët."
Aspekti i dytë — kufizimi i vëllimit të logëve. Nëse disa kontejnerë përjetojnë një shpërthim të vëllimit të logëve (një aplikacion në cikël tregon stack-trace), rritet ngarkesa mbi CPU, lidhjet dhe sistemin e përpunimit të logëve, dhe kjo ndikon në funksionimin e hostit në përgjithësi dhe të kontejnerëve të tjerë në host, ndonjëherë duke çuar në "rënien" e hostit.
Aspekti i tretë — është e nevojshme të mbështeten sa më shumë metodika të mbledhjes së metrikave nga kutia. Nga leximi i skedarëve dhe pyetja e pikës së fundit Prometheus deri te përdorimi i protokolleve specifike të aplikacioneve.
Dhe aspekti i fundit — është e nevojshme të minimizohet konsumimi i burimeve.
Ne zgjodhëm një zgjidhje open-source në Go të quajtur Telegraf. Ky është një konktor universal që mbështet më shumë se 140 lloje të kanalizimeve të hyjshëm (input plugins) dhe 30 lloje të kanalizimeve të dalëse (output plugins). Ne e kemi përmirësuar dhe tani do t'ju tregojmë se si e përdorim atë në shembullin e Kubernetes.
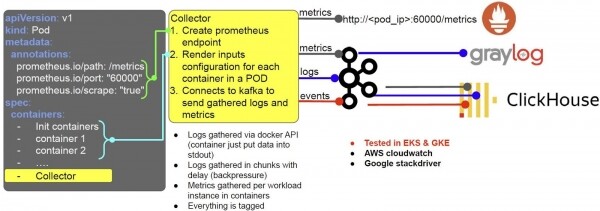
Supozoni se zhvilluesi shpërndan ngarkesën dhe Kubernetes merr një kërkesë për të krijuar një pod. Në këtë moment për çdo pod krijohet automatikisht një kontejner i quajtur Collector (ne përdorim mutation webhook). Collector është agjenti ynë. Në fillim, ky kontejner e konfiguroni veten për të punuar me Prometheus dhe sistemin e mbledhjes së logëve.
- Për këtë, ai përdor anotimet e pod-it, dhe në varësi të përmbajtjes së saj, krijon, le të themi, një pikë fundit të Prometheus;
- Në bazë të specifikacioneve të pod-it dhe parametrave specifikë të kontejnerëve, vendos se si të dërgojë logët.
Ne mbledhim logët përmes Docker API: zhvilluesit mjafton t'i vendosin ato në stdout ose stderr, dhe pastaj Collector do të merret me to. Logët mblidhen në grupe me disa vonesa, për të parandaluar mbingarkesën e mundshme të hostit.
Metrikat mblidhen sipas instancave të ngarkesës së punës (proceseve) në kontejnerë. Gjithçka shënohet me etiketa: namespace, pod dhe kështu me radhë, dhe pastaj konvertohet në formatin Prometheus – dhe bëhet e disponueshme për mbledhje (përveç logëve). Po ashtu, logët, metrikat dhe ngjarjet ne i dërgojmë në Kafka dhe më pas:
- Logët janë të disponueshme në Graylog (për analizë vizuale);
- Logët, metrikat, dhe ngjarjet dërgohen në Clickhouse për ruajtje afatgjatë.
Po ashtu punon gjithçka në AWS, vetëm se ne zëvendësojmë Graylog me Kafka me Cloudwatch. Dërgojmë logët atje, dhe gjithçka bëhet shumë e convenient: menjëherë kuptohet, për cilin klaster dhe kontejner i takojnë. E njëjta gjë vlen edhe për Google Stackdriver. Kjo do të thotë se skema jonë punon si on-premise me Kafka, ashtu edhe në cloud.
Nëse nuk kemi Kubernetes me pod-e, skema bëhet pak më e komplikuar, por punon sipas të njëjtave principe.
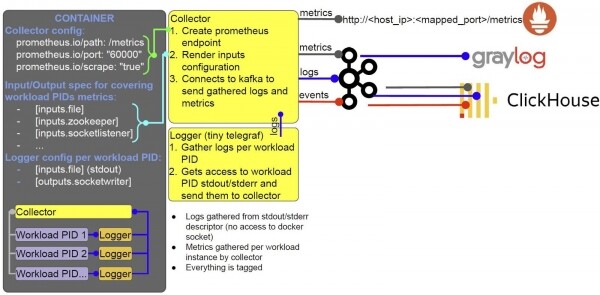
Brenda kontejnerit ekzekutohen procese të njëjta, të orkestruara me S6. Të njëjtat procese janë të ngarkuara brenda një kontejneri.
Në fund
Krijuam një zgjidhje të plotë për ndërtimin dhe ekzekutimin e imazheve në prodhim, me mundësi për mbledhjen dhe dërgimin e logëve dhe metrikave:
- Kemi zhvilluar një qasje të standardizuar për ndërtimin e imazheve, mbi të cilën kemi zhvilluar CI-shabllonet;
- Agjentët për mbledhjen e të dhënave janë zgjerime tona Telegraf. I kemi testuar mirë në prodhim;
- Përdorim webhook të mutation për implementimin e kontejnerëve me agjentë në pod-e;
- Jemi integruar në ekosistemin Kubernetes/Rancher;
- Mund të ekzekutojmë kontejnerë të njëjtë në sisteme të ndryshme orkestrimi dhe të marrim rezultatin që presim;
- Krijuam një konfigurim të plotë dinamik për menaxhimin e kontejnerëve.
Bashkëautor: Ilya Prudnikov
Burimi: habr.com
