

E ardhmja ka ardhur, teknologjitë e inteligjencës artificiale dhe mësimit të makinave tashmë po përdoren me sukses nga dyqanet tuaja të preferuara, kompanitë e transportit dhe madje edhe fermat që rritin halvaret.
Dhe nëse diçka ekziston, atëherë do të ketë informacion për të… një projekt të hapur! Shihni si Open Data Hub ndihmon në shkallëzimin e teknologjive të reja dhe shmangien e vështirësive gjatë implementimit të tyre.
Për të gjitha përfitimet e inteligjencës artificiale (artificial Intelligence, AI) dhe mësimit të makinave (machine learning, ML), organizatat shpesh hasin vështirësi në shkallëzimin e këtyre teknologjive. Problemet kryesore zakonisht janë si më poshtë:
- Shkëmbimi i informacionit dhe bashkëpunimi – është praktikisht e pamundur të shkëmbehet informacion pa mundime dhe të bashkëpunoni në mënyrë të shpejtë.
- Qasja në të dhëna – për çdo detyrë duhet të ndërtohet nga fillimi dhe manualisht, që merr shumë kohë.
- Qasja sipas kërkesës – nuk ka mundësi për të marrë qasje on-demand në mjetet dhe platformën e mësimit të makinave, si dhe në infrastrukturën llogaritëse.
- Prodhimi – modelet mbeten në fazën e prototipit dhe nuk arrijnë në prodhimin masiv.
- Gjetja dhe shpjegimi i rezultateve të AI – riprodhueshmëria, ndjekja dhe shpjegimi i rezultateve të AI/ML janë të vështira.
Nëse këto probleme lihen të patrajtuara, ato ndikojnë negativisht në shpejtësinë, efikasitetin dhe produktivitetin e specialistëve të vlefshëm të të dhënave dhe analizës. Kjo çon në frustrim, zhgënjim në punë, dhe përfundimisht presionet e biznesit ndaj AI/ML shkojnë në rrugë të gabuar.
Përgjegjësia për zgjidhjen e këtyre problemeve i takon specialistëve të IT-së, të cilët duhet të ofrojnë analistëve të të dhënave – saktësisht, diçka si një cloud. Nëse dëshirohet më në detaje, nevojitet një platformë që ofron lirinë e zgjedhjes dhe ka akses të thjeshtë dhe të lehtë. Ajo duhet të jetë e shpejtë, duhet të rregullohet lehtësisht, të shkallëzohet sipas kërkesës dhe të jetë rezistente ndaj dështimeve. Ndërtimi i një platforme të tillë mbi teknologji me kod të hapur ndihmon në shmangien e varësisë nga shitësit dhe ruan një avantazh strategjik afatgjatë në kontrollin e kostove.
Para disa vjetësh, diçka e ngjashme ndodhte në zhvillimin e aplikacioneve, duke çuar në lindjen e mikroshërbimeve, mjediseve hibride të cloud-it, automatizimit IT dhe proceseve agile. Për të përballuar të gjitha këto, profesionistët IT filluan të përdorin kontejnerë, Kubernetes dhe cloud-e hibride të hapura.
Tani kjo përvojë aplikohet për të përballuar sfidat e AI. Prandaj, profesionistët IT krijojnë platforma që mbështeten në kontejnerë, lejojnë krijimin e shërbimeve AI/ML brenda proceseve agile, përshpejtojnë inovacionet dhe ndërtohen me fokus në cloud-in hibrid.
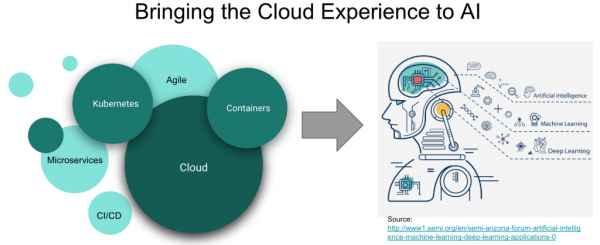
Ndërtimin e një platforme të tillë do ta fillojmë me Red Hat OpenShift, platformën tonë të kontejnerëve Kubernetes për cloud-in hibrid, e cila ka një ekosistem në rritje të zgjidhjeve softuerike dhe harduerike ML (NVIDIA, H2O.ai, Starburst, PerceptiLabs, etj.). Disa nga klientët e Red Hat, si BMW Group, ExxonMobil dhe të tjerë, tashmë kanë zbatuar zinxhirë kontejnerëzish të mjeteve ML dhe proceseve DevOps mbi këtë platformë dhe ekosistemin e saj, për të çuar arkitekturën e tyre ML në një status industrial dhe për të përshpejtuar punën e analistëve të të dhënave.
Një arsye tjetër pse ne filluam projektin Open Data Hub është të tregojmë një shembull të arkitekturës mbi disa projekte të hapura dhe të shfaqim se si mund të realizohet e gjithë cikli i zgjidhjes ML mbi platformën OpenShift.
Projekti Open Data Hub
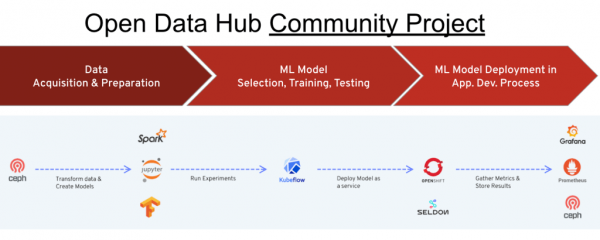
Ky është një projekt me kod të hapur, i cili zhvillohet në kuadër të komunitetit përkatës të zhvillimit dhe realizon ciklin e plotë të operacioneve – nga ngarkimi dhe transformimi i të dhënave fillestare deri te formimi, trajnimi dhe mbështetja e modelit – duke zgjidhur çështjet AI/ML me ndihmën e kontejnerëve dhe Kubernetes në platformën OpenShift. Ky projekt mund të shqyrtohet si një implementim referencë, një shembull se si të krijohet një zgjidhje të hapur të klasës "AI/ML si shërbim" mbi bazën e OpenShift dhe mjeteve përkatëse me kod të hapur, si Tensorflow, JupyterHub, Spark dhe të tjerë. Është e rëndësishme të theksohet se Red Hat e përdor këtë projekt për ofrimin e shërbimeve të saj AI/ML. Për më tepër, OpenShift integrohet me zgjidhjet kryesore softuerike dhe harduerike ML nga NVIDIA, Seldon, Starbust dhe të tjerë ofrues, duke lehtësuar ndërtimin dhe lançimin e sistemeve të veta të mësimit të makinave.
Projekti Open Data Hub është i orientuar drejt kategorive të mëposhtme të përdoruesve dhe skenarëve të përdorimit:
- Analisti i të dhënave, i cili ka nevojë për një zgjidhje për realizimin e projekteve ML, të organizuar në një model cloud me funksione vetë-shërbimi.
- Analisti i të dhënave, i cili ka nevojë për zgjedhje maksimale nga e gjithë larmia e instrumenteve dhe platformave të fundit AI/ML me kod të hapur.
- Analisti i të dhënave, i cili ka nevojë për qasje në burimet e të dhënave gjatë trajnimet e modeleve.
- Analisti i të dhënave, i cili ka nevojë për qasje në resurset kompjuterike (CPU, GPU, memorie).
- Analisti i të dhënave, i cili kërkon mundësinë për të bashkëpunuar dhe shkëmbyer rezultatet e punës me kolegët, për të marrë feedback dhe për të sjellë përmirësime përmes iteracioneve të shpejta.
- Analisti i të dhënave, i cili dëshiron të bashkëveprojë me zhvilluesit (dhe ekipet devops), për t'i çuar modelet dhe rezultatet e tij të ML në prodhim.
- Inxhinieri i të dhënave, i cili ka nevojë t'i japë analistit të të dhënave qasje në burime të ndryshme të të dhënave duke e respektuar standardet dhe kërkesat e sigurisë.
- Administrator/operator i sistemeve IT, i cili ka nevojë për mundësinë për të kontrolluar pa ndonjë përpjekje të tepërt ciklin e jetës (instalimi, konfigurimi, përditësimi) të komponentëve dhe teknologjive me kod të hapur. Po ashtu, i duhen instrumente për menaxhim dhe kuotim përkatës.
Projekti Open Data Hub bashkon një gamë të gjerë mjetesh me kod të hapur për realizimin e ciklit të plotë të operacioneve AI/ML. Si mjeti kryesor i punës për analistin e të dhënave këtu përdoret Jupyter Notebook. Ky instrument sot gëzon një popullaritet të gjerë mes specialistëve të përpunimit dhe analizës së të dhënave, dhe Open Data Hub u mundëson atyre të krijojnë dhe menaxhojnë lehtësisht hapësira pune Jupyter Notebook, duke përdorur JupyterHub të vendosur brenda. Përveç krijimit dhe importimit të notebooks Jupyter, projekti Open Data Hub gjithashtu përmban një seri notebooks të gatshme në formë të bibliotekës AI Library.
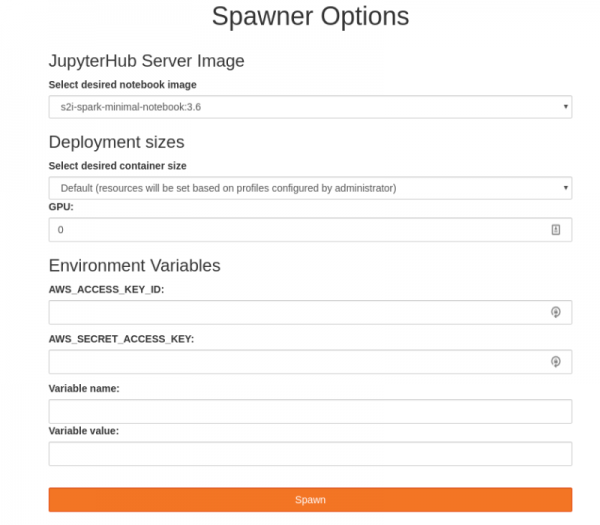
Kyta biblioteka është një koleksion komponentësh open-source të mësimit të makinerive dhe zgjidhjeve për skenarë të zakonshëm, duke e thjeshtuar prototipizimin e shpejtë. JupyterHub integrohet me modelin e qasjes RBAC të OpenShift, çka lejon përdorimin e llogarive ekzistuese të OpenShift dhe implementimin e një hyrjeje të vetme në sistem. Për më tepër, JupyterHub ofron një ndërfaqe përdoruesi të quajtur spawner, me anë të së cilës përdoruesi mund të konfigurojë lehtësisht sasinë e burimeve kompjuterike (nuk dhe procesorë, memorie, GPU) për Notebook-un e zgjedhur Jupyter.
Pasi analisti i të dhënave të ketë krijuar dhe konfiguruar notebook-un, të gjitha shqetësimet e tjera për të mbulohen nga planifikuesi Kubernetes, i cili është pjesë e OpenShift. Përdoruesit duhet vetëm të kryejnë eksperimentet e tyre, të ruajnë dhe të ndajnë rezultatet e punës së tyre. Për më tepër, përdoruesit e avancuar mund të aksesojnë drejtpërdrejt shell-in CLI të OpenShift nga Jupyter notebooks, për të angazhuar primitive të Kubernetes, siç është Job, ose funksionalitetin e OpenShift, si Tekton apo Knative. Ose për këtë, mund të përdorin GUI-në e përdoruesit të OpenShift të quajtur "web-console OpenShift."
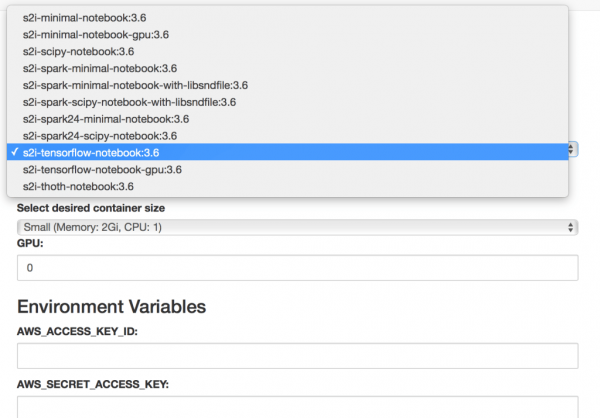
Duke kaluar në fazën e ardhshme, Open Data Hub ofron mundësinë për të menaxhuar konveyorët e të dhënave (data pipelines). Për këtë përdoret objekti Ceph, i cili ofrohet si një depo e dhënash përmbushëse S3. Apache Spark siguron transmetimin e të dhënave nga burime të jashtme ose depoja e brendshme Ceph S3, si dhe lejon kryerjen e transformimeve të parakohshme të të dhënave. Apache Kafka ofron menaxhim të avancuar për konveyorët e të dhënave (ku mund të kryhen ngarkesa të shumta, si dhe operacione transformimi, analize dhe ruajtjeje të të dhënave).
Pra, analisti i të dhënave ka akses në të dhëna dhe ka ndërtuar një model. Tani ai dëshiron të ndajë rezultatet e marra me kolegët ose zhvilluesit e aplikacioneve, duke iu ofruar atyre modelin e tij mbi parimin e shërbimit. Për këtë, nevojitet një server ndihmës, dhe Open Data Hub ka një server të tillë, të quajtur Seldon, i cili lejon publikimin e modelit si një shërbim RESTful.
Në një moment, në serverin Seldon, këto modele bëhen disa, dhe lind nevoja për monitorimin e përdorimit të tyre. Për këtë, Open Data Hub ofron një koleksion të metrikave përkatëse dhe një motor raportimi të bazuar në mjete të njohura monitorimi me kod të hapur si Prometheus dhe Grafana. Si rezultat, ne marrim feedback për monitorimin e përdorimit të modeleve AI, veçanërisht në ambientin e prodhimit.
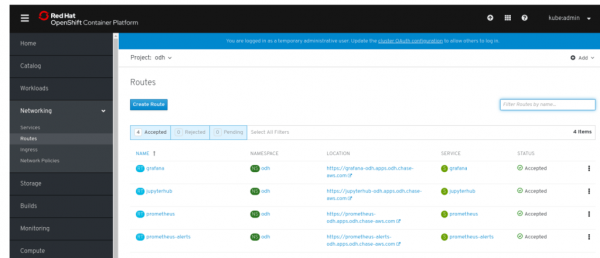
Kështu, Open Data Hub siguron një qasje si në re gjatë tërë ciklit të operacioneve AI/ML, duke filluar nga qasja dhe përgatitja e të dhënave dhe duke përfunduar me trajnim dhe kërcimin e modelit në prodhim.
Mblidhni gjithçka së bashku
Tani lind pyetja se si të organizohet tërë kjo nga administratori i OpenShift. Dhe këtu hyn në përdorim një operator i veçantë Kubernetes për projektet Open Data Hub.
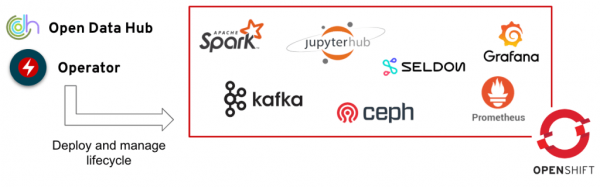
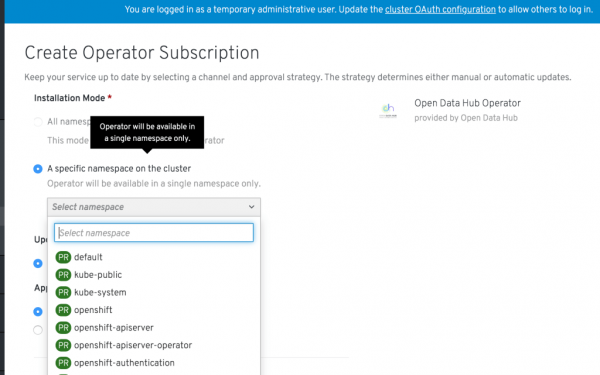
Ky operator menaxhon instalimin, konfigurimin dhe ciklin e jetës së projektit Open Data Hub, duke përfshirë depolimin e mjeteve të lartpërmendura si JupyterHub, Ceph, Spark, Kafka, Seldon, Prometheus dhe Grafana. Projekti Open Data Hub mund të gjendet në konsolën e webit të OpenShift, në seksionin e operatorëve komunitarë. Në këtë mënyrë, administratori i OpenShift mund të përcaktojë se projektet përkatëse të OpenShift përfshihen në kategorinë "projekti Open Data Hub". Kjo bëhet një herë. Pas kësaj, analisti i të dhënave kalon përmes konsolës së webit të OpenShift në hapësirën e tij të projekteve dhe sheh se për projektet e tij është instaluar dhe në dispozicion operatori përkatës Kubernetes. Pastaj ai krijon një instancë të projektit Open Data Hub me një klik të vetëm dhe menjëherë merr qasje në mjetet e përmendura më parë. Dhe gjithë kjo mund të konfigurohet në një mod të lartë të disponueshmërisë dhe qëndrueshmërisë.
Nëse dëshiron ta provosh projektin Open Data Hub me duar, fillo me . Detajet teknike të arkitekturës së Open Data Hub mund të gjenden , planet për zhvillimin e projektit – . Në të ardhmen, planifikohet të realizohet një integrim shtesë me Kubeflow, të zgjidhen disa çështje rregullative dhe sigurie, si dhe të organizohet integrimi me sistemet e bazuara në rregulla Drools dhe Optaplanner. Të shprehësh mendimin tënd dhe të bëhesh pjesë e projektit mund të bëhet në faqen .
Në përmbledhje: problemet serioze me shkallëzimin pengojnë organizatat të realizojnë plotësisht potencialin e inteligjencës artificiale dhe mësimit automat. Red Hat OpenShift është përdorur prej kohësh me sukses për të zgjidhur probleme të ngjashme në industrinë e softuerit. Projekti Open Data Hub, i realizuar në kuadër të komunitetit zhvillues me kod të hapur, ofron një arkitekturë standarde për organizimin e ciklit të plotë të operacioneve AI/ML mbi bazën e Cloud-it hibrid OpenShift. Ne kemi një plan të qartë dhe të menduar për zhvillimin e këtij projekti dhe jemi të vendosur për të krijuar rreth tij një komunitet aktiv dhe produktiv zhvilluesish të zgjidhjeve AI me kod të hapur në platformën OpenShift.
Burimi: habr.com
