

Sot, do të flasim sot për mënyrat më të mira të ruajtjes së të dhënave në një botë ku rrjetet e gjeneratës së pestë, skanerët e genomit dhe automjetet pa drejtues prodhojnë çdo ditë më shumë të dhëna se sa ka prodhuar e gjithë njerëzimi deri në revolucionin industrial.
Bota jonë po gjeneron gjithnjë e më shumë informacion. Disa nga këto janë kalimtare dhe humbasin po aq shpejt sa mblidhen. Të tjera duhet të ruhen për një periudhë më të gjatë, ndërsa disa janë të destinuara "për shekuj" — të paktën, kështu na duket nga perspektiva e tanishme. Rrymat informative vendosen në qendrat e të dhënave me një shpejtësi të tillë, saqë çdo qasje e re, çdo teknologji, që synon të përmbushë këtë "kërkesë" të pafund, bëhet shpejt e vjetruar.
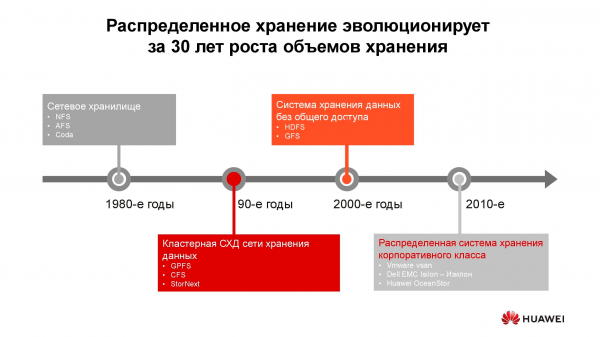
40 vjet zhvillimi i sistemeve të shpërndara të ruajtjes
Sistemet e para të ruajtjes në rrjet, siç i njohim ne sot, u shfaqën në vitet 1980. Shumë prej jush kanë hasur në NFS (Sistemi i Skedarëve në Rrjet), AFS (Sistemi i Skedarëve Andrew) ose Coda. Pas një dekade, moda dhe teknologjitë kanë evoluar, dhe sistemet e shpërndara të skedarëve janë zëvendësuar nga sistemet e ruajtjes në klastra mbi bazën e GPFS (Sistemi i Skedarëve me Paralel të Përgjithshëm), CFS (Sistemet e Skedarëve të Klastrave) dhe StorNext. Në bazë të këtyre, u përdorën ruajtjet bllokuese me arkitekturë klasike, mbi të cilat, përmes një shtrese të programuar, u krijua një sistem i vetëm skedarësh. Këto dhe zgjidhje të ngjashme akoma përdoren, zënë pozitat e tyre dhe janë mjaft të kërkuara.
Në prag të mijëvjeçarit, paradigma e ruajtjeve të shpërndara kaloi disa ndryshime, dhe sistemet me arkitekturë SN (Shared-Nothing) dolën në pozita udhëheqëse. U kalua nga ruajtja në klaster në ruajtje në nyje individuale, të cilat, zakonisht, ishin serverë klasikë që ofronin një ruajtje të besueshme të softuerit; mbi këto parime, janë ndërtuar, për shembull, HDFS (Sistemi i Shpërndarë i Skedarëve Hadoop) dhe GFS (Sistemi Global i Skedarëve).
Përpara vitit 2010, konceptet e integruara në sistemet e shpërndara të ruajtjes filluan gjithnjë e më shpesh të reflektohen në produkte komerciale të plota, si VMware vSAN, Dell EMC Isilon dhe tona . Pas platformave të përmendura qëndrojnë jo më vetëm komunitete entuziastësh, por ofrues të caktuar, të cilët përgjigjen për funksionalitetin, mbështetje, shërbimin e produktit dhe garantojnë zhvillimin e tij të mëtejshëm. Të tilla zgjidhje janë më të kërkuara në disa fusha.
O operatorët e komunikacionit
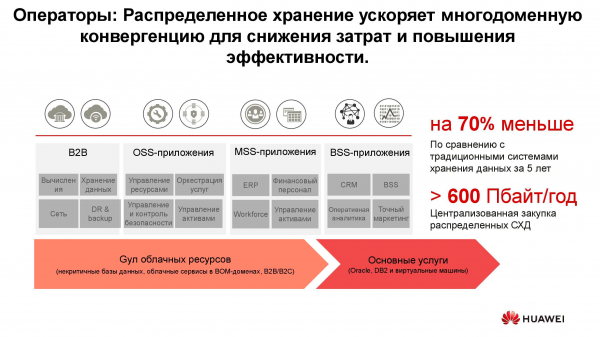
Një nga konsumatorët më të vjetër të sistemeve të shpërndara të ruajtjes janë operatorët e komunikimeve. Në diagram, tregohet se cilat grupe aplikacionesh prodhojnë shumicën e të dhënave. OSS (Sistemet e Mbështetjes për Operacionet), MSS (Shërbimet e Mbështetjes për Menaxhimin) dhe BSS (Sistemet e Mbështetjes për Biznesin) përbëjnë tre nivele programi që plotësojnë njëri-tjetrin, të nevojshme për ofrimin e shërbimeve për abonentët, raporteve financiare për ofruesin dhe mbështetje operacionale për inxhinierët e operatorit.
Shpesh të dhënat e këtyre niveleve janë të përziera me njëra-tjetrën, dhe për të shmangur akumulimin e kopjeve të panevojshme, përdoren pikërisht ruajtjet e shpërndara, të cilat akumulojnë gjithë informacionin që vjen nga rrjeti në funksion. Ruajtjet bashkohen në një rezervuar të përbashkët, të cilit i drejtohen të gjitha shërbimet.
Llogaritjet tona tregojnë se kalimi nga ruajtjet tradicionale në ato bllok mund të kursejë deri në 70% të buxhetit thjesht duke hequr dorë nga ruajtjet hi-end të dedikuara dhe duke përdorur serverë të zakonshëm të arkitekturës tradicionale (zakonisht x86), që punojnë në bashkëpunim me software të specializuar. Operatorët celularë prej kohësh kanë filluar të blejnë zgjidhje të tilla në sasi domethënëse. Në veçanti, operatorët rusë e përdorin këtë lloj produkti nga Huawei për më shumë se gjashtë vjet.
Po, disa detyra nuk mund të realizohen me sistemet e shpërndara. Për shembull, në rastin e kërkesave të larta për performancë ose për pajtueshmëri me protokollet e vjetra. Por jo më pak se 70% e të dhënave që proceson operatori, mund të vendosen në një rezervuar të shpërndarë.
Sektori Bankar
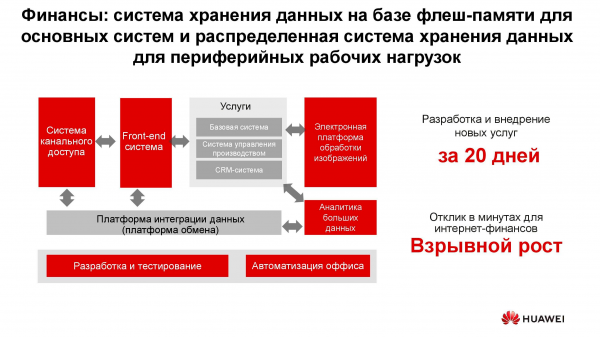
Në çdo bankë coexistojnë shumë sisteme IT të ndryshme, nga procesimi deri në sistemin bankar automatizuar. Kjo infrastrukturë gjithashtu punon me një volum të madh informacioni, dhe shumë nga detyrat nuk kërkojnë performancë të lartë ose besueshmëri të sistemeve të ruajtjes, për shembull zhvillimi, testimi, automatizimi i proceseve zyrtare etj. Këtu përdorimi i ruajtjeve tradicionale është i mundshëm, por çdo vit bëhet gjithnjë e më pak i përballueshëm. Për më tepër, në këtë rast mungon fleksibiliteti i shpenzimit të burimeve të ruajtjeve, performanca e të cilave llogaritet nga ngarkesa maksimale.
Në përdorimin e sistemeve të shpërndara të ruajtes, nyjat e tyre, të cilat në fakt janë serverë të zakonshëm, mund të konvertohen në çdo moment, për shembull, në një fermë serverësh dhe të përdoren si një platformë llogaritjeje.
Liqenet e të dhënave
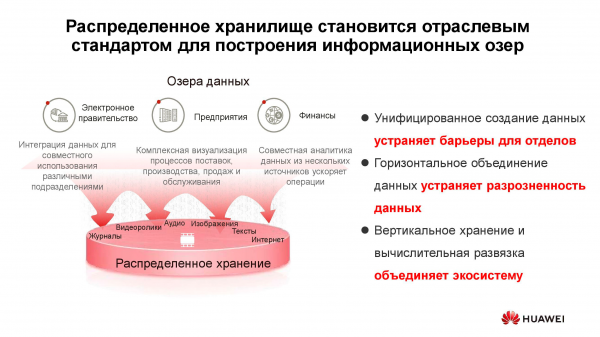
Në diagramin e sipërm është paraqitur një listë e konsumatorëve tipikë të shërbimeve . Këtu mund të jenë shërbimet e qeverisë elektronike (për shembuj, "Shërbimet Shtetërore"), të cilat kanë përfunduar digitalizimin e ndërmarrjeve, strukturat financiare etj. Të gjithë ata kanë nevojë të punojnë me sasi të mëdha informacioni heterogjen.
Eksplorimi i sistemeve të ruajtjes tradicionale për të zgjidhur këto detyra është i pafavorshëm, pasi kërkohet si akses me performancë të lartë në bazat e dhënash me blloqe, ashtu edhe akses të zakonshëm në bibliotekat e dokumenteve të skanuara që ruhen si objekte. Këtu mund të lidhet, për shembull, një sistem porosish përmes portalit web. Për ta realizuar të gjitha këto në një platformë të sistemit tradicional të ruajtjes, do të nevojitet një sasi e madhe pajisjesh për detyra të ndryshme. Një sistem horizontal universali i ruajtjes mund të mbulojë të gjitha detyrat e përmendura më parë: do të kërkohet vetëm të krijohen disa grupe me karakteristika të ndryshme ruajtjeje.
Gjeneruesit e informacionit të ri
Sasia e informacionit të ruajtur në botë rritet për rreth 30% në vit. Këto janë lajme të mira për ofruesit e sistemeve të ruajtjes, por çfarë është dhe do të jetë burimi kryesor i këtyre të dhënave?
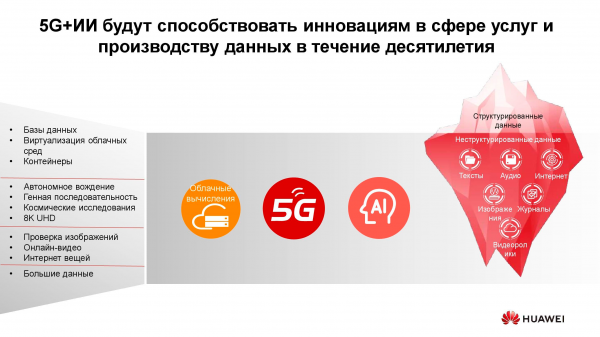
Dhjetë vjet më parë, këta gjenerues u bënë rrjetet sociale, çka kërkoi krijimin e një sasi të madhe algoritmesh të rinj, zgjidhjesh harduerike etj. Aktualisht, dallohet tre motorë kryesorë të rritjes së sasisë së ruajtjes. I pari — cloud computing. Në këtë moment, rreth 70% e kompanive përdorin në një farë mënyre shërbime në re. Këto mund të jenë sisteme email-i, kopje rezervë dhe entitete të tjera të virtualizuara.
Motor i dytë bëhen rrjetet e gjeneratës së pestë. Këto sjellin shpejtësi të reja dhe sasi të reja të transferimit të të dhënave. Sipas parashikimeve tona, përhapja e gjerë e 5G do të çojë në një rënie të kërkesës për kartat e flash memory. Sa herë që ka memorie në telefon, ajo gjithmonë mbaron, dhe nëse pajisja ka një kanal 100 megabit, nuk ka asnjë nevojë për të ruajtur fotografitë lokalmente.
Grupi i tretë i arsyeve për të cilat rritet kërkesa për sistemet e ruajtjes është zhvillimi i shpejtë i inteligjencës artificiale, kalimi në analitikën e të dhënave të mëdha dhe tendenca për automatizimin e gjithçkaje.
Veçantia e "trafikut të ri" është . Ne duhet të ruajmë këto të dhëna, pa e përcaktuar formatin e tyre. Ai kërkohet vetëm gjatë leximit të mëvonshëm. Për shembull, një sistem bankar skoringu për të përcaktuar madhësinë e kredisë së mundshme do të shikojë fotografitë e postuara nga ju në rrjetet sociale, duke përcaktuar sa shpesh shkoni në det dhe në restorante, dhe njëkohësisht do të shqyrtojë të dhënat nga dokumentet tuaja mjekësore. Këto të dhëna, nga njëra anë, janë gjithëpërfshirëse, ndërsa nga ana tjetër, janë të çrregullta.
Oqeani i të dhënave të pastrukturara
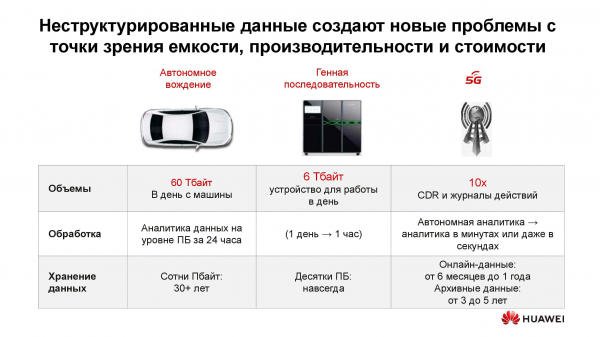
Cilat janë problemet që sjell shfaqja e "të dhënave të reja"? Problemi kryesor është, natyrisht, volumi i informacionit dhe afatet për ruajtjen e tij. Një vetëm automjeti modern autonom pa drejtues gjeneron çdo ditë deri në 60 Tbyte të dhënash nga të gjithë sensorët dhe mekanizmat e tij. Për të zhvilluar algoritmet e reja të lëvizjes, këto informacione duhet të përpunohen brenda të njëjtit ditë, përndryshe do të fillojnë të grumbullohen. Në të njëjtën kohë, ato duhet të ruhen për një kohë të gjatë — dekada. Vetëm atëherë në të ardhmen do të jetë e mundur të jepen përfundime mbi baza të mëdha analitike.
Një pajisje për dekodimin e sekuencave gjenetike prodhon rreth 6 Tbyte në ditë. Ndërsa të dhënat e mbledhura nga ajo faktikisht nuk parashikojnë fshirjen, dmth hipotekisht duhet të ruhen përjetësisht.
Së fundi, të njëjtat rrjete të gjeneratës së pestë. Përveç informacionit të vet që transmetohet, një rrjet i tillë është gjithashtu një gjenerues i madh të dhënash: regjistrat e veprimeve, regjistrat e telefonatave, rezultatet ndërmjetak të ndërveprimeve ndërmjet makinave, etj.
Të gjitha këto kërkojnë zhvillimin e qasjeve dhe algoritmeve të reja për ruajtjen dhe përpunimin e informacionit. Dhe këto qasje po shfaqen.
Teknologjitë e epokës së re
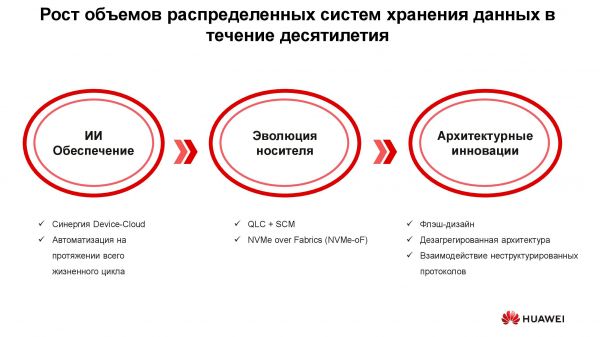
Mund të identifikohen tri grupe zgjidhjesh, të destinuara për të përballuar kërkesat e reja ndaj sistemeve të ruajtjes së informacionit: implementimi i inteligjencës artificiale, evolucioni teknik i mediave të të dhënave dhe inovacionet në arkitekturën sistemore. Le të fillojmë me IA.
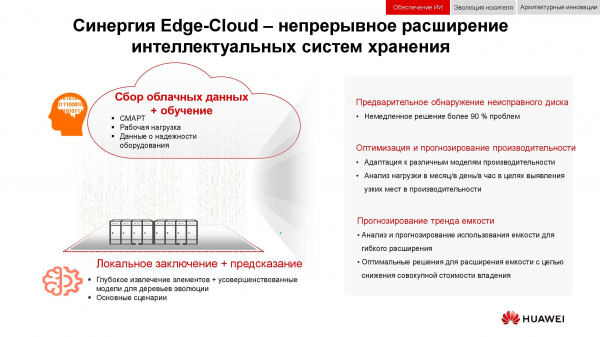
Në zgjidhjet e reja të Huawei, inteligjenca artificiale përdoret tani në nivelin e vetë ruajtjes, e cila është e pajisur me një procesor AI që lejon sistemin të analizojë vetë gjendjen e tij dhe të parashikojë dështimet. Nëse SxD lidhet me një re shërbimi që ka kapacitete të konsiderueshme llogaritëse, inteligjenca artificiale do të jetë në gjendje të përpunojë më shumë informacion dhe të rrisë saktësinë e hipotezave të saj.
Përveç dështimeve, një I.A. e tillë di të parashikojë ngarkesën e ardhshme maksimale dhe kohën e mbetur deri në shterimin e kapacitetit. Kjo mundëson optimizimin e performancës dhe shkallëzimin e sistemit para se të ndodhin ngjarje të padëshiruara.
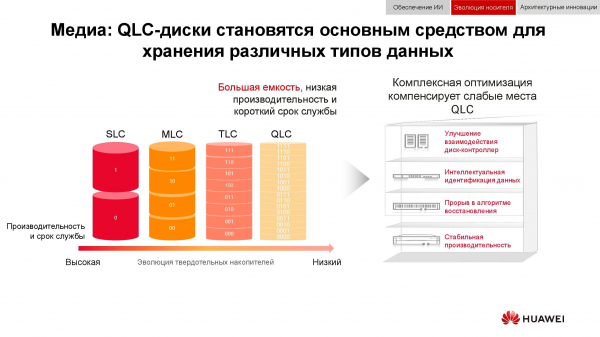
Tani për evoluimin e mjetëve të ruajtjes së të dhënave. Flash-t e para ishin realizuar me teknologjinë SLC (Single-Level Cell). Pajisjet e bazuara në të ishin të shpejta, të sigurta, stabile, por kishin kapacitet të vogël dhe kushtonin shumë. Rritja e volumit dhe ulja e çmimit arritën përmes disa kompromisve teknike, të cilat reduktuan shpejtësinë, besueshmërinë dhe jetën e pajisjeve. Megjithatë, trendi nuk ndikoi në vetë SxD-të, të cilat përmes larash arkitektonike u bënë më të performuara dhe më të besueshme në përgjithësi.
Por pse ishin të nevojshme SxD-të e klasës All-Flash? A nuk mjaftonte thjesht të zëvendësonim HDD-të e vjetra në sistemin që ishte duke u përdorur me SSD të rinj me të njëjtin formati? Kjo ishte e nevojshme për të shfrytëzuar në mënyrë efikase të gjitha burimet e reja të ruajtjes solide, gjë që në sistemet e vjetra nuk ishte e mundur.
Kompania Huawei, për shembull, për të zgjidhur këtë problem, zhvilloi një gamë të tërë teknologjish, njëra prej të cilave ishte , e cila i mundësoi optimizimin maksimal të bashkëveprimit "disk - kontrollues".
Identifikimi inteligjent ofroi mundësinë të shpërndajë të dhënat në disa rrjedha dhe të përballet me disa fenomene të padëshiruara, siç është (shkalla e shkruar). Në të njëjtën kohë, algoritmet e reja të rikuperimit, në veçanti , rritën shpejtësinë e ribuild-it, duke e reduktuar kohën në shifra krejtësisht të pavlefshme.
Dështimi, mbipopullimi, "grumbullimi i mbeturinave" - këto faktorë gjithashtu nuk ndikojnë më në performancën e sistemit të ruajtjes për shkak të modifikimeve të veçanta të kontrolluesve.
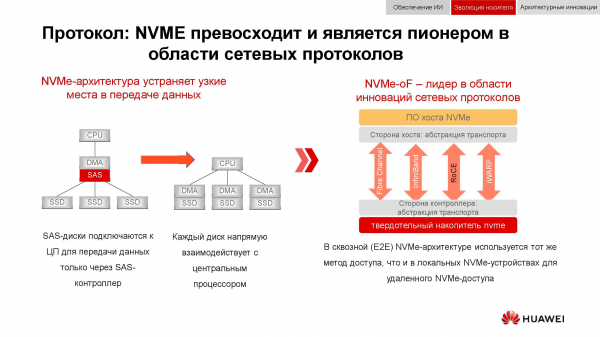
Dhe gjithashtu, magazinat e bllokut të të dhënave po përgatiten për të pritur . Kujtojmë se skema klasike e organizimit të aksesit në të dhëna funksiononte si më poshtë: procesori i drejtohej kontrolerit RAID përmes autobusit PCI Express. Ky i fundit, nga ana e tij, bashkëpunonte me diskët mekanikë përmes SCSI ose SAS. Përdorimi i NVMe në backend e përshpejtoi dukshëm gjithë procesin, megjithatë kishte një disavantazh: ngjitesit duhet të kishin një lidhje të drejtpërdrejtë me procesorin për të siguruar aksesin e drejtpërdrejtë në memorie.
Faza e ardhshme e zhvillimit të teknologjisë, të cilën po e vëzhgojmë tani, është përdorimi i NVMe-oF (NVMe mbi Fabrika). Sa i përket teknologjive të bllokut Huawei, ato tani mbështesin FC-NVMe (NVMe mbi Fiber Channel), dhe po afrohet NVMe mbi RoCE (RDMA mbi Ethernet e Konvergjuar). Modelet testuese janë plotësisht funksionale, deri në prezantimin e tyre zyrtar kanë mbetur disa muaj. Vlen të theksohet se e gjithë kjo do të shfaqet edhe në sistemet e shpërndara, ku “Ethernet pa humbje” do të jetë mjaft i kërkuar.
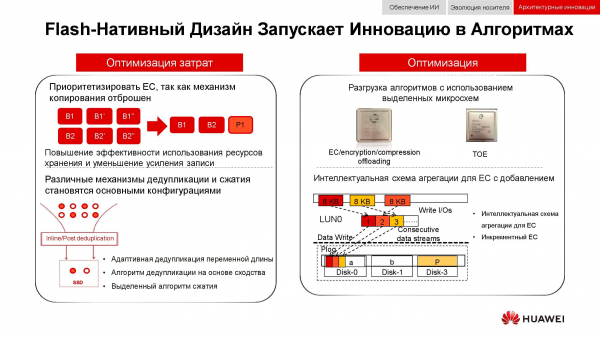
Një mënyrë shtesë për optimizimin e punës së saktë të magazinave të shpërndara ishte heqja e plotë e pasqyrimit të të dhënave. Zgjidhjet e Huawei nuk përdorin më n kopje, si në RAID 1 të njohur, dhe kalojnë plotësisht në mekanizmin (Kodimi i të dhënave). Një paketë matematikore speciale në një periudhë të caktuar llogarit blloket kontrolluese, që mundësojnë rikuperimin e të dhënave të ndërmjetme në rast humbjeje.
Mekanizmat e deduplication dhe kompresionit po bëhen të domosdoshme. Në sistemet klasike të ruajtjes, jemi të kufizuar në numrin e procesorëve të instaluar në kontrolerë, ndërsa në sistemet e ruajtjes horizontale që shkallëzojnë, secila njësi përmban gjithçka të nevojshme: disqe, memorie, procesorë dhe ndër-konektim. Këto mundësi janë të mjaftueshme për të garantuar që deduplication dhe kompresioni të kenë një ndikim minimal në performancë.
Dhe mbi metodat harduerike të optimizimit. Këtu, arrijmë të ulim ngarkesën mbi procesorët qendrorë me anë të çipave të dedikuar (ose blloqeve të dedikuar në vetë procesorin), që veprojnë si (TCP/IP Offload Engine) ose që merret me detyrat matematikore EC, deduplication dhe kompresion.
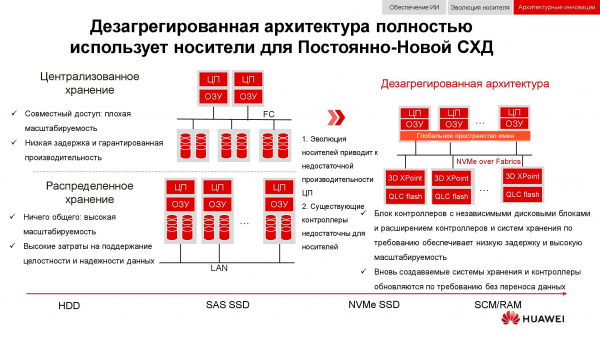
Qasht siqer u ruajtja e të dhënave ka gjetur përfaqësim në arkitekturën e dezagreguar (të shpërndarë). Në sistemet e ruajtjes qendrore ka një fabrikë serverësh, të lidhur përmes Fibre Channel me një numër të madh arrays. Disavantazhet e këtij qasje përfshijnë vështirësitë me shkallëzimin dhe sigurimin e nivelit të garantuar të shërbimit (për performancën ose vonesat). Sistemet hiper-konvergente përdorin të njëjtat hoste - si për ruajtjen ashtu edhe për procesimin e informacionit. Kjo ofron një hapësirë praktike të pakufizuar për shkallëzim, por sjell kosto të larta për mbajtjen e integritetit të të dhënave.
Ndryshe nga të dyja arkitekturat e përmendura më sipër, arkitektura dezagreguese nënkupton ndarjen e sistemit në një fabrikë llogaritëse dhe një sistem horizontal ruajtjeje. Kjo ofron përfitime nga të dyja arkitekturat dhe lejon shkallëzimin e pakufizuar të vetëm elementit, performanca e të cilit është e pamjaftueshme.
Nga integrimi në konvergjencë
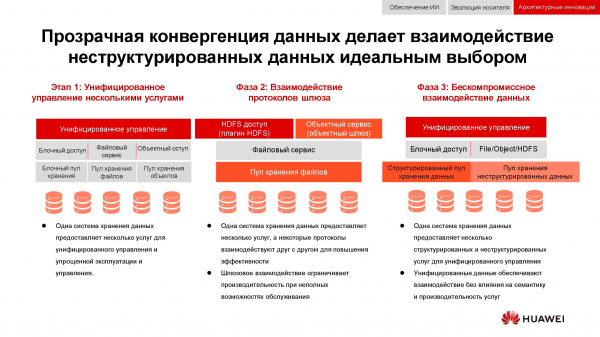
Një problem klasik, relevanca e të cilit është rritur gjatë 15 viteve të fundit, është nevoja për të siguruar njëkohësisht ruajtjen bllok, qasjen në skedarë, qasjen në objekte, punën e ferma për të dhëna të mëdha, etj. Një qendër në maj të tortës mund të jetë gjithashtu një sistem backup në lidhje me kasetat.
Në fazën e parë ishte e mundur të unifikohej vetëm menaxhimi i këtyre shërbimeve. Sistemet e ndryshme të ruajtjes së të dhënave ishin të mbyllura në një softuer të specializuar, përmes të cilit administratori shpërndante burimet nga basenet e disponueshme. Por, pasi që harduerët e këtyre baseneve ishin të ndryshëm, migrimi i ngarkesës midis tyre ishte i pamundur. Në një nivel më të lartë integrimi, bashkimi ndodhte në nivelin e portës. Nëse kishte një qasje të përbashkët në skedarë, ajo mund të jepte nëpër protokolle të ndryshme.
Metoda më e avancuar që kemi tani për konvergjencën nënkupton krijimin e një sistemi hibrid universal. Pikërisht kështu, siç duhet të bëhet . Qasja universale përdor të njëjtat burime harduerike, të ndara logjikisht në grupe të ndryshme, por që lejojnë migrimin e ngarkesës. Të gjitha këto mund të realizohen përmes një konsolë të vetme menaxhimi. Në këtë mënyrë kemi arritur të realizojmë konceptin «një Qendër të Dhënash — një Storage Area Network».
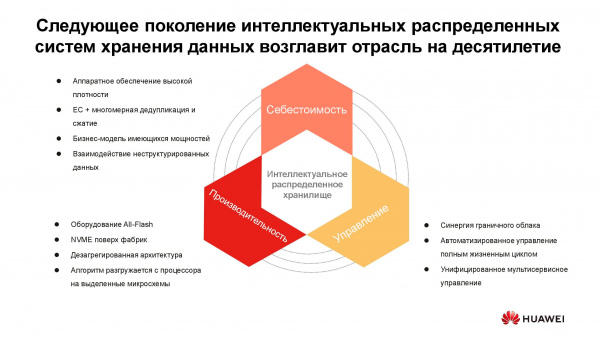
Kostoja e ruajtjes së informacionit tani përcakton shumë zgjidhje arkitekturore. Dhe ndonëse mund ta vendosim pa frikë në qendër, sot po diskutojmë për ruajtjen «në jetë» me qasje aktive, kështu që performanca gjithashtu duhet të merret parasysh. Një cilësi tjetër e rëndësishme e sistemeve të shpërndara të gjeneratës së ardhshme është unifikimi. Askush nuk dëshiron të ketë disa sisteme të shkëputura, të menaxhuara nga konsola të ndryshme. Të gjitha këto cilësi janë pasqyruar në serinë e re të produkteve Huawei. .
Storage Area Network masive të gjeneratës së re
OceanStor Pacific i plotëson kërkesat e besueshmërisë në nivelin «gjashtë nëntë» (99,9999%) dhe mund të përdoret për të ndërtuar Qendra të Dhënash të klasës HyperMetro. Me një distancë midis dy qendrave të dhënash deri në 100 km, sistemet tregojnë vonesën shtesë në nivelin 2 ms, duke lejuar ndërtimin e çdo zgjidhjeje të qëndrueshme ndaj fatkeqësive, përfshirë ato me servera quorum.
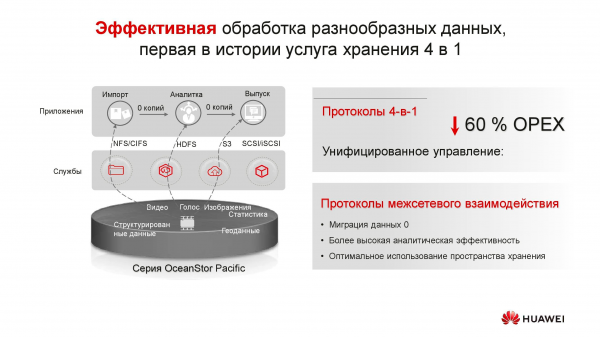
Produktet e serisë së re demonstrojnë universialitet me protokollet. Tani e tutje, OceanStor 100D mbështet aksesin blok, aksesin objekt dhe aksesin Hadoop. Në të ardhmen e afërt do të implementohet edhe accessi me skedarë. Nuk ka nevojë për të ruajtur kopje të shumta të të dhënave, nëse ato mund të jepen përmes protokoleve të ndryshme.
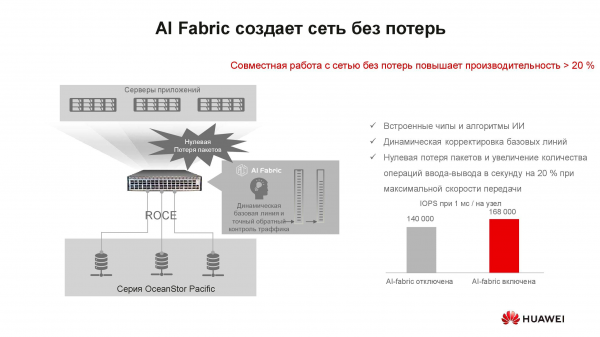
Duket si një pyetje e çuditshme, çfarë lidhjeje ka koncepti «rrjet pa humbje» me Storage Area Network? E vërteta është se sistemet e shpërndara të ruajtjes së të dhënave ndërtohen mbi një rrjet të shpejtë, që mbështet algoritmet përkatëse dhe mekanizmin RoCE. Shtesë në rritjen e shpejtësisë së rrjetit dhe uljen e vonesave ndihmon sistemi i inteligjencës artificiale që mbështetet nga switch-ët tanë. . Përfitimi i performancës së Storage Area Network me aktivizimin e AI Fabric mund të arrijë deri në 20%.
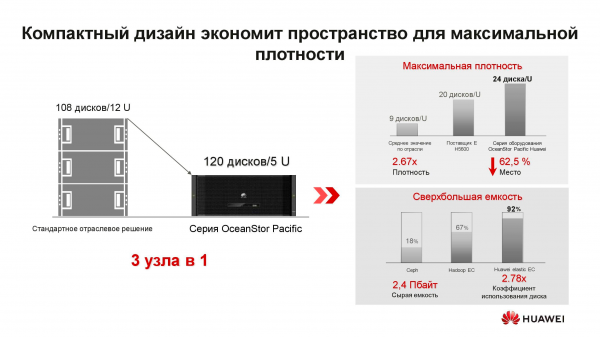
Çfarë përfaqëson një njësi të re të shpërndarë të Storage Area Network OceanStor Pacific? Zgjidhja me formë 5U përmban 120 njësitë dhe mund të zëvendësojë tre njësitë klasike, çka jep një kursim të hapësirës në raft më shumë se dyfish. Duke ndaluar ruajtjen e kopjeve, efikasiteti i njësive rritet ndjeshëm (deri në +92%).
Jemi mësuar se ruajtja e definuar nga software është një program i veçantë, i instaluar në një server klasik. Por tani, për të arritur parametrat optimalë, ky zgjidhje arkitekturore kërkon edhe njësitë speciale. Ajo përbëhet nga dy serverë të bazuar në procesorët ARM, të cilët menaxhojnë një grup disqesh tre inç.
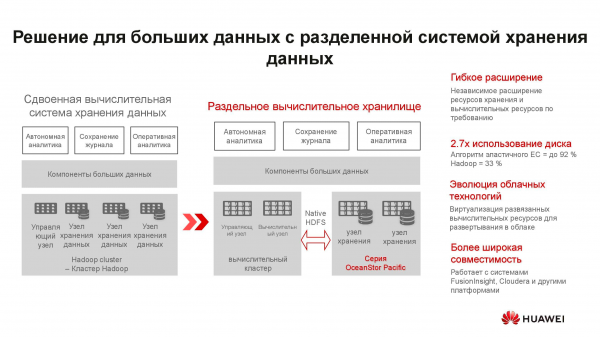
Këta serverë nuk janë të përshtatshëm për zgjidhje hiper-konvergjente. Së pari, ka shumë pak aplikacione për ARM, dhe së dyti, është e vështirë të përmbushesh balanca e ngarkesës. Ne sugjerojmë të kalojmë në ruajtje të ndarë: klasteri i llogarive, i paraqitur nga serverët klasikë ose rack-serverët, funksionon veçmas, por lidhet me njësitë e ruajtjes OceanStor Pacific, të cilat gjithashtu realizojnë detyrat e tyre direkte. Dhe kjo justifikohet.
Si një shembull, le të marrim një zgjidhje klasike për ruajtjen e të dhënave të mëdha me një sistem hiper-konvergjent që zë 15 shkallë serverësh. Nëse shpërndajmë ngarkesën mes serverëve të veçantë llogarish dhe njësive të ruajtjes OceanStor Pacific, duke i ndarë ato nga njëra-tjetra, numri i shkallëve të nevojshme do të reduktohet me gjysmën! Kjo zvogëlon kostot e eksploatimit të qendrës së të dhënave dhe ul koston totale të pronësisë. Në një botë ku sasia e informacionit të ruajtur rritet me 30% në vit, avantazhe të tilla nuk duhet të injorohen.
***
Më shumë informacion rreth zgjidhjeve të Huawei dhe skenarëve të aplicimit të tyre mund të merrni në ose duke kontaktuar drejtpërdrejt përfaqësuesit e kompanisë.
Burimi: habr.com
