

Ju lutem, njihni me përshkrimin e raportit të Nikolay Samokhvalov "Qasje industriale në tunimin e PostgreSQL: eksperimentet mbi bazat e të dhënave"
Shared_buffers = 25% – është shumë apo pak? A është saktësisht ashtu? Si të kuptoni nëse ky rekomandim – mjaft i vjetëruar – është i përshtatshëm për rastin tuaj të veçantë?
Ka ardhur koha për të trajtuar çështjen e përcaktimit të parametrave postgresql.conf "në një mënyrë më të qartë". Jo përmes "autotunerëve" të verbër ose këshillave të vjetruara nga artikuj dhe blogje, por në bazë të:
- eksperimentëve rigorozë në BD, të kryera automatizueshëm, në sasi të mëdha dhe në kushte sa më të afërta me "luftën".
- kuptimit të thellë të veçorive të funksionimit të DBMS dhe OS.
Duke përdorur Nancy CLI (), ne do të shqyrtojmë një shembull konkret – të njohurit shared_buffers – në situata të ndryshme, në projekte të ndryshme dhe do të përpiqemi të kuptojmë se si të përcaktojmë parametrin optimal për infrastrukturën tonë, BD dhe ngarkesën.
Bëhet fjalë për eksperimentet mbi bazat e të dhënave. Kjo është një histori që vazhdon pak më shumë se gjashtë muaj.
Pak për mua. Kam më shumë se 14 vjet përvojë me Postgres. Kam themeluar disa kompani në rrjete sociale. Kudo është përdorur dhe përdoret Postgres.
Po ashtu, grupi RuPostgres në Meetup, vendi i dytë në botë. Po afrohemi ngadalë drejt 2,000 anëtarëve. RuPostgres.org.
Dhe në konferenca të ndryshme, duke përfshirë Highload, unë jam përgjegjës për bazat e të dhënave, veçanërisht për Postgres që nga fillimi.
Dhe në vitet e fundit kam rinisur praktikën time të konsulencës për Postgres në 11 zona të kohës nga këtu.
Dhe kur e bëra këtë disa vjet më parë, pata një pushim në punën aktive manuale me Postgres, ndoshta që nga viti 2010. U habitëm sa pak kanë ndryshuar ditët e punës së DBA, sa shumë punë manuale duhet akoma të përdoret. Dhe menjëherë m'u duk se kishte diçka të gabuar, duhej të automatizoja më shumë gjëra.
Dhe pasi që gjithçka ndodhte në distancë, shumica e klientëve ishte në cloud. Dhe shumë është automatizuar tashmë. Për këtë do flasim më vonë. Kështu që kjo kaloi në ide, se duhet të ketë disa mjete, pra një platformë që do të automatizonte praktisht të gjitha veprimet e DBA, në mënyrë që të mund të menaxhonte numra të mëdha të bazave.
Në këtë raport nuk do të ketë:
- «Plumba të argjendtë» dhe deklarata si – vendosni 8 GB ose 25 % shared_buffers dhe do të jeni mirë. Për shared_buffers nuk do të flasim shumë.
- Hardcore "interiors".
And what will happen?
- There will be optimization principles that we apply and develop. There will be various ideas that come up along the way and different tools we mostly create in Open Source, meaning we build the foundation in Open Source. Moreover, we have tickets, and almost all communication happens in Open Source. You can see what we are currently doing, what will be in the next release, and so on.
- There will also be some experience using these principles and tools in a number of companies: from small startups to large corporations.
How is all this developing?
First of all, the main task of a DBA, besides ensuring the creation of instances, deploying backups, etc., is identifying bottlenecks and optimizing performance.
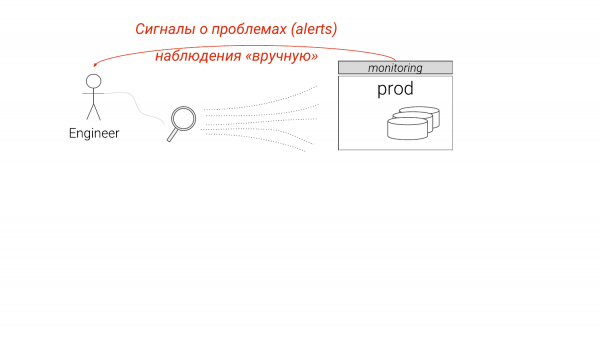
Currently, it's organized this way. We look at monitoring, we see something, but we lack some details. We start digging a little deeper, usually by hand, and understand what to do with it one way or another.
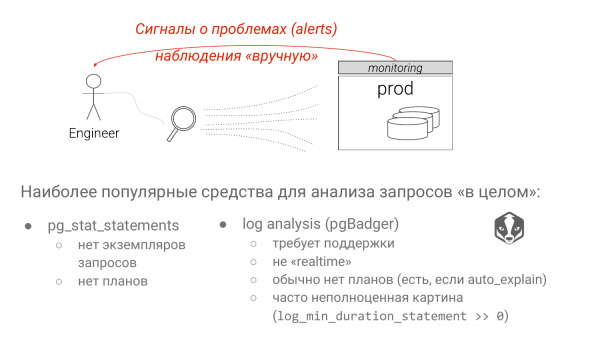
And there are two approaches. Pg_stat_statements is the standard default solution for identifying slow queries. And analyzing Postgres logs with pgBadger.
Each approach has serious drawbacks. The first approach discards all parameters. If we see groups like SELECT * FROM table where column equals sign "?" or "$" starting with Postgres version 10. We don't know if it's an index scan or a sequential scan. It heavily depends on the parameter. If you insert a rarely occurring value, there will be an index scan. If you insert a value that represents 90% of the table, it will obviously be a sequential scan, because Postgres knows the statistics. And that's a significant drawback of pg_stat_statements, although some work is being done on it.
The main drawback of log analysis is that you can't usually afford "log_min_duration_statement = 0". We'll also talk about this. Accordingly, you don't see the full picture. A very fast query could consume a huge amount of resources, but you won’t notice it because it’s below your threshold.
How do DBAs solve identified problems?
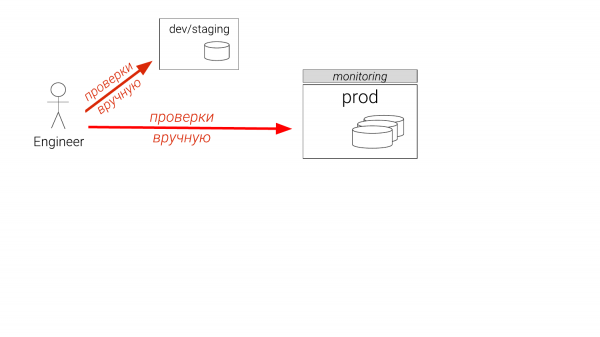
Për shembull, ne gjetëm ndonjë problem. Çfarë bëhet zakonisht? Nëse jeni zhvillues, do të bëni diçka në ndonjë instance, që nuk është aq shumë e madhe. Nëse jeni DBA, atëherë keni staging. Dhe mund të ketë vetëm një. Dhe ai ka mbetur pas gjysmë viti. Dhe mendoni se do të shkoni në production. Madhenj DBA të eksperiencës kontrollojnë më vonë në production, në replikë. Disa herë krijojnë një indeks temporar, sigurohen që ai ndihmon, e heqin dhe ia kthejnë zhvilluesve, që të fusin atë në skedarët e migrimit. Kjo është çfarë po ndodh tani. Dhe kjo është një e keqe.
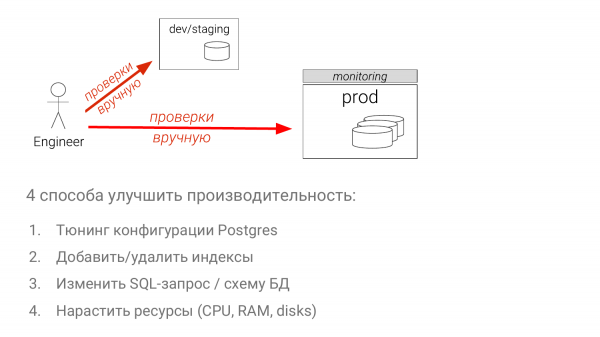
- Të tunim konfigurimet.
- Të optimizojmë grupin e indekseve.
- Të ndryshojmë vetë SQL-query (kjo është mënyra më e komplikuar).
- Të shtojmë kapacitete (mënyra më e thjeshtë në shumicën e rasteve).
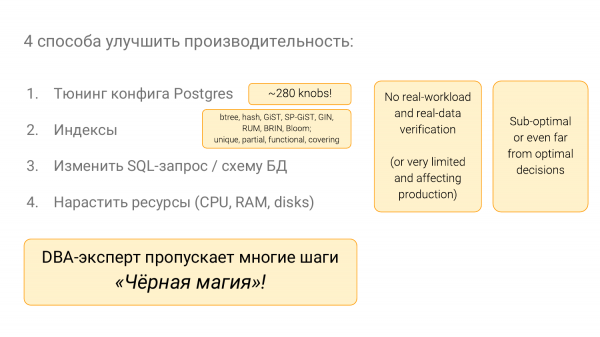
Me këto gjëra ka shumë për të thënë. Ka shumë kontrolla në Postgres. Duhet të dish shumë. Ka shumë indekse në Postgres, falë gjithashtu organizatorëve të këtij konferencë. Dhe të gjitha këto duhet t’i dish, dhe pikërisht kjo i jep ndjesinë që DBA po merret me magji të zezë. Domethënë, duhet të kalosh 10 vjet që të fillosh ta kuptosh dhe kjo saktë.
Dhe unë jam luftëtar kundër kësaj magjie të zezë. Dua të bëj gjithçka në një mënyrë që të ketë teknologji, e jo intuita në të gjitha këto.
Shembuj nga jeta
Këtë e kam vërejtur të paktën në dy projekte, duke përfshirë timin. Një postim tjetër në blog na informon se vlera 1,000 për default_statistic_target – është e mirë. E mirë, le të provojmë në production.
Dhe këtu ne, duke përdorur mjetin tonë dy vjet më vonë nëpërmjet eksperimenteve mbi bazat e të dhënave për të cilat flasim sot, mund të krahasojmë çfarë ishte dhe çfarë është tani.
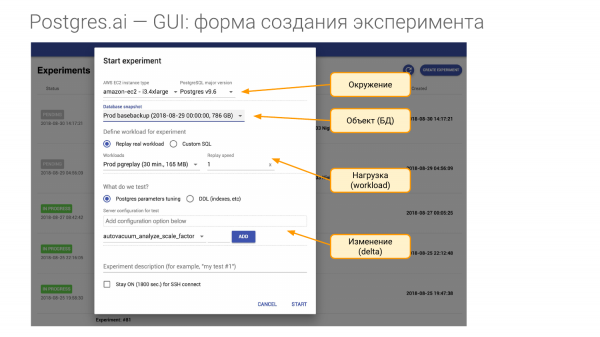
Dhe për këtë na nevojitet të krijojmë një eksperiment. Ai përbëhet nga katër pjesë.
- E para – është ambienti. Na duhen pajisjet. Dhe kur shkoj në ndonjë kompani dhe lidh një kontratë, atëherë i them të më japin pajisje të njëjta si në production. Për secilin nga mjeshtrat tuaj, kam nevojë për të paktën një pajisje të tillë. Ose është një makinë virtuale instance në Amazon ose në Google, ose më duhet saktësisht e njëjta pajisje. Domethënë, dua të riprodhoj ambientin. Dhe në konceptin e ambientit ne përfshijmë versionin kryesor të Postgres.
- Pjesa e dytë – është objekti i hulumtimeve tona. Kjo është baza e të dhënave. Ajo mund të krijohet në disa mënyra. Unë do të tregoj si.
- Pjesa e tretë – është ngarkesa. Ky është momenti më i komplikuar.
- Dhe pjesa e katërt është ajo që ne kontrollojmë, dmth me çfarë do ta krahasojmë. Supozojmë se mund të ndryshojmë një ose disa parametra në konfigurim, ose mund të krijojmë një indeks, etj.
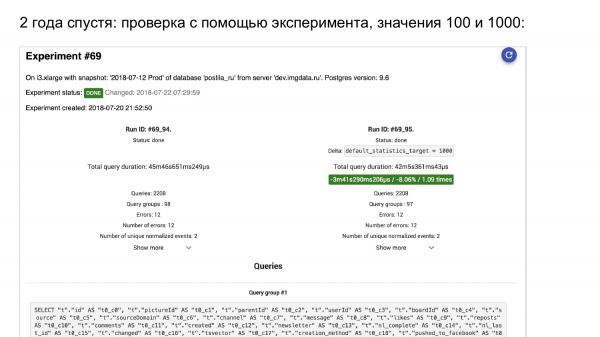
Ne po fillojmë një eksperiment. Ja pg_stat_statements. Në të majtë – si ishte. Në të djathtë – si është bërë.
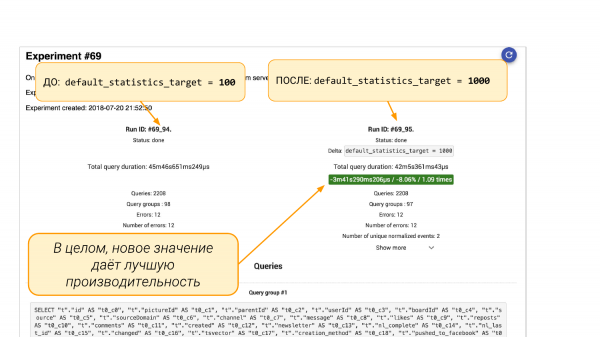
Në të majtë default_statistics_target = 100, në të djathtë = 1,000. Ne shohim se kjo na ndihmoi. Nga 8% gjithçka është përmirësuar në tërësi.
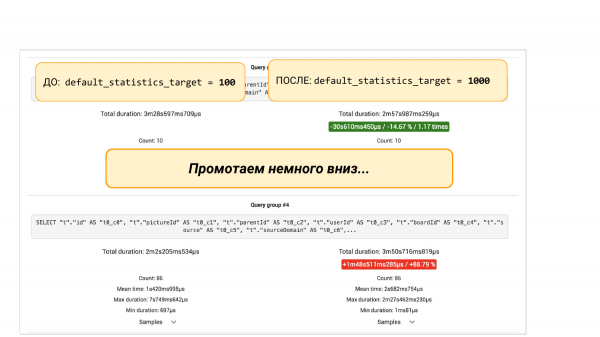
Por nëse e rrokullisim poshtë, do të ketë grupe kërkesash nga pgBadger ose nga pg_stat_statements. Këtu ka dy mundësi. Ne do të shohim se ndonjë kërkesë ka rënë me 88%. Dhe këtu fillon qasja inxhinierike. Ne mund të thellohemi më tej, sepse është interesante se pse ajo ka rënë. Duhet të kuptojmë çfarë ndodhi me statistikat. Pse më shumë kube në statistikë çojnë në një rezultat më të dobët.
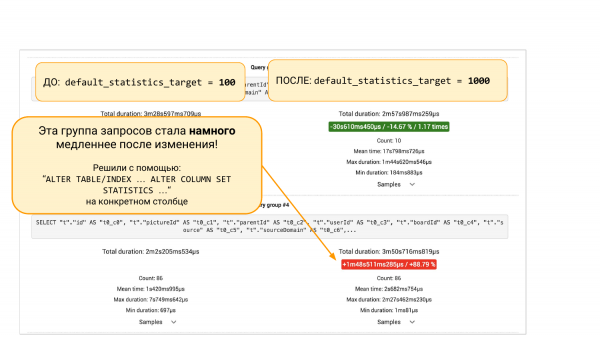
Ose mund të mos thellohemi, por të bëjmë 'ALTER TABLE … ALTER COLUMN' dhe t'i kthejmë 100 kube në statistikë kësaj kolone. Dhe pastaj, përmes një eksperimentit, ne mund të sigurohemi se kjo zgjidhje ndihmoi. Kaq. Kjo është qasja inxhinierike që na ndihmon të shohim situatën dhe të marrim vendime mbi baza të të dhënave, e jo mbi intuitë.
Disa shembuj nga fusha të tjera. Në testime, ka CI testime që ekzistojnë prej shumë vitesh. Dhe asnjë projekt i shëndoshë në mendje nuk do të ekzistojë pa teste automatike.
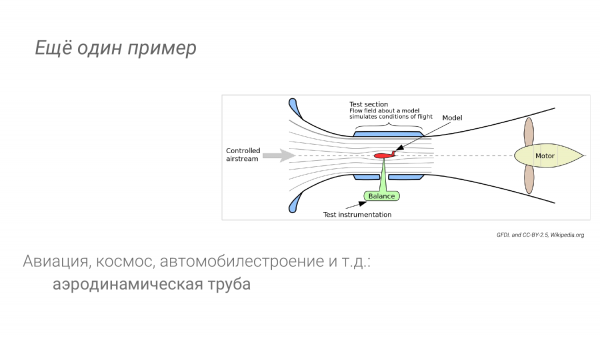
Në industri të tjera: në aviacion, në prodhimin e automjeteve, kur testojmë aerodinamikën, gjithashtu kemi mundësinë të kryejmë eksperimente. Ne nuk do të lëshojmë diçka nga skicimi menjëherë në hapësirë apo nuk do të nxjerrim ndonjë makinë menjëherë në autostradë. Për shembull, ka një tunel aerodinamik.
Nga vObservimet në industri të tjera, ne mund të nxjerrim përfundime.
Së pari, ne kemi një mjedis të veçantë. Ai është afër prodhimit, por jo tërësisht i njëjtë. Karakteristika kryesore e tij është se duhet të jetë i lirë, i përsëritshëm dhe maksimalisht i automatizuar. Dhe gjithashtu duhet të ketë mjete speciale për të kryer një analizë të detajuar.
Mundësisht, kur fluturojmë me avionin, kemi më pak mundësi të studiojmë çdo militër të sipërfaqes së krahut, se sa kemi në tunelin aerodinamik. Ne kemi më shumë mjete për diagnostikim. Mund të lejojmë të vendosim më shumë gjëra të rënda, të cilat nuk mund t'i vendosim në avionin në ajër. Po ashtu edhe me Postgres. Në disa raste, mund të aktivizojmë logimin e plotë të kërkesave gjatë eksperimenteve. Dhe nuk duam ta bëjmë këtë në ambientin e prodhimit. Ndoshta madje do ta aktivizojmë këtë me planet përmes auto_explain.
Dhe siç thashë, një nivel i lartë automatizimi do të thotë që kemi shtypur butonin dhe kemi përsëritur. Kështu duhet të jetë, për të pasur shumë eksperimente, që të jetë në rrjedhë.
Nancy CLI – themeli i "laboratorit të DB"
Dhe ja, ne kemi bërë një gjë të tillë. Do të thotë, kam folur për këto ide në qershor, pothuajse një vit më parë. Dhe tani kemi në Open Source një Nancy CLI të quajtur kështu. Ky është themeli për të ndërtuar një laborator të bazës së të dhënave.
– Ky është në Open Source, në Gitlab. Mund ta thoni, mund ta provoni. Kam dhënë një lidhje në slidet. Mund të klikoni dhe do të ketë për të gjitha parametrat.
Sigurisht, ka ende shumë për të zhvilluar. Ka shumë ide. Por kjo është ajo që ne e zbatojmë pothuajse çdo ditë. Dhe kur na vjen një ide - a çfarë ndodh kur fshini 40,000,000 rreshta dhe gjithçka është bllokuar në IO, atëherë mund të bëjmë një eksperiment dhe të shohim më në detaje, për të kuptuar se çfarë po ndodh dhe më pas të përpiqemi ta zgjidhim atë në mënyrë që të mund të vazhdojmë. Do të thotë, bëjmë një eksperiment. Për shembull, ndonjë gjë e rregullojmë dhe shohim se çfarë rezultati marrim. Dhe ne nuk e bëjmë këtë në prodhim. Ky është thelbi i idesë.
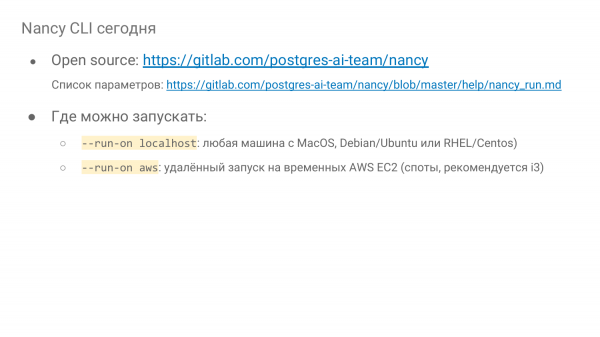
Ku mund të funksionojë kjo? Mund të funksionojë lokal, do të thotë, mund ta bëni kudo, madje mund ta nisni në MacBook. Keni nevojë për docker, fillojmë. Dhe kaq. Mund të ndizni në ndonjë instancë në hardware, ose në një virtual, kudo.
Dhe ka edhe mundësinë e hapjes së largët në Amazon në EC2 Instance, në spots. Dhe kjo është një mundësi shumë e shkëlqyer. Për shembull, dje kemi realizuar më shumë se 500 eksperimente në instancën i3, duke filluar nga ajo më e vogël dhe duke përfunduar në i3-16-xlarge. Dhe na kushtoi 500 eksperimente 64 dollarë. Çdo njëri zgjati 15 minuta. Domethënë, falë përdorimit të spoteve, kjo është shumë e lirë – zbritje 70%, tarifimi sipas sekondës nga Amazon. Mund të bëni shumë gjëra. Mund të realizoni një hetim të vërtetë.
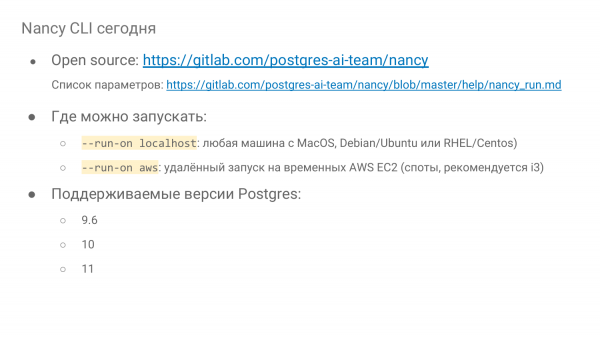
Dhe tri versione kryesore të Postgres mbështeten. Nuk është kaq e vështirë të përmirësosh disa versione të vjetra dhe versionin e ri 12 gjithashtu.
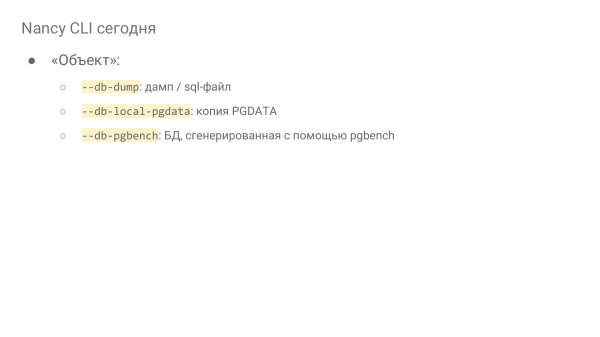
Objektin mund ta përcaktojmë në tri mënyra. Ato janë:
- Dump/sq-fail.
- Mënyra kryesore – është kloni i direktorisë PGDATA. Zakonisht marrë nga serveri i backup-it. Nëse keni backup-e binaresh të mira, mund të bëni klone prej andej. Nëse keni cloud, atëherë kjo do të bëhet automatikisht nga kompania cloud si Amazon dhe Google. Kjo është mënyra kryesore për klonët në prodhim të vërtetë. Kështu zhvillojmë ne.
- Dhe mënyra e fundit është e përshtatshme për hulumtimet, kur ka dëshirë të kuptohet se si funksionon diçka në Postgres. Kjo është pgbench. Mund të gjeneroni me ndihmën e pgbench. Kjo është thjesht një opsion "db-pgbench". I thua atij, çfarë scale. Dhe gjithçka do të gjenerohet në cloud, siç është thënë.
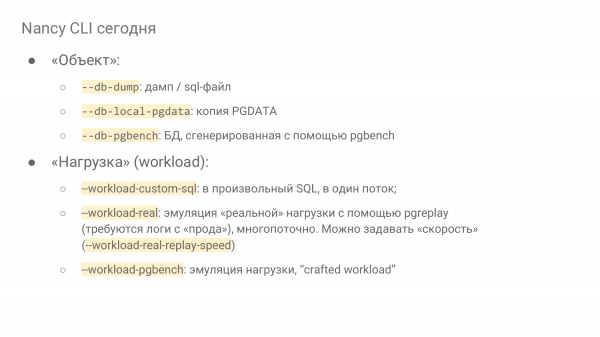
Dhe ngarkesa:
- Ngarkesën mund ta ekzekutojmë në një rrjedhë SQL. Kjo është mënyra më primitive.
- Ose mund të emulojmë ngarkesën. Dhe mund ta emulojmë atë para së gjithash në këtë mënyrë. Na nevojitet të mbledhim të gjitha logjet. Dhe kjo është e dhimbshme. Do t'ju tregoj pse. Dhe me ndihmën e pgreplay luajmë, që është i integruar në Nancy.
- Ose një opsion tjetër. Një ngarkesë e quajtur artizanal, që ne e bëjmë me një sasi të caktuar përpjekjeje. Duke analizuar ngarkesën tonë aktuale në sistemin e prodhimit, ne nxjerrim grupet më të mira të kërkesave. Dhe me ndihmën e pgbench mund ta emulojmë këtë ngarkesë në laborator.
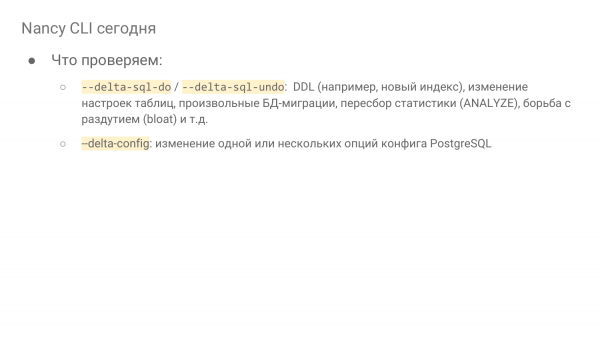
- Ose duhet të ekzekutojmë ndonjë SQL, domethënë kontrollojmë një migrim, krijojmë një indeks atje, realizojmë ANALAZE. Dhe shohim se çfarë ndodhi para vakuumit dhe pas vakuumit. Në përgjithësi, çdo SQL.
- Ose ne e nevojë që të ndryshojmë një ose disa parametra në konfigurim. Mund të kërkojmë që të verifikohen, për shembull, 100 vlera në Amazon për bazën tonë me terabajt. Dhe pas disa orësh, do të keni rezultatin. Si rregull, baza me terabajt do të zgjatet disa orë. Por në zhvillim kemi një patch, ku kemi mundësinë për të bërë një seri, domethënë, mund të përdorni të njëjtin pgdata në të njëjtin server dhe të verifikoni. Postgres do të rindezë, cache-t do të zbrazin. Dhe mund të stërvitni ngarkesën.
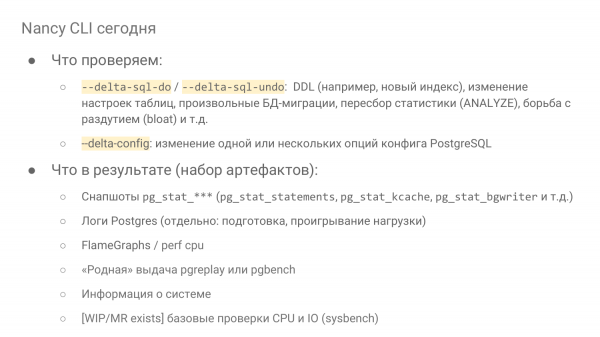
- Vjen një direktori, ku ka shumë skedarë, duke filluar nga snapshots pg.stat***. Dhe aty janë gjërat më interesante – pg_stat_statements, pg_stat_kcacke. Këto janë dy zgjerime që analizojnë kërkesat. Dhe pg_stat_bgwriter përmban jo vetëm statistikën e pgwriter, por gjithashtu për checkpoint dhe se si vetë backendet shkarkojnë bufferat e papastër. Dhe kjo është e interesante të shikohet. Për shembull, kur konfiguroni shared_buffers, është shumë interesante të shikoni sa ka shkarkuar kush.
- Po ashtu, arrijnë log-ët e Postgres. Dy log-e – log i përgatitjes dhe log i luajtjes së ngarkesës.
- Një tipar relativisht i ri – janë FlameGraphs.
- Po ashtu, nëse keni përdorur pgreplay ose pgbench varianta e luajtjes së ngarkesës, do të keni nativen e tyre në daljen e tyre. Dhe do të shihni latency dhe TPS. Mund të kuptoni se si e kanë parë ata.
- Informacion rreth sistemit.
- Kontrollet bazike CPU dhe IO. Kjo është më shumë për instancat EC2 në Amazon, kur dëshironi të nisni në rrjedhë 100 instanca identike dhe t'i testoni ato me 100 prova të ndryshme, do të keni 10,000 eksperimente. Dhe duhet të siguroheni që nuk keni një instancë problematike, të cilën dikush e ka pakësuar. Në këtë hardware, të tjerët aktivizohen dhe ju mbetet pak burim. Të tilla rezultate është më mirë t'i eliminoni. Dhe pikërisht me ndihmën e sysbench nga Aleksei Kopytov ne bëjmë disa kontrolle të shkurtra, që do të vijë dhe mund të krahasohet me të tjerat, domethënë, do të kuptoni si e menaxhon CPU-ja dhe si e menaxhon IO-ja.
Cilat janë komplikimet teknike në shembuj të kompanive të ndryshme?
Supozoni se duam të përsëritim një ngarkesë të vërtetë me anë të log-ëve. Ide e shkëlqyer, nëse është shkruar në Open Source pgreplay. Ne e përdorim. Por, që të punojë mirë, duhet të aktivizoni logimin e plotë të kërkesave me parametra dhe kohëmatjen.
Ka there disa vështirësi rreth duration dhe timestamp. Ne do ta anashkalojmë këtë pjesë. Pyetja kryesore është – a mund ta lejoni veten një gjë të tillë apo jo?
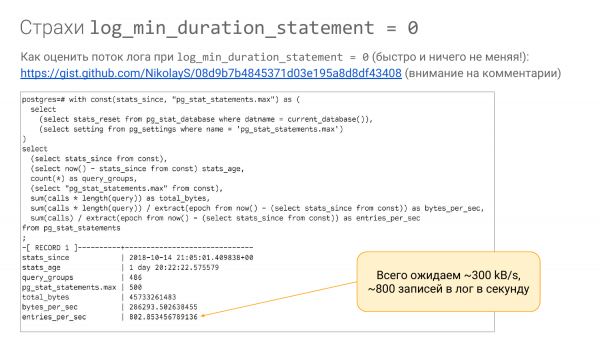
Problemi është se kjo mund të mos jetë e aksesueshme. Ju duhet së pari të kuptoni se çfarë fluksi do të shkruhet në log. Nëse keni pg_stat_statements, mund të kuptoni, me këtë kërkesë (linku do të jetë i disponueshëm në slajde), sa përafërsisht byte do të shkruhet në sekondë.
Ne e shikojmë gjatësi e kërkesës. Ne injorojmë faktin se nuk ka parametra, por e dimë gjatësi e kërkesës dhe dimë sa herë në sekondë është ekzekutuar. Kështu mund të përllogarisim sa përafërsisht byte në sekondë. Mund të gabojmë dy herë, por rendi do ta kuptojmë me siguri kështu.
Mund të shohim se kjo kërkesë ekzekutohet 802 herë në sekondë. Dhe ne shohim se bytes_per sec – 300 kB/s do të shkruhen plus minus. Dhe, zakonisht, mund të lejojmë një fluks të tillë.
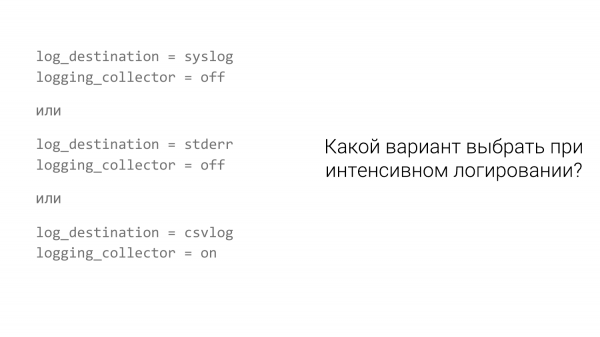
Por! Çështja është se ka sisteme të ndryshme logimi. Dhe zakonisht, njerëzit kanë ‘syslog’ si parazgjedhje.
Dhe nëse keni syslog, atëherë mund të keni një pamje të tillë. Ne do të marrim pgbench, do të aktivizojmë logimin e kërkesave dhe do të shohim çfarë ndodh.
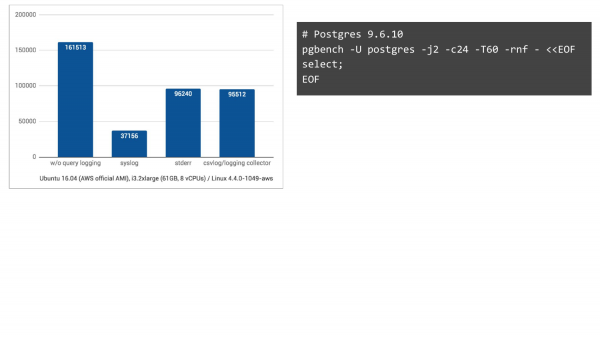
Pa logim – kjo është kolona në të majtë. Atëherë kishim 161,000 TPS. Me syslog – në Ubuntu 16.04 në Amazon, kemi 37,000 TPS. Ndërsa nëse ndërojmë dy metoda të tjera të logimit, situata është shumë më e mirë. Kjo është, prisnim që të shënuarit të bjerë, por jo kaq shumë.
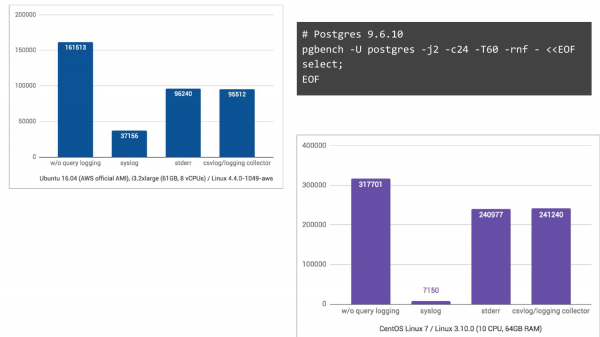
Dhe në CentOS 7, ku merr pjesë journald, duke e kthyer logun në format binary për kërkimin e lehtë, atëherë ndodhemi në një situatë të tmerrshme, 44 herë ulje në TPS.
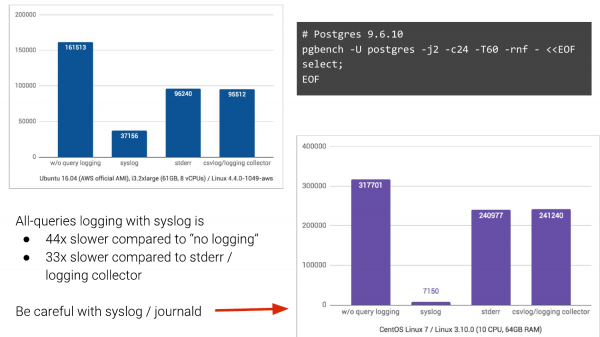
Dhe kjo është ajo me të cilën jetojnë njerëzit. Dhe shpesh në kompani, veçanërisht në të mëdha, është shumë e vështirë për t'u ndryshuar. Nëse mund të largoheni nga syslog, atëherë ju lutemi largohuni.
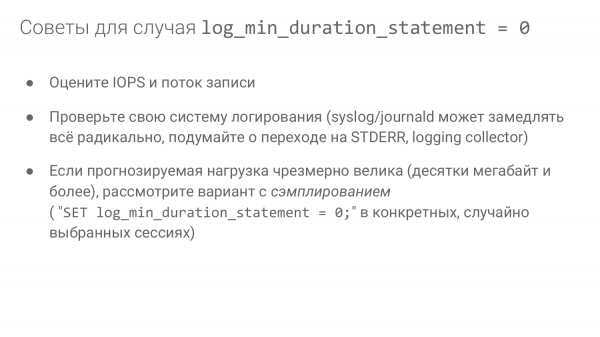
- Vlerësoni IOPS dhe fluksin e shkruar.
- Kontrolloni sistemin tuaj të logimit.
- Nëse ngarkesa e parashikuar është tepër e madhe, shqyrtoni mundësinë e sampling.
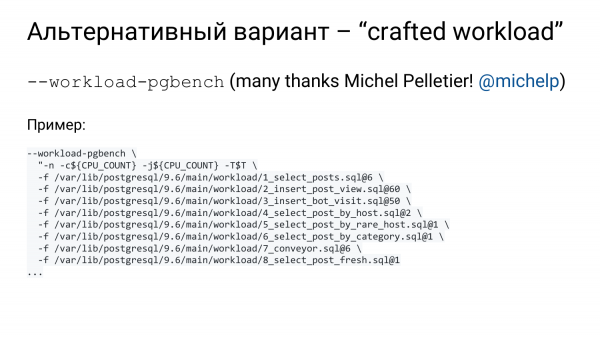
Kemi pg_stat_statements. Siç e thashë, ai duhet patjetër të jetë. Dhe mund të marim dhe çdo grup kërkesash ta përshkruajmë në një skedar special. Pastaj mund të përdorim një funksion shumë të dobishëm në pgbench – mundësinë për të përfshirë disa skedare me opsionin ‘-f’.
Ai kupton shumë “-f”. Dhe mund të thuash me “@” në fund, cila përqindje i takon secilit skedar. Pra, mund të themi se ky duhet të ekzekutohet në 10% të rasteve, dhe ky në 20%. Dhe kjo do të na afrojë me atë që shohim në prodhim.
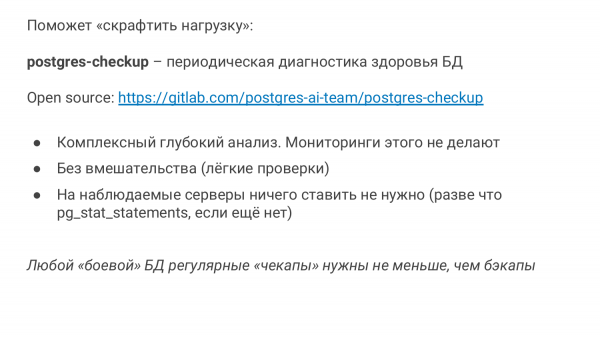
Si do ta kuptojmë se çfarë kemi në prodhim? Cila përqindje dhe çfarë si? Këtu kemi një devijim paksi. Kemi një produkt tjetër. . Gjithashtu baza është në Open Source. Dhe ne tani po e zhvillojmë aktivisht atë.
Ai lindi për arsye pak të ndryshme. Për arsye se monitorimi nuk është i mjaftueshëm. Pra, ju vini, shikoni në bazë, shikoni problemet që ekzistojnë. Dhe, zakonisht, ju bëni kontrollin e shëndetit. Nëse jeni një DBA me përvojë, atëherë e bëni kontrollin e shëndetit. Shikoni përdorimin e indekseve etj. Nëse keni OKmeter, atëherë shkëlqyeshëm. Ky është një monitorim i klasit për Postgres. OKmeter.io – ju lutem, instalojeni, gjithçka është bërë shumë mirë atje. Ai është me pagesë.
Nëse nuk e keni atë, atëherë, zakonisht, nuk keni shumë për të parë. Në monitorim zakonisht ka CPU, IO dhe madje me rezervime, dhe gjithë kjo. Por ne kemi nevojë për më shumë. Duhet të shohim si funksionon autovakuumi, si funksionon checkpoint, në IO duhet të ndash checkpoint nga bgwriter dhe nga backend-et etj.
Problemi është kur ndihmon një kompani të madhe, ato nuk mund të zbatojnë shpejt diçka. Nuk mund të blejnë shpejt OKmeter. Mund të kenë mundësi ta blejnë pas gjashtë muajsh. Nuk mund të instalojnë shpejt disa paketa.
Dhe na lindi ideja se na nevojitet një vegël e tillë, e cila nuk kërkon asgjë për instalim, pra ju nuk duhet të instaloni asgjë në prodhim. E instaloni në laptopin tuaj, ose në serverin e vëzhgimit, nga ku do të nisni. Dhe ai do të analizojë shumë gjëra: edhe sistemin operativ, edhe sistemin e skedarëve, edhe vetë Postgres-in, duke bërë disa kërkesa të lehta që mund t'i drejtoni drejtpërdrejt në prodhim dhe asgjë nuk do të bjerë.
Ne e quajmë atë Postgres-checkup. Nëse flasim mjekësisht, kjo është një kontroll i rregullt i shëndetit. Nëse e lidhim me temën automobilistike, është si një kontroll teknik. Ju bëni kontroll teknik për makinën çdo gjashtë muaj ose një vit, në varësi të markës. A bëni kontroll teknik për bazën tuaj? Pra, a bëni një kërkim të thellë rregullisht? Kjo duhet bërë. Nëse bëni kopje rezervë, atëherë bëni edhe kontrollin, kjo është po aq e rëndësishme.
Dhe ne kemi një vegël të tillë. Ai filloi të zhvillohet aktivisht vetëm tri muaj më parë. Është ende i ri, por aty ka shumë gjëra.
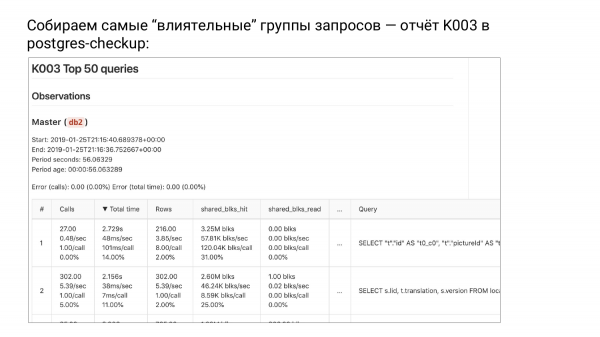
Ne pofigurojmë grupet më "të ndikueshme" të kërkesave – raporti K003 në Postgres-checkup
Dhe ka një grup raportesh K. Momentalisht ka tre raporte. Dhe ka një raport të tillë K003. Aty është maje e pg_stat_statements, e renditur sipas total_time.
Kur rendisim grupet e kërkesave sipas total_time, në krye shohim një grup që ngarkon sistemin tonë më shumë, dmth konsumon më shumë burime. Pse e quaj grupet e kërkesave? Sepse ne heqim parametrat. Kjo nuk janë më kërkesa, por grupe kërkesash, dmth ato janë të abstrahuara.
Dhe nëse do të optimizojmë nga lartë poshtë, do të lehtësojmë burimet tona dhe do të shtyjmë momentin kur do të duhet të bëjmë një përmirësim. Ky është një mënyrë shumë e mirë për të kursyer para.
Mund të mos jetë ndoshta mënyra më e mirë për të kujdesur për përdoruesit, sepse ndoshta nuk shohim raste të rralla, por shumë të bezdisshme, kur dikush pret 15 sekonda. Në total, ato janë aq të rralla sa që nuk i shohim, por përndryshe merremi me burimet.
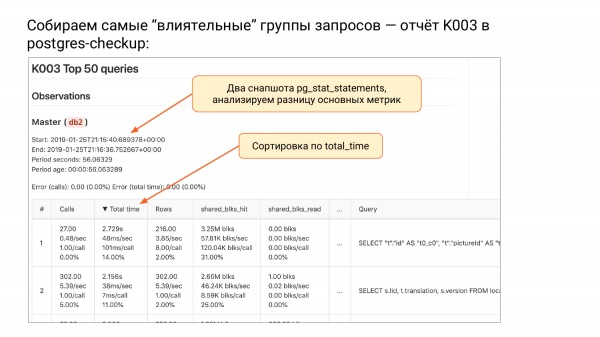
Çfarë ndodhi në këtë tabelë? Ne bëmë dy snapshot-e. Postgres_checkup do t'ju bëjë një delta për çdo metrikë: për total-time, calls, rows, shared_blks_read etj. E gjithë, delta është llogaritur. Problemi i madh me pg_stat_statements është se ai nuk e mban mend kur ka qenë reset. Ndërsa pg_stat_database e mban mend, pg_stat_statements nuk e mban. Shihni, ka 1 000 000 numër, por nga e kemi llogaritur, nuk e dimë.
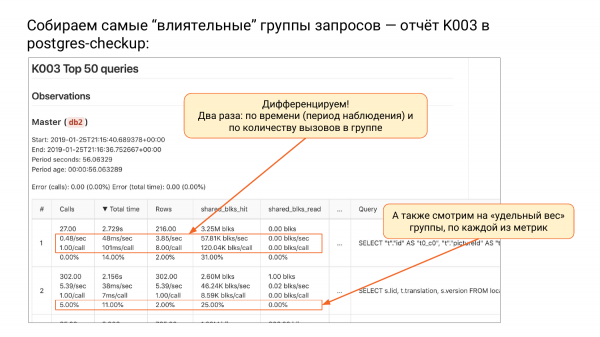
Dhe këtu e dimë, këtu kemi dy snapshot-e. E dimë se delta në këtë rast ishte 56 sekonda. Një periudhë shumë e vogël. E renditëm sipas total_time. Më pas mund të diferencojmë, domethënë, të gjithë metrikat i ndajmë me duration. Nëse i ndajmë çdo metrikë me duration, do të kemi numrin e thirrjeve për sekondë.
Më pas total_time për sekondë – kjo është metrika ime e preferuar. Ajo matet në sekonda, në sekondë, dmth sa sekonda i nevojiteshin sistemit tonë për të përfunduar këtë grup kërkesash për sekondë. Nëse shihni aty më shumë se një sekondë për sekondë, do të thotë se ju nevojiteshin më shumë se një bërthamë. Kjo është një metrikë shumë e mirë. Mund të kuptoni se ky person, për shembull, ka nevojë për të paktën tri bërthama.
Kjo është novatori ynë, nuk kam parë asgjë të tillë. Vini re – kjo është një gjë shumë e thjeshtë – sekonda për sekondë. N sometimes, kur keni CPU 100 %, atëherë gjysmë ore për sekondë, dmth ju keni kaluar gjysmë ore vetëm me këto kërkesa.
Më pas, ne shohim rreshta në sekondë. Ne e dimë sa rreshta u kthyen në sekondë.
Dhe gjithashtu ka një gjë interesante. Sa shared_buffers kemi lexuar në sekondë nga vetë shared_buffers. Hit-et kishin qenë atje, ndërsa rreshtat i morëm nga cache i sistemit operativ, ose nga disku. Varianti i parë është i shpejtë, ndërsa i dyti, ndoshta është i shpejtë, ndoshta edhe jo, varet nga situata.
Dhe mënyra e dytë për diferencim – ne ndajmë numrin e kërkesave në këtë grup. Në kolonën e dytë do të keni gjithmonë një kërkesë të ndarë nga kërkesa. Më pas është interesante – sa milisekonda ishin në këtë kërkesë. Ne e dimë si sillet në mesatare kjo kërkesë. 101 milisekonda ishin të nevojshme për çdo kërkesë. Kjo është një metrikë tradicionale që na nevojitet për të kuptuar.
Sa rreshta çdo kërkesë ktheu në mesatare. Ne shohim se grupi kthen 8. Sa në mesatare morëm dhe lexuam nga cache. Ne shohim se gjithçka është e mbajtur shkëlqyeshëm në cache. Të gjitha hit-et për grupin e parë.
Dhe në rreshtin e katërt në çdo rresht – është sa përqind nga numri total. Ne kemi calls. Le të supozojmë, në 1,000,000. Dhe ne mund të kuptojmë çfarë kontribuon ky grup. Ne shohim se në këtë rast grupi i parë kontribuon më pak se 0.01 %. Kjo do të thotë se është kaq e ngadaltë sa nuk e shohim në pamjen e përgjithshme. Ndërsa grupi i dytë – 5 % nga calls. Kjo do të thotë 5 % nga të gjitha calls – është grupi i dytë.
Po ashtu, edhe për total_time është interesante. Ne shpenzuam 14 % të gjithë kohës së punës për grupin e parë të kërkesave. Ndërsa për të dytin – 11 % etj.
Nuk do të thellohem në detaje, por aty ka nuanca. Ne nxjerrim gabimin nga lart, sepse, kur krahasojmë, snapshot-et mund të deformohen, domethënë, disa kërkesa mund të bien dhe në të dytën nuk mund të jenë më, ndërsa disa mund të shfaqen të reja. Dhe ne aty llogarisim gabimin. Nëse shihni 0, atëherë është mirë. Nuk ka gabime. Nëse niveli i gabimit është deri në 20 %, është OK.
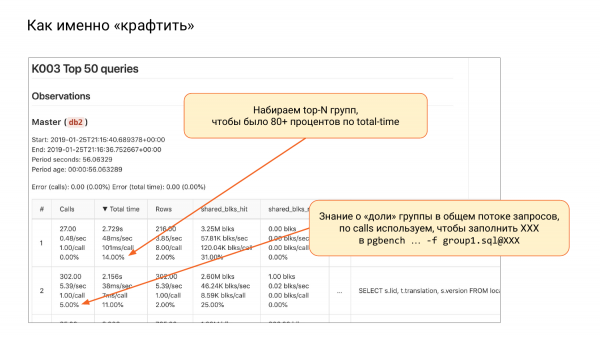
Më pas kthehemi në temën tonë. Duhet të krijojmë workload. Ne e marrim nga lartë poshtë, derisa të mbledhim 80 % ose 90 %. Zakonisht janë 10-20 grupe. Dhe krijojmë skedarë për pgbench. Atje përdorim random. Ndonjëherë, fatkeqësisht, kjo nuk funksionon. Dhe në Postgres 12 do të ketë më shumë mundësi për ta përdorur këtë qasje.
Dhe kështu ne arrijmë 80-90% në total_time. Çfarë duhet të vendosim pas "@"? Shikojmë thirrjet, shikojmë sa përqindje dhe kuptojmë se duhet të kemi këtë përqindje këtu. Nga këto përqindje mund të kuptojmë se si të balancojmë secilin nga skedarët. Pas kësaj, përdorim pgbench dhe vazhdojmë punën.
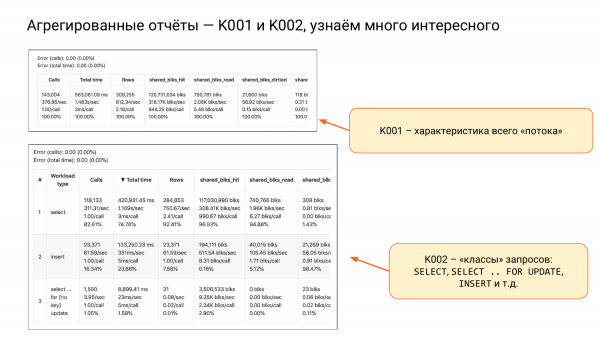
Kemi gjithashtu K001 dhe K002.
K001 – është një varg i madh me katër nënvargje. Kjo është karakteristika e ngarkesës sonë të gjithë. Shikoni kolonen e dytë dhe nënvargun e dytë. Shikojmë se është rreth një e gjysmë sekondë për sekondë, dmth nëse do të kishte dy bërthama, do të ishte mirë. Do të ishte rreth 75% ngarkesë. Dhe kështu do të punonte. Nëse do të kishim 10 bërthama, do të ishim plotësisht të qetë. Kështu mund të vlerësojmë burimet.
K002 – këtu e quaj klasat e kërkesave, dmth SELECT, INSERT, UPDATE, DELETE. Dhe veçmas SELECT FOR UPDATE, sepse ky bllokon.
Dhe këtu mund të arrijmë në përfundimin se SELECT të zakonshëm lexues – 82% e të gjithë thirrjeve, por nga ana tjetër – 74% për total_time. DMTH ato thirren shumë, por konsumojnë më pak burime.
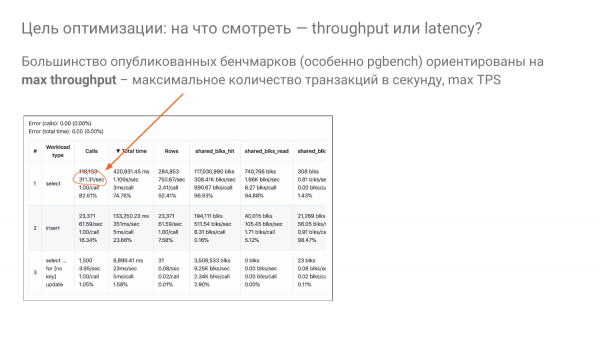
Dhe kthehemi tek pyetja: "Si të zgjedhim saktë shared_buffers?". Vërej se shumica e bllokimeve ndodhen mbi idenë – le të shikojmë se çfarë throughput-i do të ketë, dmth çfarë do të jetë kapaciteti i kalimit. Kjo matet zakonisht në TPS ose QPS.
Dhe ne përpiqemi të nxjerrim nga makina sa më shumë transaksione për sekondë përmes parametrave të optimizimit. Këtu është 311 për sekondë për select.
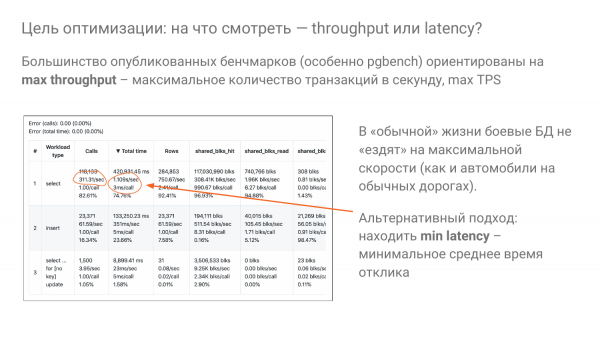
Por askush nuk shkon në punë dhe përsëri në shtëpi me makinë me shpejtësinë maksimale. Kjo është e budallallëk. Po ashtu me databazat. Ne nuk duhet të ecim me shpejtësinë maksimale, askush nuk e bën këtë. Askush nuk jeton në prodhim me 100% CPU. Edhe pse ndoshta dikush jeton, por kjo nuk është mirë.
Ideja është që ne zakonisht shkojmë rreth 20% të mundësive, ndoshta jo më shumë se 50%. Dhe përpiqemi të optimizojmë kohën e përgjigjes për përdoruesit tanë përpara gjithçkaje. DMTH duhet të rrotullojmë duart tona për të pasur latencë minimale në 20% shpejtësie, në mënyrë të thjeshtë. Kjo është një ide që ne gjithashtu përpiqemi ta përdorim në eksperimentet tona.
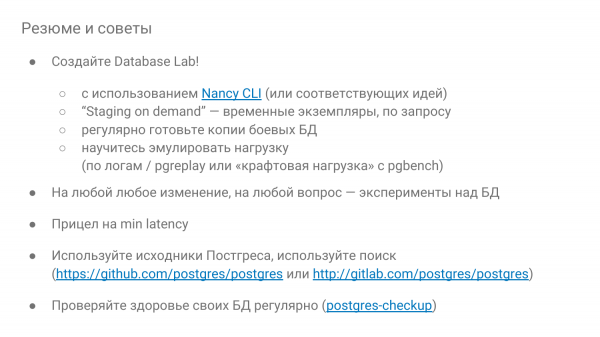
Dhe në përfundim të rekomandimeve:
- Sigurohuni që të krijoni Database Lab.
- Sa më shumë që është e mundur, krijoni në kërkesë, që të zhvillohet për një kohë të caktuar – të luani dhe të hidhni. Nëse keni mbështetje për cloud, kjo është vetë e natyrshme, dmth, keni shumë qëndrim.
- Bëni kuriozë. Dhe nëse diçka nuk shkon, kontrolloni me eksperimente se si sillet. Nancy mund të përdoret për të mësuar vetë, për të provuar si funksionon baza.
- Dhe synoni kohën minimale të reagimit.
- Dhe mos u friksoni nga kodet burimore të Postgres. Kur punoni me kodin burimor, duhet të dini anglisht. Ka shumë komente, gjithçka është e shpjeguar.
- Dhe kontrolloni shëndetin e bazës rregullisht, të paktën një herë në tre muaj manualisht ose me Postgres-checkup.
Pyetje
Faleminderit shumë! është një gjë shumë interesante.
Dy gjëra.
Po, dy gjëra. Vetëm se nuk e kuptova plotësisht. Kur punojmë me Nancy, a mund të rregullojmë vetëm një parameter ose një grup të tërë?
Ne kemi parametrin e konfigurimit delta. Mund të rregulloni aq shumë sa të doni njëkohësisht. Por duhet të kuptoni, kur ndryshoni shumë gjëra, mund të bëni konkluzione të gabuara.
Po. Pse e pyes? Sepse është e vështirë të bësh eksperimente kur ke vetëm një parameter. E rregullon, sheh si funksionon. E vendos. Pastaj fillon me parametrin tjetër.
Mund të rregullohen njëkohësisht, por varet nga situata, sigurisht. Por është më mirë të provosh një ide. Dje na erdhi një ide. Kishim një situatë shumë të ngjashme. Kishim dy konfigurime. Dhe nuk mund të kuptonim pse kishte një diferencë të madhe. Na erdhi ideja se duhet të përdorim dykalimin për të kuptuar dhe gjetur ndryshimin. Mund të bëni menjëherë gjysmën e parametrave të njëjtë, pastaj një të katërtën e kështu me radhë. Gjithçka është fleksibël.
Dhe ka një pyetje tjetër. Projekti është i ri, po zhvillohet. A është dokumentacioni tashmë i gatshëm, a ka një përshkrim të detajuar?
Kisha bërë një lidhje të veçantë për përshkrimin e parametrave. Kjo ekziston. Por ka shumë gjëra ende që nuk ekzistojnë. Po kërkoj bashkëpunëtorë. Dhe i gjej ata kur flas. Është shumë bukur. Disa tashmë punojnë me mua, disa ndihmuan dhe bënë diçka atje. Dhe nëse jeni të interesuar në këtë temë, jepni feedback – çfarë mungon.
Kur të vendosim laboratorin, ndoshta do të ketë feedback. Do ta shikojmë. Faleminderit!
Përshëndetje! Faleminderit për referatin! Shihja se ka mbështetje për Amazon. A është planifikuar mbështetje për GSP?
Pyetja e mirë. Kemi filluar të punojmë. Dhe për momentin e kemi ngrirë, sepse duam të kursejmë. Do të thotë, ka mbështetje përmes run on localhost. Ju mund të krijoni vetë një instance dhe të punoni lokalmente. Në fakt, kështu ne punojmë. Në Getlab e bëj kështu, aty në GSP. Por nuk shohim kuptim në organizimin e tillë për momentin, sepse Google nuk ka oferta të lira. Ka ??? instances atje, por ato kanë kufizime. Së pari, ata gjithmonë kanë një zbritje prej 70 % dhe nuk mund të luani me çmimin. Ne rrisim çmimin e ofertave me 5-10 % për të ulur probabilitetin që ju të eliminoheni. Do të thotë, me ofertat kurseni, por ato mund t'ju merren në çdo moment. Nëse jeni pak më të lartë çmimi se të tjerët, do të eliminoheni më vonë. Google ka një specifikë krejtësisht ndryshe. Dhe ka një kufizim shumë të pafavorshëm – ato jetojnë vetëm 24 orë. Ndonjëherë ne duam të eksperimentojmë për 5 ditë. Por me ofertat është e mundur, ndonjëherë ato jetojnë për muaj me radhë.
Përshëndetje! Faleminderit për referatin! Ju përmendët për checkup. Si i llogaritni gabimet stat_statements?
Pyetje shumë e mirë. Mund të tregoj dhe të shpjegoj në detaje. Në shkurtime – ne shikojmë se si ka ndryshuar grupi i kërkesave: sa janë eliminuar dhe sa të reja janë shfaqur. Dhe më pas ne shikojmë dy metrika: total_time dhe calls, prandaj ka dy gabime. Dhe shohim, çfarë kontributi kanë grupet që janë ndryshuar. Ka dy nën-grupe: ato që janë ikur dhe ato që janë kthyer. Shikojmë, çfarë kontributi kanë në pamjen e përgjithshme.
A mos keni frikë se ajo do të rrotullohet dy-tre herë në kohën midis snapshot-ëve?
Do të thotë, ata u regjistruan përsëri ose si?
Për shembull, kjo kërkesë është eliminuar një herë, pastaj erdhi dhe u eliminuar përsëri, pastaj erdhi sërish dhe u eliminuar përsëri. Dhe këtu llogaritet diçka, dhe ku është e gjithë kjo?
Pyetje e mirë, duhet të shikojmë.
Kam bërë diçka të ngjashme. Sigurisht më e thjeshtë, e kam bërë vetëm. Por mu desh të rikthehem, të bëj reset stat_statements dhe të orientohesha në momentin e snapshot-it, duke parë që kishte më pak se një pjesë të caktuar, që ende nuk kishte arritur në kulm, sa stat_statements mund të grumbullohen. Dhe unë orientohesha që, me sa duket, nuk ishte eliminuar asgjë.
Po-po.
Por nuk e kuptoj si mund ta bëj ndryshe me saktësi.
Më vjen keq, nuk e mbaj mend saktësisht – përdorim tekstin e kërkesës ose queryid nga pg_stat_statements dhe mbi të orientoheshim. Nëse ne orientoheshim në queryid, në parim, krahasojmë gjëra të krahasueshme.
Jo, ai mund të largohet disa herë midis snapshot-eve dhe të vijë sërish.
Me këtë ID të njëjtë?
Po.
Ne do ta studiojmë këtë. Pyetje e mirë. Duhet të hulumtojmë. Por për momentin, ajo që shohim është ose 0 shkruhet...
Sigurisht, kjo është një rast i rrallë, por më tronditi kur mësova se stat_statements mund të largohet atje.
Në Pg_stat_statements mund të ketë shumë gjëra. Ne kemi kaluar me atë që nëse keni track_utility = on, atëherë grupet tuaja gjithashtu ndjeken.
Po, sigurisht.
Dhe nëse keni java hibernate, që është rastësor, atëherë aty fillon të bllokohet tabela e hash-it. Dhe sapo të çaktivizoni një aplikacion me ngarkesë të madhe, keni 50-100 grupe. Dhe aty gjithçka është më shumë-më pak e stabilizuar. Një nga mënyrat për të luftuar këtë është të rritur pg_stat_statements.max.
Po, por duhet të dini se sa. Dhe ndonjëherë duhet ta monitoroni. Unë e bëj këtë. Domethënë, kam pg_stat_statements.max. Dhe shoh se në momentin e snapshot-it nuk kam arritur 70% të saj. Mirë, domethënë, nuk kemi humbur asgjë. Bëjmë reset. Dhe grumbullojmë sërish. Nëse në snapshot-in tjetër është më pak se 70, atëherë me shumë gjasë, sërish nuk kemi humbur asgjë.
Po. Për default tani janë 5,000. Dhe shumë njerëz e kanë mjaft këtë.
Zakonisht – po.
Video:
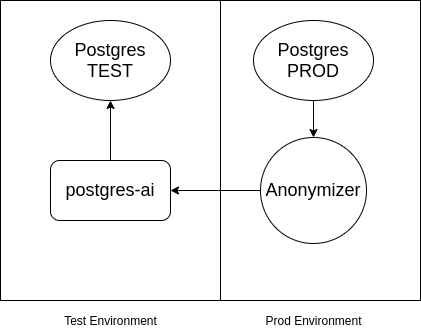
P.S. Nga ana ime, do të shtoj se nëse në Postgres ka të dhëna konfidenciale dhe ato nuk duhet të kalojnë në ambientin e testimit, atëherë mund të përdorni . Schema është përafërsisht si më poshtë:
Burimi: habr.com
