

Përshëndetje, Habr!
Sot ne do të punojmë në aftësinë e përdorimit të mjeteve të grupimit dhe vizualizimit të të dhënave në Python. Në të dhënat e siguruara do të analizojmë disa karakteristika dhe do të krijojmë një grup vizualizimesh.
Siç e duan traditat, fillimisht do të përcaktojmë objektivat:
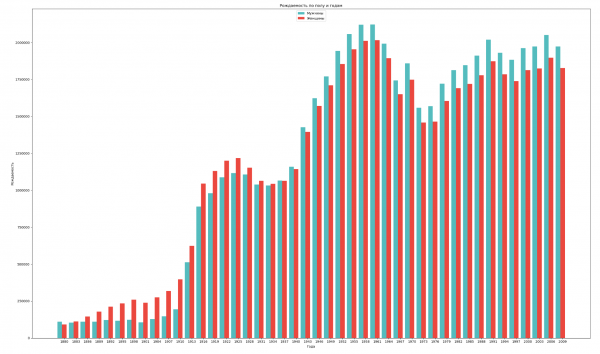
- Të grupojmë të dhënat sipas gjinisë dhe vitit dhe të vizualizojmë dinamikën e përgjithshme të lindjeve të të dy gjinive;
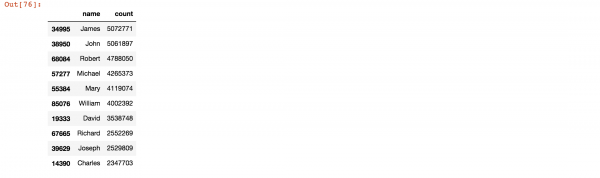
- Të gjejmë emrat më të njohur gjatë gjithë historisë;
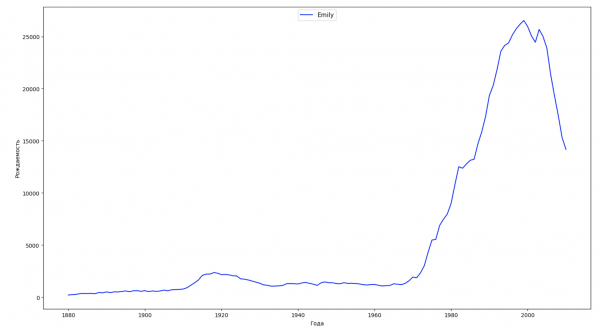
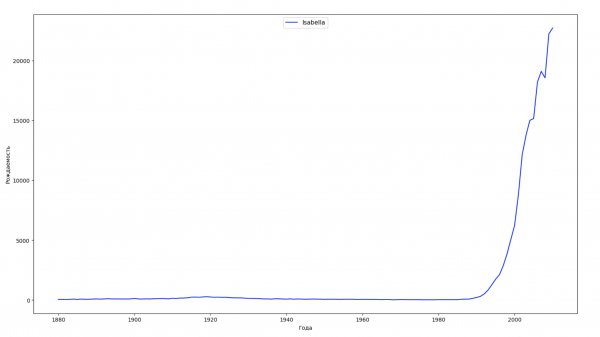
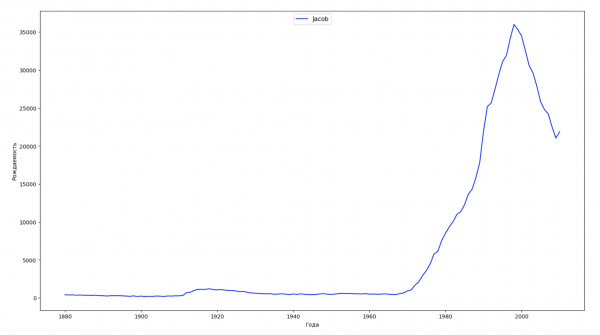
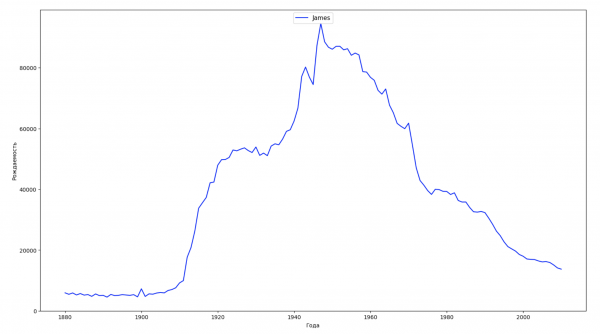
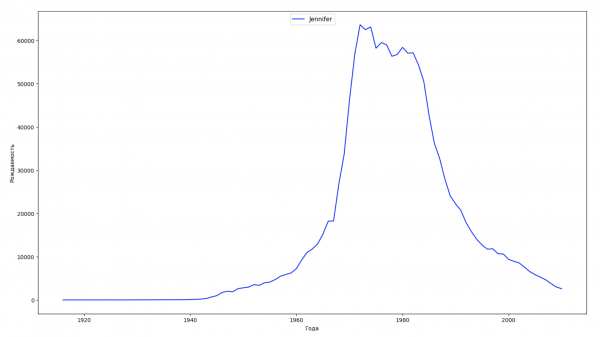
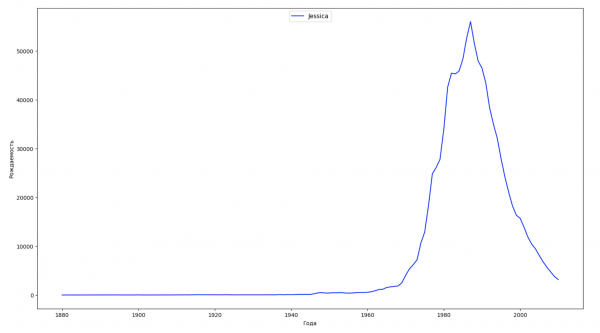
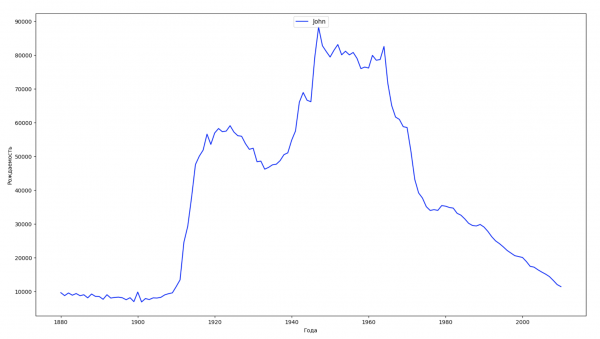
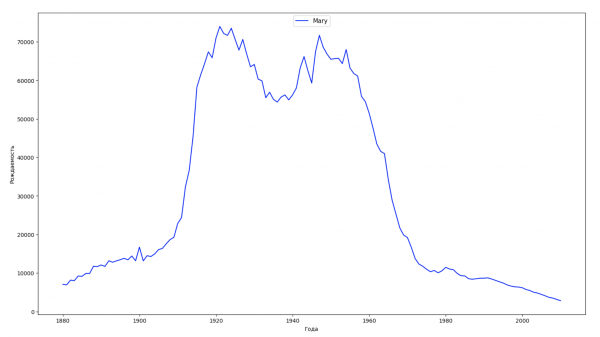
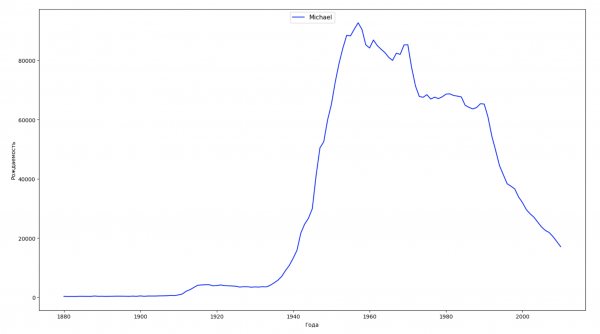
- Të ndajmë gjithë periudhën kohore në të dhëna në 10 pjesë dhe për secilën të gjejmë emrin më të njohur të çdo gjenus. Për çdo emër të gjetur, të vizualizojmë dinamikën e tij përgjatë gjithë kohës;
- Për çdo vit të llogarisim sa emra mbulojnë 50% të njerëzve dhe të vizualizojmë (do të shohim ndryshueshmërinë e emrave për çdo vit);
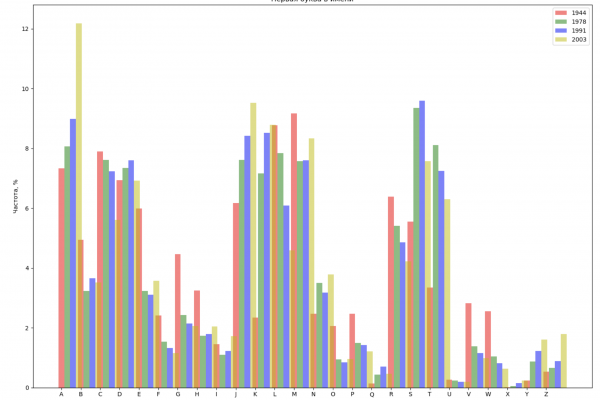
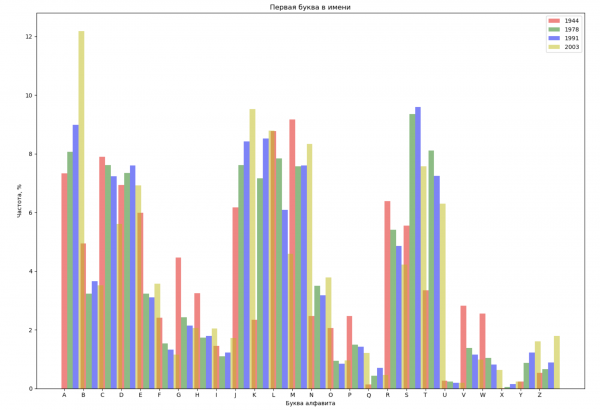
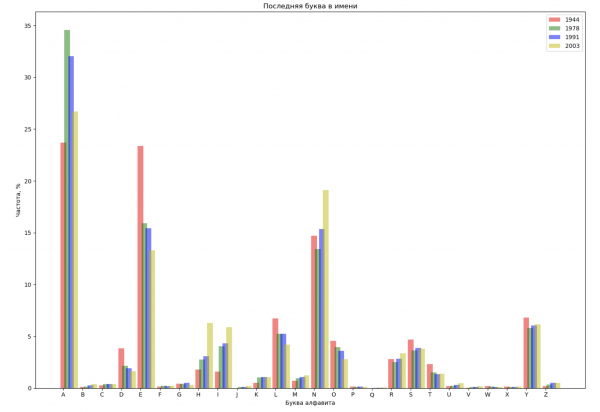
- Të zgjedhim 4 vite nga e gjithë periudha dhe të paraqesim për secilin vit shpërndarjen sipas shkronjës së parë dhe të fundit në emër;
- Të përgatisim një listë nga disa njerëz të njohur (presidentë, këngëtarë, aktorë, heronjtë e filmit) dhe të vlerësojmë ndikimin e tyre në dinamikën e emrave. Të ndërtojmë një vizualizim të qartë.
Më pak fjalë, më shumë kod!
Dhe, le të fillojmë.
Do të grupojmë të dhënat sipas gjinisë dhe vitit dhe do të vizualizojmë dinamikën e përgjithshme të lindjeve të të dy gjinive:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

years = np.arange(1880, 2011, 3)
datalist = 'https://raw.githubusercontent.com/wesm/pydata-book/2nd-edition/datasets/babynames/yob{year}.txt'
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe.assign(year=year))

result = pd.concat(dataframes)
sex = result.groupby('sex')
births_men = sex.get_group('M').groupby('year', as_index=False)
births_women = sex.get_group('F').groupby('year', as_index=False)
births_men_list = births_men.aggregate(np.sum)['count'].tolist()
births_women_list = births_women.aggregate(np.sum)['count'].tolist()

fig, ax = plt.subplots()
fig.set_size_inches(25,15)

index = np.arange(len(years))
stolb1 = ax.bar(index, births_men_list, 0.4, color='c', label='Meshkujt')
stolb2 = ax.bar(index + 0.4, births_women_list, 0.4, alpha=0.8, color='r', label='Femrat')

ax.set_title('Lindjet sipas gjinisë dhe viteve')
ax.set_xlabel('Vitet')
ax.set_ylabel('Lindjet')
ax.set_xticklabels(years)
ax.set_xticks(index + 0.4)
ax.legend(loc=9)

fig.tight_layout()
plt.show()
Do të gjejmë emrat më të njohur gjatë gjithë historisë:
years = np.arange(1880, 2011)

dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe)

result = pd.concat(dataframes)
names = result.groupby('name', as_index=False).sum().sort_values('count', ascending=False)
names.head(10)
Ne do ta gjith periudhën e dhënave në 10 pjesë dhe për secilën të gjejmë emrin më të popullarizuar për secilin gjin. Për çdo emër të gjetur, do të vizualizojmë dinamikën e tij gjatë gjithë kohës:
years = np.arange(1880, 2011)
part_size = int((years[years.size - 1] - years[0]) / 10) + 1
parts = {}
def GetPart(year):
    return int((year - years[0]) / part_size)
for year in years:
    index = GetPart(year)
    r = years[0] + part_size * index, min(years[years.size - 1], years[0] + part_size * (index + 1))
    parts[index] = str(r[0]) + '-' + str(r[1])

dataframe_parts = []
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframe_parts.append(dataframe.assign(years=parts[GetPart(year)]))
    dataframes.append(dataframe.assign(year=year))

result_parts = pd.concat(dataframe_parts)
result = pd.concat(dataframes)

result_parts_sums = result_parts.groupby(['years', 'sex', 'name'], as_index=False).sum()
result_parts_names = result_parts_sums.iloc[result_parts_sums.groupby(['years', 'sex'], as_index=False).apply(lambda x: x['count'].idxmax())]
result_sums = result.groupby(['year', 'sex', 'name'], as_index=False).sum()

for groupName, groupLabels in result_parts_names.groupby(['name', 'sex']).groups.items():
    group = result_sums.groupby(['name', 'sex']).get_group(groupName)
    fig, ax = plt.subplots(1, 1, figsize=(18,10))

    ax.set_xlabel('Vitet')
    ax.set_ylabel('Fertiliteti')
    label = group['name']
    ax.plot(group['year'], group['count'], label=label.aggregate(np.max), color='b', ls='-')
    ax.legend(loc=9, fontsize=11)

    plt.show()
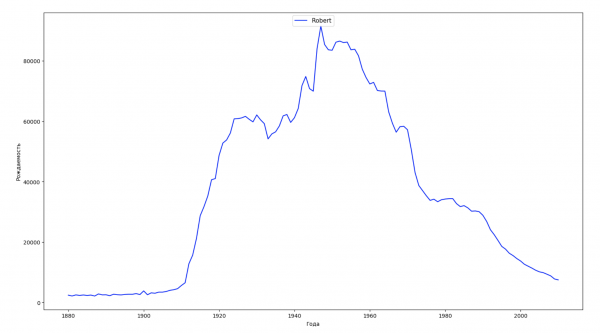
Për çdo vit do të llogarisim se sa emra mbulojnë 50% të njerëzve dhe do të vizualizojmë këto të dhëna:
dataframe = pd.DataFrame({'year': [], 'count': []})
years = np.arange(1880, 2011)
for year in years:
    dataset = datalist.format(year=year)
    csv = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    names = csv.groupby('name', as_index=False).aggregate(np.sum)
    names['sum'] = names.sum()['count']
    names['percent'] = names['count'] / names['sum'] * 100
    names = names.sort_values(['percent'], ascending=False)
    names['cum_perc'] = names['percent'].cumsum()
    names_filtered = names[names['cum_perc'] <= 50]
    dataframe = dataframe.append(pd.DataFrame({'year': [year], 'count': [names_filtered.shape[0]]}))

fig, ax1 = plt.subplots(1, 1, figsize=(22,13))
ax1.set_xlabel('Vitet', fontsize = 12)
ax1.set_ylabel('Diversiteti i emrave', fontsize = 12)
ax1.plot(dataframe['year'], dataframe['count'], color='r', ls='-')
ax1.legend(loc=9, fontsize=12)

plt.show()
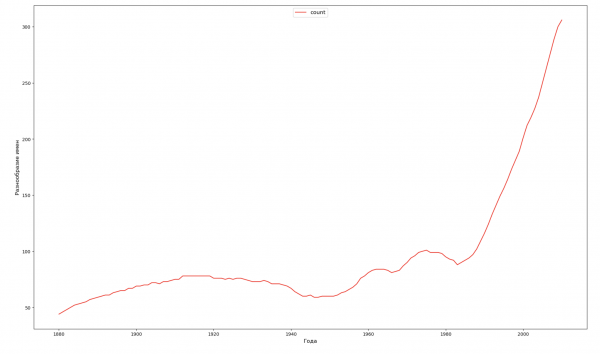
Do të zgjedhim 4 vite nga gjithë periudha dhe do të shfaqim për secilin vit shpërndarjen sipas shkronjës së parë në emër dhe sipas shkronjës së fundit në emër:
nga string import ascii_lowercase, ascii_uppercase

fig_first, ax_first = plt.subplots(1, 1, figsize=(14,10))
fig_last, ax_last = plt.subplots(1, 1, figsize=(14,10))

index = np.arange(len(ascii_uppercase))
years = [1944, 1978, 1991, 2003]
colors = ['r', 'g', 'b', 'y']
n = 0
for year in years:
    dataset = datalist.format(year=year)
    csv = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    names = csv.groupby('name', as_index=False).aggregate(np.sum)
    count = names.shape[0]

    dataframe = pd.DataFrame({'letter': [], 'frequency_first': [], 'frequency_last': []})
    for letter in ascii_uppercase:
        countFirst = (names[names.name.str.startswith(letter)].count()['count'])
        countLast = (names[names.name.str.endswith(letter.lower())].count()['count'])

        dataframe = dataframe.append(pd.DataFrame({
            'letter': [letter],
            'frequency_first': [countFirst / count * 100],
            'frequency_last': [countLast / count * 100]}))

    ax_first.bar(index + 0.3 * n, dataframe['frequency_first'], 0.3, alpha=0.5, color=colors[n], label=year)
    ax_last.bar(index + bar_width * n, dataframe['frequency_last'], 0.3, alpha=0.5, color=colors[n], label=year)
    n += 1

ax_first.set_xlabel('Shkronja e alfabetit')
ax_first.set_ylabel('Frekuenca, %')
ax_first.set_title('Shkronja e parë në emër')
ax_first.set_xticks(index)
ax_first.set_xticklabels(ascii_uppercase)
ax_first.legend()

ax_last.set_xlabel('Shkronja e alfabetit')
ax_last.set_ylabel('Frekuenca, %')
ax_last.set_title('Shkronja e fundit në emër')
ax_last.set_xticks(index)
ax_last.set_xticklabels(ascii_uppercase)
ax_last.legend()

fig_first.tight_layout()
fig_last.tight_layout()

plt.show()
Të gjejmë një listë të disa njerëzve të njohur (presidentë, këngëtarë, aktorë, personazhe filmash) dhe të vlerësojmë ndikimin e tyre në dinamikën e emrave:
celebrities = {'Frank': 'M', 'Britney': 'F', 'Madonna': 'F', 'Bob': 'M'}
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe.assign(year=year))

result = pd.concat(dataframes)

for celebrity, sex in celebrities.items():
    names = result[result.name == celebrity]
    dataframe = names[names.sex == sex]
    fig, ax = plt.subplots(1, 1, figsize=(16,8))

    ax.set_xlabel('Vitet', fontsize = 10)
    ax.set_ylabel('Lindshmëria', fontsize = 10)
    ax.plot(dataframe['year'], dataframe['count'], label=celebrity, color='r', ls='-')
    ax.legend(loc=9, fontsize=12)

    plt.show()
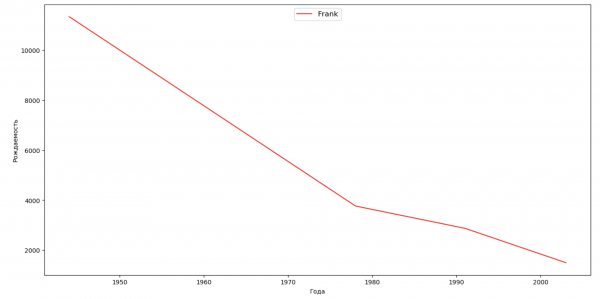
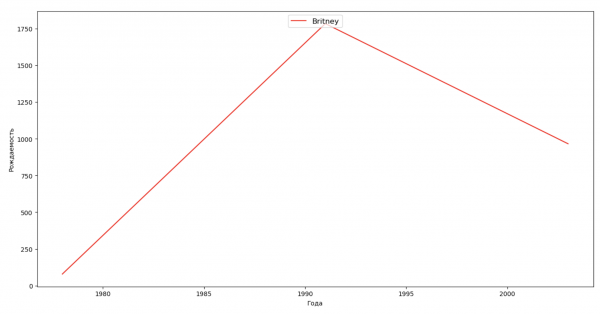
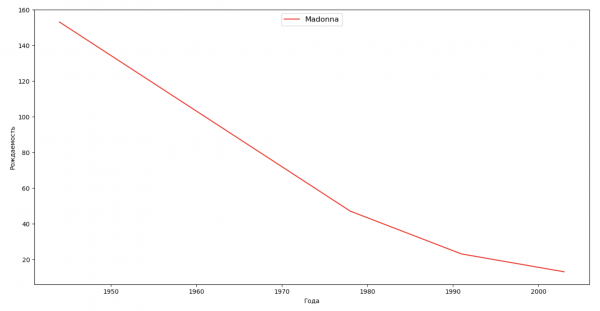
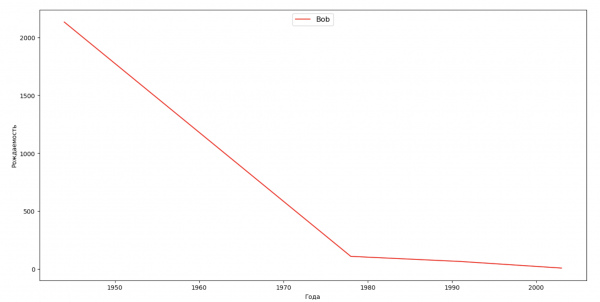
Për të stërvitur, mund të shtoni në vizualizim periudhën e jetës së një celebrity, në mënyrë që të vlerësoni ndikimin e tyre mbi dinamikën e emrave.
Këtu përfunduam të gjitha qëllimet tona. Ne punuam me aftësitë e përdorimit të mjeteve të grupimit dhe vizualizimit të të dhënave në Python dhe do të vazhdojmë të punojmë me të dhënat. Çdo kush mund të nxjerrë përfundimet nga të dhënat e vizualizuara që kemi përgatitur.
Të gjithë me dije!
Burimi: habr.com
