

Shumë mendojnë se është e mjaftueshme të transferohet aplikacioni në Kubernetes (ose përmes Helm-it, ose manualisht) - dhe kjo do të sjellë lumturi. Por jo gjithçka është kaq e thjeshtë.
Ekipa përkthena artikullin e inxhinierit DevOps, Julian Gindi. Ai tregon me cilat pengesa u përball kompania e tij gjatë migrimit, në mënyrë që të mos shkelni mbi të njëjtat rake.
Hapi i parë: konfigurimi i kërkesave të pod-it dhe kufijve
Të fillojmë me konfigurimin e një mjedisi të pastër, ku do të punojnë pod-ët tanë. Kubernetes bën një punë të shkëlqyer në planifikimin e pod-ëve dhe ndihmën në menaxhimin e gjendjeve të dështimit. Por doli se planifikuesi ndonjëherë nuk mund të vendosë një pod, nëse ka vështirësi në vlerësimin e sa burime i duhen për të funksionuar me sukses. Pikërisht këtu shfaqen kërkesat për burime dhe kufijtë. Ka shumë debate mbi qasjen më të mirë për konfigurimin e kërkesave dhe kufijve. Nd sometimes duket se kjo është më shumë art sesa shkencë. Këtu është qasja jonë.
Kërkesat e pod-it (pod requests) janë vlera kryesore që përdoret nga planifikuesi për vendosjen optimale të pod-it.
Nga : në hapin e filtrimit përcaktohet grupi i nyjeve, ku është e mundur të planifikohet pod-i. Për shembull, filtri PodFitsResources kontrollon nëse ka mjaft burime në nyje për të përmbushur kërkesat specifike të pod-it për burime.
Kërkesat e aplikacionit i përdorim në mënyrë që të vlerësojmë se sa burime në të vërtetë i nevojiten aplikacionit për të funksionuar normalisht. Kështu, planifikuesi do të jetë në gjendje të vendosë nyjet në mënyrë realiste. Fillimisht, ne do të dëshironim të vendosnim kërkesat me një rezervë, për të garantuar një sasi mjaft të madhe burimesh për secilin pod, por vërejtëm se koha e planifikimit u rrit ndjeshëm, dhe disa pod-e nuk u planifikuan plotësisht, sikur nuk kishin bërë asnjë kërkesë për burime.
Në këtë rast, planifikuesi shpesh "dështonte" në menaxhimin e pod-eve dhe nuk ishte në gjendje që t’i riplanifikonte, për shkak se plani i menaxhimit nuk kishte asnjë ide se sa burime do t’i nevojitet aplikacionit, dhe kjo është një komponent kyç i algoritmit të planifikimit.
Kufijtë e pod-it (pod limits) janë një kufizim më i saktë për pod-in. Ai përfaqëson sasinë maksimale të burimeve që klasteri do t’i alokojë kontejnerit.
Përsëri, nga : nëse për kontejnerin është vendosur një kufi memorie 4 GiB, atëherë kubelet (dhe mjedisi i ekzekutimit të kontejnerit) do ta zbatojë atë me forcë. Mjedisi i ekzekutimit nuk lejon që kontejneri të përdorë më shumë se kufiri i caktuar i burimeve. Për shembull, kur një proces në kontejner përpiqet të përdorë më shumë memori se sa lejohet, bërthama e sistemit përfundon këtë proces me gabimin
Kontejneri gjithmonë mund të përdorë më shumë burime se sa është caktuar në kërkesën për burime, por asnjëherë nuk mund të përdorë më shumë se sa është caktuar në kufizim. Ky vlerësim është i vështirë për t'u vendosur saktë, por është shumë i rëndësishëm.
Idealisht ne duam që kërkesat për burimet e pod-it të ndryshojnë gjatë ciklit të jetës së procesit, pa ndërhyrë në proceset e tjera në sistem — kjo është qëllimi i vendosjes së kufijve.
Fatkeqësisht nuk mund të jap udhëzime të sakta se cilat vlera duhet të vendosen, por ne vetë ia përshtatim rregullave të mëposhtme:
- Duke përdorur një mjet për testimin e ngarkesës, ne modelojmë një nivel të bazuar të trafikut dhe vëzhgojmë përdorimin e burimeve të pod-it (memoria dhe CPU).
- Vendosim kërkesat e pod-it në një vlerë të ulët të rastësishme (me një kufizim burimesh rreth 5 herë më të lartë se vlera e kërkesave) dhe vëzhgojmë. Kur kërkesat janë shumë të ulëta, procesi nuk mund të fillojë, gjë që shpesh shkakton gabime misterioze në kohën e ekzekutimit në Go.
Dua të theksoj se kufizimet më të larta të burimeve e komplikojnë planifikimin, sepse pod-i ka nevojë për një nyje objektiv me burime të mjaftueshme të disponueshme.
Imagjinoni një situatë kur keni një server të lehtë në web me një kufi shumë të lartë burimesh, për shembull 4 GB memorie. Probabilisht, ky proces do të duhet të shkallëzohet horizontalisht dhe çdo modul i ri do të duhet të planifikohet në një nyje me një vëllim të disponueshëm të memorie jo më pak se 4 GB. Nëse një nyje e tillë nuk ekziston, klasteri duhet të sjellë një nyje të re për të trajtuar këtë pod, që mund të marrë ca kohë. Është e rëndësishme të arrihet një diferencë minimale midis kërkesave për burime dhe kufijve, në mënyrë që të sigurohet një shkallëzim të shpejtë dhe të qetë.
Hapi i dytë: konfigurimi i testeve Liveness dhe Readiness
Ky është një temë tjetër e ndjeshme që shpesh diskutohet në komunitetin Kubernetes. Është e rëndësishme të kuptoni mirë testet e gjallërisë (Liveness) dhe gatishmërisë (Readiness), pasi ato ofrojnë një mekanizëm për funksionimin e qëndrueshëm të softuerit dhe minimizojnë kohën e papunësisë. Sidoqoftë, ato mund të dëmtojnë rëndë performancën e aplikacionit tuaj nëse nuk janë konfiguruar siç duhet. Më poshtë jepet një përmbledhje e asaj që përfaqësojnë të dy provat.
Liveness tregon nëse kontejneri është duke punuar. Nëse ajo dështon, kubelet vret kontenierin dhe politika e rinisjes aktivizohet për të. Nëse kontenieri nuk është i pajisur me provën Liveness, gjendja e paracaktuar do të jetë suksesi — kështu thotë .
Provat Liveness duhet të jenë të lira, do të thotë që nuk duhet të konsumojnë shumë burime, pasi ato ekzekutohen shpesh dhe duhet t'i informojnë Kubernetes se aplikacioni është aktiv.
Nëse vendosni parametrin për ta ekzekutuar çdo sekondë, atëherë kjo do të shtojë 1 kërkesë për sekondë, prandaj merrni parasysh se për të përballuar këtë trafik do të nevojiten burime të tjera.
Në kompaninë tonë, testet Liveness kontrollojnë komponentët kryesorë të aplikacionit, edhe nëse të dhënat (p.sh., nga një bazë të dhënash ose cache të largët) nuk janë plotësisht të disponueshme.
Ne kemi konfiguruar në aplikacione një pikë fundore të 'gjallërisë', e cila thjesht kthen kodin e përgjigjes 200. Ky është një tregues se procesi është aktiv dhe i aftë për të trajtuar kërkesat (por ende jo trafikun).
Prova Readiness tregon nëse kontejneri është i gatshëm për të shërbyer kërkesat. Nëse prove e gatishmërisë dështon, kontrolluesi i pikave përfundimtare heq adresën IP të pods nga pikat përfundimtare të të gjitha shërbimeve që lidhen me podin. Kjo thuhet gjithashtu në dokumentacionin Kubernetes.
Provat Readiness konsumojnë më shumë burime, pasi ato duhet të arrijnë në backend në një mënyrë të tillë që të tregojnë gatishmërinë e aplikacionit për të pranuar kërkesa.
Në komunitet po zhvillohen shumë polemika nëse duhet të shkojmë drejtpërdrejt te databaza. Duke marrë parasysh kostot (kontrollet kryhen shpesh, por ato mund të menaxhohen), ne vendosëm se për disa aplikacione gatishmëria për të shërbyer trafikun konsiderohet e vlefshme vetëm pas verifikimit se regjistrimet kthehen nga databaza. Probat e mirëpërcaktuara të gatishmërisë sigurojnë një nivel më të lartë të disponueshmërisë dhe eliminojnë ndalimet gjatë përhapjes.
Nëse vendosni të bëni një kërkesë në databazë për të verifikuar gatishmërinë e aplikacionit, sigurohuni që ajo të jetë sa më e lirë. Le të marrim këtë kërkesë:
SELECT small_item FROM table LIMIT 1Ja një shembull se si ne e konfigurojmë këto dy vlera në Kubernetes:
livenessProbe:
 httpGet:
   path: /api/liveness
   port: http
readinessProbe:
 httpGet:
   path: /api/readiness
   port: http  periodSeconds: 2
Mund të shtoni disa parametra të tjerë të konfigurimit:
initialDelaySeconds— sa sekonda do të kalojnë nga fillimi i kontejnerit deri në fillimin e kontrollit.periodSeconds— intervali i pritjes mes kontrollove.timeoutSeconds— numri i sekondave pas të cilave një pod konsiderohet problematik. Një kohë e zakonshme.failureThreshold— numri i dështimeve në kontrolle, përpara se një sinjal rinovimi të dërgohet në pod.successThreshold— numri i kontrollove të suksesshme, përpara se pod-i të kalojë në gjendjen e gatishmërisë (pas dështimit, kur pod-i fillon ose ripërtërihet).
Hapi i tretë: konfigurimi i politikave të rrjetit të defoltit të pod-it
Në Kubernetes, topologjia e rrjetit është 'e sheshtë', në mënyrë të paracaktuar të gjithë pod-et lidhen drejtpërdrejt me njëri-tjetrin. Në disa raste, kjo nuk është e dëshirueshme.
Një problem potencial i sigurisë qëndron në faktin se një sulmues mund të përdorë një aplikacion të vetëm të prekshëm për të dërguar trafik në të gjithë pod-et në rrjet. Si në shumë fusha të sigurisë, këtu vlen parimi i privilegjeve të minimizuara. Idealisht, politikat e rrjetit duhet të specifikojnë qartë cilat lidhje midis pod-eve janë të lejuara dhe cilat jo.
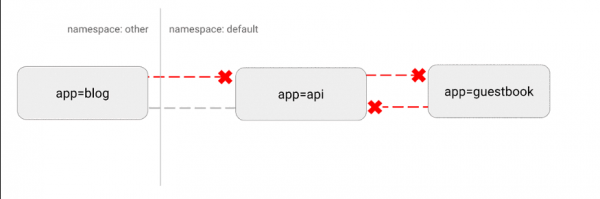
Për shembull, më poshtë është një politikë e thjeshtë që ndalon të gjithë trafik të ardhur për një hapësirë të caktuar emri:
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
 name: default-deny-ingress
spec:
 podSelector: {}
 policyTypes:
   - Ingress
Vizualizimi i kësaj konfiguracioni:
(https://miro.medium.com/max/875/1*-eiVw43azgzYzyN1th7cZg.gif)
Më hollësisht .
Hapi i katërt: sjellje jo standarde me anë të hooks dhe init-container-eve
Një nga detyrat tona kryesore ishte të siguronim deploje në Kubernetes pa ndërprerje për zhvilluesit. Kjo është e vështirë për shkak se ka shumë mënyra për të përfunduar aplikacionet dhe për të liruar burimet e përdorura nga ato.
Vështirësi të veçanta u shfaqën me . Ne vërejtëm se gjatë shpërndarjes në rend, lidhjet aktive ndërprenë deri në përfundimin e suksesshëm.
Pas kërkimeve të gjera në internet, u zbulua se Kubernetes nuk pret që lidhjet Nginx të shfrytëzohen plotësisht para se të përfundojë podi. Me ndihmën e hook-ut pre-stop, ne implementuam një funksionalitet të tillë dhe u shpëtuam plotësisht nga ndërprerjet:
lifecycle:
 preStop:
   exec:
     command: ["/usr/local/bin/nginx-killer.sh"]
Por nginx-killer.sh:
#!/bin/bash
sleep 3
PID=$(cat /run/nginx.pid)
nginx -s quit
while [ -d /proc/$PID ]; do
   echo "Waiting while shutting down nginx..."
   sleep 10
done
Një tjetër paradigmë jashtëzakonisht e dobishme është përdorimi i init-container-eve për menaxhimin e nisjes së aplikacioneve specifike. Kjo është veçanërisht e dobishme nëse keni një proces të rëndë migrimi të bazës së të dhënave që duhet të niset para se të nisë aplikacioni. Për këtë proces ju gjithashtu mund të specifikoni një limit më të lartë burimesh, pa vendosur një limit të tillë për aplikacionin kryesor.
Një skemë tjetër e zakonshme është qasja në sekretet në init-container, i cili ofron këto akreditime për modulin kryesor, duke parandaluar qasjen e paautorizuar në sekretet nga moduli më i rëndësishëm i aplikacionit.
Si zakonisht, një citatë nga dokumentacioni: init-container-et ekzekutojnë në siguri kodin ose utilitetet përdoruesve, të cilat ndryshe do të ulshin sigurinë e imazhit të kontejnerit të aplikacionit. Duke mbajtur veçmas mjetet e panevojshme, ju kufizoni sipërfaqen e sulmit të imazhit të kontejnerit të aplikacionit.
Hapi i pestë: konfigurimi i kernelit
Në fund, do të flasim për një teknikë më të avancuar.
Kubernetes është një platformë jashtëzakonisht fleksibile, e cila lejon që të ekzekutoni ngarkesa pune ashtu siç e gjykoni të nevojshme. Ne kemi një sërë aplikacionesh me performancë të lartë, që kërkojnë burime jashtëzakonisht të mëdha. Pas testimeve të gjera të ngarkesës, ne zbuluam se një nga aplikacionet përballon me vështirësi ngarkesën e pritshme të trafikut, nëse janë në fuqi konfigurimet e Kubernetes-it në mënyrë të paracaktuar.
Megjithatë, Kubernetes lejon ekzekutimin e një kontejneri me privilegje, i cili ndryshon parametrat e bërthamës vetëm për podin përkatës. Këtu është ajo që kemi përdorur për të ndryshuar numrin maksimal të lidhjeve të hapura:
initContainers:
  - emri: sysctl
     imazhi: alpine:3.10
     securityContext:
         privileged: true
      komanda: ['sh', '-c', "sysctl -w net.core.somaxconn=32768"]
Kjo është një teknikë më e avancuar, e cila shpesh nuk është e nevojshme. Por nëse aplikacioni juaj ka vështirësi me ngarkesat e mëdha, mund të provoni të konfiguroni disa nga këta parametra. Informacione më të detajuara mbi këtë proces dhe konfigurimin e vlerave të ndryshme — si gjithmonë .
Në përfundim
Megjithëse Kubernetes mund të duket si një zgjidhje gati 'nga kutia', për të siguruar funksionimin e pa ndërprerje të aplikacioneve, nevojiten disa hapa kyç.
Gjatë tërë migrimit në Kubernetes, është e rëndësishme të ndiqni 'ciklin e testimit të ngarkesës': aktivizoni aplikacionin, testoni atë nën ngarkesë, vëzhgoni metrikat dhe sjelljen gjatë shkallëzimit, konfiguroni cilësimet bazuar në këto të dhëna, pastaj përsërisni ciklin sërish.
Vlerësoni realistisht trafikun e pritur dhe provoni të kaloni kufijtë e tij për të parë cilat komponentë do të dështojnë të parët. Me një qasje të tillë iterative, për të arritur suksesin mund të mjaftojnë vetëm disa nga rekomandimet e përmendura. Ose mund të kërkohet një parametrizim më i thellë.
Gjithmonë bëni vetes pyetje të tilla:
- Sa resurse konsumojnë aplikacionet dhe si do të ndryshojë ky volum?
- Cilat janë kërkesat reale për shkallëzim? Sa trafik do të trajtojë mesatarisht aplikacioni? Dhe çfarë ndodh me trafikun maksimal?
- Sa shpesh do t'i nevojitet shërbimit shkallëzim horizontal? Sa shpejt duhet të futen në punë podet e reja për të pranuar trafik?
- Sa saktë përfundojnë podet? A është e nevojshme? A mund të arrihet një shpërndarje pa ndalesa?
- Si të minimizoni rreziqet për sigurinë dhe të kufizoni dëmmet nga çdo pod i kompromentuar? A kanë disa shërbime leje ose akses që ata nuk e kërkojnë?
Kubernetes ofron një platformë të jashtëzakonshme që lejon përdorimin e praktikave më të mira për të zbatuar mijëra shërbime në një grup. Megjithatë, të gjitha aplikacionet janë të ndryshme. Ndonjëherë implementimi kërkon pak më shumë punë.
Fatmirësisht, Kubernetes ofron cilësimet e nevojshme për të arritur të gjitha objektivat teknike. Duke përdorur një kombinim të kërkesave për burime dhe kufij, provat Liveness dhe Readiness, konteinerët init, politikat rrjet dhe konfiguratat e pahartuar të bërthamës, mund të arrini performancë të lartë së bashku me qëndrueshmërinë dhe shkallëzimin e shpejtë.
Çfarë tjetër mund të lexoni:
- .
- .
- .
Burimi: habr.com
