

Qëndrueshmëria dhe disponueshmëria e lartë janë tema të mëdha, kështu që do t'i kushtojmë RabbitMQ dhe Kafka artikuj të veçantë. Ky artikull është për RabbitMQ, ndërsa artikulli tjetër është për Kafka, në krahasim me RabbitMQ. Artikulli është i gjatë, prandaj bëni një komoditet.
Le të shqyrtojmë strategjitë e qëndrueshmërisë, koherencës dhe disponueshmërisë së lartë (HA), si dhe kompromiset që duhet të bëhen në çdo strategji. RabbitMQ mund të funksionojë në një klaster nyjesh - dhe atëherë klasifikohet si një sistem të shpërndarë. Kur flasim për sistemet e shpërndara, shpesh flasim për koherencën dhe disponueshmërinë.
Këto koncepte përshkruajnë se si sillet një sistem në rast të një dështimi. Dështimi i lidhjes rrjet, dështimi i serverit, dështimi i hard diskut, mungesa e përkohshme e serverit për shkak të grumbullimit të të dhënave, humbja e paketeve ose ngadalësimi i lidhjes rrjet. Të gjitha këto mund të çojnë në humbje të të dhënave ose konflikte. Duket se është praktikisht e pamundur të ngrish një sistem, në mënyrë të njëkohshme dhe plotësisht të koherent (pa humbje të të dhënave, pa kundërshtim të të dhënave), dhe të jetë i disponueshëm (do të pranojë operacione leximi dhe shkrimi) për të gjitha rastet e dështimit.
Ne do të shohim se koherenca dhe disponueshmëria janë në skajet e ndryshme të spektrit, dhe duhet të zgjidhni se në cilin drejtim të optimizoni. Lajmi i mirë është se me RabbitMQ ky zgjedhje është e mundur. Keni ato "leverat nerd" për të lëvizur balancën drejt më shumë koherencës ose më shumë disponueshmërisë.
Do t'i kushtohet vëmendje të veçantë se cilat konfigurime çojnë në humbje të të dhënave për shkak të konfirmimeve. Ekziston një zinxhir përgjegjësie midis botuesve, brokerëve dhe konsumatorëve. Pasi mesazhi i është dorëzuar brokerit, kjo është puna e tij - të mos humbasë mesazhin. Kur brokeri konfirmon pranim nga botuesi të mesazhit, ne nuk presim që ai të humbet. Por do të shohim se kjo mund të ndodhë në varësi të konfigurimit të brokerit dhe botuesit tuaj.
Primitivët e qëndrueshmërisë së një nyje
Radhë të qëndrueshme / Rrjetëzimi
Në RabbitMQ ka dy lloje të radhëve: të qëndrueshme (durable) dhe të paqëndrueshme (non-durable). Të gjitha radhët ruhen në bazën e të dhënave Mnesia. Radhët e qëndruara shpallën përsëri kur niset nodi dhe, kështu, mbijetojnë rinisjen, dështimin e sistemit ose dështimin e serverit (derisa të dhënat ruajnë). Kjo do të thotë se sa herë që ju shpallni routing (exchange) dhe radhën si të qëndruara, infrastruktura e radhëve/routing do të rikthehet në operim.
Radhët e paqëndrueshme dhe routing fshihen kur ripërdoret nodi.
Mesazhet e qëndrueshme
Fakti që një radhë është e qëndrueshme nuk do të thotë se të gjitha mesazhet e saj do të mbijetojnë rinisjen e nodit. Do të rikuperohen vetëm mesazhet që janë vendosur nga publikuesi si të qëndrueshme (persistent). Mesazhet e qëndrueshme në të vërtetë krijojnë një ngarkesë shtesë për brokerin, por nëse humbja e mesazhit është e papranueshme, atëherë nuk ka tjetër zgjedhje.
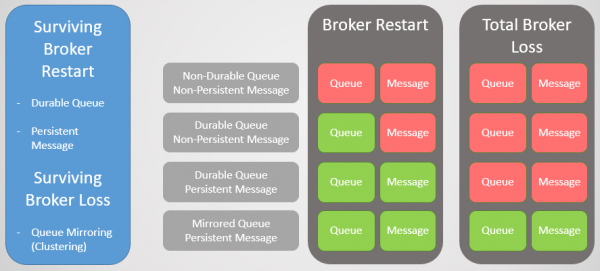
Fig. 1. Matrica e qëndrueshmërisë
Klastrimi me pasqyrime radhësh
Për të mbijetuar humbjen e brokerit, na nevojitet tepërsi. Mund të kombinojmë disa nodo RabbitMQ në një klaster dhe pastaj të shtojmë tepërsi të mëtejshme përmes replikimit të radhëve mes disa nodave. Kështu, nëse një nod bie, ne nuk humbasim të dhëna dhe mbetemi të aksesueshëm.
Pasqyrimi i radhës:
- një radhë kryesore (master), e cila merr të gjitha komandat për shkrim dhe lexim
- një ose më shumë pasqyra, të cilat merrni të gjitha mesazhet dhe metadatet nga radha kryesore. Këto pasqyra nuk ekzistojnë për shkak të shkallëzimit, por ekskluzivisht për tepërsi.
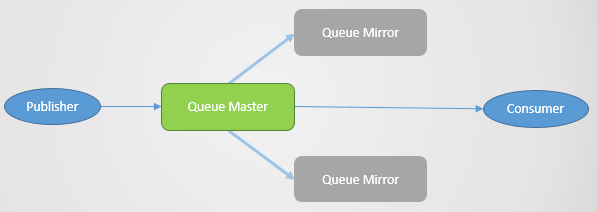
Fig. 2. Pasqyrimi i radhës
Pasqyrimi vendoset nga politika përkatëse. Në të mund të zgjidhet faktor i replikimit dhe madje nodet ku duhet të vendoset radhë. Shembuj:
ha-mode: allha-mode: exactly, ha-params: 2(një master dhe një pasqyrë)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Konfirmimi për publikuesin
Për të arritur një regjistrim të zakonshëm, janë të nevojshme konfirmimet për botuesin (Publisher Confirms). Pa to, ka mundësi për humbje të mesazheve. Konfirmimi i dërgohet botuesit pasi mesazhi të regjistrohet në disk. RabbitMQ regjistron mesazhet në disk jo në momentin e pranimit, por në baza periodike, rreth disa qindra milisekondash. Kur radhët janë pasqyruar, konfirmimi dërgohet vetëm pasi të gjitha pasqyrat gjithashtu të kenë regjistruar kopjen e tyre të mesazhit në disk. Kjo do të thotë se përdorimi i konfirmimeve shton vonesë, por nëse siguria e të dhënave është e rëndësishme, ato janë të nevojshme.
Radhë rezistente ndaj dështimit
Kur brokeri ndalon ose dështojnë, të gjitha radhët kryesore (master) në këtë nyjë ndalen bashkë me të. Pastaj, klusteri zgjedh pasqyrën më të vjetër të çdo masteri dhe e promovon atë si një master të ri.
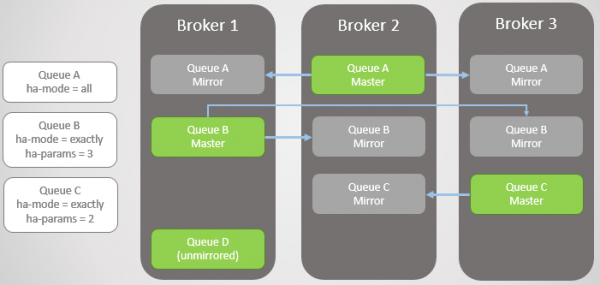
Fig. 3. Disa radhë të pasqyruara dhe politikat e tyre
Brokeri 3 dështon. Vini re se pasqyra e Radhës C në Brokerin 2 ngjitet në master. Gjithashtu, vërejtni se për Radhën C është krijuar një pasqyrë e re në Brokerin 1. RabbitMQ gjithmonë përpiqet të mbajë raportin e replikimit që është treguar në politikat tuaja.
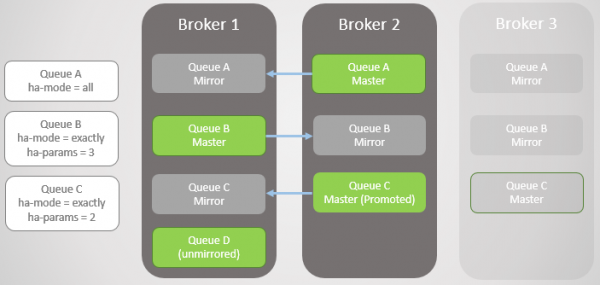
Fig. 4. Brokeri 3 dështon, duke shkaktuar dështimin e radhës C
Dëshmoni se Brokeri 1 dështon! Na ka mbetur vetëm një broker. Pasqyra e Radhës B ngjitet në master.
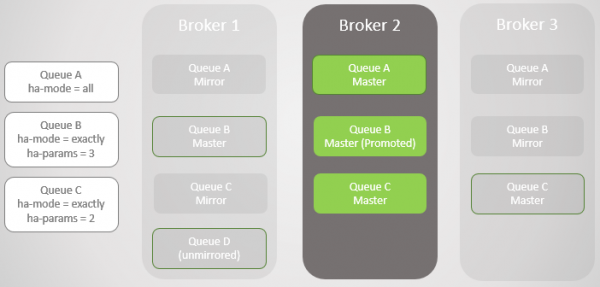
Fig. 5
E kthejmë Brokerin 1. Pavarësisht se sa të suksesshme ishin të dhënat që mbijetuan humbjen dhe rikthimin e brokerit, të gjitha mesazhet e pasqyruara të radhës janë hedhur gjatë rindizjes. Është e rëndësishme të theksohet, pasi do të ketë pasoja. Shpejt do të shqyrtojmë këto pasoja. Pra, Brokeri 1 tani është përsëri një anëtar i klasterit, dhe klasteri përpiqet të respektojë politikat dhe kështu krijon pasqyra në Brokerin 1.
Në këtë rast, humbja e Brokerit 1 ishte e plotë, ashtu si dhe e dhënave, kështu që Radhë B e pa pasqyrë u humb tërësisht.
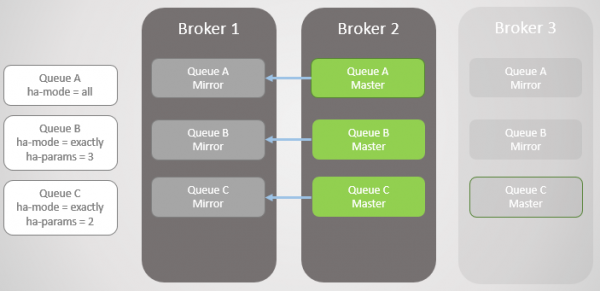
Fig. 6. Brokeri 1 kthehet në punë
Broker 3 është rikthyer në funksion, kështu që radhët A dhe B po rikthejnë pasqyrat e krijuara mbi të, për t'u përmbushur politikave të tyre HA. Por tani, të gjitha radhët kryesore janë në një nod! Kjo nuk është ideale, do të ishte më mirë një shpërndarje e barabartë mes nodëve. Fatkeqësisht, këtu nuk ka shumë mundësi për riparimin e balancimit të masterëve. Do të kthehemi në këtë problem më vonë, pasi fillimisht duhet të shqyrtojmë sinkronizimin e radhës.
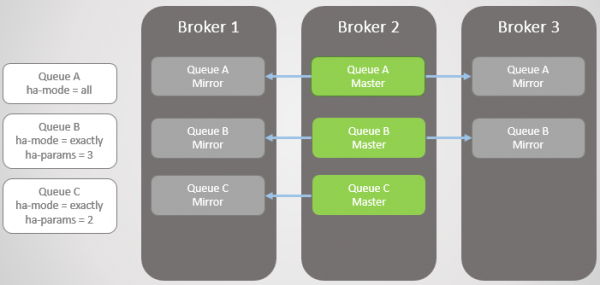
Fig. 7. Broker 3 rikthehet në funksion. Të gjitha radhët kryesore janë në një nod!
Siç është, tani duhet të keni një pamje se si pasqyrat sigurojnë tepërsi dhe qëndresë ndaj dështimit. Kjo garanton disponueshmërinë në rast dështimi të një nodi dhe mbron nga humbja e të dhënave. Por ne nuk kemi përfunduar ende, sepse në të vërtetë gjithçka është shumë më e komplikuar.
Sinkronizimi
Kur krijoni një pasqyrë të re, të gjitha mesazhet e reja gjithmonë do të replikohen në këtë pasqyrë dhe çdo tjetër. Sa i përket të dhënave ekzistuese në radhën kryesore, ne mund t'i replikojmë ato në pasqyrën e re, e cila bëhet një kopje e plotë e masterit. Ne gjithashtu mund të mos replikojmë mesazhet ekzistuese dhe t'i lejojmë radhën kryesore dhe pasqyrën e re të bashkohen në një moment, kur mesazhet e reja hyjnë në bisht, ndërsa mesazhet ekzistuese dalin nga krye.
Kjo sinkronizim bëhet automatikisht ose manualisht dhe menaxhohet me politika të radhëve. Le të shqyrtojmë një shembull.
Kemi dy radhë të pasqyruara. Radhë A sinkronizohet automatikisht, ndërsa Radhë B manualisht. Të dy radhët kanë dhjetë mesazhe.
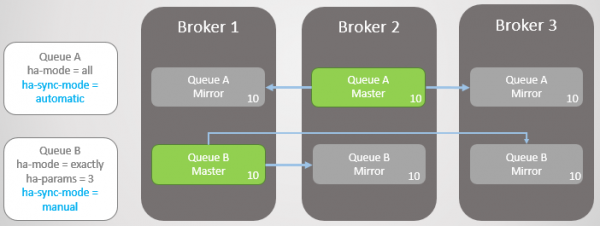
Fig. 8. Dy radhë me mënyra të ndryshme sinkronizimi
Tani po humbasim Broker 3.
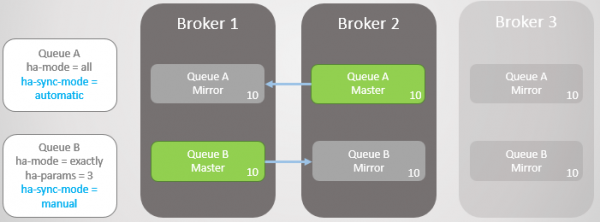
Fig. 9. Broker 3 ka rënë
Broker 3 rikthehet në funksion. Klasteri krijon një pasqyrë për çdo radhë në një nod të ri dhe automatikisht sinkronizon Radhën e Re A me masterin. Megjithatë, pasqyra e re e Radhës B mbetet bosh. Kështu, kemi tepërsi të plotë të Radhës A dhe vetëm një pasqyrë për mesazhet ekzistuese të Radhës B.
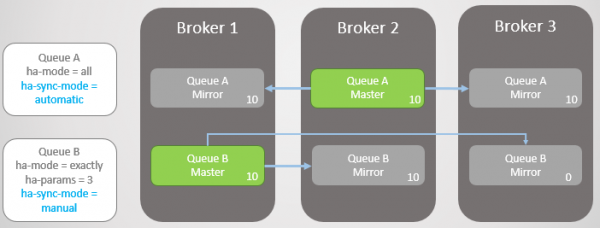
Fig. 10. Pasqyra e re e Radhës A merr të gjitha mesazhet ekzistuese, ndërsa pasqyra e re e Radhës B nuk merr asnjë
Të dy radhët pranojnë edhe nga dhjetë mesazhe. Më pas, Brokeri 2 bie, ndërsa Rradha A kthehet në pasqyrën më të vjetër që ndodhet te Brokeri 1. Në rastin e dështimit nuk ka humbje të të dhënave. Në Rradhën B ka njëzet mesazhe në mjeshtrinë dhe vetëm dhjetë në pasqyrë, pasi kjo radhë asnjëherë nuk ka riplikuar dhjetë mesazhet fillestare.
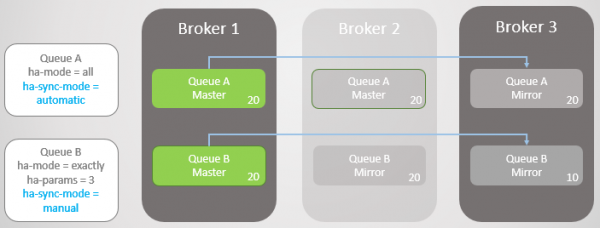
Fig. 11. Rradha A kthehet te Brokeri 1 pa humbje mesazhesh
Në të dy radhët pranojnë tani edhe nga dhjetë mesazhe. Tani bie Brokeri 1. Rradha A kalon pa probleme te pasqyra pa humbje mesazhesh. Sidoqoftë, Rradha B përballet me probleme. Në këtë pikë ne mund të optimizojmë ose disponueshmërinë, ose konsistencën.
Nëse duam të optimizojmë disponueshmërinë, atëherë politika ha-promote-on-failure duhet të vendoset në always. Ky është vlera e parazgjedhur, prandaj mund ta lëmë politikën të papërcaktuar fare. Në këtë rast, në thelb, ne lejojmë dështime në pasqyrat që nuk janë në sinkronizim. Kjo do të çojë në humbje mesazhesh, por rradha mbetet e disponueshme për lexim dhe shkrim.
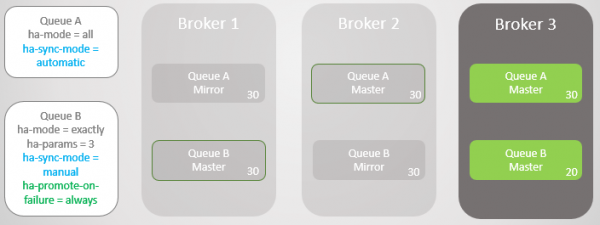
Fig. 12. Rradha A kthehet te Brokeri 3 pa humbje mesazhesh. Rradha B kthehet te Brokeri 3 me humbje të dhjetë mesazheve
Ne gjithashtu mund të vendosim ha-promote-on-failure në vlerën when-synced. Në këtë rast, në vend që të kthehet te pasqyra, rradha do të presë derisa Brokeri 1 me të dhënat e tij të kthehet në operim. Pas rikthimit të tij, rradha kryesore kthehet përsëri te Brokeri 1 pa humbje të të dhënave. Disponueshmëria sakrifikohet për sigurinë e të dhënave. Por kjo është një mënyrë me rrezik, e cila mund të çojë madje në humbjen e plotë të të dhënave, çka do ta shqyrtojmë së shpejti.
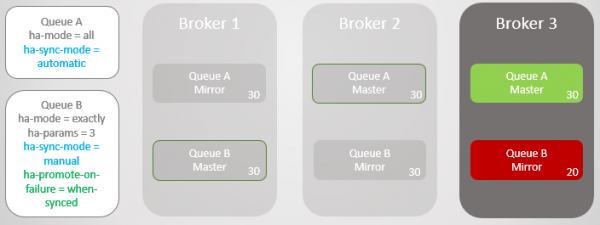
Fig. 13. Rradha B mbetet e paqasshme pas humbjes së Brokerit 1
Mund të bëni një pyetje: "A është ndoshta më mirë të mos përdorni kurrë sinkronizimin automatik?". Përshtypja është se sinkronizimi është një operacion bllokues. Gjatë sinkronizimit, rradha kryesore nuk mund të kryejë asnjë operacion lexim ose shkrim!
Le të shqyrtojmë një shembull. Tani kemi radhë shumë të mëdha. Si mund të arrijnë të rriten në këtë madhësi? Për disa arsye:
- Rradhat nuk përdoren aktivisht
- Këto janë rradha me shpejtësi të lartë, dhe tani konsumatorët po punojnë ngadalë
- Këto janë rradha me shpejtësi të lartë, ndodhi një dështim dhe konsumatorët po arrijnë
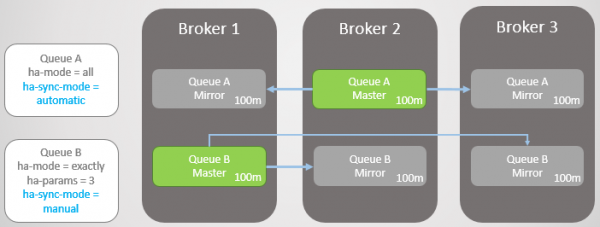
Fig. 14. Dy dy big queues with different synchronization modes
Now Broker 3 is crashing.
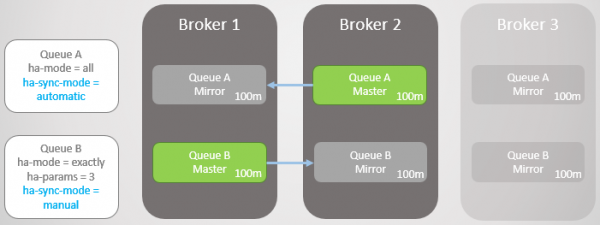
Fig. 15. Broker 3 crashes, leaving one master and one mirror in each queue
Broker 3 returns to operation, and new mirrors are created. The main Queue A starts replicating existing messages to the new mirror, and during this time the Queue is unavailable. Data replication takes two hours, resulting in two hours of downtime for this Queue!
However, Queue B remains available throughout the period. It sacrificed some redundancy for availability.
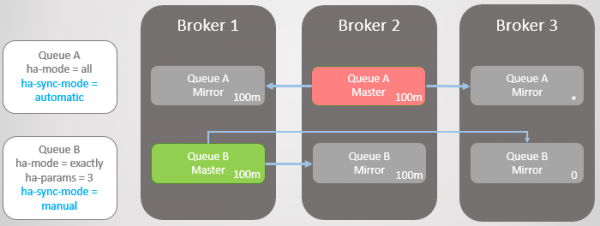
Fig. 16. The queue remains unavailable during synchronization
After two hours, Queue A also becomes available and can again start accepting read and write operations.
Azhurnimet
Such blocking behavior during synchronization complicates updates to clusters with very large queues. At some point, the node with the master needs to be restarted, which means either switching to a mirror or taking the queue offline during the server update. If we choose to switch, we will lose messages if the mirrors are not synchronized. By default, during broker shutdown, switching to an unsynchronized mirror does not occur. This means that as soon as the broker returns, we lose no messages; the only damage done is the queue's downtime. The rules for behavior during broker shutdown are set by policy. ha-promote-on-shutdown. You can set one of two values:
always= enable switching to unsynchronized mirrorswhen-synced= switch only to a synchronized mirror; otherwise, the queue becomes unavailable for reading and writing. The queue returns to operation as soon as the broker returns.
Either way, with large queues, one has to choose between data loss and unavailability.
When availability increases data security
Before making a decision, one must consider another complication. While automatic synchronization is better for redundancy, how does it affect data security? Of course, with better redundancy, RabbitMQ is less likely to lose existing messages, but what about new messages from publishers?
One must consider the following:
- A mund të kthejë një publisher gabim, dhe shërbimi më i lartë ose përdoruesi të provojë përsëri më vonë?
- A mundet publisher-i ta ruajë mesazhin lokalisht ose në një bazë të dhënash, që të provojë sërish më vonë?
Nëse publisher-i është në gjendje vetëm të heqë mesazhin, atëherë përmirësimi i disponueshmërisë gjithashtu rrit sigurinë e të dhënave.
Prandaj, duhet të kërkohet një ekuilibër dhe zgjidhja varet nga situata e veçantë.
Problemet me ha-promote-on-failure=when-synced
Ideja ha-promote-on-failure= when-synced ka të bëjë me faktin se ne parandalojmë kalimin në një pasqyrë të pa sinkronizuar dhe kështu shmangim humbjen e të dhënave. Rrjeti mbetet i paqasshëm për lexim ose shkrim. Në vend të kësaj, ne përpiqemi të rikthejmë brokerin e rënë me të dhëna të paprekura që të vazhdojë si master pa humbur të dhënat.
Por (dhe ky është një çështje e madhe) nëse brokeri humbi të dhënat e tij, atëherë kemi një problem të madh: rrjeti është humbur! Të gjitha të dhënat janë zhdukur! Edhe nëse keni pasqyra që zakonisht e ndjekin rrjetin kryesor, këto pasqyra gjithashtu janë hequr.
Për të riemëruar një nyjë me të njëjtin emër, ne i themi klashtit të harrojë nyjën e humbur (me komandën rabbitmqctl forget_cluster_node) dhe të nisin një broker të ri me të njëjtin emër host. Derisa klasteri të mbajë mend nyjën e humbur, ai mban edhe rrjetin e vjetër dhe pasqyrat e pa sinkronizuar. Kur klasterit i thuhet të harrojë nyjën e humbur, ky rrjet gjithashtu harrohet. Tani duhet ta shpallim përsëri. Ne kemi humbur të gjitha të dhënat, megjithëse kishim pasqyra me një grup të pjesshëm të të dhënave. Do të ishte më mirë të kalonim në një pasqyrë të pa sinkronizuar!
Prandaj, sinkronizimi manual (dhe mosrealizimi i sinkronizimit) së bashku me ha-promote-on-failure=when-synced, në mendimin tim, është mjaft i rrezikshëm. Dokumentet thonë se ky opsion ekziston për sigurinë e të dhënave, por është një thikë me dy tehe.
Ribalançimi i masterëve
Siç u premtua, kthehemi te problemi i grumbullimit të të gjithë masterëve në një ose më shumë nyje. Kjo mund të ndodhë edhe si rezultat i një përditësimi 'rrëshqitës' (rolling) të klasterit. Në një klaster me tre nyje, të gjitha rrjetet kryesore do të grumbullohen në një ose dy nyje.
Ribalançimi i masterëve mund të jetë problematik për dy arsye:
- Nuk ka mjete të mira për të realizuar ribalançimin
- Sinkronizimi i rrjeteve
Për ribalançimin ekziston një plug-in të tretë , i cili nuk mbështetet zyrtarisht. Në lidhje me plugins e jashtme në udhëzimin e RabbitMQ : «Plugin'i ofron disa mjete shtesë për konfigurimin dhe raportimin, por nuk mbështetet dhe nuk është kontrolluar nga ekipi i RabbitMQ. Përdorni me rrezikun tuaj».
Ekziston edhe një mashtrim tjetër për të zhvendosur rreshtin kryesor përmes politikave HA. Në udhëzimin përmendet për këtë. Funksionon kështu:
- Fshin të gjitha pasqyrat duke përdorur një politikë përkohësisht me prioritet më të lartë se politika ekzistuese HA.
- Ndryshon politikën përkohësisht HA për të përdorur modalitetin 'nodi' me tregimin e nodit ku duhet të zhvendoset rreshti kryesor.
- Sinkronizon rreshtin për migrim të detyruar.
- Pas përfundimit të migrimit, fshin politikën përkohësisht. Politika origjinale HA hyjnë në veprim dhe krijohen numri i nevojshëm i pasqyrave.
Disavantazhi është se ky qasje mund të mos funskionojë nëse keni rreshta të mëdhenj ose kërkesa strikte për tepërsi.
Tani le të shohim se si funksionojnë klasterët RabbitMQ me ndarjet e rrjetit.
Ndërprerja e lidhjes
Nodet e sistemit të shpërndarë lidhen me lidhje rrjetesh, dhe lidhjet rrjetike mund dhe do të shkëputen. Shpesh shkëputjesh varet nga infrastruktura lokale apo besueshmëria e sistemit të zgjedhur të re. Në çdo rast, sistemet e shpërndara duhet të jenë të afta për t'u përballur me to. Përsëri kemi zgjedhjen midis disponueshmërisë dhe koherencës, dhe përsëri lajm i mirë është se RabbitMQ ofron të dyja opsionet (thjesht jo njëkohësisht).
Me RabbitMQ kemi dy opsione kryesore:
- Të lejojmë ndarjen logjike (split-brain). Kjo siguron disponueshmëri, por mund të provokojë humbjen e të dhënave.
- Të ndalojmë ndarjen logjike. Mund të çojë në humbje të përkohshme të disponueshmërisë në varësi të mënyrës së lidhjes së klientëve me klasterin. Po ashtu mund të shkaktojë plotësisht pamundësi në klasterin me dy node.
Por çfarë është ndarja logjike? Kjo është kur klasteri ndahet në dy pjesë për shkak të humbjes së lidhjeve rrjetike. Në secilën anë, pasqyrat ngrihen në master, kështu që në fund çdo rresht ka disa mastera.
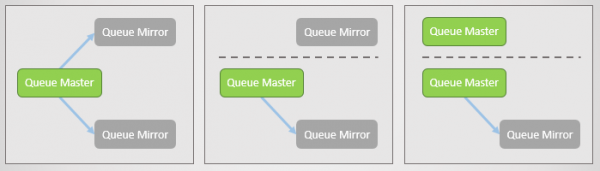
Fig. 17. Kryeqendra dhe dy pasqyra, secila në nyjë të ndryshme. Pastaj ndodh një dështim rrjeti, dhe një pasqyrë ndahet. Nyja e ndarë sheh se dy të tjera kanë rënë, dhe avancojnë pasqyrat e tyre deri te masteri. Tani kemi dy kryeqendra, dhe të dyja lejojnë të shkruhet dhe të lexohen.
Nëse botuesit dërgojnë të dhëna në të dy masterat, do të kemi dy kopje që ndahen të radhës.
Modet e ndryshme të RabbitMQ ofrojnë ose disponueshmëri, ose konsistencë.
Modi Ignore (në parazgjedhje)
Ky mod ofron disponueshmëri. Pas humbjes së lidhjes ndodh një ndarje logjike. Pas rikthimit të lidhjes, administratori duhet të vendosë se cilës ndarje t'i japë përparësi. Anija e humbur do të riniset, dhe të dhënat e grumbulluara nga kjo anije humben.
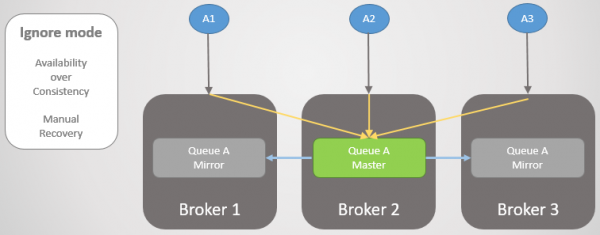
Fig. 18. Tre botues janë të lidhur me tre brokerë. Brenda, klasteri drejton të gjitha kërkesat në kryeqendrën në Brokerin 2.
Tani ne e humbim Brokerin 3. Ai sheh se brokerët e tjerë kanë rënë, dhe avancon pasqyrën e tij deri te masteri. Kështu ndodh ndarja logjike.
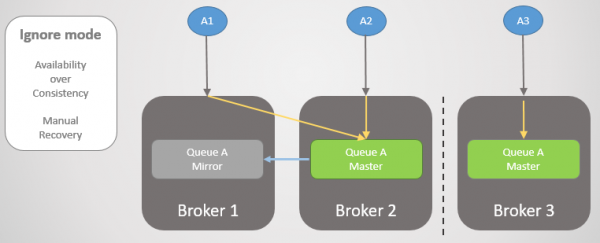
Fig. 19. Ndarja logjike (split-brain). Shkrimet shkojnë në dy kryeqendra, dhe dy kopjet ndahen.
Lidhja rikthehet, por ndarja logjike mbetet. Administratori duhet të zgjedhë me dorë anën e humbur. Në rastin e mëposhtëm, administratori rinis Brokerin 3. Të gjitha mesazhet që ai nuk arriti t'i dërgojë humbin.
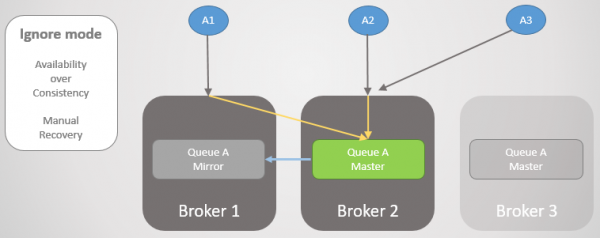
Fig. 20. Administratori çon në ndalesën e Brokerit 3.
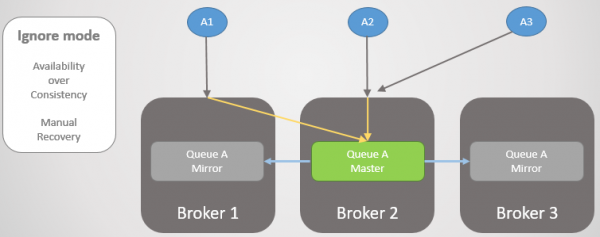
Fig. 21. Administratori fillon Brokerin 3 dhe ai bashkohet me klasterin, duke humbur të gjitha mesazhet që ishin aty.
Gjatë humbjes së lidhjes dhe pas rikthimit të saj, klasteri dhe kjo kryeqendër ishin të disponueshme për shkrim dhe lexim.
Modi Autoheal
Funksionon ashtu si moda Ignore, përveç se klasteri automatikisht zgjedh anën e humbur pas ndarjes dhe rikthimit të lidhjes. Anija e humbur kthehet në klaster bosh, dhe kryeqendra humb të gjitha mesazhet që ishin dërguar vetëm në atë anë.
Modi Pause Minority
Nëse nuk duam të lejojmë një ndarje logjike, opsioni ynë i vetëm është të heqim dorë nga leximi dhe shkrimi në anën më të vogël pas ndarjes së klasterit. Kur brokeri sheh që ndodhet në anën më të vogël, ai ndalon punën, pra mbyll të gjitha lidhjet e ekzistuara dhe refuzon çdo të re. Një herë në sekondë, ai kontrollon rikuperimin e lidhshmërisë. Sa herë që lidhshmëria rikuperohet, ai rifillon punën dhe bashkohet me klasterin.
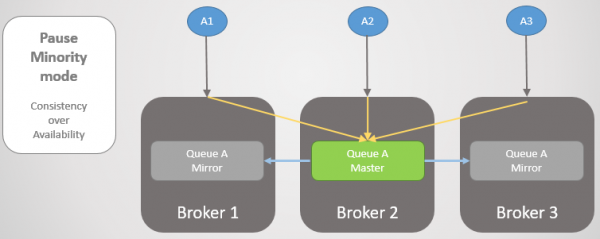
Fig. 22. Tre publikues janë të lidhur me tre brokerë. Brenda, klasteri drejton të gjitha kërkesat në radhën kryesore në Brokerin 2.
Pastaj Brokerët 1 dhe 2 ndahen nga Brokeri 3. Në vend që të rrisë pasqinë e tij në master, Brokeri 3 ndalon punën dhe bëhet i papërshtatshëm.
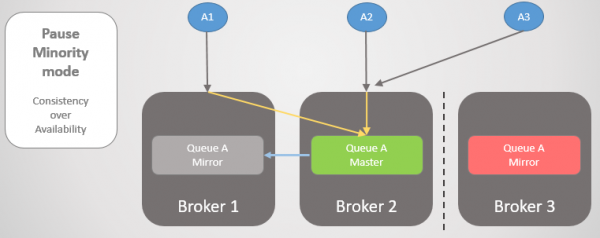
Fig. 23. Brokeri 3 ndalon punën, çaktivizon të gjithë klientët dhe refuzon kërkesat për lidhje.
Sa herë që lidhshmëria rikuperohet, ai kthehet në klaster.
Le të shikojmë një shembull tjetër, ku rada kryesore ndodhet në Brokerin 3.
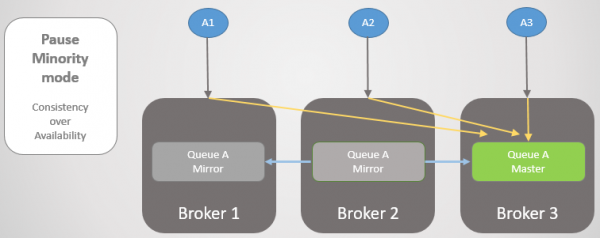
Fig. 24. Rada kryesore në Brokerin 3.
Pastaj ndodh e njëjta humbje lidhshmërie. Brokeri 3 ndalon, pasi ndodhet në anën më të vogël. Në anën tjetër, nyjat shohin që Brokeri 3 është ndarë, kështu që një pasqyrë më e vjetër nga Brokerët 1 dhe 2 rritet në master.
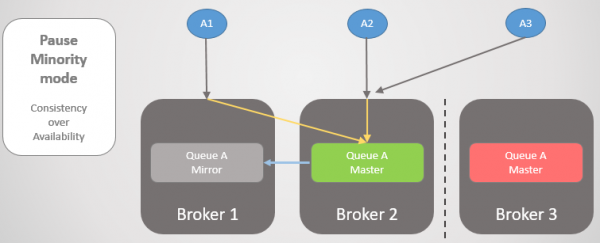
Fig. 25. Kalimi te Brokeri 2 në papërshtatshmërinë e Brokerit 3.
Kur lidhshmëria rikuperohet, Brokeri 3 do t'i bashkohet klasterit.

Fig. 26. Klasteri u kthye në punën normale.
Këtu është e rëndësishme të kuptojmë se ne arrijmë konsistencë, por gjithashtu mund të arrijmë disponueshmëri, nëse me sukses të transferojmë klientët në pjesën më të madhe të ndarjes. Për shumicën e situatave, personalisht do të zgjidhja modin Pause Minority, por kjo vërtet varet nga rasti i veçantë.
Për të siguruar disponueshmërinë, është e rëndësishme të sigurohemi që klientët lidhen me sukses me nyjën. Le të shqyrtojmë opsionet tona.
Sigurimi i lidhshmërisë së klientëve
Ne kemi disa mundësi se si të drejtojmë klientët në pjesën kryesore të klasterit ose në nyjat që punojnë (pas dështimit të një nyjeje). Së pari, le të kujtojmë se radhët specifike vendosen në një nyje të caktuar, por rrugëtimi dhe politikat riprodhohen në të gjitha nyjat. Klientët mund të lidhen me çdo nyje, dhe rrugëtimi i brendshëm do t'i drejtojë ata aty ku duhet. Por kur një nyje është pezull, ajo refuzon lidhjet, kështu që klientët duhet të lidhen me një nyje tjetër. Nëse një nyje ndalon, ajo në të vërtetë nuk mund të bëjë shumë.
Mundësitë tona:
- Qasja në klaster është e mundur përmes balancuesit të ngarkesës, i cili thjesht kalon nëpër nyjat, ndërsa klientët kryejnë përpjekje të përsëritura për lidhje deri në përfundim të suksesshëm. Nëse një nyje nuk punon ose është pezull, përpjekjet për lidhje me këtë nyje do të dështojnë, por përpjekjet e mëpasshme do të shkojnë në servera të tjerë (në mënyrë ciklike). Kjo është e përshtatshme për një humbje të shkurtër të lidhjes ose për një server që ka rënë dhe do të rrije shpejt.
- Qasja në klaster përmes balancuesit të ngarkesës dhe heqja e nyjave të pezulluara/dëmtuara nga lista, sa herë që identifikohen. Nëse bëhet shpejt, dhe nëse klientët janë në gjendje të kryejnë përpjekjet e lidhjes, atëherë ne do të arrijmë një disponueshmëri të vazhdueshme.
- Të jepni çdo klienti një listë të të gjitha nyjave, dhe klienti, kur lidhet, zgjedh rastësisht një prej tyre. Nëse gjatë përpjekjes për lidhje merr një gabim, ai kalon në nyjën e ardhshme në listë, derisa të krijojë lidhjen.
- Të largoni trafik nga nyja e rënë/pezulluar përmes DNS. Kjo bëhet me një TTL të vogël.
Përfundimet
Klasterizimi i RabbitMQ ka përfitimet dhe disavantazhet e veta. Dezavantazhet më serioze janë:
- kur nyjat bashkohen në klaster, ato heqin dorë nga të dhënat e tyre;
- sinkronizimi bllokues çon në paaftësinë e radhës.
Të gjitha vendimet e vështira rrjedhin nga këto dy karakteristika të arkitekturës. Nëse RabbitMQ do të kishte mundësinë të ruante të dhënat gjatë ri-ndërlidhjes së klasterit, atëherë sinkronizimi do të ndodhte më shpejt. Nëse do të ishte në gjendje të bënte sinkronizim pa bllokim, do të mbështeste më mirë radhët e mëdha. Zgjidhja e këtyre dy problemeve do të përmirësonte ndjeshëm karakteristikat e RabbitMQ si një teknologji e besueshme dhe me akses të lartë për shkëmbimin e mesazheve. Unë nuk do të rekomandoja RabbitMQ me klasterizim në situatat e mëposhtme:
- Rrjet i pasigurt.
- Ruajtje e pasigurt.
- Radhë shumë të mëdha.
Sa i përket konfigurimeve për akses të lartë, shqyrtoni këto:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(oseautoheal)- mesazhe të qëndrueshme
- sigurohuni që klientët të lidhen me nodin aktiv kur ndonjë nod del nga funksioni
Për koherencën (sigurinë e të dhënave) shqyrtoni këto konfigurime:
- Publisher Confirms dhe Manual Acknowledgements nga ana e konsumatorit
ha-promote-on-failure=when-synced, nëse botuesit mund të përpiqen përsëri më vonë dhe nëse keni një ruajtje shumë të besueshme! Përndryshe vendosni=always.ha-sync-mode=automatic(por për radhë të mëdha joaktive mund të kërkohet një mod manual; për më tepër, mendoni nëse mos aksesimi do të çonte në humbje mesazhesh)- modi Pause Minority
- mesazhe të qëndrueshme
Nuk i kemi shqyrtuar të gjitha çështjet e besueshmërisë dhe aksesit të lartë; për shembull, si të kryeni procedura administrative në siguri (si përditësimet e vazhdueshme). Duhet të flasim gjithashtu për federatën dhe plugin-in Shovel.
Nëse kam humbur ndonjë gjë, ju lutem më njoftoni.
Shihni gjithashtu artikullin tim , ku realizoj një përshkallëzim në klasterin RabbitMQ duke përdorur Docker dhe Blockade për të testuar disa skenarë të humbjes së mesazheve që janë përshkruar në këtë artikull.
Artikujt e mëparshëm të serisë:
Nr. 1 —
Nr. 2 —
Nr. 3 —
Burimi: habr.com
