

Shën. përkth.: Autori i këtij materiali është Cindy Sridharan, inxhiniere në kompaninë imgix, e specializuar në zhvillimin e API-ve dhe, veçanërisht, testimin e mikroshërbimeve. Në këtë material, ajo ndan vizionin e saj të zgjeruar mbi problemet aktuale në fushën e konsolidimit të shpërndarë, ku, sipas saj, ka një mungesë të instrumenteve efektivë për të zgjidhur çështjet e ngutshme.
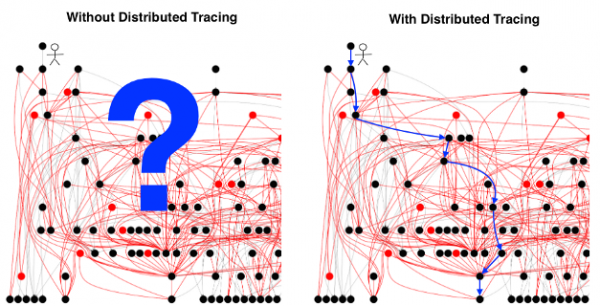
[Ilustrimi i huazuar nga në lidhje me konsolidimin e shpërndarë.]
Mendohet se është i vështirë për tu zbatuar, dhe përfitimi nga ai . "Problematika" e konsolidimit shpjegohet me shumë arsye, shpeshherë duke u referuar në vështirësinë e konfigurimit të çdo komponenti të sistemit për të transmetuar titujt përkatës me çdo kërkesë. Megjithëse ky problem me të vërtetë ekziston, ai nuk mund të quhet aspak i pakalueshëm. Po ashtu, nuk shpjegon pse zhvilluesit nuk e duan shumë konsolidimin (madje edhe atëherë kur është në funksion).
Vështirësia kryesore me konsolidimin e shpërndarë është se nuk është mbledhja e të dhënave, as standardizimi i formateve të shpërndarjes dhe paraqitjes së rezultateve, dhe as përcaktimi i kur, ku dhe si të bëhet mostrimi. Unë nuk po përpiqem të paraqes si triviale këto "problema të adaptueshmërisë" — për të qenë të sinqertë, ekzistojnë sfida mjaft të rëndësishme teknike dhe (nëse e shohim nga një këndvështrim vërtet Open Source ) politike, të cilat duhet të kalohen para se këto probleme të mund të quhen të zgjidhura.
Megjithatë, nëse supozojmë se të gjitha këto probleme janë zgjidhur, ka një mundësi të lartë që asgjë të mos ndyshojë ndjeshëm nga pikëpamja e përdoruesit të fundit. Konsolidimi do të vazhdojë të mos sjellë përfitime praktike në skenaret më të zakonshëm të debugimit — edhe pas implementimit të tij.
Një konsolidim i tillë i ndryshëm
Konsolidimi i shpërndarë përfshin disa komponente të ndara:
- arsimi i aplikacioneve dhe middleware me mjete kontrolli;
- transmetimi i kontekstit të shpërndarë;
- mbledhja e konsolidimeve;
- ruajtja e konsolidimeve;
- nxjerrja dhe vizualizimi i tyre.
Shumë biseda për gjurmimin e shpërndarë e reduktojnë atë në një operacion unitar, me qëllimin e vetëm për të ndihmuar në diagnostikimin e plotë të sistemit. Kjo është në masë të madhe e lidhur me mënyrën se si historikisht janë formuar kuptimet për gjurmimin e shpërndarë. Në , i bërë kur u hapën kodet burimore të Zipkin, u përmend se ai [Zipkin] e bën Twitter-in më të shpejtë. Ofertat e para komerciale për gjurmimin gjithashtu u promovuan si .
Shën. përkth.: Për ta bërë tekstin e mëtejmë më të kuptueshëm, le të përcaktojmë dy terminologji themelore sipas :
- Span — elementi bazë i gjurmimit të shpërndarë. Përfaqëson përshkrimin e një procesi të caktuar (p.sh., një kërkesë në bazën e të dhënave) me emrin, kohën e fillimit dhe mbarimit, etiketat, log-et dhe kontekstin.
- Span-et zakonisht përmbajnë lidhje me span-e të tjera, duke lejuar që shumë span-e të bashkohen në Trace — vizualizimi i jetës së kërkesës gjatë kalimit të saj në sistemin e shpërndarë.
Trace-et përmbajnë të dhëna jashtëzakonisht të vlefshme që mund të ndihmojnë në detyra të tilla si: testimi në prodhim, kryerja e testeve të rikuperimit të fatkeqësive, testimi me injeksion të gabimeve etj. Në fakt, disa kompani tashmë po e përdorin gjurmimin për këto qëllime. Le të fillojmë me atë që ka dhe aplikime të tjera përveç thjesht transferimit të span-eve në sistemin e ruajtjes:
- Për shembull, Uber rezultatet e gjurmimit për të ndarë trafikun testues dhe trafikun e prodhimit.
- Facebook të dhënat e trace-ve për analizimin e rrugës kritike dhe për kalimin e trafikut gjatë testeve të rregullta të rikuperimit nga fatkeqësitë.
- Gjithashtu, rrjeti social ditarët Jupyter, që lejojnë zhvilluesit të kryejnë kërkesa arbitrare mbi rezultatet e gjurmimit.
- Përkrahësit (Injeksioni i Dështimit të Drejtuar nga Linja) gjurmimet e shpërndara për testimin me injeksion të gabimeve.
Asnjë nga opsionet e mësipërme nuk i përket plotësisht skenarit të debunktimit, në të cilin inxhinieri përpiqet të zgjidhë problemin, duke e shqyrtuar trace.
Kur bëhet me të vërtetë ka të bëjë me skenarin e debunktimit, ndërfaqja primare mbetet diagrami traceview (edhe pse disa e quajnë atë "diagrami Gantt" ose "diagrami kaskadë"). Nën traceview unë të gjitha span'ët dhe metadatat përkatëse, të cilat së bashku përbëjnë trace. Çdo sistem gjurmimi me kod të hapur, si dhe çdo zgjidhje komerciale për gjurmim ofron një bazë të traceview ndërfaqe përdoruesi për vizualizimin, detajimin dhe filtrimin e trace'ave.
Problemi me të gjitha sistemet e gjurmimit me të cilat kam pasur mundësinë të njihem deri tani është se vizualizimi (traceview) praktikisht reflektimin e veçorive të procesit të gjenerimit të trace'it. Edhe kur ofrohen vizualizime alternative: harta e intensitetit (heatmap), topologjitë e shërbimeve, histogramet e vonesave (latency), në fund ato gjithmonë përfundojnë duke u shndërruar në traceview.
Në të kaluarën unë kërcënimin se shumica e "inovacioneve" në fushën e gjurmimit në lidhje me UI/UX, duket se janë të kufizuara në e metadatat e shtuara në trace, duke e ngarkuar ato me informacione me kardinalitet të lartë (high-cardinality) ose ofrimin e mundësisë për të detajuar span'të specifike ose për të bërë kërkesa midis dhe brenda trace. Ndërkohë, traceview mbetet mjeti kryesor i vizualizimit. Derisa kjo gjendje të ruhet, gjurmimi i shpërndarë do të zërë (në rastin më të mirë) vendin e katërt si një mjet debugimi, pas metrikeve, shënimeve dhe stack trace'ave, dhe në rastin më të keq, do të rezultojë një humbje e kotë parash dhe kohe.
Problemi me traceview
Qëllimi traceview është të ofrojë një pamje të plotë të lëvizjes së një kërkese të veçantë përmes të gjitha komponentëve të sistemit të shpërndarë me të cilët ka lidhje. Disa sisteme më të avancuara të gjurmimit lejojnë detajimin e span'ave të veçanta dhe shikimin e ndarjeve sipas kohës brenda një procesi (kur span'ët kanë kufij funksionalë).
Një parakusht themelor i arkitekturës së mikroshërbimeve është ideja se struktura organizative rritet së bashku me nevojat e kompanisë. Pronarët e mikroshërbimeve pohojnë se shpërndarja e detyrave të ndryshme të biznesit në shërbime të ndara lejon që grupe të vogla, autonome të zhvilluesve të kontrollojnë të gjithë ciklin e jetës së këtyre shërbimeve, duke u dhënë atyre mundësinë për të krijuar, testuar dhe implementuar këto shërbime në mënyrë të pavarur. Megjithatë, një disavantazh i tillë është humbja e informacionit mbi mënyrën se si çdo shërbim ndërvepron me të tjerët. Në këto kushte, gjurmimi i shpërndarë pretendon të luajë rolin e një instrumenti të pazëvendësueshëm për të debunktimit ndërveprimet komplekse midis shërbimeve.
Nëse keni me të vërtetë , atëherë asnjë njeri nuk është në gjëndje ta mbajë mend pamjen e tij të plotë. Në të vërtetë, zhvillimi i një instrumenti me supozimin se kjo është e mundur, është diçka si një antipattern (një qasje e paefektshme dhe e paproduktive). Idealisht, për debugin do të kërkonte një instrument që ndihmon të ngushtohet zona e kërkimit, në mënyrë që inxhinierët të mund të përqendrohen në një nënset të matjeve (shërbimeve/përdoruesve/hosteve etj.) që kanë të bëjnë me skenarin e shqetësimit të studiuar. Kur zbulojnë shkakun e dështimit, inxhinierët nuk duhet të shqyrtojnë se çfarë ka ndodhur në të gjithë shërbimet njëherësh, pasi një kërkesë e tillë do të ishte në kontradiktë me vetë idenë e arkitekturës së mikroshërbimeve.
Megjithatë, traceview përfaqëson pikërisht këtë. Po, disa sisteme gjurmimi ofrojnë traceview të kompresuar, kur numri i span’ave në gjurmë është aq i madh sa që nuk mund të shfaqet brenda një vizualizimi. Megjithatë, për shkak të volumit të madh të informacionit, edhe në një vizualizim të tillë të reduktuar, inxhinierët megjithatë duhen të "filtron" atë, duke ngushtuar manualisht mostrat në një grup shërbimesh që janë burim i problemeve. Me të vërtetë, në këtë fushë makinat janë shumë më të shpejta se njeriu, më pak të prirura ndaj gabimeve dhe rezultatet e tyre janë më të përsëritshme.
Një arsye tjetër pse unë e mendoj metodën traceview si të gabuar është se ajo nuk është e përshtatshme për debugin e bazuar në hipoteza. Në thelbin e saj, debugu është iterativ procesi që fillon me një hipotezë, pasuar nga verifikimi i vëzhgimeve dhe fakteve të ndryshme të marra nga sistemi për kanale të ndryshme, përfundimet/përmbledhjet dhe vlerësimi më tej i vërtetësisë së hipotezës.
Mundësia shpejt dhe gjatë testimi i hipotezave dhe përmirësimi përkatës i modelit mendor është thelbësor për debugimin. Çdo mjet debugimi duhet të jetë interaktiv dhe të ngushtojë hapësirën e kërkimit ose, në rast të një gjurme të rremë, të lejojë përdoruesin të kthehet prapa dhe të fokusohet në një zonë tjetër të sistemit. Mjeti ideal do ta bëj këtë në mënyrë proaktive, duke tërhequr menjëherë vëmendjen e përdoruesit në zona potencialisht problematike.
Për fat të keq, traceview nuk mund të quhet një mjet me një ndërfaqe interaktive. E mira që mund të shpresosh nga përdorimi i tij është të zbulojë një burim të vonesave të rritura dhe të shqyrtojë të gjitha etiketat dhe log-et që lidhen me të. Kjo nuk ndihmon inxhinierin të zbulojë modellet në trafik, siç janë specifikat e shpërndarjes së vonesave, ose të zbulojë korelacionet midis matjeve të ndryshme. mund të ndihmojë në kalimin e disa nga këto probleme. Në të vërtetë, analizash të suksesshme duke përdorur mësimin e makinave për të zbuluar anomali të span’ave dhe identifikimin e nëndegëve të etiketave që mund të jenë të lidhura me sjelljen anomale. Megjithatë, deri tani, nuk kam hasur në vizualizime bindëse të gjetjeve të bëra me ndihmën e mësimit të makinave ose analizës së të dhënave të aplikuara në span’ave që do të ishin ndjeshëm më të ndryshme nga traceview ose DAG (grafi i orientuar aciklik).
Span’ave janë shumë të nivelit të ulët
Problemi themelor me traceview është se span’ave janë shumë të nivelit të ulët për analizën e vonesave (latency) dhe për analizën e shkakut të origjinës. Është si të analizosh komandat e veçanta të procesorëve në përpjekjen për të eliminuar një përjashtim, duke e ditur se ekzistojnë mjete shumë më të nivelit më të lartë si backtrace, me të cilat është shumë më e lehtë të punosh.
Më tej, do të marrë guximin të deklaroj këtë: në mënyrë ideale, nuk na nevojitet aspak pamja e plotë ngjarja e ndodhur gjatë ciklit të jetës së kërkesës, e cila paraqitet nga mjetet moderne për gjurmimin. Në vend të kësaj, kërkohet një formë abstrakcioni më të lartë, e cila përmban informacion mbi atë që ka shkuar keq ((përshtatur nga backtrace), së bashku me disa kontekst. Në vend që të shoh gjithë trace-n, preferoj ta shoh atë pjesën, ku ndodh diçka interesante ose të pazakontë. Në këtë moment, kërkimi bëhet manualisht: inxhinieri merr trace-n dhe analizon span-ët për të gjetur diçka interesante. Prirja, kur njerëzit shikojnë span-ët në trace të veçanta me shpresën se do të zbulojnë aktivitete të dyshimta, nuk është aspak e shkallëzueshme (sidomos kur ata duhet të kuptojnë të gjitha metadatën e koduar në span të ndryshëm, siç janë ID span, emri i metodës RPC, kohëzgjatja e span-it, log-et, etiketat etj.).
Alternativat e traceview
Rezultatet e gjurmimit janë më të dobishme kur mund të vizualizohen në një mënyrë që ofron një përfaqësim jo trivial të asaj që po ndodh në pjesët e ndërlidhura të sistemit. Derisa kjo të mos ndodhë, procesi i debugimit mbetet në masë të madhe inert dhe varet nga aftësia e përdoruesit për të vërejtur korrelacionet e sakta, për të verifikuar pjesët e duhura të sistemit ose për të mbledhur copëza të mozaikut së bashku - ndryshe nga instrumenti, i cili ndihmon përdoruesin të formulojë këto hipoteza.
Nuk jam dizajner visual dhe as specialist në UX, por në seksionin e ardhshëm dua të ndaj disa ide për atë si mund të duken këto vizualizime.
Fokusi në shërbime të caktuara
Në kushte kur industria konsolidohet rreth ideve , duket e arsyeshme që ekipet e veçanta duhet në radhë të parë të monitorojnë përputhshmërinë e shërbimeve të tyre me këto objektiva. Prej këndej, vizualizimi i orientuar drejt shërbimit është më i përshtatshëm për këto ekipe.
Trace-t, sidomos pa zgjedhje, janë një burim i çmueshëm informacioni mbi çdo komponent të një sistemi të shpërndarë. Ky informacion mund të ushqehet në një përpunues të zgjuar, i cili do t'u ofrojë përdoruesve gjetje të orientuara drejt shërbimit. Ato mund të identifikohen paraprakisht - para se përdoruesi të shikojë trace-t:
- Diagramet e shpërndarjes së vonesave janë vetëm për kërkesat që dallohet shumë (kërkesat e jashtme);
- Diagramet e shpërndarjes së vonesave për rastet kur qëllimet SLO të shërbimit nuk arrihen;
- Etiketat më "të zakonshme", "më interesante" dhe "më të çuditshme" në kërkesa që shfaqen më shpesh po përsëriten;
- Shkëputja e vonesave për rastet kur varësitë e shërbimit nuk arrijnë qëllimet e caktuara të SLO;
- Shkëputja e vonesave sipas shërbimeve të ndryshme poshtë (downstream).
Disa nga këto pyetje nuk mund të përgjigjen nga metrikat e ndërtuara, duke detyruar përdoruesit të shqyrtojnë me kujdes span’ët. Kështu, rezulton një mekanizëm jashtëzakonisht armiqësor ndaj përdoruesit.
Në këtë kontekst lind pyetja: si është për ndërveprimet komplekse midis shërbimeve të ndryshme, të kontrolluara nga ekipe të ndryshme? A nuk traceview është mjeti më i përshtatshëm për të ndriçuar një situatë të tillë?
Zhvilluesit mobilë, pronarët e shërbimeve stateless, pronarët e shërbimeve stateful të menaxhuara (siç janë bazat e të dhënave) dhe pronarët e platformave mund të jenë të interesuar për një paraqitje tjetër të sistemit të shpërndarë; — është një zgjidhje shumë universale për këto nevoja esencialisht të ndryshme. Edhe në një arkitekturë shumë të komplexe mikro-shërbimesh, pronarët e shërbimeve nuk kanë nevojë për njohuri të thella mbi më shumë se dy-tre shërbime upstream dhe downstream. Në thelb, në shumicën e skenarëve, përdoruesit duhet të përgjigjen vetëm pyetjeve që lidhen me traceview një grup të kufizuar shërbimesh Ky proces është si të shikosh një nënçensemble të vogël shërbimesh përmes një lupë për studim të detajuar. Kjo do t'i mundësojë përdoruesit të bëjë pyetje më presuese mbi ndërveprimet komplekse midis këtyre shërbimeve dhe varësive të tyre të menjëhershme. Kjo është e ngjashme me backtrace në botën e shërbimeve, ku inxhinieri di.
çfarë nuk shkon, dhe gjithashtu ka një ide për atë që ndodh në shërbimet përreth, për të kuptuar, Jo kështu, dhe gjithashtu ka njëfarë ideje për atë që po ndodh në shërbimet përreth, për të kuptuar, pse.
Qasja që unë promovoj është krejtësisht e kundërt me qasjen "nga lart poshtë", e bazuar në traceview, kur analiza fillon me të gjithë trace-in dhe pastaj gradualisht zbret deri te span-t e veçantë. Nga ana tjetër, qasja "nga poshtë lart" fillon me analizimin e një pjese të vogël, e cila është afër shkakut të mundshëm të incidentit, dhe pastaj zgjeron hapësirën e kërkimit sipas nevojës (me mundësinë e angazhimit të ekipeve të tjera për të analizuar një gamë më të gjerë shërbimesh). Qasja e dytë është më e përshtatshme për kontrollin e shpejtë të hipotezave fillestare. Pas marrjes së rezultateve konkrete, mund të kalojmë në një analizë më të fokusuar dhe të detajuar.
Ndërtimi i topologjisë
Pamjet e lidhura me një shërbim të caktuar mund të jenë jashtëzakonisht të dobishme, nëse përdoruesi e di se cili shërbim ose grup shërbimesh mund të jetë fajtori në rritjen e vonesave ose është burimi i gabimeve. Megjithatë, në një sistem kompleks, përcaktimi i shërbimit të problemit mund të jetë një detyrë e ndërlikuar gjatë ndërprerjes, veçanërisht nëse mesazhet e gabimeve nga shërbimet nuk janë marrë.
Ndërtimi i topologjisë së shërbimeve mund të ndihmojë shumë në përllogaritjen e cilit shërbim po tregon një rritje të frekuencës së gabimeve ose një rritje të vonesës, duke rezultuar në një përkeqësim të dukshëm të performancës së shërbimit. Kur flas për ndërtimin e topologjisë, nuk kam parasysh hartën e shërbimeve, e cila tregon çdo shërbim të pranishëm në sistem dhe është e njohur për . Një paraqitje e tillë nuk është më mirë se traceview në bazë të një grafi aciklike të orientuar. Në vend të kësaj, do doja të shihja topologjinë e shërbimeve që gjenerohet dinamikisht, e cila bazohet në atribute të caktuara, të tilla si frekuenca e gabimeve, koha e përgjigjes ose ndonjë parametër të dhënë nga përdoruesi që ndihmon në sqarimin e situatës me shërbime pikale.
Le të marrim një shembull. Imagjinoni një sit hipotetik lajmesh. Shërbimi i faqes kryesore (front page) ndërron të dhëna me Redis, shërbimin e rekomandimeve, shërbimin reklamues dhe shërbimin e videove. Shërbimi i videove merr videoklipet nga S3, ndërsa metadatat nga DynamoDB. Shërbimi i rekomandimeve merr metadatat nga DynamoDB, ngarkon të dhëna nga Redis dhe MySQL, dhe shkruan mesazhe në Kafka. Shërbimi reklamues merr të dhëna nga MySQL dhe shkruan mesazhe në Kafka.
Në vazhdim është një imazh skematik i kësaj topologjie (topologji që shumë programe tregtare e krijojnë për gjurmim). Ajo mund të jetë e dobishme nëse keni nevojë të kuptoni varësitë e shërbimeve. Megjithatë, gjatë të debunktimit, kur një shërbim (le të themi, shërbimi i videove) tregon një kohë të zgjatjes së përgjigjes, një topologji e tillë nuk është shumë e dobishme.
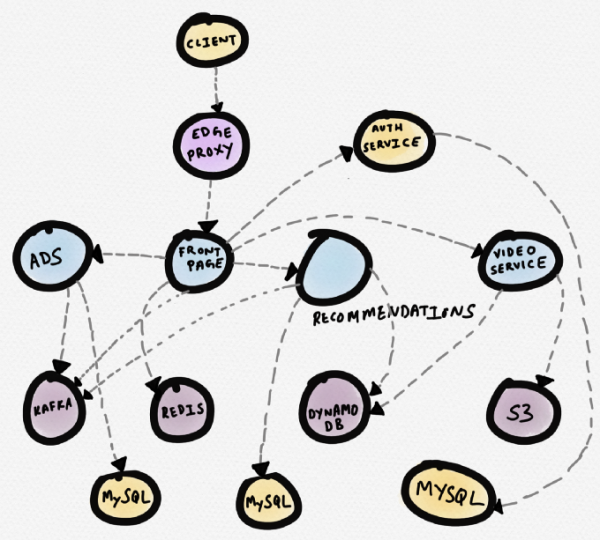
Skema e shërbimeve të një siti hipotetik lajmesh
Një diagram që ilustron më mirë do të ishte ai në vazhdim. Në të, shërbimi problematik (video) shfaqet drejtpërdrejt në qendër. Përdoruesi e vë re menjëherë atë. Nga kjo vizualizim kuptohet se shërbimi i videos funksionon anomalisht për shkak të rritjes së Kohëve të përgjigjes nga S3, e cila ndikon në shpejtësinë e ngarkesës së një pjese të faqes kryesore.
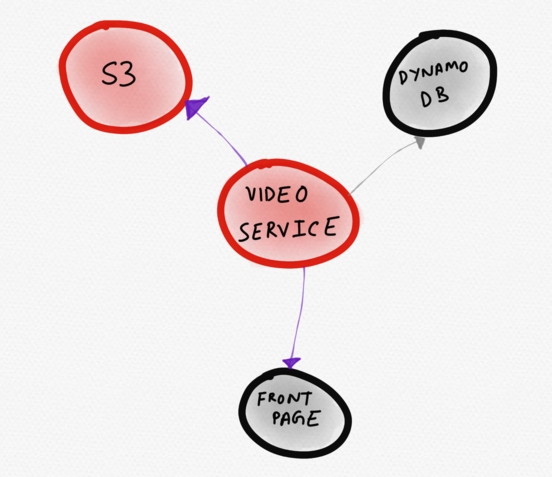
Topologjia dinamike, që tregon vetëm shërbimet "e rëndësishme"
Skemat topologjike që gjenerohen dinamikisht mund të jenë më efikase se hartat statike të shërbimeve, veçanërisht në infrastrukturat elastike dhe që auto-skalohen. Mundësia për të krahasuar dhe përputhur topologjitë e shërbimeve i lejon përdoruesit të bëjë pyetje më të aktualizuara. Pyetje më të sakta rreth sistemit kanë më shumë gjasa të çojnë në një kuptim më të mirë të mënyrës se si funksionon sistemi.
Paraqitja krahasuese
Një vizualizim tjetër i dobishëm do të ishte paraqitja krahasuese. Aktualisht, trace-t nuk janë shumë të përshtatshme për krahasim për krahasim, prandaj zakonisht krahasohen span’ave. Ideja kryesore e këtij artikulli është se span-t janë shumë të nivelit të ulët për të ekstraktuar informacionin më të çmuar nga rezultatet e gjurmimeve.
Krahasimi i dy trace-ve nuk kërkon vizualizime krejt të reja. Në të vërtetë, mjafton diçka si një histogram, që përfaqëson të njëjtat të dhëna si traceview. Është befasuese, por madje ky metodë e thjeshtë mund të sjellë shumë më tepër përfitime se sa thjesht studimi i dy trace-ve për veçmas. Një mundësi akoma më e fuqishme do të ishte vizualizoni krahasimi i trace’ave në përmbledhje. Do të ishte jashtëzakonisht e dobishme të shihnim se si ndarja e re e konfiguracionit të bazës së të dhënave me aktivizimin e GC (grumbullimin e mbetjeve) ndikon në kohën e përgjigjes të shërbimit downstream për një periudhë disa orëshe. Nëse ajo që po përshkruaj këtu duket si një analizë A/B e ndikimit të ndryshimeve në infrastrukturë në shumë shërbime me rezultatet e gjurmimit, atëherë nuk jeni shumë larg së vërtetës.
Përfundim
Nuk e vë në dyshim përdorimin e vetë gjurmimit. I besoj sinqerisht se nuk ka metodë tjetër për të mbledhur të dhëna po aq të pasura, kalimtare dhe kontekstuale si ato që përmbahen në një trace. Megjithatë, besoj gjithashtu se të gjitha zgjidhjet e gjurmimit e përdorin këtë të dhënë jashtëzakonisht paefektivisht. Derisa mjetet e gjurmimit të përqendrohen në paraqitjen e traceview, ato do të jenë të kufizuara në aftësinë për të shfrytëzuar maksimalisht informacionin e çmuar që mund të nxirret nga të dhënat që përmbahen në gjurmë. Për më tepër, ekziston rreziku i zhvillimit të një ndërfaqe vizuale krejtësisht jo miqësore dhe jo intuitiv, e cila do të kufizojë ashpër aftësinë e përdoruesit për të zgjidhur gabimet në aplikacion.
Debugimi i sistemeve komplekse, madje edhe me përdorimin e mjeteve më të fundit, është jashtëzakonisht i vështirë. Mjetet duhet të ndihmojnë zhvilluesin të formulonte dhe testonte një hipotezë, duke ofruar aktivisht informacione relevante, duke identifikuar përjashtimet dhe duke vërejtur karakteristikat në shpërndarjen e vonesave. Në mënyrë që gjurmimi të bëhet mjeti i preferuar i zhvilluesve për të zgjidhur defektet në prodhim ose për të adresuar probleme që përfshijnë shërbime të ndryshme, nevojiten ndërfaqe dhe vizualizime origjinale që i përgjigjen më shumë modelit mendor të zhvilluesve që krijojnë dhe operojnë këto shërbime.
Do të nevojiten përpjekje të mëdha mendore për të projektuar një sistem që do të paraqesë sinjale të ndryshme të disponueshme në rezultatet e gjurmimit në një mënyrë të optimizuar për të lehtësuar analizimin dhe arsyetimin. Duhet menduar se si të abstrahohet topologjia e sistemit gjatë debugimit për të ndihmuar përdoruesin të kapërcejë zonat e verbra, pa shkuar në trace’ave ose span’ave të veçanta.
Na nevojiten një qasje e fortë për abstragimin dhe ndarjen në nivele (veçanërisht në UI). E tillë që përshtatet mirë në procesin e debugut të bazuar në hipoteza, ku mund të parashtroni pyetje dhe të testoni hipotezat iterativisht. Ato nuk do ta zgjidhin automatikisht të gjitha problemet me vëzhgueshmërinë, por do t'u ndihmojnë përdoruesve të rafinojnë intuitën dhe të formulojnë pyetje më të menduara. Ftoj një qasje më të reflektuar dhe inovative në fushën e vizualizimit. Këtu ka një perspektivë të vërtetë për të zgjeruar horizontet.
P.S. nga përkthyesi
Lexoni gjithashtu në blogun tonë:
- «»;
- «»;
- «».
Burimi: habr.com
