

Teorema CAP është një themel i sistemit të teorisë distribuuese. Sigurisht, debati mbi të nuk ka pushuar: as definicionet nuk janë kanonike, as ndonjë provë strikte e saj nuk ekziston… Megjithatë, duke qëndruar fort në pozitat e gjykimit të zakonshëm™, ne e kuptojmë intuitivisht se teorema është e vërtetë.
E vetmja gjë që nuk është e qartë është kuptimi i shkronjës «P». Kur klasteri ndahet, ai vendos – të mos përgjigjet derisa të arrihet një kuorum, ose të japë të dhënat që ka. Në varësi të rezultateve të kësaj zgjedhjeje, sistemi klasifikohet ose si CP ose si AP. Cassandra, për shembull, mund të sillet ose kështu ose ashtu, në varësi, madje, jo vetëm të cilësimeve të klasterit, por edhe të parametrave të çdo kërkese specifike. Por nëse sistemi nuk është «P», dhe ai është ndarë, atëherë – çfarë?
Përgjigjja në këtë pyetje është disi befasuese: Klasteri CA nuk mund të ndahet.
Çfarë është ky klaster që nuk mund të ndahet?
Një atribut i domosdoshëm i një klasteri të tillë është një sistem i përbashkët ruajtjeje të dhënash. Në shumicën dërrmuese të rasteve, kjo do të thotë lidhje përmes SAN, gjë që e kufizon përdorimin e zgjidhjeve CA nga bizneset e mëdha që janë në gjendje të mbajnë infrastrukturën SAN. Për të patur disa serverësh që të punojnë me të dhëna të njëjta, kërkohet një sistem skedarësh klasteri. Këto sisteme skedarësh janë në portofolët e HPE (CFS), Veritas (VxCFS) dhe IBM (GPFS).
Oracle RAC
Opsioni Real Application Cluster u shfaq për herë të parë në vitin 2001 në lëshimin Oracle 9i. Në një klaster të tillë, disa instance serverë punojnë me të njëjtën bazë të dhënash.
Oracle mund të punojë si me një sistem skedarësh klasteri, ashtu edhe me zgjidhjen e saj – ASM, Automatic Storage Management.
Çdo instance mbajnë gazetën e saj. Transaksioni ekzekutohet dhe regjistrohet nga një instance. Në rast dështimi të një instance, një nga node-t e mbetura të klasterit (instanceve) lexon gazetën e saj dhe rikuperon të dhënat e humbura – për këtë arsye sigurohet disponueshmëria.
Të gjitha instancat mbështesin cache-n e tyre, dhe të njëjtat faqe (bllokime) mund të jenë njëkohësisht në cache-n e disa instancave. Më tepër, nëse ndonjë faqe nevojitet nga një instancë, dhe ajo është në cache-n e një instance tjetër, mund ta marrë atë nga «fqinji» me anë të mekanizmit cache fusion në vend që të lexojë nga disku.
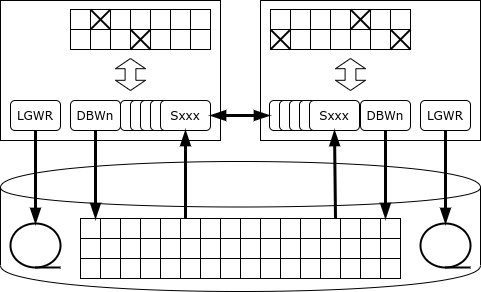
Por e gjithë se çfarë do të ndodhte nëse një nga ekzemplarët do të kërkonte të ndryshonte të dhënat?
Karakteristika e Oracle është se nuk ka një shërbim të dedikuar për bllokimin: nëse serveri dëshiron të bllokojë një rresht, atëherë informata për bllokimin vendoset drejtpërdrejt në atë faqe të memories, ku ndodhet rreshti i bllokuar. Falë këtij qasje, Oracle është kampion në performancë mes bazave të dhënash monolitike: shërbimi i bllokimeve kurrë nuk bëhet një ngushticë. Por në konfigurimin klaster, një arkitekturë e tillë mund të çojë në shkëmbim intensiv rrjeti dhe bllokime reciproke.
Sa herë që një shënim bllokohet, ekzemplari i njofton të gjithë ekzemplarët e tjerë se faqja, në të cilën ruhet ky shënim, është kapur në një mënyrë monopole. Nëse një ekzemplar tjetër ka nevojë të ndryshojë shënimin në të njëjtën faqe, ai duhet të presë derisa ndryshimet në faqe të konfirmohen, dmth. informata për ndryshimin të regjistrohet në ditarin në disk (ndërkohë transaksioni mund të vazhdojë). Mund të ndodhë gjithashtu që faqa të ndryshohet në mënyrë të njëpasnjëshme nga disa ekzemplarë, dhe atëherë, kur të shkruhet faqja në disk, do të duhet të sqarohet se kush ka versionin aktual të kësaj faqe.
Një përditësim i rastësishëm i faqeve të njëjta përmes nyjave të ndryshme RAC çon në një rënie të ndjeshme të performancës së bazës së të dhënave – deri në atë pikë sa performanca e klasterit mund të jetë më e ulët se performanca e një ekzemplari të vetëm.
Përdorimi i duhur i Oracle RAC – ndarja fizike e të dhënave (për shembull, përmes mekanizmit të tabelave të ndara) dhe qasja në çdo grup seksionesh përmes një nyje të dedikuar. Qëllimi kryesor i RAC-it nuk është shkallëzimi horizontal, por sigurimi i qëndrueshmërisë.
Nëse një nyje pushon së përgjiguri në heartbeat, atëherë nyja që e zbulon këtë së pari, nis procedurën e votimit në disk. Nëse dhe këtu nyja e humbur nuk shënohet, atëherë një nga nyjat merr përsipër detyrat për rikuperimin e të dhënave:
- «E ngrin» të gjitha faqet që ishin në cache të nyjës së humbur;
- Lexon ditarët (redo) e nyjës së humbur dhe përsëri aplikon ndryshimet e regjistruara në këto ditarë, duke kontrolluar gjithashtu nëse ndonjë nyje tjetër ka versione më të reja të faqeve që po ndryshohen;
- rishkah transaksionet e papërfunduara.
Për të thjeshtuar kalimin mes nyjeve, në Oracle ekziston koncepti i shërbimit – një shembull virtual. Një shembull mund të shërbejë disa shërbime, dhe një shërbim mund të kalojë mes nyjeve. Një shembull aplikacioni, që shërben një pjesë të caktuar të bazës (për shembull, një grup klientësh) punon me një shërbim, ndërsa shërbimi që përgjigjet për këtë pjesë të bazës, kur një nyje dështon, kalon në një nyje tjetër.
IBM Pure Data Systems for Transactions
Zgjidhja kluster për DBMS erdhi në portofolin e Gigantit Blu në vitin 2009. Ideologjikisht, ajo është pasardhëse e klusterit Parallel Sysplex, e ndërtuar mbi pajisje "të zakonshme". Në vitin 2009 doli produkti DB2 pureScale, që përbën një paketë softuerike, dhe në vitin 2012 IBM ofron një paketë softuerike dhe harduerike (appliance) nën emrin Pure Data Systems for Transactions. Nuk duhet ngatërruar me Pure Data Systems for Analytics, e cila nuk është gjë tjetër veçse një riemërim i Netezza.
Arkitektura pureScale në pamje të parë duket si Oracle RAC: po ashtu, disa nyje janë të lidhura me një sistem të përbashkët ruajtjeje të dhënash, dhe në secilën nyje punon një shembull i vetë DBMS me zonat e tij të memories dhe journaleve të transaksioneve. Por, ndryshe nga Oracle, në DB2 ekziston një shërbim i dedikuar për bllokimin, i përfaqësuar nga një grup procesesh db2LLM*. Në konfigurimin klaster, ky shërbim vendoset në një nyje të veçantë, e cila në Parallel Sysplex quhet facilitet lidhës (CF), dhe në Pure Data – PowerHA.
PowerHA ofron shërbimet e mëposhtme:
- menaxher bllokimesh;
- kesh global buffer;
- zona e komunikimeve ndërproçesore.
Për transferimin e të dhënave nga PowerHA në nyjet e DB dhe anasjelltas, përdoret qasja e largët në memorie, prandaj interkonekti klaster duhet të mbështesë protokollin RDMA. PureScale mund të përdorë si Infiniband ashtu edhe RDMA mbi Ethernet.
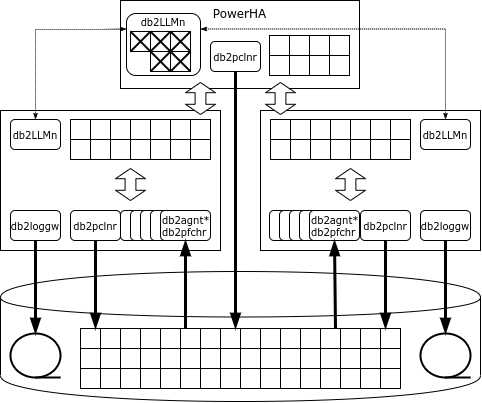
Nëse një nyje ka nevojë për një faqe, dhe kjo faqe nuk është në kesh, atëherë nyja kërkon faqen në keshin global dhe vetëm në rast se ashtu nuk është atje, e lexon nga disku. Ndryshe nga Oracle, kërkesa shkon vetëm në PowerHA, dhe jo në nyjet fqinj.
Kurse instanca është duke u përgatitur të ndryshojë rresht, ajo bllokon atë në modin ekskluziv dhe faqen ku ndodhet rreshti – në modin e ndarë. Të gjitha bllokimet regjistrohen në menaxherin global të bllokimeve. Kur transaksioni përfundon, nyja dërgon një mesazh menaxherit të bllokimeve, i cili kopjon faqen e ndryshuar në cache-in global, heq bllokimet dhe invalidon faqen e ndryshuar në caches e nyjeve të tjera.
Nëse faqja, ku ndodhet rreshti i ndryshueshëm, është tashmë e bllokuar, menaxheri i bllokimeve do të lexojë faqen e ndryshuar nga memorizimi i nyjës që bëri ndryshimet, do të heqë bllokimin, invalidon faqen e ndryshuar në caches e nyjeve të tjera dhe do ta japë bllokimin e faqes nyjës që e kërkoi atë.
Faqet "e ndyrë", që do të thotë të ndryshuara, mund të shkruhen në disk nga një nyje e zakonshme, si dhe nga PowerHA (castout).
Në rast të një defekti të njërit nga nyjat pureScale, rikthimi është i kufizuar vetëm në transaksionet që në momentin e dështimit ende nuk ishin përfunduar: faqet e ndryshuara nga kjo nyje në transaksionet e përfunduara gjenden në cache-in global në PowerHA. Nyja riçellet në një konfigurim të reduktuar në një nga serverët e klasterit, rikthen transaksionet e papërfunduara dhe çliron bllokimet.
PowerHA funksionon në dy serverë dhe nyja kryesore replicon në mënyrë sinkrone gjendjen e saj. Në rastin e defektit të nyjës kryesore, klasteri PowerHA vazhdon të punojë me nyjën rezervë.
Sigurisht, nëse i qasemi grupeve të dhënash përmes një nyje, performanca e përgjithshme e klasterit do të jetë më e lartë. PureScale madje mund ta vëren se disa zona të dhënash po përpunohen nga një nyje dhe atëherë të gjitha bllokimet që i përkasin kësaj zone do të përpunohen nga nyja në nivel lokal pa komunikime me PowerHA. Por sa herë që aplikacioni përpiqet të aksesojë këto të dhëna përmes një nyje tjetër, përpunimi i centralizuar i bllokimeve do të rinisë.
Testet e brendshme IBM mbi një ngarkesë që përbëhet nga 90% lexime dhe 10% shkruaj, që është shumë e ngjashme me një ngarkesë industrale reale, tregojnë një gjerësi pothuajse lineare deri në 128 nyje. Kushtet e testimit, fatkeqësisht, nuk zbulohet.
HPE NonStop SQL
Platforma e saj me disponueshmëri të lartë është gjithashtu në portofolin e Hewlett-Packard Enterprise. Kjo është platforma NonStop, që u lançua në treg në vitin 1976 nga Tandem Computers. Në vitin 1997, kompania u ble nga Compaq, e cila, nga ana e saj, u bashkua me Hewlett-Packard në vitin 2002.
NonStop përdoret për ndërtimin e aplikacioneve kritike – për shembull, HLR ose procesimin e kartave bankare. Platforma ofrohet si një kompleks softuerik-harduerik (appliance), që përfshin njësitë kompjuterike, sistemin e ruajtjes së të dhënave dhe pajisjet e komunikimit. Rrjeti ServerNet (në sistemet moderne – Infiniband) shërben si për shkëmbimin mes njësive, ashtu edhe për aksesin në sistemin e ruajtjes së të dhënave.
Në versionet e hershme të sistemit u përdorën procesorë pronësorë, të cilët ishin të sinkronizuar me njëri-tjetrin: të gjitha operacionet ekzekutoheshin sinkronisht nga disa procesorë, dhe sa herë që një nga procesorët gabonte, ai ndalonte punën, ndërsa ai tjetër vazhdonte.
- mesazhet: çdo proces sistemik ka një dyplikat-'hije', të cilit procesi aktiv i dërgon periodikisht mesazhe për gjendjen e tij; në rast të një gabimi të procesit kryesor, procesi hije fillon punën nga momenti që është përcaktuar nga mesazhi i fundit;
- votimi: sistemi i ruajtjes së të dhënave ka një komponent të veçantë harduerik, i cili pranon disa kërkesa të njëjta dhe i ekzekuton ato vetëm në rast se kërkesat përputhen; përveç sinkronizimit fizik, procesorët punojnë asinkronisht, dhe rezultatet e punës së tyre krahasohen vetëm në momentet e input/output.
Që nga viti 1987, në platformën NonStop funksionon një DBMS relacionale – së pari SQL/MP, dhe më pas – SQL/MX.
Baza e të dhënave ndahet në pjesë, dhe çdo pjesë ka menaxherin e vet të qasjes në të dhëna (DAM). Ai siguron regjistrimin e të dhënave, ndihmën dhe mekanizmin e bllokimeve. Trajtimin e të dhënave e kryejnë proceset e ekzekutuesit (Executor Server Process), të cilat punojnë në të njëjtët nyje si menaxherët përkatës të të dhënave. Planifikuesi SQL/MX ndan detyrat midis ekzekutuesve dhe bashkon rezultatet. Kur është e nevojshme të bëhen ndryshime të rregullta, përdoret protokolli i bllokimit me dy faza, i siguruar nga biblioteka TMF (Facilitimi i Menaxhimit të Transaksioneve).
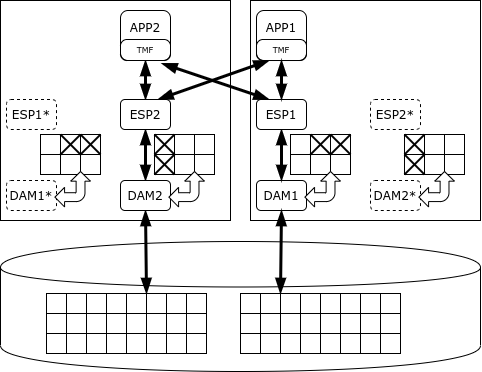
NonStop SQL mund të prioritizojë proceset në mënyrë që kërkesat analitike të gjata të mos pengojnë ekzekutimin e transaksioneve. Megjithatë, qëllimi i saj është pikërisht përpunimi i transaksioneve të shkurtra, jo analytics. Zhvilluesi garanton disponueshmërinë e klasterit NonStop në nivelin pesë 'nëntë', që do të thotë se koha e papunësisë është vetëm 5 minuta në vit.
SAP HANA
Mbështetje e parë stabile e DBMS HANA (1.0) u lançua në nëntor 2010, dhe paketa SAP ERP kaloi në HANA që nga maji 2013. Platforma bazohet në teknologjitë e blera: Motori i Kërkimit TREX (për kërkimin në magazinën kolonore), DBMS P*TIME dhe MAX DB.
Vetë fjala 'HANA' është një akronim, High performance ANalytical Appliance. Ky DBMS ofrohet në formën e kodit që mund të punojë në serverë të çdo lloji x86, megjithatë instalimet industriale lejohen vetëm në pajisje që kanë kaluar certifikimin. Janë të disponueshme zgjidhje nga HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Disa konfiguracione të Lenovo lejojnë madje funksionimin pa SAN - roli i sistemit të përbashkët të ruajtjes luhet nga klasteri GPFS në disqe lokale.
Ndryshe nga platformat e lartpërmendura, HANA është një DBMS në memorie, që do të thotë se pamja e parë e të dhënave ruhet në memorien operative, ndërsa në disk regjistrohen vetëm ditarët dhe skenarët periodikë - për t'u rikuperuar në rast të dështimit.
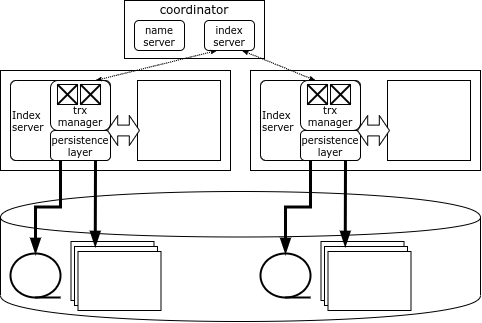
Çdo nyje e klasterit HANA përgjigjet për pjesën e saj të të dhënave, dhe harta e të dhënave ruhet në një komponent të veçantë - Serverin e Emrave, i vendosur në nyjen koordinuese. Të dhënat midis nyjeve nuk përsëriten. Informacioni mbi bllokimet gjithashtu ruhet në çdo nyje, por në sistem ka një detektor global të bllokimeve të ndërsjella.
Klienti HANA, kur lidhet me klasterin, ngarkon topologjinë e tij dhe mund të hyjë drejtpërdrejt në çdo nyje në varësi të të dhënave që i nevojiten. Nëse transaksioni prek të dhëna të një nyjeje të vetme, ato mund të ekzekutohen lokal nga kjo nyje, por nëse ndodhin ndryshime në të dhëna të disa nyjeve, nyja nisëse kontakton nyjën koordinatore, e cila hap dhe koordinon transaksionin e shpërndarë, duke e regjistruar atë përmes një protokolli të optimizuar të dy fazave.
Nyja koordinatore është e dyfishuar, kështu që në rast se koordinatorja dështon, menjëherë fillon puna e nyjës rezervë. Nëse dështon një nyje me të dhëna, mënyra e vetme për të aksesuar të dhënat e saj është të ripërsërisni nyjën. Në përgjithësi, në klasterët HANA mbahet një server rezervë (spare) për të rinisur sa më shpejt nyjën e humbur.
Burimi: habr.com
