

Përshëndetje, përdoruesit e Habra. Siç e kemi thënë, këtë muaj OTUS po lançon dy kurse për mësimin e makinerive, pra dhe . Në lidhje me këtë vazhdojmë të ndajmë materiale të dobishme.
Qëllimi i këtij artikulli është të flasë për përvojën tonë të parë me .
. Ne do të fillojmë me serverin e tij të ndjekjes dhe do të logojmë të gjitha iteracionet e hulumtimit. Më pas do të ndajmë përvojën e lidhjes së Spark me MLflow përmes UDF. Alpha Health
Konteksti
Ne në Qëllimi kryesor i MLflow është të sigurojë një shtresë të shtuar mbi mësimin e makinerive, e cila do të lejonte profesionistët e shkencës së të dhënave të punojnë praktikisht me çdo bibliotekë mësimi të makinerive (
MLflow
h2o, , , , dhe MLflow ofron tre komponentë:
Ndjekja
- – regjistrimi dhe pyetjet për eksperimentet: kodi, të dhënat, konfigurimi dhe rezultatet. Të ndjekësh procesin e krijimit të modelit është shumë e rëndësishme. – Formati i paketimit për ekzekutim në çdo platformë (p.sh.,
- Projektet SageMaker )
- – një format i përbashkët për dërgimin e modeleve në veglat e ndryshme të shpërndarjes. MLflow (në momentin e shkruarjes së artikullit në versionin alfa) — një platformë me kod të hapur, e cila lejon menaxhimin e ciklit të jetës së mësimit të makinerive, duke përfshirë eksperimentet, ribashkëngitjen dhe shpërndarjen.
Konfigurimi i MLflow
Për të përdorur MLflow fillimisht duhet të konfigurosh të gjithë ambientin Python, për këtë do të përdorim
PyEnv ). Në këtë mënyrë do të krijojmë një ambient virtual në të cilin do të instalojmë të gjitha bibliotekat e nevojshme për ekzekutimin. ``` pyenv install 3.7.0 pyenv global 3.7.0 # Përdorni Python 3.7 mkvirtualenv mlflow # Krijoni një Ambient Virtual me Python 3.7 workon mlflow ```
Të instalojmë bibliotekat e kërkuara.``` pip install mlflow==0.7.0 Cython==0.29 numpy==1.14.5 pandas==0.23.4 pyarrow==0.11.0 ```
Shënim: Ne përdorim PyArrow për të ekzekutuar modele të tilla si UDF. Versionet e PyArrow dhe Numpy duhej të rregullonin, pasi versionet më të fundit ishin në konflikt me njëra-tjetrën.Vazhdojmë me UI-në e Ndjekjes
Nisimë Tracking UI
MLflow Tracking na lejonë të regjistrojmë dhe të bëjmë kërkesa për eksperimente përmes Python dhe API. Përveç kësaj, mund të vendosim se ku të ruajmë artefaktet e modelit (localhost, , , ose ). Duke qenë se në Alpha Health ne përdorim AWS, S3 do të jetë vendi i ruajtjes për artefaktet.
# Running a Tracking Server
mlflow server
    --file-store /tmp/mlflow/fileStore
    --default-artifact-root s3://<bucket>/mlflow/artifacts/
    --host localhost
    --port 5000
MLflow rekomandon përdorimin e një ruajtjeje të qëndrueshme skedari. Ruajtja e skedarëve është vendi ku serveri do të ruajë metadatat e ekzekutimeve dhe eksperimenteve. Kur të filloni serverin, sigurohuni që ai t'i referohet një ruajtjeje të qëndrueshme skedari. Këtu për eksperimentin ne thjesht do të përdorim /tmp.
Mbani mend se nëse duam të përdorim serverin mlflow për të ekzekutuar eksperimente të vjetra, ato duhet të jenë të pranishme në ruajtjen e skedarëve. Megjithatë, edhe pa këtë do të mund ta përdorim në UDF, pasi na nevojitet vetëm rruga deri te modeli.
Shënim: Kini parasysh se UI Tracking dhe klienti i modelit duhet të kenë akses në vendndodhjen e artefaktit. Kjo do të thotë se pavarësisht nga fakti se UI Tracking ndodhet në një instancë EC2, kur të ekzekutojme MLflow lokal, makina duhet të ketë akses të drejtpërdrejtë në S3 për të regjistruar modelet e artefakteve.
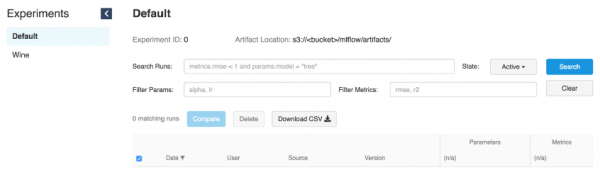
UI Tracking ruan artefaktet në një enë S3
Ekzekutimi i modeleve
Sapo të funksionojë serveri Tracking, mund të filloni të trajni modelet.
Si një shembull, ne do të përdorim modifikimin e wine nga shembulli i MLflow në .
MLFLOW_TRACKING_URI=http://localhost:5000 python wine_quality.py
  --alpha 0.9
  --l1_ration 0.5
  --wine_file ./data/winequality-red.csv
Ashtu siç e përmendem, MLflow lejon të regjistrojmë parametra, metrika dhe artefakte të modeleve, për të ndjekur se si ato zhvillohen gjatë iteracioneve. Kjo funksionalitet është jashtëzakonisht e dobishme, pasi kështu ne mund të riprodhojmë modelin më të mirë, duke iu drejtuar serverit Tracking ose duke kuptuar se cili kod e realizoi iteracionin e nevojshëm, duke përdorur regjistrat e hash commit-eve git.
with mlflow.start_run():

    ... model ...

    mlflow.log_param("source", wine_path)
    mlflow.log_param("alpha", alpha)
    mlflow.log_param("l1_ratio", l1_ratio)

    mlflow.log_metric("rmse", rmse)
    mlflow.log_metric("r2", r2)
    mlflow.log_metric("mae", mae)

    mlflow.set_tag('domain', 'wine')
    mlflow.set_tag('predict', 'quality')
mlflow.sklearn.log_model(lr, "model") 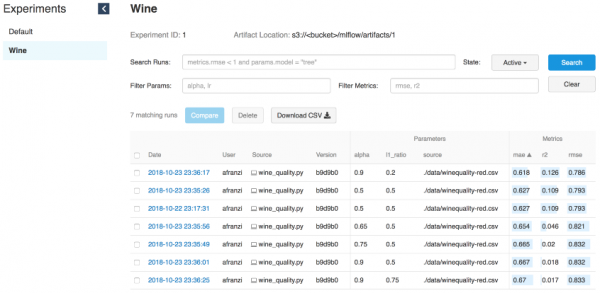
Iteracionet e wine
Pjesa serverike për modelin
Serveri i gjurmimit MLflow, i nisur përmes komandës "mlflow server", ka një API REST për të gjurmuar ekzekutimet dhe për të regjistruar të dhëna në sistemin lokal të skedarëve. Ju mund të specifikoni adresën e serverit të gjurmimit përmes variablës mjedisore "MLFLOW_TRACKING_URI" dhe API-ja e gjurmimit të MLflow automatikisht do të lidhet me serverin e gjurmimit në këtë adresë për të krijuar/marrë informacion rreth ekzekutimit, metrikave të logeve, etj.
Burimi:
Për të siguruar që modeli të ketë server, na nevojitet një server gjurmimi i nisur (shih ndërfaqen e nisjes) dhe Run ID e modelit.
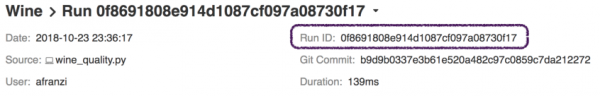
Run ID
# Serve a sklearn model through 127.0.0.0:5005
MLFLOW_TRACKING_URI=http://0.0.0.0:5000 mlflow sklearn serve
  --port 5005
  --run_id 0f8691808e914d1087cf097a08730f17
  --model-path model
Për të menaxhuar modelet me funksionalitetin MLflow serve, na nevojitet qasje në Tracking UI për të marrë informacionin rreth modelit thjesht duke specifikuar --run_id.
Sapo modeli lidhet me serverin e gjurmimit, ne mund të marrim një pikë të re fundore për modelin.
# Query Tracking Server Endpoint
curl -X POST
  http://127.0.0.1:5005/invocations
  -H 'Content-Type: application/json'
  -d '[
	{
		"fixed acidity": 3.42,
		"volatile acidity": 1.66,
		"citric acid": 0.48,
		"residual sugar": 4.2,
		"chloridessssss": 0.229,
		"free sulfur dsioxide": 19,
		"total sulfur dioxide": 25,
		"density": 1.98,
		"pH": 5.33,
		"sulphates": 4.39,
		"alcohol": 10.8
	}
]'

> {"predictions": [5.825055635303461]}
Ekzekutimi i modeleve nga Spark
Megjithëse serveri i gjurmimit është mjaft i fuqishëm për të shërbyer modelet në kohë reale, trajnimi dhe përdorimi i funksionalitetit serve (burimi: ), përdorimi i Spark (batch ose streaming) është një zgjidhje edhe më e fuqishme për shkak të shpërndarjes.
Imaginoni se sapo keni kryer trajnim offline dhe pastaj aplikuat modellin e rezultatit mbi të dhënat tuaja. Këtu është ku Spark dhe MLflow do të shfaqen në mënyrën më të mirë.
Instaloni PySpark + Jupyter + Spark
Burimi:
Për të treguar se si i aplikojmë modelet MLflow në DataFrame të Spark, duhen konfiguruar bashkëpunimi i Jupyter notebooks me PySpark.
Filloni me instalimin e versionit më të fundit stabil :
cd ~/Downloads/
tar -xzf spark-2.4.3-bin-hadoop2.7.tgz
mv ~/Downloads/spark-2.4.3-bin-hadoop2.7 ~/
ln -s ~/spark-2.4.3-bin-hadoop2.7 ~/spark
Instaloni PySpark dhe Jupyter në një ambient virtual:
pip install pyspark jupyterKonfiguroni variablat mjedisorë:
export SPARK_HOME=~/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS="notebook --notebook-dir=${HOME}/Projects/notebooks"
Duke përcaktuar notebook-dir, ne do të jemi në gjendje të ruajmë notebook-ët tanë në dosjen e dëshiruar.
Nisim Jupyter nga PySpark
Duke qenë se arritëm të konfigurojmë Jupiter si drejtuesin e PySpark, tani mund të nisim notebook Jupyter në kontekstin e PySpark.
(mlflow) afranzi:~$ pyspark
[I 19:05:01.572 NotebookApp] sparkmagic extension enabled!
[I 19:05:01.573 NotebookApp] Serving notebooks from local directory: /Users/afranzi/Projects/notebooks
[I 19:05:01.573 NotebookApp] The Jupyter Notebook is running at:
[I 19:05:01.573 NotebookApp] http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745
[I 19:05:01.573 NotebookApp] Use Control-C to stop this server and shut down all kernels (twice to skip confirmation).
[C 19:05:01.574 NotebookApp]

    Copy/paste this URL into your browser when you connect for the first time,
    to login with a token:
http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745 
Si e thamë më sipër, MLflow ofron veçorinë e regjistrimit të artefakteve të modelit në S3. Sa herë që kemi në duar modelin e zgjedhur, kemi mundësinë ta importojmë si UDF nëpërmjet modulit mlflow.pyfunc.
import mlflow.pyfunc

model_path = 's3:///mlflow/artifacts/1/0f8691808e914d1087cf097a08730f17/artifacts/model'
wine_path = '/Users/afranzi/Projects/data/winequality-red.csv'
wine_udf = mlflow.pyfunc.spark_udf(spark, model_path)

df = spark.read.format("csv").option("header", "true").option('delimiter', ';').load(wine_path)
columns = [ "fixed acidity", "volatile acidity", "citric acid",
            "residual sugar", "chlorides", "free sulfur dioxide",
            "total sulfur dioxide", "density", "pH",
            "sulphates", "alcohol"
          ]

df.withColumn('prediction', wine_udf(*columns)).show(100, False) 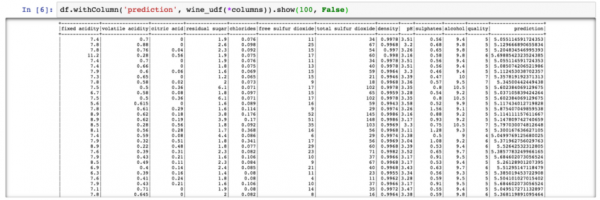
PySpark – Dalja e parashikimit të cilësisë së verës
Derisa kemi folur deri tani për mënyrën e përdorimit të PySpark me MLflow, duke nisur parashikimin e cilësisë së verës në tërë grupin e të dhënave wine. Por çfarë ndodh nëse na nevojitet të përdorim modulët e Python MLflow nga Scala Spark?
E kemi testuar këtë gjithashtu, duke ndarë kontekstin Spark mes Scala dhe Python. Kështu, ne regjistruam MLflow UDF në Python dhe e përdorëm nga Scala (po, ndoshta nuk është zgjidhja më e mirë, por është ajo që kemi).
Scala Spark + MLflow
Për këtë shembuj do të shtojmë në Jupiterin ekzistues.
Instalojmë Spark + Toree + Jupyter
pip install toree
jupyter toree install --spark_home=${SPARK_HOME} --sys-prefix
jupyter kernelspec list
```
```
Kernela të disponueshme:
  apache_toree_scala    /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/apache_toree_scala
  python3               /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/python3
```
Siç duket nga notebook-u i bashkangjitur, UDF përdoret në bashkëpunim me Spark dhe PySpark. Shpresojmë që kjo pjesë do të jetë e dobishme për ata që duan Scala dhe duan të implementojnë modele të mësimit të makinerive në prodhim.
import org.apache.spark.sql.functions.col
import org.apache.spark.sql.types.StructType
import org.apache.spark.sql.{Column, DataFrame}
import scala.util.matching.Regex

val FirstAtRe: Regex = "^_".r
val AliasRe: Regex = "[\s_.:@]+".r

def getFieldAlias(field_name: String): String = {
    FirstAtRe.replaceAllIn(AliasRe.replaceAllIn(field_name, "_"), "")
}

def selectFieldsNormalized(columns: List[String])(df: DataFrame): DataFrame = {
    val fieldsToSelect: List[Column] = columns.map(field =>
        col(field).as(getFieldAlias(field))
    )
    df.select(fieldsToSelect: _*)
}

def normalizeSchema(df: DataFrame): DataFrame = {
    val schema = df.columns.toList
    df.transform(selectFieldsNormalized(schema))
}

FirstAtRe = ^_
AliasRe = [s_.:@]+

getFieldAlias: (field_name: String)String
selectFieldsNormalized: (columns: List[String])(df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
normalizeSchema: (df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
Out[1]:
[s_.:@]+
In [2]:
val winePath = "~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv"
val modelPath = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"

winePath = ~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv
modelPath = \/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
Out[2]:
\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
In [3]:
val df = spark.read
              .format("csv")
              .option("header", "true")
              .option("delimiter", ";")
              .load(winePath)
              .transform(normalizeSchema)

df = [fixed_acidity: string, volatile_acidity: string ... 10 more fields]
Out[3]:
[fixed_acidity: string, volatile_acidity: string ... 10 more fields]
In [4]:
%%PySpark
import mlflow
from mlflow import pyfunc

model_path = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"
wine_quality_udf = mlflow.pyfunc.spark_udf(spark, model_path)

spark.udf.register("wineQuality", wine_quality_udf)
Out[4]:
<function spark_udf..predict at 0x1116a98c8>
In [6]:
df.createOrReplaceTempView("wines")
In [10]:
%%SQL
SELECT
    quality,
    wineQuality(
        fixed_acidity,
        volatile_acidity,
        citric_acid,
        residual_sugar,
        chlorides,
        free_sulfur_dioxide,
        total_sulfur_dioxide,
        density,
        pH,
        sulphates,
        alcohol
    ) AS prediction
FROM wines
LIMIT 10
Out[10]:
+-------+------------------+
|quality|        prediction|
+-------+------------------+
|      5| 5.576883967129615|
|      5|  5.50664776916154|
|      5| 5.525504822954496|
|      6| 5.504311247097457|
|      5| 5.576883967129615|
|      5|5.5556903912725755|
|      5| 5.467882654744997|
|      7| 5.710602976324739|
|      7| 5.657319539336507|
|      5| 5.345098606538708|
+-------+------------------+

In [17]:
spark.catalog.listFunctions.filter('name like "%wineQuality%").show(20, false)

+-----------+--------+-----------+---------+-----------+
|name       |database|description|className|isTemporary|
+-----------+--------+-----------+---------+-----------+
|wineQuality|null    |null       |null     |true       |
+-----------+--------+-----------+---------+-----------+
Hapat e ardhshëm
Megjithëse në momentin e shkrimit të këtij artikulli MLflow është në versionin Alpha, duket mjaft premtuese. Ajo mundësi për të drejtuar disa framework-e të mësimit të makinë dhe për t'i përdorur ato nga një pikë fundore e njëjtë e çon sistemet rekomanduese në një nivel të ri.
Për më tepër, MLflow afron inxhinierët e të dhënave dhe specialistët e shkencës së të dhënave duke krijuar një shtresë të përbashkët midis tyre.
Pas kësaj hulumtimi mbi MLflow, jemi të sigurt se do të vazhdojmë përpara dhe do ta përdorim në pipeline-t tona të Spark dhe në sistemet rekomanduese.
Do të ishte mirë të sinkronizojmë ruajtjen e skedarëve me bazën e të dhënave, në vend të sistemit të skedarëve. Kështu duhet të kemi disa pika fundore që mund të përdorin të njëjtin ruajtje skedari. Për shembull, të përdorim disa instance dhe me të njëjtin Glue metastore.
Në përfundim, duam të falënderojmë komunitetin MLFlow për atë që e bëni punën tonë me të dhëna më interesante.
Nëse po luani me MLflow, mos hezitoni të na shkruani dhe të na tregoni si e përdorni, dhe për më tepër, nëse e përdorni atë në prodhim.
Mësoni më shumë rreth kurseve:
Lexoni më shumë:
Burimi: habr.com
