

Kemi pasur 2 çanta bari, 75 tableta meskaline ambient unix, depo docker dhe detyra për të realizuar komandat docker pull dhe docker push pa klientin docker.
UPD:
Pyetja: Për çfarë shërben gjithçka kjo?
Përgjigja: Testimi i ngarkesës së produktit (JO me mjete bash, skriptet janë dhënë për qëllime edukative). Nuk u vendos të përdoret klienti docker për të reduktuar shtresat shtesë (në kufij të arsyeshëm) dhe duke kështu imituar një ngarkesë më të lartë. Si rezultat, u hoqën të gjitha vonesat sistemike të klientit docker. Kemi marrë një ngarkesë relativisht të pastër drejtpërdrejt në produkt.
Në artikull u përdorën mjete GNU versionesh.
Për të filluar, le të shohim se çfarë bëjnë këto komanda.
Pra, për çfarë përdoret docker pull? Sipas :
"Merrni një imazh ose një depo nga një regjistër."
Aty gjithashtu gjejmë lidhjen për .
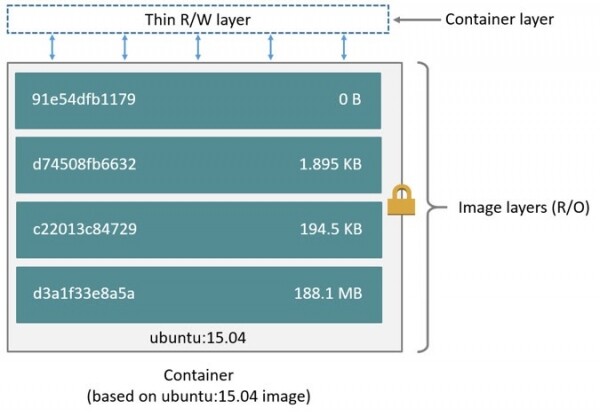
Prej këtu mund të kuptojmë se imazhi docker është një grup layers, të cilat përmbajnë informacion në lidhje me ndryshimet më të fundit në imazh, të cilat natyrisht na duhen. Më pas, shohim në .
Këtu thuhet si më poshtë:
"Një 'imazh' është një kombinim i një manifeshti JSON dhe skedarëve individualë të layers. Procesi i tërheqjes së një imazhi përqendrohet rreth sjelljes së këtyre dy komponentëve."
Pra, hapi i parë sipas dokumentacionit është “Tërheqja e një Manifesti të Imazhit”.
Sigurisht që nuk do ta terheqim atë, por të dhënat nga të cilat na nevojiten. Më pas jepet një shembull kërkese: GET /v2/{name}/manifests/{reference}
"Parametrat emri dhe referenca identifikojnë imazhin dhe janë të nevojshme. Referenca mund të përfshijë një etiketë ose digest."
Depoja jonë docker është instaluar lokalisht, le të provojmë të kryejmë kërkesën:
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/manifests/1.1.1" -H "header_if_needed"
Në përgjigje marrim json nga i cili na interesojnë vetëm layers, më saktësisht hash-et e tyre. Duke i marrë ato, mund të kalojmë për secilin dhe të kryejmë kërkesën e ardhshme: "GET /v2/{name}/blobs/{digest}"
“Qasja në një layer do të jetë e kufizuar nga emri i depozitës, por identifikohet në mënyrë unike në regjistrin nga digest.”
diegsti në këtë rast është hash-i, të cilin e morëm.
Po provojmë
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/blobs/sha256:f972d139738dfcd1519fd2461815651336ee25a8b54c358834c50af094bb262f" -H "header_if_needed" --output firstLayer
le të shohim çfarë lloj skedari kemi marrë si layer të parë.
file firstLayer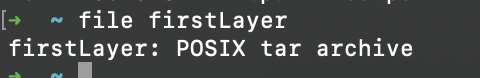
dmth, layers përfaqësojnë arkiva tar, të cilat, kur shpaketohen në rendin e duhur, do të na japin përmbajtjen e imazhit.
Le të shkruajmë një skript të vogël për bash që të mund ta automatizojmë gjithçka këtë.
#!/bin/bash -eu

downloadDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
imageName=$3
tag=$4

# array of layers
layers=($(curl -s -X GET "$url/v2/$imageName/manifests/$tag" | grep -oP '(?<=blobSum" : ").+(?=")'))

# download each layer from array
for layer in "${layers[@]}"; do
    echo "Downloading ${layer}"
    curl -v -X GET "$url/v2/$imageName/blobs/$layer" --output "$downloadDir/$layer.tar"
done

# find all layers, untar them and remove source .tar files
cd "$downloadDir" && find . -name "sha256:*" -exec tar xvf {} ;
rm sha256:*.tar
exit 0
Tani zgjidhim mund ta nisim me parametrat e dëshiruara dhe të marrim përmbajtjen e imazhit të nevojshëm
.\/script.sh dirName "http:\/\/localhost:8081\/link\/to\/docker\/registry" myAwesomeImage 1.0Pjesa 2 — docker push
Këtu do të jetë pak më e komplikuar.
Le të fillojmë përsëri me . Pra, na duhet të ngarkojmë secilën shtresë, të bëjmë manifestin përkatës dhe ta ngarkojmë atë gjithashtu. Kjo duket e thjeshtë.
Duke studiuar dokumentacionin, mund ta ndajmë procesin e ngarkimit në disa hapa:
- Inicimi i procesit — "POST \/v2\/{repoName}\/blobs\/uploads\/"
- Ngarkimi i shtresës (ne do të përdorim ngarkim monolitik, dmth. secila shtresë dërgohet e tëra) — "PUT \/v2\/{repoName}\/blobs\/uploads\/{uuid}?digest\={digest}"
Content-Length: {size of layer}
Content-Type: application\/octet-stream
Layer Binary Data". - Ngarkimi i manifestit — "PUT \/v2\/{repoName}\/manifests\/{reference}".
Por në dokumentacion është humbur një hap, pa të cilin asgjë nuk do të funksionojë. Për ngarkimin monolitik, ashtu si për atë të pjesshëm (chunked), para se të ngarkoni një shtresë duhet të kryeni një kërkesë PATCH:
"PATCH \/v2\/{repoName}\/blobs\/uploads\/{uuid}"
Content-Length: {size of chunk}
Content-Type: application\/octet-stream
{Layer Chunk Binary Data}".
Në të kundërt, nuk do të mund të avanconi më tej se pika e parë, pasi përveç kodit të pritur 202 do të merrni 4xx.
Tani algoritmi duket si më poshtë:
- Inicimi
- Patch i shtresës
- Ngarkimi i shtresës
- Ngarkimi i manifestit
Pikat 2 dhe 3 përkatësisht do të përsëriten sa herë që duhen ngarkuar shtresa.
Për fillimin na nevojitet një imazh çfarëdo. Unë do të përdor archlinux:latest
docker pull archlinux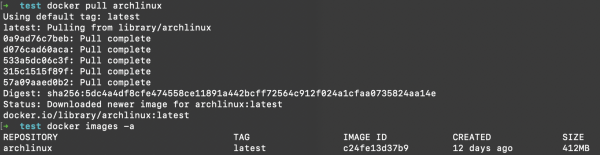
Tani ta ruajmë lokal për analizë të mëtejshme
docker save c24fe13d37b9 -o savedArch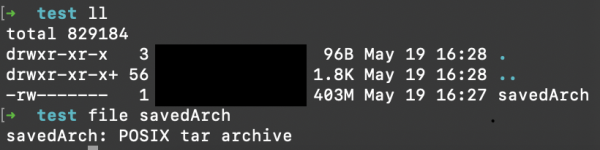
Të nxjerrim arkivën e marrë në direktorinë aktuale
tar xvf savedArch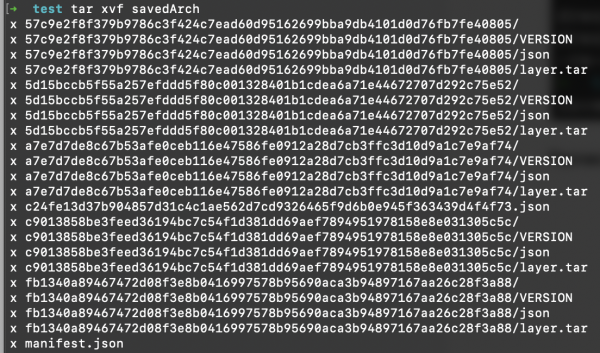
Siç e shohim, secila shtresë ndodhet në një dosje të veçantë. Tani të shohim strukturën e manifestit që marrëm
cat manifest.json | json_pp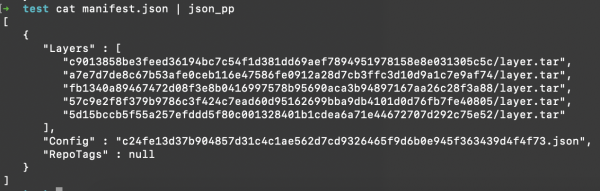
Nuk ka shumë aty. Të shohim cilin manifest na nevojitet për ngarkim, sipas .
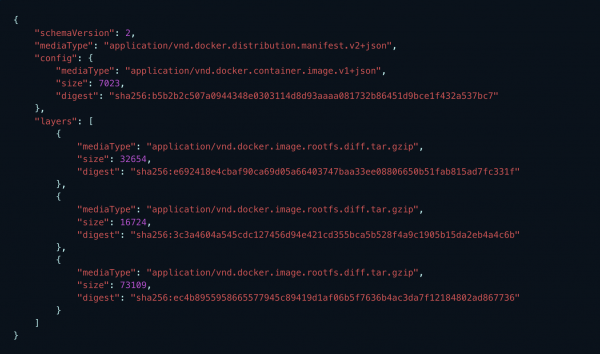
Është e qartë se manifesti ekzistues nuk na përshtatet, prandaj do të bëjmë tonin me blackjack dhe shtresa dhe konfigurime.
Do të kemi gjithmonë minimum një skedar konfigurimi dhe një varg shtresash. Versioni i skemës 2 (aktual në momentin e shkrimit të artikullit), mediaType do ta lëmë pa ndryshuar:
echo ‘{
   "schemaVersion": 2,
   "mediaType": "application/vnd.docker.distribution.manifest.v2+json",
   "config": {
      "mediaType": "application/vnd.docker.container.image.v1+json",
      "size": config_size,
      "digest": "config_hash"
   },
   "layers": [
      ’ > manifest.json
Pas krijimit të manifestit bazë, duhet ta mbushim atë me të dhëna valide. Për këtë do të përdorim shembullin e objektit JSON të shtresës:
{\n "mediaType": "application\/vnd.docker.image.rootfs.diff.tar.gzip",\n "size": ${layersSizes[$i]},\n "digest": "sha256:${layersNames[$i]}"\n },atë do ta shtojmë në manifest për secilën shtresë.
Pastaj na duhet të dimë madhësinë e skedarit të konfigurimit dhe të zëvendësojmë vendet e lirë në manifest me të dhëna reale
sed -i "s/config_size/[31m$configSize[0m/g; s/config_hash/[31m$configName[0m/g" $manifestFileTani mund të nisim procesin e ngarkimit dhe të ruajmë uuid, i cili duhet të shoqërojë të gjitha kërkesat e mëvonshme.
Skripti i plotë duket pak a shumë kështu:
#!/bin/bash -eux

imageDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
repoName=$3
tag=$4
manifestFile=$(readlink -f ${imageDir}/manifestCopy)
configFile=$(readlink -f $(find $imageDir -name "*.json" ! -name "manifest.json"))

# calc layers sha 256 sum, rename them accordingly, and add info about each to manifest file
function prepareLayersForUpload() {
  info_file=$imageDir/info
  # lets calculate layers sha256 and use it as layers names further
  layersNames=($(find $imageDir -name "layer.tar" -exec shasum -a 256 {} ; | cut -d" " -f1))

  # rename layers according to shasums. !!!Set required amount of fields for cut command!!!
  # this part definitely can be done easier but i didn't found another way, sry
  find $imageDir -name "layer.tar" -exec bash -c 'mv {} "$(echo {} | cut -d"/" -f1,2)/$(shasum -a 256 {} | cut -d" " -f1)"' ;

  layersSizes=($(find $imageDir -name "*.tar" -exec ls -l {} ; | awk '{print $5}'))

  for i in "${!layersNames[@]}"; do
    echo "{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      }," >> $manifestFile
  done
  # remove last ','
  truncate -s-2 $manifestFile
  # add closing brakets to keep json consistent
  printf "nt]n}" >> $manifestFile
}

# calc config sha 256 sum and add info about it to manifest
function setConfigProps() {
  configSize=$(ls -l $configFile | awk '{print $5}')
  configName=$(basename $configFile | cut -d"." -f1)

  sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFile
}

#prepare manifest file
prepareLayersForUpload
setConfigProps
cat $manifestFile

# initiate upload and get uuid
uuid=$(curl -s -X POST -I "$url/v2/$repoName/blobs/uploads/" | grep -oP "(?<=Docker-Upload-Uuid: ).+")

# patch layers
# in data-binary we're getting absolute path to layer file
for l in "${!layersNames[@]}"; do
  pathToLayer=$(find $imageDir -name ${layersNames[$l]} -exec readlink -f {} ;)
    curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: ${layersSizes[$i]}"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$pathToLayer"

# put layer
  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:${layersNames[$i]}"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: ${layersSizes[$i]}"
  --data-binary "@$pathToLayer"
done

# patch and put config after all layers
curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: $configSize"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$configFile"

  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:$configName"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: $configSize"
  --data-binary "@$configFile"

# put manifest
curl -v -X PUT "$url/v2/$repoName/manifests/$tag"
  -H 'Content-Type: application/vnd.docker.distribution.manifest.v2+json'
  --data-binary "@$manifestFile"

exit 0
mund të përdorim një skript të gatshëm:
./uploadImage.sh "~\/path\/to\/saved\/image" "http:\/\/localhost:8081\/link\/to\/docker\/registry" myRepoName 1.0UPD:
Çfarë morëm si rezultat?
Së pari, të dhëna reale për analizë, pasi testet ekzekutohen në blazemeter dhe të dhënat nga kërkesat e klientit docker janë mjaft të pa informuar krahasuar me kërkesat e pastërta HTTP.
Së dyti, kalimi na lejoi të rrisim numrin e përdoruesve virtualë për ngarkimin docker me rreth 150% dhe të arrijmë një kohë mesatare përgjigjeje 20-25% më të shpejtë. Për shkarkimin docker, arritëm të rrisim numrin e përdoruesve me 500%, duke ulur në të njëjtën kohë kohën mesatare të përgjigjes me rreth 60%.
Faleminderit për vëmendjen.
Burimi: habr.com
