

Disa muajve më parë — shërbimi publik për PostgreSQL.
Gjatë kësaj periudhe, ju e keni përdorur atë më shumë se 6000 herë, por një nga funksionet e dobishme mund të ketë mbetur e papërfillur — këto janë suggestionet strukturore, të cilat duken përafërsisht kështu:
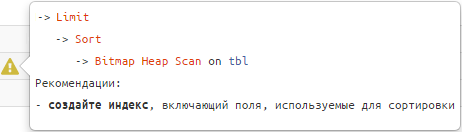
Dëgjoni ato, dhe pyetjet tuaja "do të bëhen të lëmuara dhe të përkryera". 🙂
Por nëse flasim seriozisht, shumë situata që e bëjnë pyetjen të ngadalshme dhe "konsumon shumë burime" janë tipike dhe mund të identificohen nga struktura dhe të dhënat e planit.
Në këtë rast, çdo zhvillues i veçantë nuk do të duhet të kërkojë një variant optimizimi në mënyrë të pavarur, duke u mbështetur vetëm në përvojën e tij — ne mund t'i tregojmë atij se çfarë po ndodh, cili mund të jetë shkaku dhe si mund të qasemi në zgjidhje. Këto janë gjërat që kemi bërë.
Le të shqyrtojmë pak më në detaje këto raste — si përcaktohen dhe në çfarë rekomandacionesh çojnë.
Për një përvojë më të mirë të temës, në fillim mund të dëgjoni bllokun përkatës nga , dhe pastaj të kaloni në analizën e detajuar të çdo shembulli:
#1: индексная «недосортировка»
Kur ndodh
Trego faturën më të fundit për klientin "OOO Kolokollchik".
Si të identifikohet
-> Limit
   -> Sort
      -> Index [Vetëm] Skano [Mbrapsht] | Bitmap Heap Scan
Rekomandime
Indeksi i përdorur zgjerojë me fushat e rendit.
Shembulli:
KRIJO TABELË tbl SI
Zgjedh
  generate_series(1, 100000) pk  -- 100K "fakte"
, (random() * 1000)::integer fk_cli; -- 1K çelësa të ndryshëm të jashtëm

KRIJO INDESK PËR tbl(fk_cli); -- indeks për çelësin e huaj

Zgjedh
  *
KATËR
  tbl
KU
  fk_cli = 1 -- filtrimi me lidhjen specifike
ORDO
  pk DESC -- duam vetëm një "të fundit" shënim
LIMIT 1; 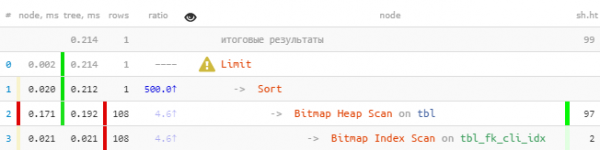
Menjëherë mund të vërehet se nga indeksi janë nxjerrë më shumë se 100 regjistrime, të cilat pastaj janë renditur të gjitha, dhe më pas është mbajtur vetëm një.
Korrigjojmë:
Fshi INDESKIN tbl_fk_cli_idx;
KRIJO INDESK PËR tbl(fk_cli, pk DESC); -- shtuam çelësin e rendit
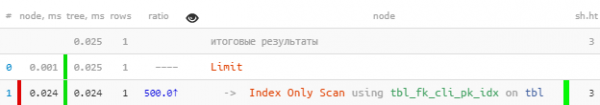
Edhe në një përzgjedhje kaq primitive — 8.5 herë më të shpejtë dhe 33 herë më pak lexime. Efekti do të jetë më i dukshëm, sa më shumë "fakte" të keni për çdo vlerë fk.
Vërej se ky indeks do të punojë si "prefiks" jo më keq se më parë edhe për pyetje të tjera me fk, ku renditjet sipas pk nuk ka qenë dhe nuk ka (më shumë për këtë mund të lexoni ). Në veçanti, ai do të sigurojë edhe mbështetje të duhur për çelësin e jashtëm të huaj për këtë fushë. për këtë fushë.
#2: пересечение индексов (BitmapAnd)
Kur ndodh
Trego të gjitha kontratat për klientin «ООО Колокольчик», të lidhura nga emri «НАО Лютик».
Si të identifikohet
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Rekomandime
Krijo indeksi i përbërë në fushat nga të dy burimet ose të zgjeroni një nga ekzistuesit me fusha nga e dyta.
Shembulli:
KRIJO TABELË tbl SI
Zgjidh
  generate_series(1, 100000) pk      -- 100K "fakte"
, (random() *  100)::integer fk_org  -- 100 çelësa të ndryshëm të jashtëm
, (random() * 1000)::integer fk_cli; -- 1K çelësa të ndryshëm të jashtëm

KRIJO INDEN NË tbl(fk_org); -- indeks për çelësin e jashtëm
KRIJO INDEN NË tbl(fk_cli); -- indeks për çelësin e jashtëm

Zgjidh
  *
FROM
  tbl
KU
(fk_org, fk_cli) = (1, 999); -- filtrimi sipas një çifti konkret 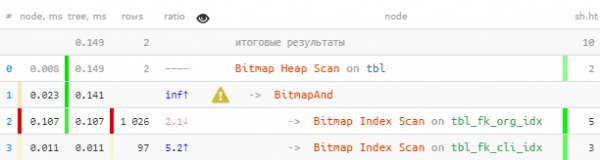
Korrigjojmë:
HEQ INDEN tbl_fk_org_idx;
KRIJO INDEN NË tbl(fk_org, fk_cli);
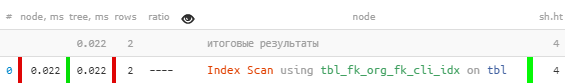
Këtu fitimi është më i vogël, pasi Bitmap Heap Scan është mjaft efikas në vetvete. Por megjithatë 7 herë më i shpejtë dhe 2.5 herë më pak lexime.
#3: объединение индексов (BitmapOr)
Kur ndodh
Trego 20 aplikacionet më të vjetra «të tua» ose të pa caktuara për përpunim, me aplikacionet e tua në prioritet.
Si të identifikohet
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Rekomandime
Përdorni UNION [ALL] për të bashkuar nënpyetjet sipas çdo njësie OR të kushteve.
Shembulli:
KRIJO TABELË tbl SI
Zgjidh
  generate_series(1, 100000) pk  -- 100K "fakte"
, RASTISHT
    KUR random() < 1::real/16 ATËHERË NULL -- me probabilitet 1:16 regjistrimi "barazim"
    ND otherwise (random() * 100)::integer -- 100 çelësa të ndryshëm të jashtëm
  FUND fk_own;

KRIJO INDEN NË tbl(fk_own, pk); -- indeks me "dukshëm përputhës" renditje

Zgjidh
  *
FROM
  tbl
KU
  fk_own = 1 OSE -- të tuat
  fk_own ËSHTË NULL -- ... ose "barazim"
RENDIT NGA
  pk
, (fk_own = 1) ZBRITJE -- fillimisht "të tua"
LIMIT 20;
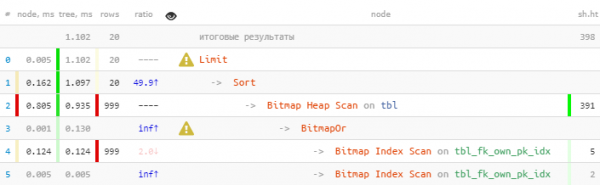
Korrigjojmë:
(
  Zgjidh
    *
  FROM
    tbl
  KU
    fk_own = 1 -- fillimisht "të tua" 20
  RENDIT NGA
    pk
  LIMIT 20
)
UNION ALL
(
  Zgjidh
    *
  FROM
    tbl
  KU
    fk_own ËSHTË NULL -- më pas "barazim" 20
  RENDIT NGA
    pk
  LIMIT 20
)
LIMIT 20; -- por gjithsej - 20, më shumë nuk nevojitet 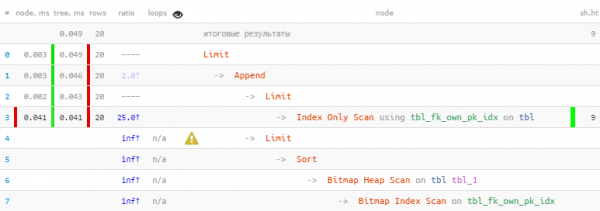
Ne e shfrytëzuam që të gjitha 20 regjistrimet e nevojshme u morën menjëherë në bllokun e parë, kështu që i dyti, me një Bitmap Heap Scan "më të shtrenjtë", nuk u ekzekutua as - përfundimisht 22 herë më i shpejtë, 44 herë më pak lexime!
Një histori më e detajuar mbi këtë metodë optimizimi në shembuj konkretë mund të lexoni në artikuj dhe .
Varianti i përgjithshëm renditja e organizuar sipas disa çelësave (dhe jo vetëm sipas një çifti const/NULL) është shqyrtuar në artikull .
#4: читаем много лишнего
Kur ndodh
Në rregull, ndodh kur dëshirohet "të shtohet një filtër tjetër" në një kërkesë ekzistuese.
«A nuk keni një të tillë, por me byzylykë perlmuar?» film "Brylili i dorës"
Për shembull, duke modifikuar detyrën e lartpërmendur, tregoni 20 aplikacione më të vjetra "kritike" për përpunim, pavarësisht nga caktimi i tyre.
Si të identifikohet
-> Scan i sekuencave | Bitmap Heap Scan | Indeks [Vetëm] Scan [Mbrapsht] && 5 × rreshta 80% e të lexuarave && loops × RRbF > 100 -- dhe në të njëjtën kohë më shumë se 100 regjistrime gjithsej
Rekomandime
Krijoni [më] të specializuar indeks me kushtin WHERE ose përfshini në indeks fusha shtesë.
Nëse kushti i filtrimit është "statik" për detyrat tuaja — domethënë nuk parashikon zgjerimin e listës së vlerave në të ardhmen — është më mirë të përdorni indeksin WHERE. Kjo kategori përfshin statuset e ndryshme boolean/enum.
Nëse kushti i filtrimit mund të marrë vlera të ndryshme, është më mirë të zgjeroni indeksin me këto fusha — si në situatën me BitmapAnd lart.
Shembulli:
KRIJO TABELË tbl SI
ZGJEDH
  generate_series(1, 100000) pk -- 100K "fakte"  , RAST
    KUR rastësor() < 1::real/16 ATËHERË NULL
    TJETRI (rastësor() * 100)::integer -- 100 çelësa të ndryshëm të jashtëm  END fk_own
, (rastësor() < 1::real/50) kritik; -- 1:50, që kërkesa "kritike"  KRIJO INDËKSO ON tbl(pk);
KRIJO INDËKSO ON tbl(fk_own, pk);

ZGJEDH
  *
PREJ
  tbl
KU
  kritik
RENDIT SIPAS
  pk
LIMITO 20; 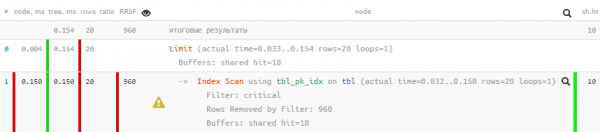
Korrigjojmë:
KRIJO INDËKSO ON tbl(pk)
  KU kritik; -- e kemi shtuar "kushtin" statik të filtrimit
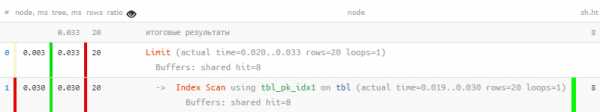
Siç e shohim, filtrimi nga plani u hoq plotësisht, dhe kërkesa u bë 5 herë më e shpejtë.
#5: разреженная таблица
Kur ndodh
Përpjekje të ndryshme për të krijuar një radhë të vetme për përpunimin e detyrave, kur një numër i madh i azhurnimeve/eleminimeve të regjistrave në tabelë çon në një situatë me shumë regjistra "të vdekur".
Si të identifikohet
-> Scan i sekuencave | Bitmap Heap Scan | Indeks [Vetëm] Scan [Mbrapsht] && loops × (rreshta + RRbF) 64
Rekomandime
Rregullisht realizoni manualisht VACUUM [PLOTË] ose arrini të realizoni një ekzekutim adekuat të shpeshtë duke e rregulluar parametrat e tij, përfshirë .
Në shumicën e rasteve, këto probleme shpesh janë të shkaktuara nga një kompozim i keq i kërkesave në thirrjet nga logjika biznesore siç janë ato që janë shqyrtuar në .
Por duhet të kuptohet se edhe VACUUM FULL mund të ndihmojë jo gjithmonë. Për këto raste, është e dobishme të njiheni me algoritmin nga artikulli .
#6: чтение с «середины» индекса
Kur ndodh
Duket se kemi lexuar pak, dhe gjithçka sipas indeksit, dhe nuk kemi filtruar askënd të panevojshëm — dhe megjithatë është lexuar ndjeshëm më shumë faqe sesa do të dëshironim.
Si të identifikohet
-> Indeks [Vetëm] Scan [Mbrapsht] && loops × (rreshta + RRbF) 64
Rekomandime
Kujdesi i veçantë për strukturën e indeksit të përdorur dhe fushat kyçe të specifikuara në kërkesë — shumë احتمال ً, një pjesë e indeksit nuk është caktuar. Më shumë probabilitet, do t'ju duhet të krijoni një indeks të ngjashëm, por pa fushat prefikse ose .
Shembulli:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "fakte"
, (random() *  100)::integer fk_org  -- 100 çelësat e jashtëm të ndryshëm
, (random() * 1000)::integer fk_cli; -- 1K çelësat e jashtëm të ndryshëm

CREATE INDEX ON tbl(fk_org, fk_cli); -- gjithçka pothuajse si në #2
-- vetëm se indeksi i veçantë për fk_cli tani e kemi llogaritur të tepërt dhe e kemi fshirë

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- dhe fk_org nuk është caktuar, megjithëse është në indeks më parë
LIMIT 20; 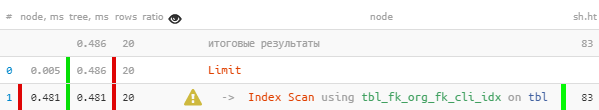
Duket se gjithçka është në rregull, madje edhe sipas indeksit, por ndjenjë e çuditshme — për secilën nga 20 rekordet e lexuara duhej të lexoje 4 faqe të dhënash, 32KB për regjistrim — nuk është pak? Po ashtu emri i indeksit tbl_fk_org_fk_cli_idx ngjall mendime.
Korrigjojmë:
CREATE INDEX ON tbl(fk_cli); 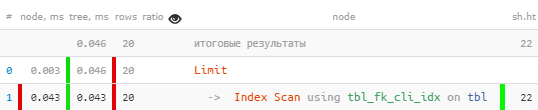
Papritur — 10 herë më shpejt, dhe 4 herë më pak të lexosh!
Shembuj të tjerë të situatave të pamjaftueshme të përdorimit të indekseve mund të shihni në artikullin .
#7: CTE × CTE
Kur ndodh
Në kërkesën kemi marrë "CTE të yndyrshme" nga tabela të ndryshme, e pastaj vendosëm të bëjmë mes tyre JOIN.
Rasti është aktual për versione më poshtë v12 ose kërkesa me ME MATERIALIZIM.
Si të identifikohet
-> CTE Scan
   && ciklet > 10
   && ciklet × (rreshtat + RRbF) > 10000
      -- produkti kartesian i CTE është tepër i madh
Rekomandime
Analizoni me kujdes kërkesën — a ? Если все-таки да, то aplikoni "shpjegimin" në hstore/json sipër modelit të përshkruar në .
#8: swap на диск (temp written)
Kur ndodh
Përpunimi një herë (renditja ose unifikimi) i një sasi të madhe regjistrash nuk i përputhet memorie që i është caktuar për këtë.
Si të identifikohet
-> *
   && temp written > 0
Rekomandime
Nëse sasia e memories e përdorur nga operacioni nuk kalon ndjeshëm vlerën e caktuar të parametrave , duhet ta rregulloni. Mund ta bëni menjëherë në konfig dhe për të gjithë, ose përmes SET [LOCAL] për kërkesën/të transaksionit konkret.
Shembulli:
SHOW work_mem;
-- "16MB"

SELECT
  random()
FROM
  generate_series(1, 1000000)
ORDER BY
1; 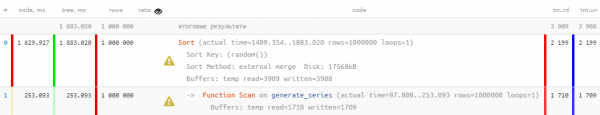
Korrigjojmë:
SET work_mem = '128MB'; -- përpara ekzekutimit të kërkesës 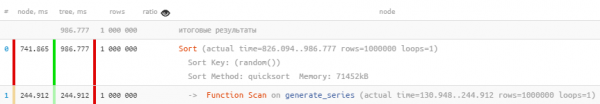
Për arsye të kuptueshme, nëse përdoret vetëm memoria, dhe jo disku, atëherë kërkesa do të ekzekutohet shumë më shpejt. Gjithashtu, një pjesë e ngarkesës nga HDD hiqet.
Por duhet të kuptohet se gjithmonë nuk është e mundur të caktohet shumë memorie — thjesht s'ka për të gjithë.
#9: неактуальная статистика
Kur ndodh
Në bazë të të dhënave u futën shumë, por nuk arritën ta kalonin ANALYZE.
Si të identifikohet
-> Selekto Skano | Bitmap Heap Scan | Indeksi [Vetëm] Skano [Prapa]
   && raporti >> 10
Rekomandime
Dhe mbani mend ANALYZE.
Më shumë detaje për këtë situatë janë përshkruar në .
#10: «что-то пошло не так»
Kur ndodh
Ndodhi një pritje bllokimi, e vendosur nga një kërkesë tjetër, ose mungoi burimi hardueror CPU/hypervisor.
Si të identifikohet
-> *
   && (pika e përbashkët / 8K) + (leximi i përbashkët / 1K) < koha / 1000
      -- RAM hit = 64MB/s, HDD leximi = 8MB/s
   && koha > 100ms -- kemi lexuar pak, por shumë ngadalë
Rekomandime
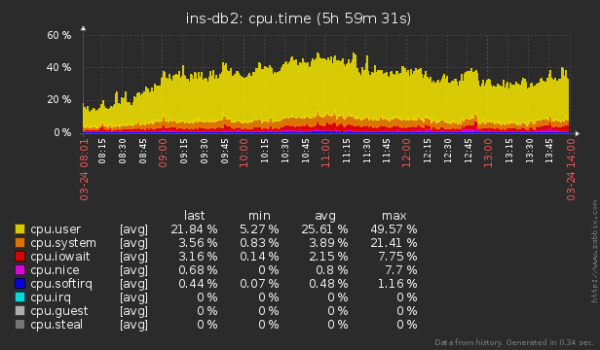
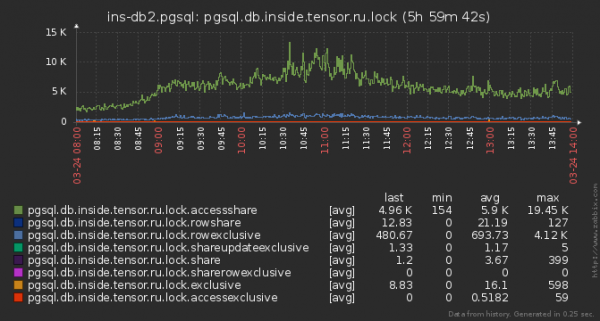
Përdorni një sistem të jashtëm për monitorimin e serverëve për bllokime ose konsum të pazakontë të burimeve. Rreth mënyrës sonë të organizimit të këtij processi për qindra serverë, ne e kemi përshkruar tashmë dhe .
Burimi: habr.com
