

Ide dhe takime mbi proceset që mund të automatizohen ende ndodhin çdo ditë në bizneset e të gjitha përmasave. Por përveç se shumë kohë mund të shpenzohet për ndërtimin e modelit, duhet të kaloni kohë për ta vlerësuar dhe për të kontrolluar që rezultati të mos jetë rastësor. Pas implementimit, çdo model duhet të vendoset në monitorim dhe të kontrollohet periodikisht.
Dhe këto janë të gjitha faza që duhet të kalojë çdo kompani, pavarësisht nga madhësia e saj. Nëse flasim për përmasat dhe trashëgiminë e Sberbank, numri i konfigurimeve të hollësishme rritet shumëfish. Deri në fund të vitit 2019, në Sber ishin përdorur më shumë se 2000 modele. Nuk është e mjaftueshme thjesht të zhvilloni një model, nevojitet integrimi me sistemet industriale, zhvillimi i vitrinave të të dhënave për ndërtimin e modeleve dhe sigurimi i kontrollit të funksionimit të saj në klaster.
Ekipa jonë po zhvillon platformën Sber.DS. Ajo lejon zgjidhjen e problemeve të mësimit makinerik, përshpejton procesin e verifikimit të hipotezave, në përgjithësi lehtëson procesin e zhvillimit dhe validimit të modeleve, dhe gjithashtu kontrollon rezultatin e funksionimit të modelit në PROМ.
Për të mos i mashtruar pritshmëritë tuaja, dua të them paraprakisht se ky post është hyrës, dhe nën kapak do të flasim fillimisht për atë që në përgjithësi ndodhet nën kapak të platformës Sber.DS. Historia e ciklit të jetës së modelit nga krijimi deri në implementim do të tregojmë ndaras.
Sber.DS përbëhet nga disa komponente, kryesoret e të cilëve janë biblioteka, sistemi i zhvillimit dhe sistemi i ekzekutimit të modeleve.
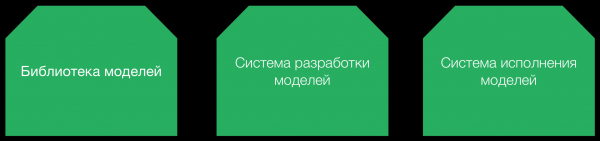
Biblioteka kontrollon ciklin e jetës së modelit nga momenti i shfaqjes së ideve për ta zhvilluar deri në implementimin në PROМ, vendosjen në monitorim dhe daljen nga punë. Shumë mundësi të bibliotekës janë të diktuara nga rregullat e rregullatorit, për shembull, raportimi dhe ruajtja e mostrave trajnimi dhe validimi. Në fakt, kjo është një regjistër i të gjithë modeleve tona.
Sistemi i zhvillimit është i destinuar për zhvillimin vizual të modeleve dhe metodologjive të validimit. Modelet e zhvilluara kalojnë një verifikim fillestar dhe dërgohen në sistemin e ekzekutimit për të përmbushur funksionet e tyre biznesore. Gjithashtu, në sistemin e ekzekutimit modeli mund të vendoset në monitor për qëllimin e aktivizimit periodik të metodologjive të validimit për kontrollin e funksionimit të tij.
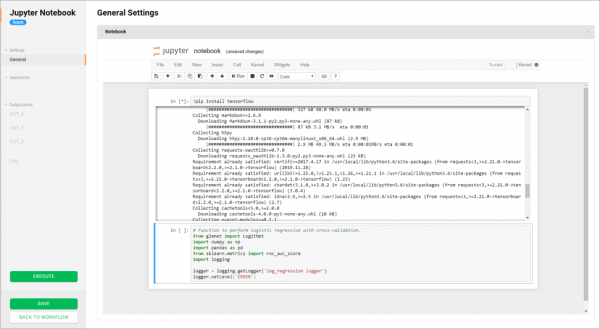
Systemi ka disa lloje nyjesh. Disa janë të destinuara për t'u lidhur me burime të ndryshme të dhënash, të tjerat - për të transformuar të dhënat origjinale dhe për t'i pasuruar ato (shënime). Ka shumë nyje për ndërtimin e modeleve të ndryshme dhe nyje për validimin e tyre. Zhvilluesi mund të ngarkojë të dhëna nga çdo burim, të transformojë, filtrojë, vizualizojë të dhënat ndërmjetëse dhe t'i ndajë ato në pjesë.
Po ashtu, platforma përmban module të gatshme, të cilat mund të tërhiqen në zonën e projektit. Të gjitha veprimet kryhen duke përdorur një ndërfaqe të vizualizuar. Faktikisht, mund të zgjidhni një problem pa shkruar asnjë rresht kodi.
Nëse mundësitë e ndërtuara nuk janë të mjaftueshme, sistemi ofron mundësinë për krijimin e shpejtë të moduleve të tij. Ne krijuam një mod ushtrimi të integruar mbi për ata që krijojnë module të reja "nga fillimi".
Arkitektura Sber.DS është ndërtuar mbi mikroshërbime. Ka shumë mendime se çfarë janë mikroshërbimet. Disa mendojnë se është e mjaftueshme të ndahen kodet monolitike në pjesë, por ata ende shkarkojnë të njëjtën bazë të dhënash. Tek ne, çdo mikroshërbim duhet të flasë me një mikroshërbim tjetër vetëm përmes REST API. Asnjë rrugë për të hyrë në bazën e të dhënave direkt.
Ne përpiqemi që shërbimet të mos bëhen shumë të mëdha dhe të ngadalta: një instancë nuk duhet të konsumojë më shumë se 4-8 gigabajt memorie të rastit dhe duhet të sigurojë mundësinë e shkallëzimit horizontal të kërkesave duke nisur instanca të reja. Çdo shërbim komunikon me të tjerët vetëm përmes REST API (). Ekipi përgjegjës për shërbimin është i detyruar të ruajë përputhshmërinë e prapme të API deri te klienti i fundit që e përdor atë.
Nuk i aplikacionit është shkruar në Java duke përdorur Spring Framework. Zgjidhja është projektuar fillimisht për një shpërndarje të shpejtë në infrastrukturën e re, kështu që aplikacioni është ndërtuar duke përdorur një sistem kontejnerizimi (). Platforma vazhdon të zhvillohet, si në aspektin e zgjerimit të funksionaliteteve të biznesit (shtohen lidhjet e reja, AutoML), ashtu edhe në aspektin e efikasitetit teknologjik.
Një nga «veçoritë» e platformës tonë është se mund të ekzekutojmë kodin e zhvilluar në ndërfaqen vizuale në çdo sistem ekzekutimi të modeleve të Sberbank. Tani kemi dy: një në Hadoop dhe tjetra në OpenShift (Docker). Ne nuk ndalojmë këtu dhe po krijojmë module integruese për të ekzekutuar kodin në çdo infrastrukturë, përfshirë on-premise dhe në cloud. Në aspektin e mundësive për t'u integruar efektivisht në ekosistemin e Sberbank, ne gjithashtu planifikojmë të mbështesim funksionimin me ambientet ekzistuese të ekzekutimit. Në të ardhmen, zgjidhja mund të integrohet fleksibël «nga kutia» në çdo peizazh të çdo organizate.
Ata që ndonjëherë kanë provuar të mbështesin një zgjidhje që ekzekuton Python në Hadoop në PROM, e dinë se është e pamjaftueshme të përgatitësh dhe dorosh një ambient përdoruesi të Python në çdo nod të dhënash. Një numër i madh bibliotekash C/C++ për mësimin e makinerive, që përdorin modulet Python, nuk do t'ju lejojnë të pushoni rehat. Nuk duhet të harrosh të përditësosh paketat gjatësisht kur shton biblioteka të reja ose serverë, duke ruajtur përputhshmërinë mbrapa me kodin e tashmë implementuar të modeleve.
Ka disa qasje në mënyrën se si ta bëjmë këtë. Për shembull, përgatituni paraprakisht disa biblioteka të përdorura shpesh dhe implementoni ato në PROM. Në distribucionin Hadoop nga Cloudera, zakonisht përdorin . Gjithashtu tani në Hadoop po shfaqet mundësia e ekzekutimit të -kontejnerëve. Në disa raste të thjeshta, mund të doroni kodin së bashku me paketën .
Banku qendror e merr shumë seriozisht sigurinë e ekzekutimit të kodit të jashtëm, prandaj ne përdorim maksimalisht mundësitë e reja të bërthamës Linux, ku procesit të ekzekutuar në një ambient izolues mund t'i kufizosh, për shembull, qasjen në rrjet dhe diskun lokal, duke reduktuar ndjeshëm mundësitë e kodit të dëmshëm. Zonat e të dhënave të çdo Departamenti janë të mbrojtura dhe të aksesueshme vetëm për pronarët e këtyre të dhënave. Platforma garanton se të dhënat nga një zonë mund të kalojnë në një zonë tjetër vetëm përmes një procesi publikimi të të dhënave me kontrollin në të gjitha fazat nga qasja në burimet deri në zbarkimin e të dhënave në vitrinën e synuar.
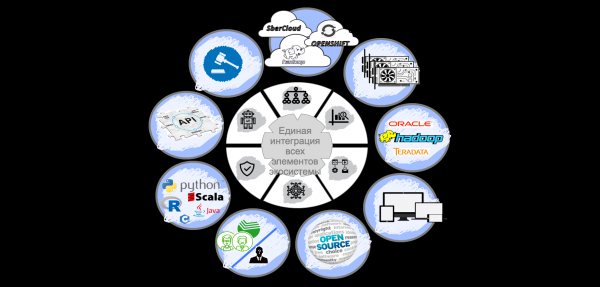
Këtë vit, ne planifikojmë të përfundojmë MVP-në e lançimit të modeleve, të shkruara në Python/R/Java në Hadoop. Kemi vendosur një objektiv ambicioz për të mësuar të ekzekutojmë çdo ambient përdoruesi në Hadoop, për të mos kufizuar përdoruesit e platformës sonë.
Për më tepër, siç është zbuluar, shumë specialistë të DS-së dinë shumë mirë matematikën dhe statistikën, krijojnë modele të shkëlqyera, por nuk janë shumë të njohur me transformimet e të dhënave të mëdha, dhe u nevojitet ndihma e inxhinierëve tanë të të dhënave për përgatitjen e mostrave të trajnimit. Ne vendosëm t'u ofrojmë kolegëve ndihmë dhe të krijojmë module të përshtatshme për transformimin dhe përgatitjen e veçorive për modelet mbi motorin Spark. Kjo do të lejojë që të kalojmë më shumë kohë në zhvillimin e modeleve dhe të mos presim, derisa inxhinierët e të dhënave të përgatisin datasetin e ri.
Në ekipin tonë punojnë njerëz me njohuri në fusha të ndryshme: Linux dhe DevOps, Hadoop dhe Spark, Java dhe Spring, Scala dhe Akka, OpenShift dhe Kubernetes. Në herën tjetër do të flasim për bibliotekën e modeleve, si kalon modeli në ciklin e jetës brenda kompanisë, si bëhet validimi dhe implementimi.
Burimi: habr.com
