

Kube-scheduler është një komponent thelbësor i Kubernetes, i cili është përgjegjës për planifikimin e pod-ëve në node në përputhje me politikat e caktuara. Shpesh, gjatë përdorimit të një klasteri Kubernetes, ne nuk duhet të mendojmë për politikat e veçanta që përcaktojnë si ndodhet planifikimi i pod-eve, pasi grupi i politikave të kube-scheduler të paracaktuar i përshtatet shumicës së detyrave të përditshme. Megjithatë, ndodhin situata kur është e rëndësishme të menaxhohet me kujdes procesi i shpërndarjes së pod-eve, dhe për kryerjen e kësaj detyre ka dy rrugë:
- Krijoni një kube-scheduler me një grup rregullash të personalizuara
- Shkruani një scheduler të veçantë dhe mësoni atë të punojë me kërkesat e API-serverit
Në këtë artikull, do të përshkruaj implementimin e pikës së parë për zgjidhjen e problemës së planifikimit të pabarabartë të pod-eve në një nga projektet tona.
Një hyrje e shkurtër mbi funksionimin e kube-scheduler
Duhet theksuar se kube-scheduler nuk është përgjegjës për planifikimin e drejtpërdrejtë të pod-eve — ai është përgjegjës vetëm për përcaktimin e nodës ku duhet të vendoset pod-i. Në terma të tjerë, rezultati i punës së kube-scheduler është emri i nodës që ai kthen në API-server kur kërkohet planifikimi dhe në këtë pikë përfundon puna e tij.
Fillimisht, kube-scheduler përgatit një listë nodash ku një pod mund të planifikohet në përputhje me politikat e predicates. Më pas, çdo nodë nga kjo listë merr një numër të caktuar pikësh në përputhje me politikat e priorites. Si rezultat, zgjidhet nodi që ka grumbulluar numrin maksimal të pikëve. Nëse ka nodash që kanë grumbulluar po aq pikë maksimale, zgjidhet njëra rastësisht. Me listën dhe përshkrimin e politikave të predicates (filtering) dhe priorites (scoring) mund të njiheni në .
Përshkrimi i problemës
Megjithëse kemi një numër të madh klasterësh të ndryshëm Kubernetes në mbikëqyrje në Nixys, për herë të parë u ballafaquam me problemin e planifikimit të pod-eve vetëm së fundmi, kur për një nga projektet tona u shfaq nevoja për të nisur një numër të madh detyrash periodike (~100 entitete CronJob). Për ta bërë sa më të thjeshtë përshkrimin e problemit, si shembull do të marrim një mikrosherbim, ku një detyrë cron startohet çdo minutë, duke krijuar disa ngarkesa në CPU. Për realizimin e detyrës cron janë ndarë tre nodë të përshtatshme që janë krejtësisht identike në karakteristika (24 vCPU në secilën).
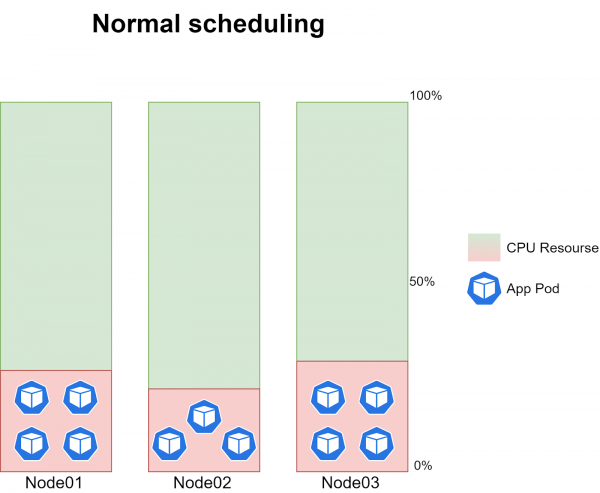
Megjithatë, nuk mund të thuhet me saktësi sa kohë do të marrë ekzekutimi i CronJob, pasi volumi i të dhënave hyrëse ndryshon vazhdimisht. Në mesatare, në funksionimin normal të kube-scheduler, në çdo nod funksionojnë 3-4 instance të punës, të cilat krijojnë ~20-30% ngarkesë në CPU të çdo node:
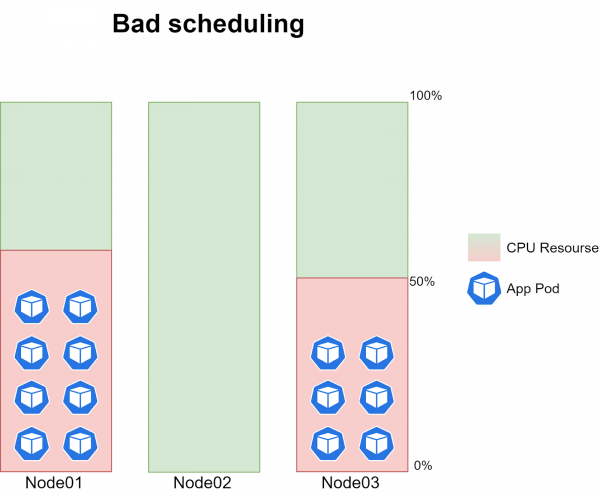
Problemi vetë është se ndonjëherë pod-et e detyrës cron ndalnin së planifikimi në një nga tre nodet. Do të thotë, në një moment të caktuar, në një nga nodet nuk planifikohej asnjë pod, ndërsa në dy nodet e tjera punonin nga 6-8 instance të punës duke krijuar ~40-60% ngarkesë në CPU:
Problemi përsëritej me një periodikë krejtësisht të rastësishme dhe herë pas here korrelohej me momentin e lëshimit të një versioni të ri të kodit.
Duke e rritur nivelin e regjistrimit të kube-scheduler në nivelin 10 (-v=10), filluam të regjistrojmë se sa pikë fitonte secili nga nodet gjatë procesit të vlerësimit. Në funksionimin normal të planifikimit, në regjistrat mund të shihnim informacionin e mëposhtëm:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 1387 millicores 4161694720 bytes memorie, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 1347 millicores 4444810240 bytes memorie, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 1387 millicores 4161694720 bytes memorie, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 1687 millicores 4790840320 bytes memorie, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 1347 millicores 4444810240 bytes memorie, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 1687 millicores 4790840320 bytes memorie, score 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node01 -> Score 100043
generic_scheduler.go:781] Host Node02 -> Score 100043
generic_scheduler.go:781] Host Node03 -> Score 100043
Pra ndaj, sipas informacionit të marrë nga log-et, secila nga nodet mori një numër të barabartë pikësh përfundimtare dhe për planifikimin u zgjodh rastësisht. Gjatë momentit të planifikimit problematik, log-et dukeshin si më poshtë:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 1587 millicores 4581125120 bytes memorie, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 1087 millicores 3532549120 bytes memorie, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 1587 millicores 4581125120 bytes memorie, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 987 millicores 3322833920 bytes memorie, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 987 millicores 3322833920 bytes memorie, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, capacity 23900 millicores 67167186944 bytes memorie, total request 1087 millicores 3532549120 bytes memorie, score 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node03 -> Score 100041
generic_scheduler.go:781] Host Node02 -> Score 100041
generic_scheduler.go:781] Host Node01 -> Score 100038
Nga të cilat dallohet se njëra nga nodet kishte grumbulluar më pak pikë totale se të tjerat, dhe për këtë arsye planifikimi u realizua vetëm për dy nodet që grumbulluan pikën maksimale. Kështu siguruan se problemi qëndronte pikërisht në planifikimin e pods.
Algoritmi i mëtejmë për zgjidhjen e problemit iu duk i qartë – të analizohej log-et, të kuptohej sipas cilit prioritet nodi nuk grumbulloi pikë dhe, nëse është e nevojshme, të korektoheshin politikat e kube-scheduler-it të paracaktuar. Megjithatë, këtu u përballëm me dy vështirësi të rëndësishme:
- Në nivelin maksimala të logimit (10) reflektohet një grumbull i pikave vetëm sipas disa prioriteteve. Në fragmentin e mësipërm të logëve, mund të vihet re se sipas të gjitha prioriteteve që reflektohen në log, nodet grumbullojnë të njëjtin numër pikash gjatë planifikimit normal dhe problematik, megjithatë rezultati final në rastin e planifikimit problematik ndryshon. Kështu, mund të arrihet përfundimi se sipas disa prioriteteve, llogaritja e pikëve ndodh “pas skenës”, dhe ne nuk kemi asnjë mundësi të kuptojmë sipas cilit prioritet nodi nuk grumbulloi pikë. Ky problem e kemi përshkruar në detaje në repozitore Kubernetes në Github. Në momentin që u shkrua artikulli, u mor përgjigje nga zhvilluesit se mbështetja për logimin do të shtohet në versionet e përmirësuara të Kubernetes v1.15, 1.16 dhe 1.17.
- Nuk ka mënyrë të thjeshtë për të kuptuar me cilin grup të saktë politikash aktualisht punon kube-scheduler. Po, në këtë listë është e përmendur, por nuk ka informacion se cilat saktësisht pesha janë vendosur për secilën nga politikat prioritet. Të shohësh pesha ose të redaktosh politikat e kube-scheduler-it të paracaktuar mund të bëhet vetëm në .
Duhet të theksohet se një herë na ka arritur të regjistrojmë se nodi nuk kishte grumbulluar pikë sipas politikës ImageLocalityPriority, e cila akordon pikë nodit nëse aty ka një imazh të nevojshëm për të nisur aplikacionin. Pra, në momentin e nxjerrjes së versionit të ri të aplikacionit, detyra cron përfundonte duke u nisur në dy nodet, duke nxjerrë një imazh të ri nga docker registry, dhe kështu dy nodet merrnin një rezultat përfundimtar më të madh në krahasim me të tretin.
Si e kam përmendur më parë, në log-e nuk shohim informacion rreth vlerësimit të politikës ImageLocalityPriority, kështu që për të verifikuar supozimin tonë, ne ngarkuam një imazh me versionin e ri të aplikacionit në nodën e tretë, pas së cilës planifikimi filloi të punojë saktë. Shkaku kryesor për problemin e planifikimit me politikën ImageLocalityPriority ishte i dukshëm vetëm në raste të rralla, shpesh ai lidhej me diçka tjetër. Duke qenë se nuk mundëm të debagojmë çdo politikë në listën e prioritetet e kube-scheduler, na nevojitej një menaxhim fleksibël për politikat e planifikimit të podëve.
Formulimi i detyrës
Ne donim që zgjidhja e problemit të ishte sa më e saktë, pra entitetet kryesore të Kubernetes (këtu kuptohet kube-scheduler-i default) duhet të mbesin të pandryshuara. Nuk doja të zgjidhja një problem në një vend dhe ta krijoja atë në një tjetër. Kështu, arritëm në dy opsione për zgjidhjen e problemit, të cilat u përmendën në hyrjen e artikullit — krijimi i një scheduler-i shtesë ose shkruajti një të tillë. Kërkesat kryesore për planifikimin e detyrave cron janë shpërndarja e barabartë e ngarkesës midis tre nodeve. Kjo kërkesë mund të përmbushet me politikat ekzistuese të kube-scheduler, prandaj për ta zgjidhur problemin tonë nuk ka kuptim të shkruajmë një scheduler të ri.
Udhëzimi për krijimin dhe Deployment e kube-scheduler-it shtesë përshkruhet në . Megjithatë, na dukej se entitetet e Deployment-it nuk ishin të mjaftueshme për të garantuar qëndrueshmërinë e një shërbimi kaq kritik si kube-scheduler, prandaj vendosëm të shkarkojmë një kube-scheduler të ri si Static Pod, për të cilin do të kujdesej direkt Kubelet. Kështu, ne kishim kërkesat e mëposhtme për kube-scheduler-in e ri:
- Shërbimi duhet të jetë i instaluar si Static Pod në të gjithë masterat e klasterit
- Duhet të parashikohet qëndrueshmëria në rast të papërshtatshmërisë së podit aktiv me kube-scheduler-in
- Prioriteti kryesor gjatë planifikimit duhet të jetë numri i burimeve të disponueshme në nodë (LeastRequestedPriority)
Realizimi i zgjidhjes
Duhet theksuar menjëherë se të gjitha punët do t'i realizojmë në Kubernetes v1.14.7, pasi kjo version ishte përdorur në projekt. Le të fillojmë me shkruan manifestin për kube-scheduler-in tonë të ri. Do të marrim si bazë manifestin e kube-scheduler-it default (\/etc\/kubernetes\/manifests\/kube-scheduler.yaml) dhe do ta sjellim atë në këtë formë:
lloji: Pod
metadata:
  etiketat:
    komponenti: scheduler
    niveli: control-plane
  emri: kube-scheduler-cron
  hapësira: kube-system
spec:
      kontejnerët:
      - urdhëri:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        imazhi: gcr.io/google-containers/kube-scheduler:v1.14.7
        politikaPërTëRrëfyer: IfNotPresent
        livenessProbe:
          thresholdiDështimit: 8
          httpGet:
            host: 127.0.0.1
            rruga: /healthz
            porta: 10151
            skema: HTTP
          vonesaFillestareSekonda: 15
          vonesaSekonda: 15
        emri: kube-scheduler-cron-container
        burimet:
          kërkesat:
            cpu: '0.1'
        ndërlidhjet:
        - rrugaEMontuar: /etc/kubernetes/scheduler.conf
          emri: kube-config
          vetëmLexim: true
        - rrugaEMontuar: /etc/localtime
          emri: localtime
          vetëmLexim: true
        - rrugaEMontuar: /etc/kubernetes/scheduler-custom.conf
          emri: scheduler-config
          vetëmLexim: true
        - rrugaEMontuar: /etc/kubernetes/scheduler-custom-policy-config.json
          emri: policy-config
          vetëmLexim: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumi:
      - hostPath:
          rruga: /etc/kubernetes/scheduler.conf
          lloji: FileOrCreate
        emri: kube-config
      - hostPath:
          rruga: /etc/localtime
        emri: localtime
      - hostPath:
          rruga: /etc/kubernetes/scheduler-custom.conf
          lloji: FileOrCreate
        emri: scheduler-config
      - hostPath:
          rruga: /etc/kubernetes/scheduler-custom-policy-config.json
          lloji: FileOrCreate
        emri: policy-config
Përmbledhje e ndryshimeve kryesore:
- Kemi ndryshuar emrin e pod-it dhe të kontejnerit në kube-scheduler-cron
- Specifikuam përdorimin e porteve 10151 dhe 10159 sepse është caktuar një opcion
hostNetwork: truedhe ne nuk mund të përdorim të njëjtat porte si kube-scheduler i paracaktuar (10251 dhe 10259) - Përmes parametrin —config specifikojmë skedarin e konfigurimit nga i cili duhet të niset shërbimi
- Konfiguruam montimin e skedarit të konfigurimit (scheduler-custom.conf) dhe skedarit të politikave të planifikimit (scheduler-custom-policy-config.json) nga hosti
Mos haroni se kube-scheduler ynë do të kërkojë të drejta, të ngjashme me ato të paracaktuar. Modifikojmë rolin e tij të grupit:
kubectl edit clusterrole system:kube-scheduler...
emratBurimeve:
- kube-scheduler
- kube-scheduler-cron
...Tani le të flasim për atë që duhet përmbajë skedari i konfigurimit dhe skedari me politikat e planifikimit:
- Skedari i konfigurimit (scheduler-custom.conf)
Për të marrë konfigurimin e kube-scheduler të paracaktuar, duhet të përdorim parametrin--write-config-tonga . Konfigurimin e marrë do ta vendosim në skedarin /etc/kubernetes/scheduler-custom.conf dhe do ta sjellim në formën e mëposhtme:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Përmbledhje e ndryshimeve kryesore:
- Kemi për sundimin e shërbimit tonë kube-scheduler-cron e kemi vendosur në schedulerName.
- Në parametrin
lockObjectNameduhet gjithashtu të vendosim emrin e shërbimit tonë dhe të sigurohemi që parametrileaderElecttë jetë vërtetuar në vlerën true (në rast se keni një master node, mund ta vendosni vlerën false). - Kemi specifikuar rrugën për skedarin me përshkrimin e politikave të planifikimit në parametrin
algorithmSource.
Duhet të përqendrohemi më shumë në pikën e dytë, ku redaktojmë parametrat për çelësin leaderElection. Për të siguruar qëndrueshmëri, aktivizuam (leaderElect) procesin e zgjedhjes së liderit (masterit) mes pod-ëve të kube-scheduler-it tonë duke përdorur një endpoint të përbashkët (resourceLock) me emrin kube-scheduler-cron (lockObjectName) në hapësirën e emrave kube-system (lockObjectNamespace). Më shumë rreth mënyrës si sigurohet disponueshmëria e lartë e komponenteve kryesore (përfshirë kube-scheduler) mund të gjeni në .
- Skedari i politikave të planifikimit (scheduler-custom-policy-config.json)
Siç kam shkruar më parë, për të mësuar se me cilat politika specifike punon kube-scheduler-i i paracaktuar mund të analizojmë vetëm kodin e tij. Pra, ne nuk mund ta marrim skedarin me politikat e planifikimit të kube-scheduler-it të paracaktuar ashtu si me skedarin e konfiguruar. Të përshkruajmë politikën që na intereson në skedarin /etc/kubernetes/scheduler-custom-policy-config.json si më poshtë:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Kështu, kube-scheduler fillimisht përgatit një listë nodash, në të cilat mund të planifikohet një pod sipas politikës GeneralPredicates (e cila përfshin një grup politikash si PodFitsResources, PodFitsHostPorts, HostName dhe MatchNodeSelector). Më pas, vlerësohet secila nodë sipas një grupi politikash në array-n prioriteteve. Për të plotësuar kushtet e detyrës sonë, ne arritëm në përfundimin se ky grup politikash do të ishte zgjidhja optimale. Ju kujtoj se grupi i politikave me përshkrimin e tyre të detajuar është i disponueshëm në . Për të përmbushur detyrën tuaj, thjesht mund të ndryshoni grupin e politikave të përdorura dhe t'i caktoni peshat përkatëse.
Manifesti i kube-scheduler të ri që krijuam në fillim të kapitullit, do ta quajmë kube-scheduler-custom.yaml dhe do ta vendosim në rrugën /etc/kubernetes/manifests në tre nodat master. Nëse gjithçka është kryer siç duhet, Kubelet në secilën nodë do të ngrisë pod-in, dhe në logët e kube-scheduler të ri do të shohim informacionin se skedari ynë me politikat është aplikuar me sukses:
Creating scheduler from configuration: {{ } [{GeneralPredicates } ] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } ] [] 10 false}
Registering predicate: GeneralPredicates
Predicate type GeneralPredicates already registered, reusing.
Registering priority: ServiceSpreadingPriority
Priority type ServiceSpreadingPriority already registered, reusing.
Registering priority: EqualPriority
Priority type EqualPriority already registered, reusing.
Registering priority: LeastRequestedPriority
Priority type LeastRequestedPriority already registered, reusing.
Registering priority: NodePreferAvoidPodsPriority
Priority type NodePreferAvoidPodsPriority already registered, reusing.
Registering priority: NodeAffinityPriority
Priority type NodeAffinityPriority already registered, reusing.
Creating scheduler with fit predicates 'map[GeneralPredicates:{}]' and priority functions 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Tani mbetet vetëm të specifikohet në spec-in e CronJob tonë se të gjitha kërkesat për planifikimin e pod-eve të saj duhet të përpunohen nga kube-scheduler-i ynë të ri:
-
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
-
Përfundim
Në fund, morëm një kube-scheduler shtesë me një grup unik politikash planifikimi, punën e të cilit e monitorson direkt kubelet. Për më tepër, ne konfiguruam zgjedhjen e një lideri të ri midis pod-eve të kube-scheduler-it tonë në rast se lideri i vjetër bëhet i paarritshëm për ndonjë arsye.
Aplikacionet dhe shërbimet e zakonshme vazhdojnë të planifikohen përmes kube-scheduler default, ndërsa të gjitha detyrat cron janë kaluar plotësisht në të riun. Ngarkesa që krijohet nga detyrat cron tani shpërndahet në mënyrë të barabartë në të gjitha nyjet. Duke marrë parasysh se pjesa më e madhe e detyrave cron ekzekutohen në të njëjtat nyje si aplikacionet kryesore të projektit, kjo ka lejuar të reduktohet ndjeshëm rreziku i lëvizjes së pods për shkak të mungesës së burimeve. Pas zbatimit të kube-scheduler të shtuar, problemet me planifikimin e pabarabartë të detyrave cron nuk kanë ndodhur më.
Lexoni gjithashtu artikuj të tjerë në blogun tonë:
Burimi: habr.com
