

Herë pas here na del nevoja për të gjetur të dhëna të lidhura me një grup çelësash, derisa të arrijmë shumën e duhur të regjistrimeve.
Një shembull më "jetësor" — të nxjerrim 20 detyra më të vjetra, që figurojnë në listën e punonjësve (për shembull, brenda një njësie). Tema të ngjashme janë të nevojshme shpesh për "dashboard" menaxherial me përmbledhje të shkurtra për seksionet e punës.
Në këtë artikull do të shqyrtojmë zbatimin në PostgreSQL të një versioni "naiv" të zgjidhjes së kësaj problemi, një algoritëm "më të zgjuar" dhe një algoritëm shumë më të komplikuar "cikli" në SQL me kusht daljeje nga të dhënat e gjetura, i cili mund të jetë i dobishëm si për zhvillim të përgjithshëm, ashtu edhe për përdorim në raste të tjera të ngjashme.
Të marrim një grup testues të të dhënave nga . Për të siguruar që regjistrimet e nxjerra nuk "kërcenin" nga njëra herë në tjetrën kur ndodhin vlerat e renditjes, do të zgjerojmë indeksin tematik duke shtuar çelësin kryesor. Kjo do t'i japë menjëherë atij unikatesë dhe do të garantojë qartësinë e renditjes:
CREATE INDEX ON task(owner_id, task_date, id);
-- dhe të vjetrin - ta heqim
DROP INDEX task_owner_id_task_date_idx;
Siç dëgjohet, ashtu edhe shkruhet
Së pari, do të bëjmë një variant shumë të thjeshtë të pyetjes, duke kaluar ID-të e ekzekutorëve :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 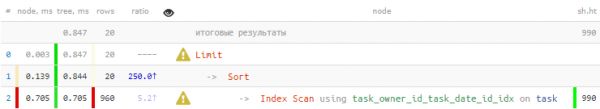
Pak pesëllog të trishtueshëm — por ne kërkuam vetëm 20 regjistrime, ndërsa Index Scan na ktheu 960 rreshta, që më pas duhej të ishin renditur… Le të përpiqemi të lexojmë më pak.
unnest + ARRAY
Këtu është një mendim i parë që do të na ndihmojë — nëse na duhen vetëm 20 regjistrime të renditura , është e mjaftueshme të lexojmë jo më shumë se 20 të renditura në të njëjtin radhë për çdo çelës. Fatmirësisht, indeksi i përshtatshëm (owner_id, task_date, id) e kemi.
Do të përdorim të njëjtin mekanizëm të nxjerrjes dhe "shndërrimit në kolona" të regjistrimit të plotë të tabelës, si dhe do të aplikojmë mbledhjen në array me anë të funksionit ARRAY() WITH T AS ( SELECT unnest(ARRAY( SELECT t FROM task t WHERE owner_id = unnest ORDER BY task_date, id LIMIT 20 -- e kufizojmë këtu... )) r FROM unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[]) ) SELECT (r).* FROM T ORDER BY (r).task_date, (r).id LIMIT 20; -- ... dhe këtu - gjithashtu:
O, tashmë shumë më mirë! 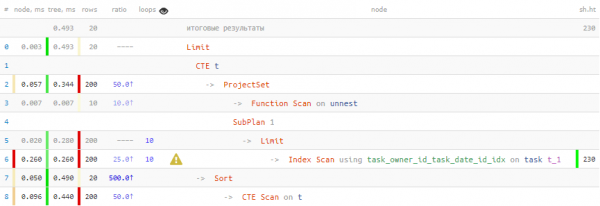
40% më shpejt, dhe 4.5 herë më pak të dhëna na duhej të lexonim. Materializimi i regjistrimeve të tabelave përmes CTE
Dua të vë në dukje senë disa raste në disa raste përpjekja për të punuar menjëherë me fushat e regjistrimit pas kërkimit të saj në nënkuptim, pa "mbështetje" në CTE mund të çojë në "shumimin" e InitPlan proporcionale me numrin e këtyre fushave:
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Rezultati (kostot=4.77..4.78 rreshta=1 gjerësi=16) (koha aktuale=0.063..0.063 rreshta=1 loops=1)
Buffers: hit i ndarë=16
InitPlan 1 (kthen $0)
-> Limit (kostot=0.42..1.19 rreshta=1 gjerësi=48) (koha aktuale=0.031..0.032 rreshta=1 loops=1)
Buffers: hit i ndarë=4
-> Skano indeksin duke përdorur task_owner_id_task_date_id_idx në task t (kostot=0.42..387.57 rreshta=500 gjerësi=48) (koha aktuale=0.030..0.030 rreshta=1 loops=1)
Kushti i indeksit: (owner_id = 1)
Buffers: hit i ndarë=4
InitPlan 2 (kthen $1)
-> Limit (kostot=0.42..1.19 rreshta=1 gjerësi=48) (koha aktuale=0.008..0.009 rreshta=1 loops=1)
Buffers: hit i ndarë=4
-> Skano indeksin duke përdorur task_owner_id_task_date_id_idx në task t_1 (kostot=0.42..387.57 rreshta=500 gjerësi=48) (koha aktuale=0.008..0.008 rreshta=1 loops=1)
Kushti i indeksit: (owner_id = 1)
Buffers: hit i ndarë=4
InitPlan 3 (kthen $2)
-> Limit (kostot=0.42..1.19 rreshta=1 gjerësi=48) (koha aktuale=0.008..0.008 rreshta=1 loops=1)
Buffers: hit i ndarë=4
-> Skano indeksin duke përdorur task_owner_id_task_date_id_idx në task t_2 (kostot=0.42..387.57 rreshta=500 gjerësi=48) (koha aktuale=0.008..0.008 rreshta=1 loops=1)
Kushti i indeksit: (owner_id = 1)
Buffers: hit i ndarë=4"
InitPlan 4 (kthen $3)
-> Limit (kostot=0.42..1.19 rreshta=1 gjerësi=48) (koha aktuale=0.009..0.009 rreshta=1 loops=1)
Buffers: hit i ndarë=4
-> Skano indeksin duke përdorur task_owner_id_task_date_id_idx në task t_3 (kostot=0.42..387.57 rreshta=500 gjerësi=48) (koha aktuale=0.009..0.009 rreshta=1 loops=1)
Kushti i indeksit: (owner_id = 1)
Buffers: hit i ndarë=4
E njëjta regjistrim "u kërkua" 4 herë... Deri në PostgreSQL 11, ky qëndrim ndodhte rregullisht, dhe zgjidhja është "mbështetja" në CTE, e cila është një kufi pa dyshim për optimizuesin në këto versione.
Akumulatori rekurziv
Në variantin e mëparshëm ne lexuam gjithsej 200 rreshta për shkak të 20 të nevojshme. Nuk është më 960, por akoma më pak — a është e mundur?
Le të përpiqemi të përdorim njohurinë se na duhen vetëm 20 regjistrime. Pra, do të iteronim leximin e të dhënave vetëm deri në arritjen e numurit të nevojshëm.
Hapi 1: lista fillestare
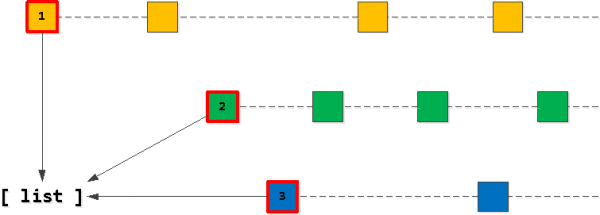
Në mënyrë të dukshme, lista jonë "e synuar" prej 20 regjistrimesh duhet të fillojë me "regjistrimet e para" sipas një nga çelësat tanë owner_id. Prandaj, së pari gjejmë të tilla "më të parat" për çdo një nga çelësat dhe i regjistrojmë në listë, duke e renditur atë në rendin që duam — (task_date, id).
Hapi 2: gjejmë regjistrimet "në vijim"
Tani, nëse të marim regjistrimin e parë nga lista jonë dhe të fillojmë "të ecim" më tej përmes indeksit duke ruajtur çelësin owner_id, atëherë të gjitha regjistrimet e gjetura janë pikërisht ato të ardhshme në përzgjedhjen përfundimtare. Sigurisht, vetëm deri sa nuk e kalojmë çelësin aplikativ pjesa e dytë në listë.
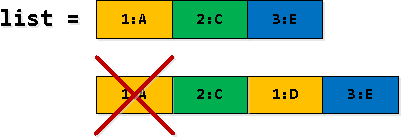
Nëse ndodhi që ne "kalojmë" të dytën në listë, atëherë pjesa e fundit e lexuar duhet të shtohet në listë në vend të të parës (me të njëjtin owner_id), pas së cilës lista rindarjet përsëri.
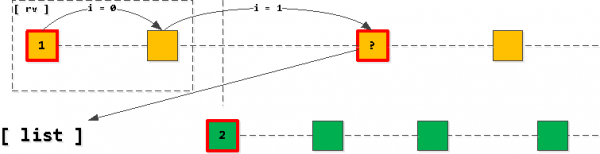
Që do të thotë se gjithmonë kemi një maksimum prej një shënimi për çdo çelës në listë (nëse shenjat përfundojnë, dhe nuk e "kalojmë", atëherë shënimi i parë thjesht do të largohet dhe nuk do të shtohet asgjë), duke qenë se ato janë gjithmonë të renditura në rendin në rritje të çelësit aplikativ (task_date, id).
Hapi 3: filtrojmë dhe "zhvillojmë" shënime
Në disa rreshta të seleksionimit tonë rekurziv, disa shënime rv janë të përsëritura - fillimisht gjejmë ato si "kalimin e kufirit të shënimit të dytë të listës", dhe pastaj i vendosim si të parën në listë. Kështu që e para që shfaqet duhet të filtrohet.
Kërkesa përfundimtare dramatike
ME RECURSIFF T AS (
  -- #1 : përfshijmë në listë "të parat" regjistrime për secilin nga çelësat e grupit
  ME wrap AS ( -- "materializojmë" regjistrimet, në mënyrë që të qasja në fushat të mos shkaktojë shumëfishim InitPlan/SubPlan
    ME T AS (
      ZGJEDH
        (
          ZGJEDH
            r
          NGA
            task r
          KU
            owner_id = unnest
          RENDIT NGA
            task_date, id
          LIMIT 1
        ) r
      NGA
        unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
    )
    ZGJEDH
      array_agg(r RENDIT NGA (r).task_date, (r).id) list -- rendisim i listës në rendin e duhur
    NGA
      T
  )
  ZGJEDH
    list
  , list[1] rv
  , FALSE not_cross
  , 0 size
  NGA
    wrap
UNION ALL
  -- #2 : lexojmë regjistrimet e çelësit të parë radhazi, për sa kohë nuk kalojmë përtej regjistrimit të dytë
  ZGJEDH
    RASTI
      -- nëse nuk është gjetur asgjë për çelësin e regjistrimit të parë
      KUR X._r IS NOT DISTINCT FROM NULL PASTAJ
        T.list[2:] -- e heqim atë nga lista
      -- nëse NE NUK KEMI kaluar çelësin aplikues të regjistrimit të dytë
      KUR X.not_cross THEN
        T.list -- thjesht e vazhdojmë të njëjtën listë pa modifikime
      -- nëse në listë tashmë nuk ka regjistrim të dytë
      KUR T.list[2] IS NULL THEN
        -- thjesht kthejmë listë të zbrazët
        '{}'
      -- riorganizojmë fjalorin, duke hequr regjistrimin e parë dhe duke shtuar të fundit që është gjetur
      ELISE (
        ZGJEDH
          coalesce(T.list[2] || array_agg(r RENDIT NGA (r).task_date, (r).id), '{}')
        NGA
          unnest(T.list[3:] || X._r) r
      )
    FUND
  , X._r
  , X.not_cross
  , T.size + X.not_cross::integer
  NGA
    T
  , LATERAL(
      ME wrap AS ( -- "materializojmë" regjistrimin
        ZGJEDH
          RASTI
            -- nëse megjithatë "kalojmë" përmes regjistrimit të dytë
            KUR NOT T.not_cross
              -- atëherë regjistrimi i nevojshëm - i pari në listë
              ATËHERË T.list[1]
            ELISE ( -- nëse nuk kaluam, çelësi ka mbetur si në regjistrimin e mëparshëm - mbështetemi në atë
              ZGJEDH
                _r
              NGA
                task _r
              KU
                owner_id = (rv).owner_id AND
                (task_date, id) > ((rv).task_date, (rv).id)
              RENDIT NGA
                task_date, id
              LIMIT 1
            )
          FUND _r
      )
      ZGJEDH
        _r
      , RASTI
          -- nëse regjistrimi i dytë tashmë nuk është në listë, por ne kemi gjetur diçka
          KUR list[2] IS NULL AND _r IS DISTINCT FROM NULL THEN
            TRUE
          ELISE -- nuk gjetëm asgjë ose "kaluam"
            coalesce(((_r).task_date, (_r).id) < ((list[2]).task_date, (list[2]).id), FALSE)
        FUND not_cross
      NGA
        wrap
    ) X
  KU
    T.size < 20 AND -- e kufizojmë këtu numrin
    T.list IS DISTINCT FROM '{}' -- ose përsa kohë lista nuk ka mbaruar
)
-- #3 : "zhvendosim" regjistrimet - rendi është i garantuar nga ndërtimi
ZGJEDH
  (rv).* -- nënkuptojmë të gjitha fushat nga regjistrimi
NGA
  T
KU
not_cross; -- marrim vetëm regjistrimet "jo të kaluara" 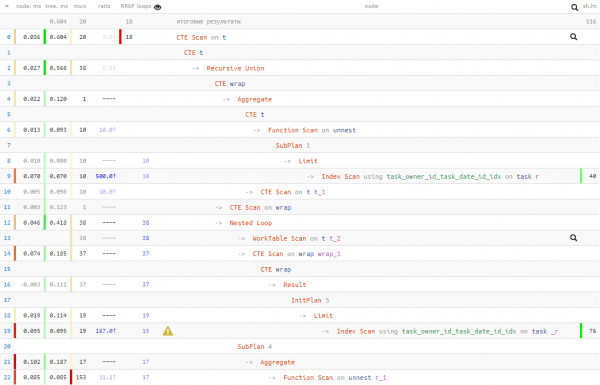
Si rezultat, ne këmbyem 50% të leximet të dhënash për 20% të kohës së ekzekutimitPra ndaj, nëse keni arsye për të besuar se leximi mund të zgjasë, (për shembull, të dhënat shpesh nuk janë në cache dhe duhet të kërkohen në disk), atëherë kështu mund të mbështeteni më pak në lexim.
Sidoqoftë, koha e ekzekutimit doli më e mirë se në versionin e parë "naiv". Por se cilin nga këto 3 versione të përdorni — është zgjedhja juaj.
Burimi: habr.com
