

Megjithëse tani ka shumë të dhëna pothuajse kudo, bazat e të dhënave analitike ende janë mjaft ekzotike. Ato njihen pak dhe përdoren edhe më keq në mënyrë efikase. Shumë vazhdojnë të "hanë kaktusin" me MySQL ose PostgreSQL, të cilat janë projektuar për skenare të tjera, të vuajnë me NoSQL ose të paguajnë shumë për zgjidhje komerciale. ClickHouse e ndryshon lojën dhe e ul ndjeshëm pragun e hyrjes në botën e DBMS analitik.
Raporti nga BackEnd Conf 2018 dhe ai është botuar me lejen e referuesit.
Kush jam unë dhe pse po flas për ClickHouse? Unë jam drejtori i zhvillimit në kompaninë LifeStreet, e cila përdor ClickHouse. Përveç kësaj, unë jam themeluesi i Altinity. Kjo është një partner i Yandex, që promovon ClickHouse dhe ndihmon Yandex-in ta bëjë ClickHouse më të suksesshëm. Gjithashtu, jam i gatshëm të ndaj njohuritë mbi ClickHouse.
Dhe akoma nuk jam vëllai i Petës Zaitsev. Shpesh më pyesin për këtë. Jo, ne nuk jemi vëllezër.
«E gjithë bota e di», që ClickHouse:
- Shumë i shpejtë,
- Shumë i përshtatshëm,
- Përdoret në Yandex.
Pak më pak e njohur është se në cilat kompani dhe si përdoret.
Do t'ju tregoj për çfarë, ku dhe si përdoret ClickHouse, përveç Yandex.
Do t'ju tregoj si zgjidhen detyrat konkrete me ndihmën e ClickHouse në kompani të ndryshme, cilat mjete të ClickHouse mund të përdorni për detyrat tuaja dhe si janë përdorur në kompani të ndryshme.
Kam përzgjedhur tre shembuj që tregojnë ClickHouse nga ana të ndryshme. Mendoj se do të jetë interesante.
Pyetja e parë: «Përse nevojitet ClickHouse?». Duket si një pyetje e zakonshme, por përgjigjet për të janë më shumë se një.
- Përgjigja e parë – për shkak të performancës. ClickHouse është shumë i shpejtë. Analizat në ClickHouse gjithashtu janë shumë të shpejta. Ai shpesh mund të përdoret atje ku diçka tjetër funksionon shumë ngadalë ose shumë keq.
- Përgjigja e dytë – është costoja. Dhe në radhë të parë, costoja e shkallëzimit. Për shembull, Vertica është një bazë të dhënash krejt e shkëlqyer. Ajo punon shumë mirë, nëse keni më shumë se disa terabajtë të dhënash. Por kur bëhet fjalë për qindra terabajtësh ose petabajtë, atëherë kostoja e licencës dhe mbështetjes arrin në një shumë të konsiderueshme. Dhe kjo është e shtrenjtë. Ndërsa ClickHouse është falas.
- Përgjigjja e tretë është kostoja operacionale. Ky është një qasje pak nga një këndvështrim tjetër. RedShift është një alternativë e shkëlqyer. Në RedShift mund të realizoni një zgjidhje shumë shpejt. Ajo do të funksionojë mirë, por çdo orë, çdo ditë dhe çdo muaj do të paguani mjaft shtrenjtë Amazon, pasi është një shërbim shumë i kushtueshëm. Google BigQuery gjithashtu. Nëse dikush e ka përdorur, ai e di se atje mund të nisni disa kërkesa dhe të merrni faturë për qindra dollarë papritur.
Në ClickHouse nuk ka këto probleme.
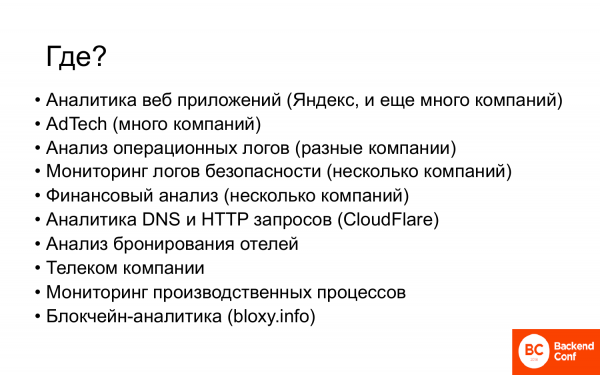
Ku përdoret tani ClickHouse? Përveç Yandex, ClickHouse përdoret në shumë biznese dhe kompani të ndryshme.
- Këtu përfshihet kryesisht analizimi i aplikacioneve web, pra është një rast përdorimi që ka ardhur nga Yandex.
- Shumë kompani AdTech përdorin ClickHouse.
- Shumë kompani që kanë nevojë të analizojnë logjet operative nga burime të ndryshme.
- Disa kompani përdorin ClickHouse për monitorimin e logjeve të sigurisë. Ato i ngarkojnë në ClickHouse, bëjnë raporte, marrin rezultate që u nevojiten.
- Kompanitë fillojnë ta përdorin në analizën financiare, pra për pak kohë, bizneset e mëdha po i afrohen gjithashtu ClickHouse.
- CloudFlare. Nëse dikush ndjek ClickHouse, sigurisht ka dëgjuar emrin e kësaj kompanie. Është një nga kontribuesit e dukshëm nga komuniteti. Dhe ata kanë një instalim të rëndësishëm të ClickHouse. Për shembull, ata krijuan Kafka Engine për ClickHouse.
- Kompani telekomunikacionesh kanë filluar ta përdorin. Disa kompani e përdorin ClickHouse ose si një provë koncepti, ose tashmë në prodhim.
- Një kompani përdor ClickHouse për monitorimin e proceseve prodhuese. Ata testojnë çipa, regjistrojnë një sërë parametrash, rreth 2,000 karakteristika. Dhe më pas analizojnë – a është një ngarkesë e mirë apo një ngarkesë e keqe.
- Analitika e blockchain. Ka një kompani ruse si Bloxy.info. Kjo është analiza e rrjetit ethereum. Këtë e bënë gjithashtu në ClickHouse.
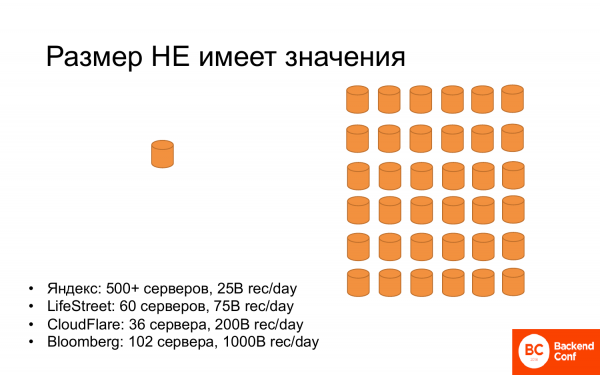
Për më tepër, madhësia nuk ka rëndësi. Ka shumë kompani që përdorin një server të vogël. Dhe ai u lejon të zgjidhin problemet e tyre. Dhe gjithashtu, më shumë kompani përdorin klastere të mëdha me shumë serverësh apo dhjetëra servera.
Dhe nëse shikoni rekordet, atëherë:
- Yandex: 500+ servera, 25 miliardë regjistrime në ditë i ruajnë atje.
- LifeStreet: 60 servera, rreth 75 miliardë regjistrime në ditë. Më pak servera, më shumë regjistrime se në Yandex.
- CloudFlare: 36 servera, ata ruajn 200 miliardë shënimesh në ditë. Ata kanë edhe më pak servera dhe ruajnë edhe më shumë të dhëna.
- Bloomberg: 102 serverë, rreth një trilion shënimesh në ditë. Rekordmeni në regjistrime.
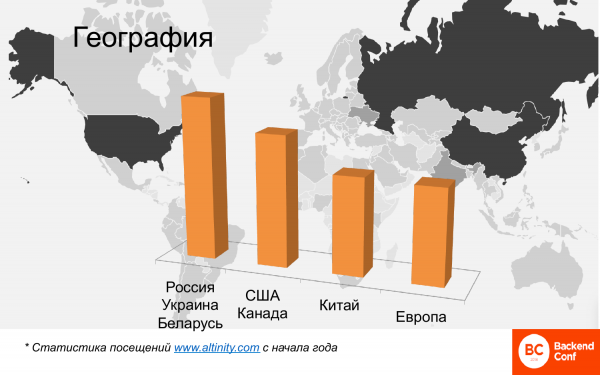
Gjeografikisht – kjo është gjithashtu shumë. Ky hartë tregon heatmap, ku ClickHouse përdoret në botë. Këtu përfaqësohet me ngjyra Rusi, Kinë, Amerikë. Ka shumë pak vende evropiane. Mund të identifikohen 4 klasterë.
Ky është një analizë krahasuese, këtu nuk duhet të kërkoni shifra absolute. Ky është analiza e vizitorëve që lexojnë materiale në anglisht në faqen e Altinity, sepse nuk ka material në rusisht aty. Dhe Rusia, Ukraina, Bjellorusia, pra pjesa rusisht-folëse e komunitetit, janë përdoruesit më të shumtë. Pas tyre vijnë SHBA dhe Kanada. Kina po e ndjek nga pas shumë fort. Para gjashtë muajve Kina pothuajse nuk ishte aty, tani Kina ka kaluar Evropën dhe vazhdon të rritet. Vjetërja Evropë gjithashtu nuk mbetet prapa, madje lideri i përdorimit të ClickHouse është, siç duket, Franca.
Pse po e tregoj gjith këtë? Për të treguar se ClickHouse po bëhet zgjidhja standarde për analizën e të dhënave të mëdha dhe tashmë përdoret shumë vende. Nëse e përdorni, jeni në trendin e duhur. Nëse nuk e keni përdorur ende, mund të mos keni frikë se do të mbeteni të vetmuar dhe askush nuk do t'ju ndihmojë, sepse tashmë shumë njerëz po e përdorin këtë.
Këto janë shembuj konkretë të përdorimit të ClickHouse në disa kompani.
- Shembulli i parë – është një rrjet reklamash: migrimi nga Vertica në ClickHouse. Dhe unë njoh disa kompani që kanë kaluar nga Vertica ose janë në procesin e kalimit.
- Shembulli i dytë – hapësira transaksionale në ClickHouse. Ky është një shembull që është ndërtuar mbi antipaterns. Të gjitha, çka nuk duhet bërë në ClickHouse sipas këshillave të zhvilluesve, këtu është bërë. Dhe megjithatë është bërë kaq efektivisht, sa që funksionon. Dhe funksionon shumë më mirë se një zgjidhje tipike transaksionale.
- Shembulli i tretë – janë llogaritë e shpërndara në ClickHouse. Kishte një pyetje se si mund të integrohet ClickHouse në ekosistemin Hadoop. Do të tregoj një shembull, si një kompani bëri në ClickHouse diçka si një analog të containerit map reduce, duke i ndjekur lokalizimet e të dhënave etj., për të llogaritur një detyrë shumë jo triviale.
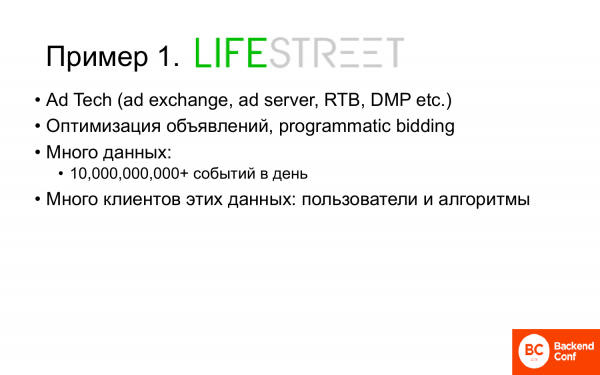
- LifeStreet – është një kompani Ad Tech, e cila ka të gjitha teknologjitë e nevojshme për një rrjet reklamash.
- Ajo merret me optimizimin e reklama, programmatic bidding.
- Shumë të dhëna: rreth 10 miliard ngjarjesh në ditë. Gjithashtu, ngjarjet mund të përfshijnë disa nën-ngjarje.
- Shumë klientë kanë nevojë për këto të dhëna, dhe kjo nuk janë vetëm njerëz, por shumë më tepër – janë algoritme të ndryshme që merren me programimin e ofertave.
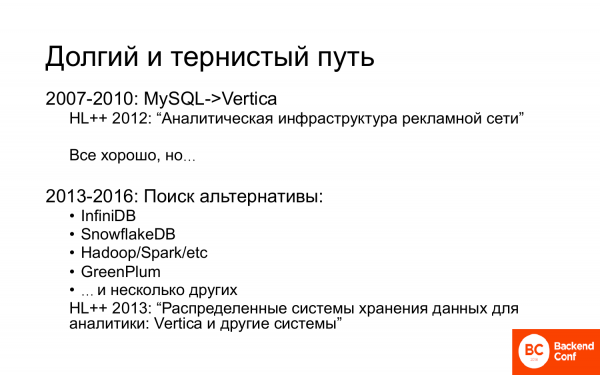
Kompania ka kaluar një rrugë të gjatë dhe të vështirë. E kam folur për këtë në HighLoad. Fillimisht, LifeStreet kaloi nga MySQL (me një ndalesë të vogël në Oracle) te Vertica. Mund të gjeni edhe tregimin për këtë.
Dhe gjithçka shkoi shumë mirë, por shpejt u kuptua se të dhënat po rriteshin dhe Vertica është e shtrenjtë. Prandaj, ishim në kërkim të alternativave të ndryshme. Disa prej tyre janë përmendur këtu. Në fakt, ne bëmë prova koncepti ose ndonjëherë teste performancës për pothuajse të gjitha sistemet e bazës së të dhënave që ishin në treg nga viti 2013 deri në vitin 2016 dhe që ishin të përshtatshme për funksionalitetin. Disa prej tyre i kam folur gjithashtu në HighLoad.
Ishte e nevojshme të migronim nga Vertica përparësisht, sepse të dhënat po rriteshin. Dhe ato rriteshin eksponencial për disa vite. Më pas arritën në një nivel, por sidoqoftë. Duke parashikuar këtë rritje dhe kërkesat e biznesit për sasinë e të dhënave për të cilat nevojitej të kryhej ndonjë analizë, ishte e qartë se së shpejti do të flasim për petabajtë. Dhe për petabajtë, është shumë e shtrenjtë të paguash, prandaj po kërkonim një alternativë për të kaluar.
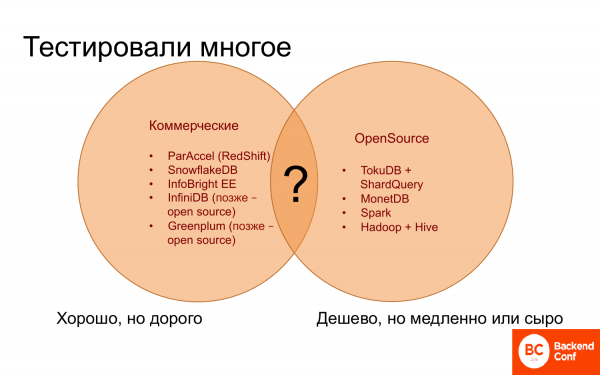
Ku të shkojmë? Dhe për një kohë të gjatë nuk ishte e qartë se ku të shkonim, sepse nga njëra anë ekzistojnë sistemet e bazës së të dhënave komerciale, të cilat duket se funksionojnë mirë. Disa funksionojnë pothuajse aq mirë sa Vertica, disa më keq. Por të gjitha janë të shtrenjta, nuk arritëm të gjenim asgjë më të lirë dhe më të mirë.
Nga ana tjetër, ekzistojnë zgjidhje open source, të cilat nuk janë shumë, pra, për analizë, mund t’i numërosh me gishta. Ato janë falas ose të lira, por funksionojnë ngadalë. Dhe shpesh u mungon funksionaliteti i nevojshëm dhe të dobishëm.
Dhe kështu, nuk kishte asgjë që të kombininte atë që është e mirë në sistemet komerciale të bazës së të dhënave dhe gjithçka që është falas në open source.
Nuk kishte asgjë derisa papritur Yandex e nxori, si një krimb nga një kapelë magjistari, ClickHouse. Dhe kjo ishte një zgjidhje e papritur, ende pyetet: "Pse?", por sidoqoftë.
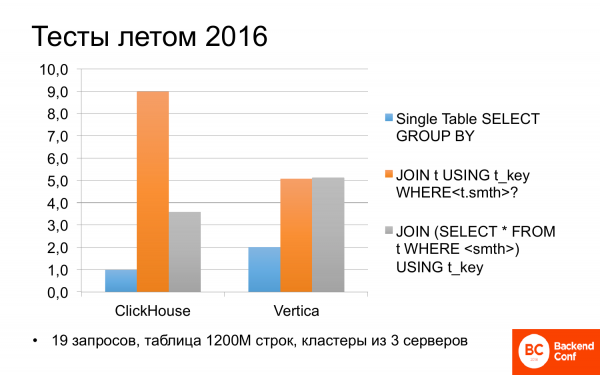
Dhe në verën e vitit 2016, filluam të shqyrtojmë se çfarë është ClickHouse. Dhe rezultoi se ndonjëherë ai mund të jetë më i shpejtë se Vertica. Testuam skenarë të ndryshëm në kërkesa të ndryshme. Dhe nëse kërkesa përdorte vetëm një tabelë, dmth pa ndonjë bashkim (join), atëherë ClickHouse ishte dy herë më i shpejtë se Vertica.
Nuk u lodha dhe shqyrtova gjithashtu testet e Yandex-it para disa ditësh. Aty është e njëjta gjë: ClickHouse është dy herë më i shpejtë se Vertica, prandaj ata shpesh flasin për këtë.
Por nëse kërkesat kanë bashkime (join), atëherë gjithçka bëhet e paqartë. Dhe ClickHouse mund të jetë më i ngadaltë se Vertica deri në dy herë. Por nëse pak e ndryshojmë kërkesën dhe e riformulojmë, atëherë ato janë afërsisht të barabarta. Jo keq. Dhe falas.
Dhe duke marrë rezultatet e testeve dhe duke e parë nga këndvështrime të ndryshme, LifeStreet kaloi në ClickHouse.
Kjo është viti 2016, më kujtohet. Ishte si në anekdotën për miu, të cilët qanë dhe u gërvishtën, por vazhduan të hanë kaktus. Dhe për këtë është folur në detaje, ka video për këtë, etj.
Prandaj nuk do të flas në detaje për këtë, do të flas vetëm për rezultatet dhe mbi disa gjëra interesante që nuk kam treguar atëherë.
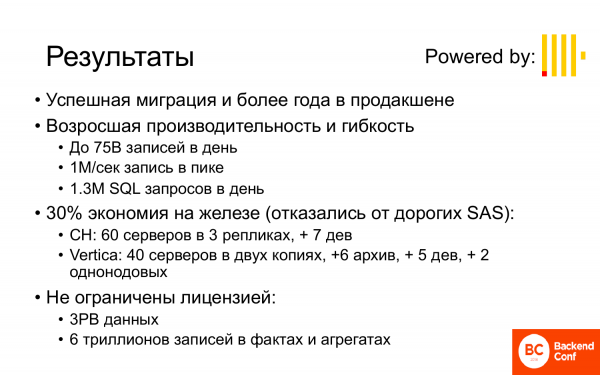
Rezultatet janë:
- Migrimi i suksesshëm dhe sistemi tashmë funksionon në prodhim për më shumë se një vit.
- Performanca dhe fleksibiliteti janë rritur. Nga 10 miliardë regjistrime, që mund të lejonim të ruheshin për një ditë dhe për një kohë të shkurtër, tani LifeStreet ruan 75 miliardë regjistrime në ditë dhe mund ta bëjë këtë për 3 muaj e më shumë. Në kulm, kjo është deri në një milion ngjarje në sekondë që ruhen. Më shumë se një milion SQL-kërkesa në ditë vijnë në këtë sistem, kryesisht nga robotë të ndryshëm.
- Pavarësisht se për ClickHouse filluan të përdoren më shumë serverë se për Vertica, kursimi ndodhi edhe në metal, sepse në Vertica ishin përdorur disqe SAS mjaft të shtrenjta. Në ClickHouse ishin përdorur SATA. Pse? Sepse në Vertica, inserti është sinkron. Dhe sinkronizimi kërkon që disqet të mos ngadalësohen shumë, si dhe që rrjeti të mos ngadalësohet, dmth, një operacion mjaft i shtrenjtë. Ndërsa në ClickHouse, inserti është asinkron. Për më tepër, gjithmonë mund të shkruani gjithçka lokal, nuk ka shpenzime shtesë për këtë, prandaj të dhënat në ClickHouse mund të futen shumë më shpejt se në Vertica, edhe në disqe që nuk janë nga më të shpejtit. Ndërsa në lexim, ato janë afërsisht të njëjta. Leximi në SATA, nëse ato janë në RAID, atëherë gjithçka është mjaft e shpejtë.
- Nuk ka kufizime për licencën, dmth 3 petabayta të dhënash në 60 serverë (20 serverë janë një replikë) dhe 6 trilion të dhëna në fakte dhe agregatë. Asgjë e tillë nuk mund të lejohej në Vertica.
Tani po kaloj në gjërat praktike në këtë shembull.
- E para është një skemë efikase. Shumë gjëra varen nga skema.
- E dyta është gjenerimi i SQL efikas.
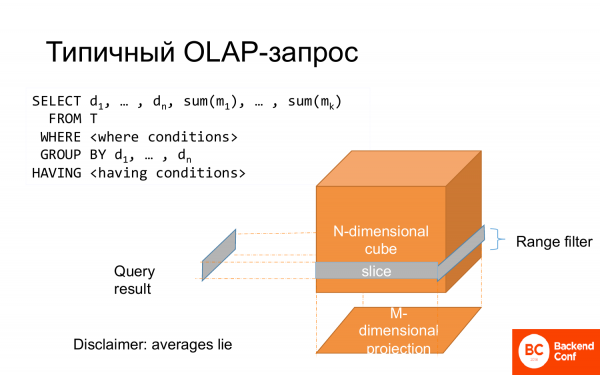
Një pyetje tipike OLAP është një select. Një pjesë e koloneve shkon në group by, një pjesë e koloneve shkon në funksionet agregate. Ka një where, të cilën mund ta përfaqësojmë si një prerje kubi. E gjithë group by mund të përfaqësohet si një projektim. Dhe prandaj kjo quhet analizë shumëdimensionale e të dhënave.
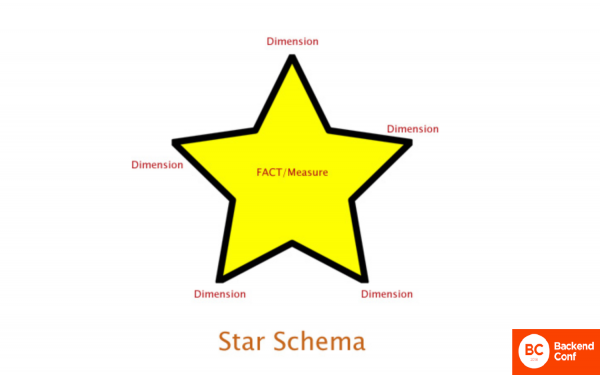
Dhe shpesh kjo modelizohet në formën e një skeme star, kur ka një fakt qendror dhe karakteristikat e këtij fakti në anët, në rrethe.
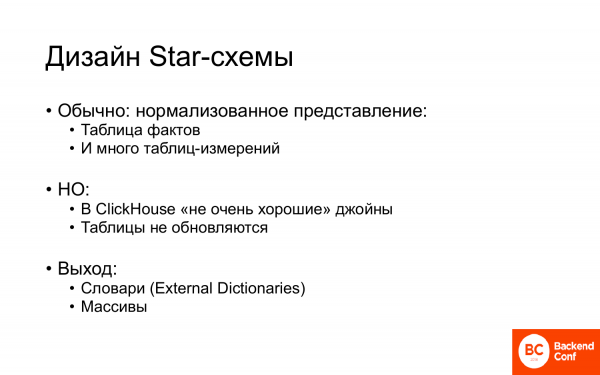
Dhe nga pikëpamja e dizajnit fizik, se si bazohet në tabelë, zakonisht bëhet një paraqitje e normalizuar. Mund ta denormalizoni, por kjo është e shtrenjtë për disku dhe nuk është shumë efikase për kërkesat. Prandaj zakonisht bëhet një paraqitje e normalizuar, dmth një tabelë fakti dhe shumë shumë tabela masash.
Por në ClickHouse kjo funksionon keq. Ka dy arsye:
- E para është sepse në ClickHouse nuk ka gjëra të mira për bashkim (join), dmth ka bashkime (join), por ato janë të këqija. Me sa duket, ende të këqija.
- E dyta është që tabelat nuk përditësohen. Zakonisht në këto tabela, që janë rreth skemës star, duhet të ndryshohet diçka. Për shembull, emri i klientit, emri i kompanisë dhe të tjera. Dhe kjo nuk funksionon.
Dhe ka një zgjidhje për këtë në ClickHouse. madje dy të plota:
- E para është përdorimi i fjalorëve. Fjalët e Jashtme – janë ato që ndihmojnë të zgjidhin 99% të problemit me skemën star, me përditësimet dhe të tjera.
- E dyta është përdorimi i masivëve. Masivët gjithashtu ndihmojnë të heqin dorë nga bashkimet (join) dhe nga problemet e normalizimit.
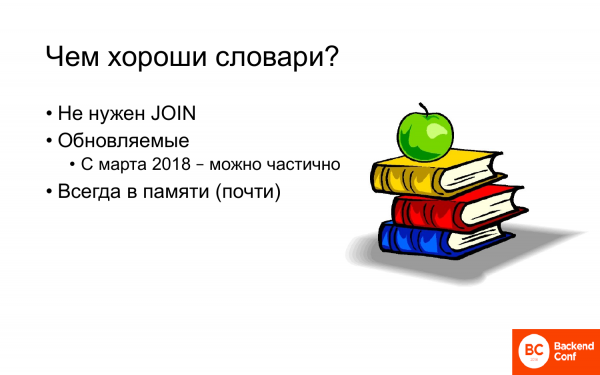
- Nuk nevojitet bashkim (join).
- Të përditësueshme. Që nga marsi i vitit 2018 u shfaq një mundësi e pa dokumentuar (në dokumentacion nuk do ta gjeni këtë) për të përditësuar pjesërisht fjalorët, dmth ato të dhëna që janë ndërruar. Praktikisht, kjo është si një tabelë.
- Gjithmonë në memorje, prandaj bashkimet (join) me fjalorin punojnë më shpejt sesa, nëse do të ishte një tabelë që ndodhet në disk dhe nuk është fakt që është në cache, me siguri që jo.
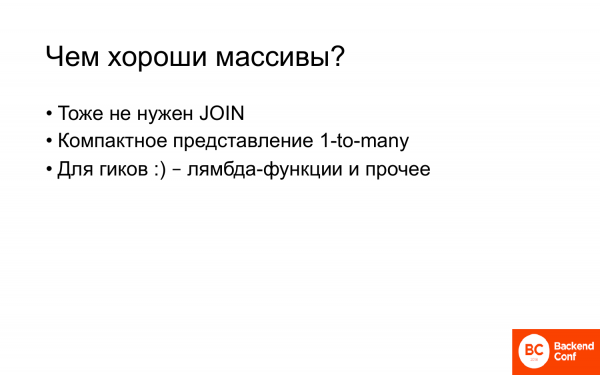
- Asnjëherë nuk nevojitet bashkim (join).
- Kjo është një paraqitje kompakte 1 me shumë.
- Dhe në mendimin tim, masivët janë bërë për gjerë. Këto janë funksionet lambda dhe të tjera.
Kjo nuk është për të bërë show. Kjo është një funksionalitet shumë i fuqishëm që lejon të bëni shumë gjëra shumë thjesht dhe me elegancë.
Shembuj tipikë që ndihmojnë në zgjidhjen e masave. Këta shembuj janë të thjeshtë dhe mjaft ilustrues:
- Kërkimi sipas etiketave. Nëse keni hashtag dhe dëshironi të gjeni disa shënime sipas hashtagut.
- Kërkimi sipas çifteve key-value. Igjithashtu ka disa atribute me vlera.
- Ruajtja e listave të çelësave që duhet t'i përktheni në diçka tjetër.
Të gjitha këto detyra mund të zgjidhen pa masa. Etiketat mund të vendosen në një rresht dhe të zgjidhen me një shprehje të rregullt ose në një tabelë të veçantë, por atëherë do t'ju duhet të bëni bashkime (join).
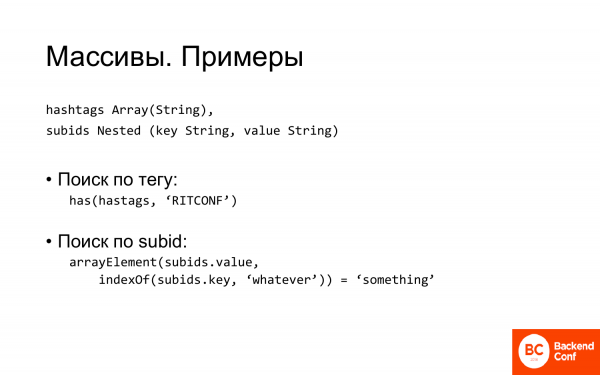
Në ClickHouse nuk keni nevojë të bëni asgjë, është mjaft të përshkruani një masë string për hashtag-et ose të bëni një strukturë të thellë për sisteme të tipit key-value.
Struktura e thellë – ndoshta nuk është emri më i mirë. Këto janë dy masa që kanë një pjesë të përbashkët në emër dhe disa karakteristika të lidhura.
Dhe të kërkosh sipas etiketës është shumë e thjeshtë. Ka një funksion ka, i cili kontrollon se a ka një element në masë. Të gjitha, e gjetëm të gjitha shënimet që i përkasin konferencës tonë.
Kërkimi sipas subid është pak mëNdërmjetës ndërsa duhet të gjejmë fillimisht indeksin e çelësit, dhe pastaj të marim elementin me atë indeks dhe të kontrollojmë nëse vlera është ajo që na nevojitet. Por gjithsesi, është shumë e thjeshtë dhe kompakte.
Shprehja e rregullt, që do të dëshironit të shkruani, nëse do ta mbanit gjithçka në një rresht, do të ishte, së pari, e çuditshme. Dhe, së dyti, do të funksiononte shumë më gjatë se dy masa.
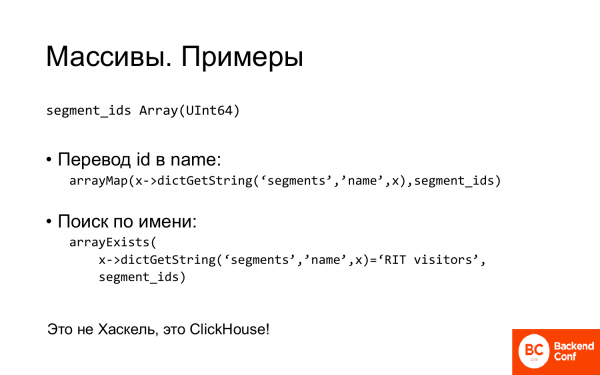
Një shembull tjetër. Keni një masë ku ruani ID-të. Dhe mund t'i përktheni ato në emra. Funksioni arrayMap. Kjo është një funksion tipik lambda. Ju e kaloni atje shprehjen lambda. Dhe ajo nxjerr vlerën e emrit për çdo ID nga fjalori.
Gjithashtu mund të bëni kërkimin. Kaloni një funksion predikat, i cili kontrollon se çfarë i përgjigjen elementet.
Këto gjëra thjeshtojnë ndjeshëm skemën dhe zgjidhin shumë probleme.
Por problemi tjetër, me të cilin ishim ballafaquar dhe për të cilin do doja të flisja, janë kërkesat efikase.
- Në ClickHouse nuk ka planifikues të kërkesave. Në përgjithësi, nuk ka.
- Por megjithatë kërkesat e komplikuara duhet të planifikohen. Në cilat raste?
- Nëse kërkesa ka disa bashkime (join), të cilat i mbuloni me nënkërkesa. Dhe renditja në të cilën ato ekzekutohen ka rëndësi.
- Dhe e dyta është nëse kërkesa është e distribuar. Sepse në kërkesat e distribuuara vetëm nënkërkesa më e brendshme ekzekutohet në mënyrë distribuar, ndërsa të gjitha të tjera kalojnë në një server të vetëm, me të cilin jeni lidhur dhe ekzekutohen atje. Pra, nëse keni kërkesa të distribuuara me shumë bashkime (join), duhet të zgjidhni rendin.
Edhe në raste më të thjeshta ndonjëherë duhet të kryeni punën e planifikuesit dhe të rishkruani pak kërkesat.
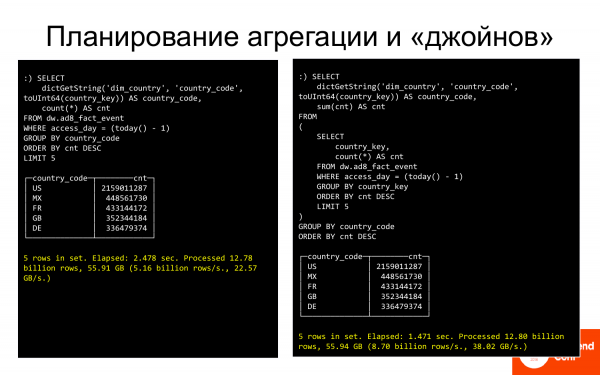
Ja një shembull. Në pjesën e majtë, kërkesa që tregon 5 vendet më të mira. Dhe ai ekzekutohet për 2.5 sekonda, mendoj. Ndërsa në pjesën e djathtë është e njëjta kërkesë, por e rishkruar pak. Ne, në vend që të grupojmë sipas rreshtit, filluam të grupojmë sipas çelësit (int). Dhe kjo është më e shpejtë. Pastaj, i lidhëm rezultatet me një fjalor. Në vend të 2.5 sekondave, kërkesa ekzekutohet për 1.5 sekonda. Kjo është e mirë.
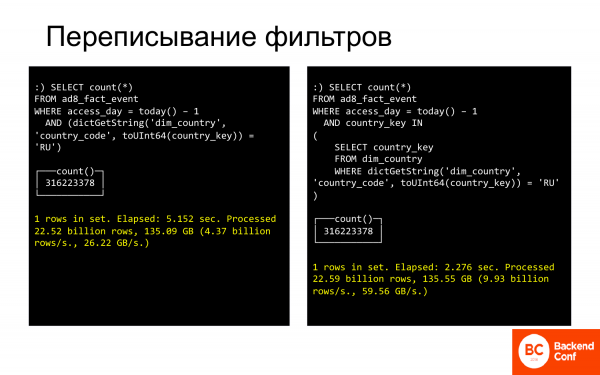
Një shembull i ngjashëm me rishkrimin e filtrave. Këtu është një kërkesë për Rusi. Ajo ekzekutohet për 5 sekonda. Nëse e rishkruajmë në një mënyrë që të krahasojmë përsëri, jo rreshtin, por numrat me një grup të atyre çelësave që përkasin për Rusinë, atëherë kjo do të jetë shumë më e shpejtë.
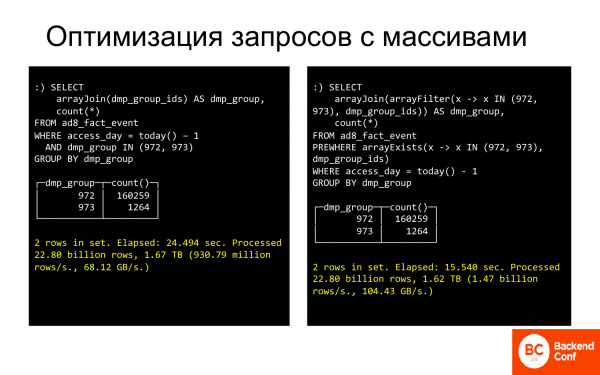
Ka shumë truke të tilla. Dhe ato lejojnë të përshpejtojnë ndjeshëm kërkesat që ju duket se funksionojnë tashmë shpejt, ose, përkundrazi, funksionojnë ngadalë. Ato mund të bëhen edhe më të shpejta.
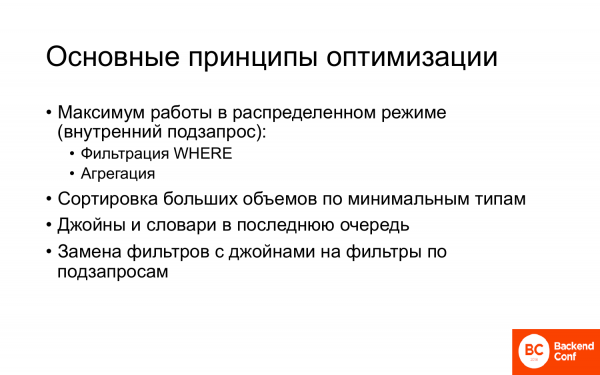
- Maksimumi i punës në mënyrë distribuar.
- Renditja sipas llojeve minimale, siç e kam bërë për int.
- Nëse ka ndonjë bashkim (join), fjalorë, është më mirë të bëhen në fund të fundit, kur keni të dhëna së paku pjesërisht të grupuara, atëherë operacioni i bashkimit (join) ose thirrja e fjalorit do të kërkohet më pak herë dhe do të jetë më e shpejtë.
- Zëvendësimi i filtrave.
Ka edhe teknika të tjera, dhe jo vetëm ato që unë demonstrova. Të gjitha ato ndonjëherë lejojnë të përshpejtojnë ndjeshëm ekzekutimin e kërkesave.
Të kalojmë në shembullin tjetër. Kompania X nga SHBA. Çfarë bën ajo?
Ishte një detyrë:
- Lidhja offline e transaksioneve të reklamave.
- Modelimi i modeleve të ndryshme të lidhjes.
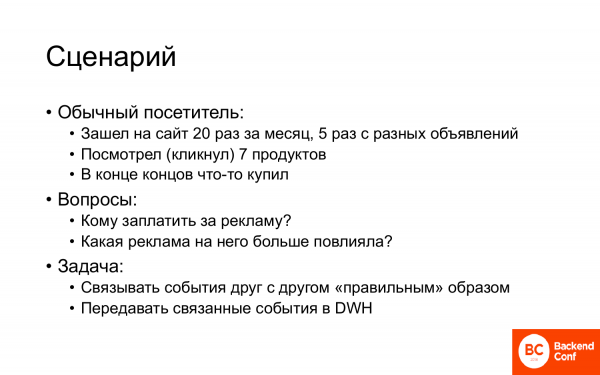
Çfarë përfshin skenari?
Një vizitor i zakonshëm hyn në faqen e internetit, për shembull, 20 herë në muaj nga reklama të ndryshme ose ndonjëherë thjesht vjen pa ndonjë reklamë, sepse e mban mend këtë faqe. Ai shikon disa produkte, i vendos ato në shportë, i heq ato nga shporta dhe, në fund, diçka blen.
Pyetje të arsyeshme: "Kë duhet të paguaj për reklamën, nëse duhet?" dhe "Cila reklamë e ndikoi, nëse e ndikoi?" Domethënë, pse e bleu dhe si ta bëjmë që njerëz të ngjashëm me këtë person të blejnë gjithashtu?
Për të zgjidhur këtë detyrë, është e nevojshme të lidhim ngjarjet që ndodhin në faqen e internetit në mënyrën e duhur, domethënë, të krijojmë një lidhje ndërmjet tyre. Pastaj, t'i dërgojmë ato për analizë në DWH. Dhe mbi bazën e kësaj analize të ndërtosh modele se kujt dhe cilën reklamë duhet të shfaqësh.
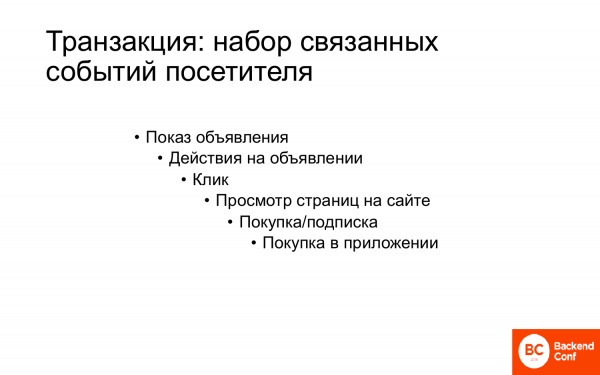
Transaksioni reklamor është një grup ngjarjesh të lidhura me përdoruesin, që fillon nga shfaqja e reklamës, pastaj ndodh diçka, dhe ndoshta blerja, e më pas mund të ndodhin blerje brenda blerjes. Për shembull, nëse është një aplikacion mobil ose një lojë mobile, instalimi i aplikacionit nganjëherë është falas, dhe nëse bëhet diçka më tutje, atëherë mund të nevojiten para. Dhe sa më shumë një person të shpenzojë në aplikacion, aq më i vlefshëm është. Por për këtë, duhet t'i lidhim të gjitha.
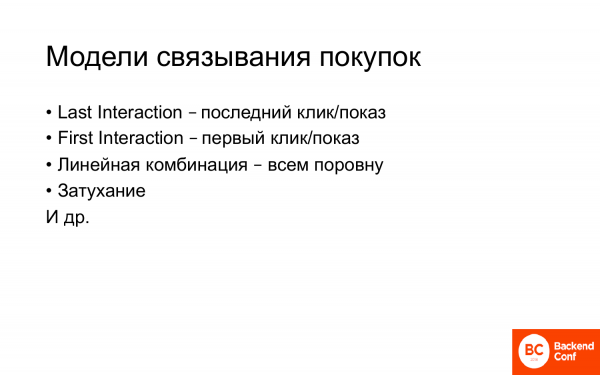
Ka shumë modele lidhjeje.
Modelet më të njohura janë:
- Interaksioni i fundit, ku interaksioni është ose klikimi, ose shfaqja.
- Interaksioni i parë, domethënë, e para që e çoi njeriun në faqe.
- Kombinimi linear – të gjithë për njësoj.
- Zgjatja.
- Dhe të tjera.
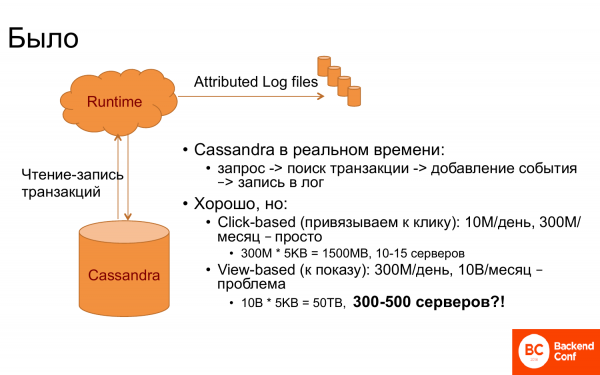
Dhe si funksiononte gjithçka fillimisht? Kishim Runtime dhe Cassandra. Cassandra përdorej si ruajtje transaksionesh, domethënë, aty ruheshin të gjitha transaksionet e lidhura. Dhe kur ndodhte një ngjarje në Runtime, për shembull, shfaqja e ndonjë faqeje ose ndonjë gjë tjetër, bëhej një kërkesë në Cassandra – a është ky person apo jo. Pastaj nxirreshin transaksionet që bëheshin lidhur me të dhe lidhej.
Dhe nëse kishte fat që në kërkesë të ishte id e transaksionit, atëherë ishte e lehtë. Por zakonisht nuk ka fat. Prandaj, duhej të gjehej transaksioni i fundit ose transaksioni me klikimin e fundit etj.
Dhe kjo ka funksionuar shumë mirë, derisa lidhi me klikimin e fundit. Sepse kishte, le të themi, 10 milion klikime në ditë, 300 milion në muaj, nëse vendosim një dritare mujor. Dhe duke qenë se në Cassandra gjithçka duhet të jetë në kujtesë për të funksionuar shpejt, sepse Runtime kërkon të përgjigjet shpejt, ne kishte nevojë për rreth 10-15 servera.
Por kur deshën të lidhnin transaksionin me shfaqjen, menjëherë nuk doli ashtu siç pritej. Pse? Është e dukshme se duhet ruajtur 30 herë më shumë ngjarje. Dhe, për pasojë, duhen gjithashtu 30 herë më shumë servera. Dhe rezulton se kjo është një shifër astronomike. Të mbash deri në 500 servera për të bërë këtë lidhje, ndërsa në Runtime ka ndjeshëm më pak servera, kjo është një shifër e papërshtatshme. Dhe filluan të mendojnë, çfarë të bëjnë.
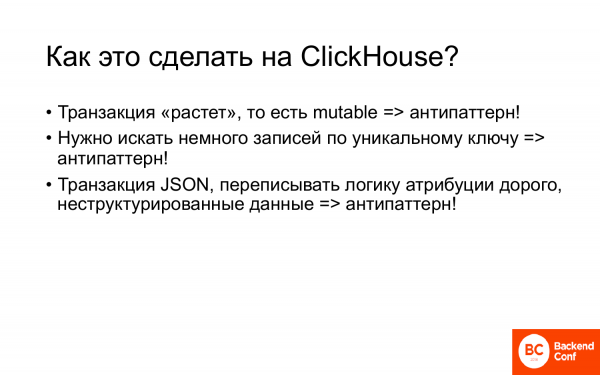
Dhe dolën te ClickHouse. Si mund të veprohet me ClickHouse? Në shikim të parë duket si një grup antipatish.
- Transaksioni rritet, ne i lidhen gjithnjë e më shumë ngjarje, dmth. është mutable, ndërsa ClickHouse nuk punon shumë mirë me objekte mutable.
- Kur na vjen një vizitor, ne duhet të nxjerrim transaksionet e tij sipas çelësit, sipas visit id. Kjo gjithashtu është një kërkesë point, në ClickHouse nuk bëhet kështu. Zakonisht në ClickHouse ka skane të mëdha, ndërsa këtu na nevojitet të nxjerrim disa regjistra. Kjo është po ashtu një antipat.
- Për më tepër, transaksioni ishte në json, por nuk donin ta riletronin, kështu që donin të ruanin json të pa strukturuar, dhe nëse ishte e nevojshme, të nxirrnin diçka nga ai. Edhe kjo është një antipat.
Dmth. një grup antipatish.
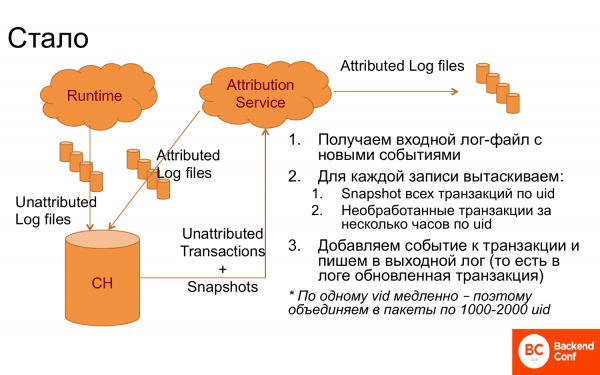
Megjithatë, arritën të krijonin një sistem që funksiononte shumë mirë.
Çfarë u bë? U shfaq ClickHouse, në të cilin u hodhën logjet, të ndara në regjistra. U shfaq një shërbim atribues, i cili merrte logjet nga ClickHouse. Pas kësaj, për çdo regjistër sipas visit id merrte transaksionet, të cilat mund të ishin ende të pa përpunuara, dhe plus snapshotet, dmth. transaksionet tashmë të lidhura, e saktësisht rezultati i punës së mëparshme. Nga ato përgatit logjikën, zgjidhte transaksionin e duhur, lidhen ngjarje të reja. Sërish e regjistronte në log. Logu shkonte sërish në ClickHouse, dmth. kjo është një sistem vazhdimisht ciklik. Dhe për më tepër, shkonte në DWH për ta analizuar atje.
Në këtë formë, kjo nuk funksiononte shumë mirë. Dhe që ClickHouse të kishte më lehtësi, kur bëhej kërkesa për id vizite, ato kërkesa grupoheshin në blloqe prej 1,000 deri në 2,000 id vizite dhe për 1,000-2,000 njerëz nxirrnin të gjitha transaksionet. Dhe atëherë gjithçka funksionoi.
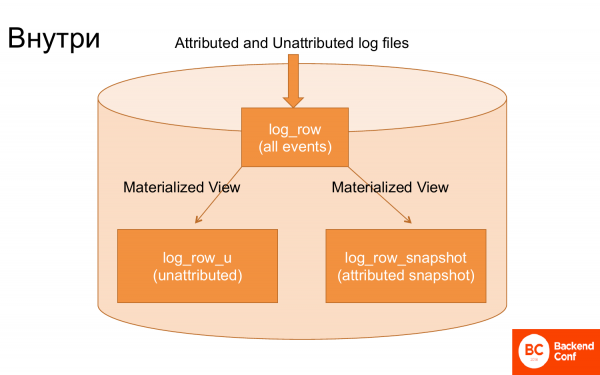
Nëse shikoni brenda ClickHouse, ka vetëm 3 tabela kryesore që e shërbejnë këtë.
Tabela e parë, ku ngarkohen log-et, ngarkohet pothuajse pa përpunim.
Tabela e dytë. Përmes materialized view, këto log-e përmbajnë ngjarje që ende nuk janë atribuuar, dmth, të pa lidhura. Dhe përmes materialized view nxirreshin transaksionet për ndërtimin e snapshot-it. Dmth, një materialized view ndihmon në ndërtimin e snapshot-it, konkretisht gjendja më e fundit e grumbulluar e transaksionit.
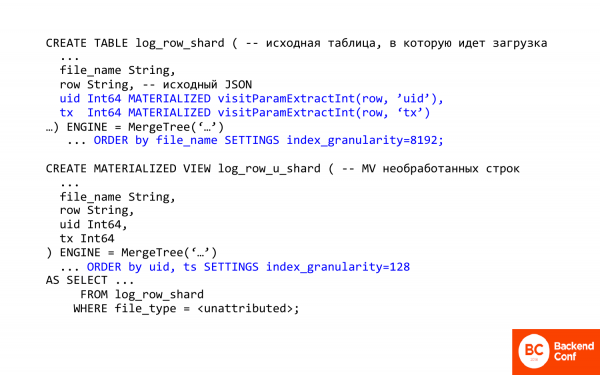
Këtu është shkruar një tekst në SQL. Do doja të komentoj disa gjëra të rëndësishme në të.
Gjëja e parë e rëndësishme është mundësia në ClickHouse për të nxjerrë kolona nga json, pra, në ClickHouse ka disa metoda për të punuar me json. Ato janë shumë, shumë primitive.
visitParamExtractInt lejon nxjerrjen e atributeve nga json, dmth, hera e parë kur ndodh aktivizohet. Dhe kështu mund të nxirren id transaksioni ose id vizite. Kjo është një.
E dyta - këtu është përdorur një fushë materialized e mençur. Çfarë do të thotë kjo? Kjo do të thotë se nuk mund ta vendosni në tabelë, dmth, nuk futet, por llogaritet dhe ruhet gjatë vendosjes. Gjatë vendosjes, ClickHouse bën punën për ju. Dhe tashmë nxirret nga json ajo që do t'ju nevojitet më vonë.
Në këtë rast, materialized view është për rreshtat e pa përpunuara. Dhe përdoret tabela e parë me log-et praktikisht të papërpunuara. Çfarë bën? Së pari, ndryshon renditjen, dmth, renditja tani bëhet sipas id vizite, sepse na nevojitet të nxjerrim shpejt transaksionin e një personi të caktuar.
Gjëja tjetër e rëndësishme është index_granularity. Nëse keni parë MergeTree, zakonisht në mënyrë parazgjedhëse është 8,192 për index_granularity. Çfarë është kjo? Ky është parametri i hollësive të indeksit. Në ClickHouse indeksi është i hollë, ai kurrë nuk indekson çdo regjistrim. E bën këtë çdo 8,192. Dhe kjo është mirë kur nevojiten shumë të dhëna për të bërë llogaritje, por e keqe kur është pak, sepse ka shumë overhead. Dhe nëse e uleni index granularity, atëherë ne e ulim overhead-in. Nuk mund ta uleni në 1, sepse mund të mos ketë mjaft memorie. Indeksi ruhet gjithmonë në memorie.
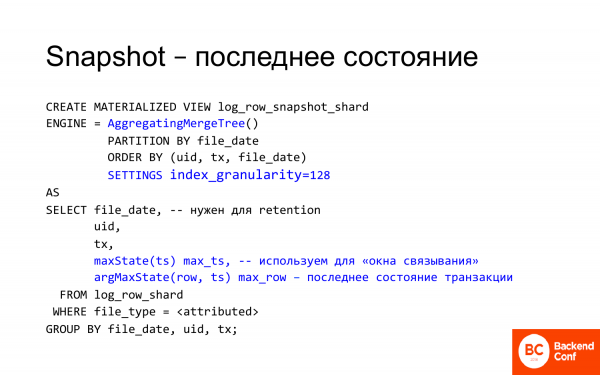
Dhe snapshoti përdor disa funksione interesante të tjera të ClickHouse.
Së pari, është AggregatingMergeTree. Në AggregatingMergeTree ruhet argMax, që do të thotë se ky është gjendja e transaksionit që përputhet me timestamp-in e fundit. Transaksionet gjithnjë e më të reja gjenerohen për këtë vizitor. Dhe në gjendjen më të fundit të këtij transaksioni ne shtuam një ngjarje dhe fituam një gjendje të re. Ajo sërish u fut në ClickHouse. Dhe nëpërmjet argMax në këtë prezantim të materializuar ne gjithmonë mund të marrim gjendjen aktuale.
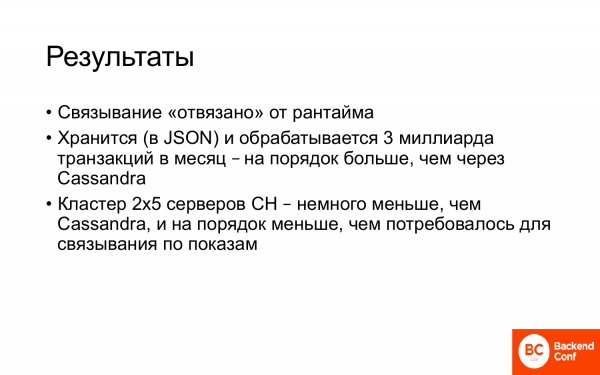
- Lidhja "keqkuptohet" nga Runtime.
- Ruhet dhe përpunohet deri në 3 miliardë transaksione në muaj. Ky është një rend tjetër më shumë se çfarë ishte në Cassandra, do të thotë në një sistem tipik transaksionesh.
- Klusteri i 2x5 serverëve ClickHouse. 5 serverë dhe çdo server ka një replikë. Kjo është edhe më pak se çfarë kishte në Cassandra për të realizuar atribucionin e bazuar në klikim, dhe këtu kemi atribucion të bazuar në impresion. Do të thotë, në vend që të rritet numri i serverëve 30 herë, ata arritën t'i zvogëlojnë.
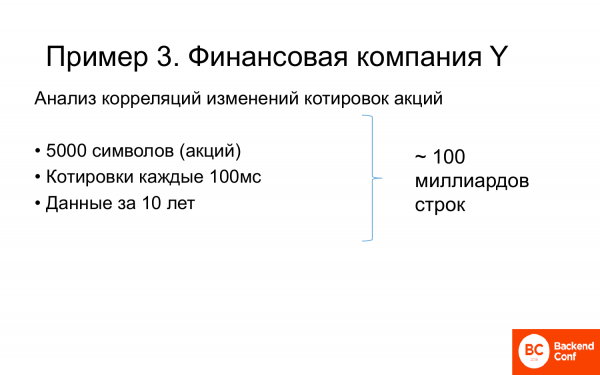
Dhe shembulli i fundit është kompania financiare Y, e cila analizonte korrelacionet e ndryshimeve të çmimeve të aksioneve.
Dhe detyra ishte si vijon:
- Ka rreth 5,000 aksione.
- Çmimet janë të njohura çdo 100 milisekonda.
- Të dhënat janë grumbulluar për 10 vjet. Duket se për disa kompani më shumë, për disa më pak.
- Në total ka rreth 100 miliardë rreshta.
Dhe duhej të llogaritej korrelacioni i ndryshimeve.
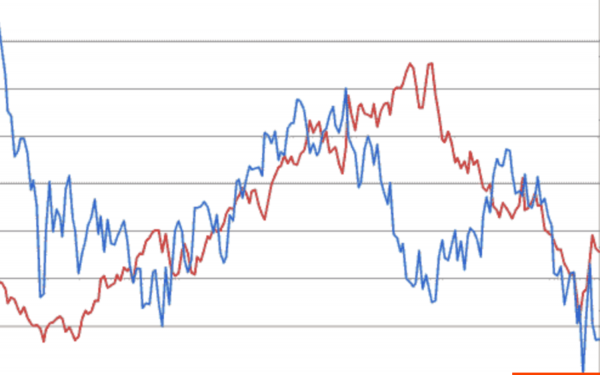
Këtu ka dy aksione dhe çmimet e tyre. Nëse njëra shkon lart, dhe tjetra shkon lart, atëherë kjo është një korrelacion pozitiv, do të thotë njëra rritet dhe tjetra rritet. Nëse njëra shkon lart, si në fund të grafikët, dhe tjetra poshtë, atëherë kjo është një korrelacion negativ, do të thotë kur njëra rritet, tjetra bie.
Duke analizuar këto ndryshime reciproke mund të bëhen parashikime në tregun financiar.
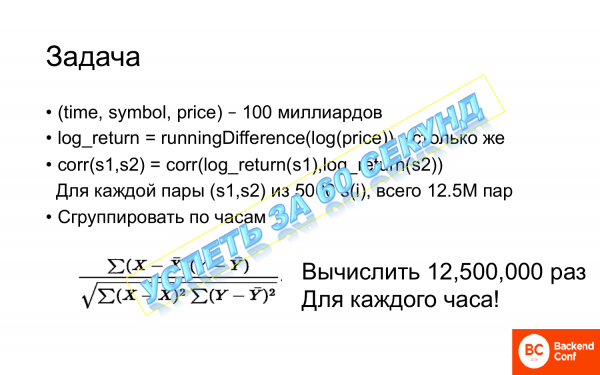
Por detyra është e vështirë. Çfarë bëhet për këtë? Ne kemi 100 miliardë të dhëna, ku kemi: kohë, aksion dhe çmim. Na nevojitet të llogarisim fillimisht 100 miliardë herë runningDifference të algoritmit të çmimit. RunningDifference është një funksion në ClickHouse që llogarit diferencën midis dy rreshtave në mënyrë të vazhdueshme.
Dhe pas kësaj duhet llogaritur korrelacioni, dhe duhet llogaritur korrelacioni për çdo çift. Për 5,000 aksione kemi 12.5 milion çifte. Dhe kjo është shumë, do të thotë 12.5 herë duhet të llogaritet një funksion të tillë korrelacioni.
Dhe nëse dikush e ka harruar, ͞x dhe ͞y – janë pritet matimore për mostrat. Pra, duhet të llogaritni jo vetëm rrënjët dhe shumat, por gjithashtu brenda këtyre shumave edhe një herë shumat e tjera. Duhet të kryhen shumë kalkulime 12.5 milion herë, dhe gjithashtu duhet të grumbullohen sipas orëve. Dhe kemi shumë orë. Dhe duhet ta bëjmë brenda 60 sekondave. Është një shakë.
Duhej të arrinim ndonjë gjë, sepse gjithçka po funksiononte shumë, shumë ngadalë, para se të vinte ClickHouse.
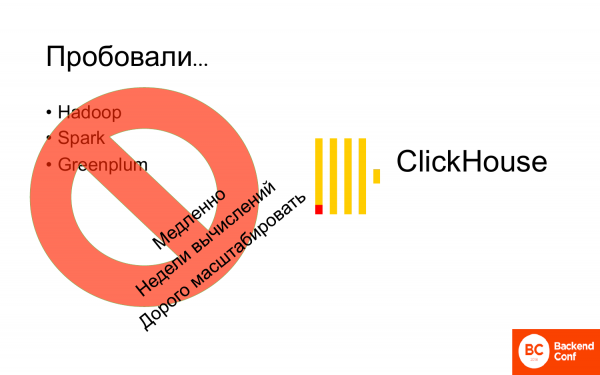
Ata provuan ta llogarisin këtë në Hadoop, në Spark, në Greenplum. Dhe gjithçka ishte shumë ngadalë ose e shtrenjtë. Pra, mund të ishte llogaritur në njëfarë mënyre, por më pas bëhej e shtrenjtë.
Dhe pastaj erdhi ClickHouse dhe gjithçka u bë shumë më mirë.
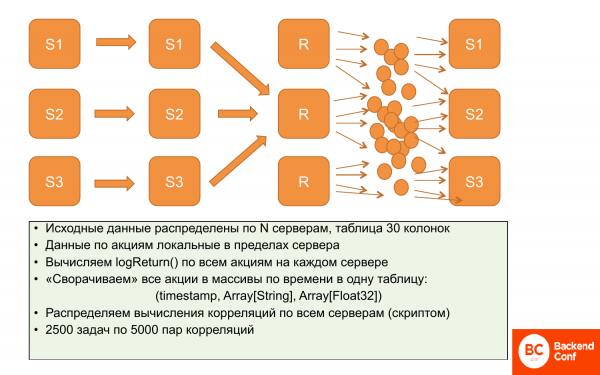
Dua të kujtoj, problemi ynë është me lokalitetin e të dhënave, prandaj korelacionet nuk mund të lokalizohen. Ne nuk mund ta mbledhim një pjesë të të dhënave në një server, një pjesë në një tjetër dhe t’i llogarisim, duhet të kemi të dhënat gjithmonë kudo.
Çfarë bënë ata? Fillimisht, të dhënat ishin të lokalizuara. Në secilin nga serverët ruhen të dhënat për çmimet e një grupi të caktuar aksionesh. Dhe ato nuk përputhen. Pra, mund të llogarisim paralelisht dhe në mënyrë të pavarur logReturn, gjithçka ndodh ndërkohë paralelisht dhe e shpërndarë.
Më pas, ata vendosën që të reduktonin këto të dhëna, pa humbur shprehshmërinë. Të reduktojnë përmes masivave, pra, për çdo segment kohor të krijojnë një masiv aksionesh dhe një masiv çmimesh. Kështu, kjo merr shumë më pak hapësirë dhe është më e lehtë për t’u punuar me to. Këto janë operacione pothuajse paralel, pra ne llogarisim pjesërisht paralelisht dhe pastaj regjistrojmë në server.
Pas kësaj, ato mund të replikohen. Shkronja «r» do të thotë se këto të dhëna ne i kemi replikuar. Pra, ne kemi të dhëna të njëjta në të tre serverat – këto masiva.
Dhe më pas me një script të veçantë nga ky grup prej 12.5 milion korelacionesh që duhen llogaritur, mund të krijojmë paketa. Pra, 2,500 detyra me 5,000 çifte korelacionesh. Dhe këtë detyrë të llogaritim në një server të caktuar ClickHouse. Të gjitha të dhënat i ka, sepse të dhënat janë të njëjta dhe ai mund t’i llogarisë ato në mënyrë radhitëse.
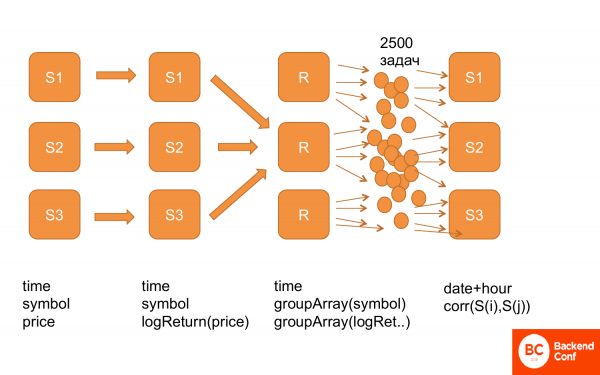
Për herë të dytë, si duket kjo. Së pari, ne kemi të gjitha të dhënat në këtë strukturë: koha, aksionet, çmimi. Pastaj ne llogaritëm logReturn, dmth. të dhënat e së njëjtës strukturë, vetëm se për çmimin tani kemi logReturn. Më pas, i përpunuam, dmth. na dolën koha dhe groupArray sipas aksioneve dhe çmimeve. I bashkuam. Dhe pas kësaj, gjeneruam një sërë detyrash dhe ua dhamë ClickHouse-it që t’i llogarisë ato. Dhe kjo funksionon.
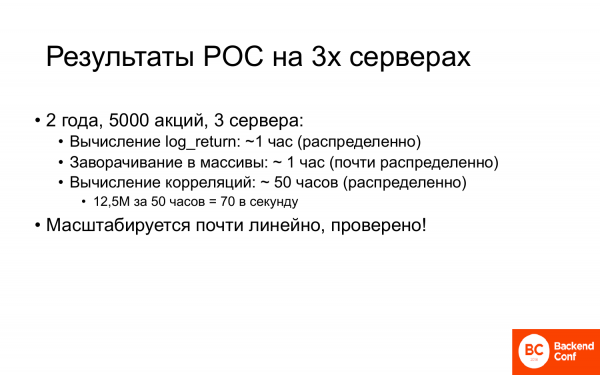
Në provën e konceptit, detyra ishte një nëndetyre, dmth. morëm më pak të dhëna. Dhe gjithçka në tre serverë.
Këta dy etapa të para: llogaritja e Log_return dhe mbështjella në array, zuri rreth një orë secila.
Por llogaritja e korrelacionit zgjati dikur 50 orë. Por 50 orë është pak, sepse më parë atyre iu duhej javë. Kjo ishte një sukses i madh. Dhe nëse llogaritet, gjithçka u llogarit 70 herë në sekondë në këtë klaster.
Por gjëja më e rëndësishme është që ky sistem është praktikisht pa ngushtica, dmth. ai shkallëzohet praktikisht në mënyrë lineare. Dhe ata e verifikuan atë. E skaluan me sukses.
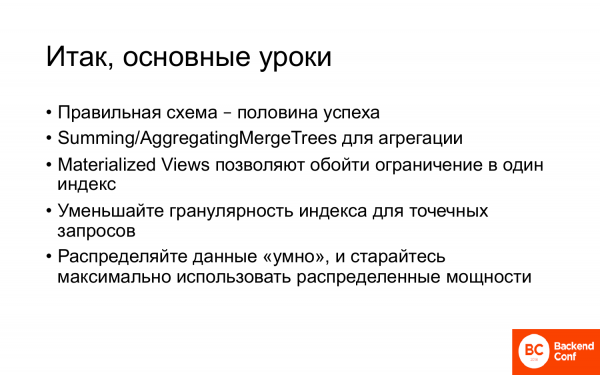
- Schema e saktë është gjysma e suksesit. Dhe schema e saktë është përdorimi i të gjitha teknologjive të nevojshme të ClickHouse.
- Summing/AggregatingMergeTrees janë teknologji që lejojnë të agregohen ose llogariten snapshot state si një rast të veçantë. Dhe kjo e thjeshton ndjeshëm shumë gjëra.
- Materialized Views lejojnë të anashkalosh kufizimin në një indeks. Ndoshta nuk e kam shpjeguar shumë qartë, por kur ngarkonim logët, logët e papërpunuar ishin në një tabelë me një indeks, ndërsa logët e atributeve ishin në tabelë, dmth. të njëjtat të dhëna, vetëm të filtruar, por indekset ishin plotësisht të ndryshme. Duket se janë të njëjtat të dhëna, por përpunimi është ndryshe. Dhe Materialized Views lejon, nëse është e nevojshme, të anashkalosh një kufizim të tillë të ClickHouse.
- Reduktoni granularitetin e indeksit për kërkesa të saktë.
- Dhe shpërndani të dhënat në mënyrë të mençur, përpiquni të lokalizoni sa më shumë të dhëna brenda serverit. Dhe përpiquni që kërkesat të përdorin gjithashtu lokalizimin atje ku është maksimalisht e mundur.
Dhe në përfundim të kësaj prezantimi të vogël, mund të thuhet se ClickHouse tani ka pushtuar qartë territorin e bazave të të dhënave komerciale dhe atyre open source, dmth për analitikë. Ai është integruar mjaft mirë në këtë peizazh. Dhe më shumë, ai ngadalë po fillon të zëvendësojë të tjerë, sepse kur keni ClickHouse, nuk keni nevojë për InfiniDB. Vertica, ndoshta së shpejti nuk do të jetë e nevojshme, nëse ata bëjnë mbështetje të mirë për SQL. Përdorni!
—Faleminderit për raportin! Mjaft interesante! A pati ndonjë krahasim me Apache Phoenix?
-Jo, nuk kam dëgjuar që dikush ka bërë krahasim. Ne dhe Yandex përpiqemi të ndjekim të gjitha krahasimet e ClickHouse me bazat e të dhënave të ndryshme. Sepse nëse ndonjëherë ndodh që diçka të jetë më e shpejtë se ClickHouse, Aleksei Milovidov nuk mund të fleë natën dhe fillon ta përshpejtojë shpejt. Nuk kam dëgjuar për një krahasim të tillë.
(Aleksei Milovidov) Apache Phoenix është një motor SQL për Hbase. Hbase kryesisht është menduar për skenarë pune të tipit key-value. Në çdo rresht mund të ketë një numër të rastësishëm kolonash me emra të rastësishëm. Kjo mund të thuhet për sisteme të tilla si Hbase, Cassandra. Dhe për to, kërkesat analitike të rënda nuk do të funksionojnë mirë. Ose mund të mendoni se ato funksionojnë mirë, nëse nuk keni pasur ndonjë përvojë pune me ClickHouse.
anonim kommentatorit
Mirëdita! Unë kam bërë mjaft hulumtime në këtë temë, sepse kam një nën-sistem analitik. Por kur shikoj në ClickHouse, kam ndjenjën se ClickHouse është shumë i përshtatshëm për analizimin e eventeve, mutable. Dhe nëse më duhet të analizoj shumë të dhëna biznesi me shumë tabela të mëdha, atëherë ClickHouse, sa po kuptoj, nuk më përshtatet shumë? Sidomos nëse ato ndryshojnë. A është e saktë kjo apo ka shembuj që mund ta mohojnë këtë?
Kjo është e saktë. Dhe kjo është e vërtetë për shumicën e bazave të dhënash analitike të specializuara. Ato janë të përshtatura për atë që ekziston një ose disa tabela të mëdha, të cilat janë mutable, dhe shumë të vogla, të cilat ndryshojnë ngadalë. Kështu, ClickHouse nuk është si Oracle, ku mund të vendosni gjithçka dhe të ndërttoni disa kërkesa shumë të komplikuara. Për të përdorur ClickHouse në mënyrë efektive, duhet të strukturohet skema në një mënyrë që funksionon mirë në ClickHouse. Kjo do të thotë që të evitoni normalizimin e tepruar, të përdorni fjalorë, dhe të përpiqeni të krijoni sa më pak lidhje të gjata. Nëse skema strukturohet kështu, atëherë detyra të ngjashme biznesi në ClickHouse mund të zgjidhen shumë më efikasitet se në një bazë të dhënash tradicionale relationale.
Faleminderit për raportin! Kam një pyetje për rastin e fundit financiar. Ata kishin analitikë. Duhej të krahasoheshin, si shkojnë lart-poshtë. Dhe e kuptoj që ju e ndërtuat sistemin pikërisht për këtë analitikë? Nëse ata nesër, për shembull, kanë nevojë për një raport tjetër mbi këto të dhëna, duhet të rindërtojnë përsëri skemën dhe të ngarkojnë të dhënat? Kështu, a duhet të bëni ndonjë përpunim paraprak për të marrë kërkesën?
Sigurisht, kjo është përdorimi i ClickHouse për një detyrë të caktuar. Ajo tradicionalisht mund të zgjidhet brenda Hadoop. Për Hadoop – kjo është një detyrë ideale. Por në Hadoop është shumë e ngadalshme. Dhe qëllimi im është të demonstrohet se në ClickHouse mund të zgjidhen detyra që zakonisht zgjidhen me mjete krejtësisht të tjera, por me shumë efikasitet më të madh. Kjo është e fokusuar për një detyrë specifike. E qartë është që nëse ka një detyrë të ngjashme, atëherë mund të zgjidhet në një mënyrë të ngjashme.
E kuptoj. Ju thatë se u procesuan 50 orë. A ka filluar nga fillimi, kur ngarkuat të dhënat apo morët rezultatet?
Po-po.
Mirë, faleminderit shumë.
Kjo ndodhi në një klaster me 3 serverë.
Përshëndetje! Faleminderit për raportin! Gjithçka është shumë interesante. Po pyes pak për funksionimin, jo për funksionalitetin, por për përdorimin e ClickHouse nga pikëpamja e stabilitetit. A ka ndodhur ndonjëherë që ju të keni pasur nevojë të rikuperoni? Si sillet ClickHouse gjatë kësaj? Dëshiruam të dija nëse ka ndodhur që edhe replika ka rënë? Ne, për shembull, kemi hasur në një problem me ClickHouse, kur ai papritmas kalon limitin e tij dhe bie.
Sigurisht, nuk ka sisteme perfekte. Edhe ClickHouse ka problemet e tij. Por a keni dëgjuar ndonjëherë që Yandex.Metrica të mos funksiononte për një kohë të gjatë? Ndoshta jo. Ajo funksionon besnikërisht që nga viti 2012-2013 në ClickHouse. Mund të flas edhe për përvojën time. Kurrë nuk kemi pasur ndalime të plota. Disa çështje pjesore mund të ndodhnin, por kurrë nuk kanë qenë kaq kritike sa të ndikojnë seriozisht në biznes. Kurrë nuk ka ndodhur një gjë e tillë. ClickHouse është mjaft i besueshëm dhe nuk bie rastësisht. Nuk keni arsye të shqetësoheni për këtë. Nuk është një gjë e papërfunduar. Kjo është provuar nga shumë kompani.
Përshëndetje! Ju thatë se duhet të mendoni mirë për mendimin tuaj të dhënave që në fillim. Por çfarë ndodhi nëse kjo ndodhi? Të dhënat po derdhen vazhdimisht. Kalojnë gjashtë muaj dhe unë kuptoj se nuk mund të jetoj kështu, duhet të ripak të dhënat dhe të bëj diçka me to.
Kjo varet, sigurisht, nga sistemi juaj. Ka disa mënyra për ta bërë këtë pothuajse pa ndalim. Për shembull, mund të krijoni një Materialized View, në të cilin të bëni një strukturë të ndryshme të të dhënave, nëse ajo mund të mapeohet qartë. Domethënë, nëse lejon mapimin përmes ClickHouse, që do të thotë të nxjerrësh disa gjëra, të ndryshosh çelësin kryesor, të ndryshosh ndarjen, atëherë mund të krijosh një Materialized View. Aty do të shkruhen të dhënat tuaja të vjetra, dhe të rejat do të shkruhen automatikisht. Pastaj thjesht kaloni në përdorimin e Materialized View, më pas ndërroni shkresën dhe shkatërroni tabelën e vjetër. Kjo është një metodë pa ndalim.
Faleminderit.
Burimi: habr.com
