

Përshëndetje! Emri im është Danil Lipovoy, ekipi ynë në Sbertech ka filluar të përdorë HBase si depozita për të dhënat operative. Gjatë studimit të tij, është grumbulluar përvoja, të cilën deshëm ta sistematizojmë dhe ta përshkruajmë (shpresojmë se do të jetë e dobishme për shumëkënd). Të gjitha eksperimentet e mëposhtme janë kryer me versionet HBase 1.2.0-cdh5.14.2 dhe 2.0.0-cdh6.0.0-beta1.
- Arkitektura e përgjithshme
- Shkrimi i të dhënave në HBASE
- Leximi i të dhënave nga HBASE
- Keshimi i të dhënave
- Procesimi i paketave të të dhënave MultiGet/MultiPut
- Strategjia e ndarjes së tabelave në rajone (shpërndarja)
- Kohëzgjatja, kompakti dhe lokaliteti i të dhënave
- Cështjet dhe performanca
- Testimi i ngarkesës
- Përfundimet
1. Arkitektura e përgjithshme
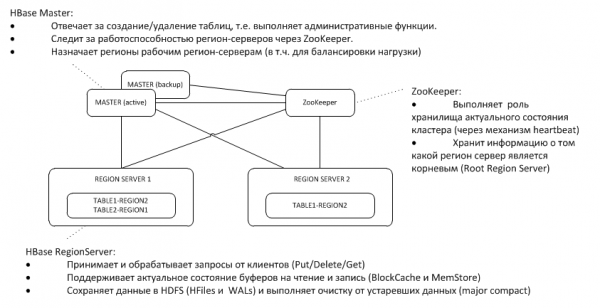
Master-i rezervë dëgjon heartbeat-in e aktiv në nodin ZooKeeper dhe në rast se zhduket merr funksionet e master-it mbi vete.
2. Shkrimi i të dhënave në HBASE
Më parë, le të shqyrtojmë rastin më të thjeshtë – shkrimin e një objekti çelës-vlerë në një tabelë me anë të put(rowkey). Klienti fillimisht duhet të kuptojë se ku ndodhet rajoni rrënjësor i serverit (Root Region Server – RRS), i cili ruan tabelën hbase:meta. Këtë informacion e merr nga ZooKeeper. Pas kësaj, ai drejtohet te RRS dhe lexon tabelën hbase:meta, nga e cila nxjerr informacionin, se cili RegionServer (RS) është përgjegjës për ruajtjen e të dhënave për çelësin e caktuar rowkey në tabelën që e intereson. Për qëllime përdorimi në të ardhmen, tabela meta keshon nga klienti dhe prandaj subvencionet e mëvonshme shkojnë më shpejt, direkt te RS.
Më pas, RS, duke marrë kërkesën, fillimisht e shkruan atë në WriteAheadLog (WAL), që është e nevojshme për rikuperimin në rast rënie. Pastaj ruan të dhënat në MemStore. Ky është një tampon në kujtesë, i cili përmban një grup të renditur të çelësave të këtij rajoni. Tabela mund të ndahet në rajone (partita), secili prej të cilëve përmban një grup të pandryshueshëm çelësh. Kjo lejon, duke vendosur rajonet në serverë të ndryshëm, të arrihet një performancë më e lartë. Megjithatë, pavarësisht qartësisë së këtij pohimi, më pas do të shohim se kjo nuk funksionon në të gjitha rastet.
Pasi të vendoset regjistrimi në MemStore, klienti merr një përgjigje se regjistrimi është ruajtur me sukses. Ndërkohë, në të vërtetë ai ruhet vetëm në tampon dhe do të kalojë në disk vetëm pas kalimit të një intervali të caktuar kohe ose kur mbushet me të dhëna të reja.
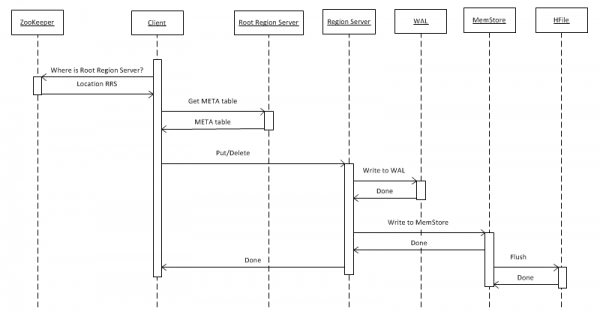
Kur operacioni "Fshi" ekzekutohet, nuk ndodh një eliminim fizik i të dhënave. Ato thjesht shënohen si të fshira, ndërsa shkatërrimi ndodh në momentin e thirrjes së funksionit major compact, për të cilin është shkruar më shumë në p.7.
Skedarët në formatin HFile grumbullohen në HDFS dhe nga koha në kohë nis një proces minor compact, i cili thjesht ngjitesh skedarët e vegjël në më të mëdhenj, pa fshirë asgjë. Me kalimin e kohës, kjo bëhet një problem që shfaqet vetëm gjatë leximit të të dhënave (për këtë do të kthehemi më vonë).
Përveç procesit të ngarkesës të përshkruar më sipër, ekziston një procedurë shumë më efikase, e cila përmban ndoshta pikën më të fortë të kësaj DB - BulkLoad. Ajo konsiston në faktin se ne vetë formojmë HFiles dhe i vendosim në disk, që na lejon të shkallëzojmë mjaft mirë dhe të arrijmë shpejtësi të konsiderueshme. Në thelb, kufizimi këtu nuk është HBase, por mundësitë e harduerit. Më poshtë janë rezultatet e ngarkesës në një klaster që përbëhet nga 16 RegionServers dhe 16 NodeManager YARN (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 procese), versioni HBase 1.2.0-cdh5.14.2.
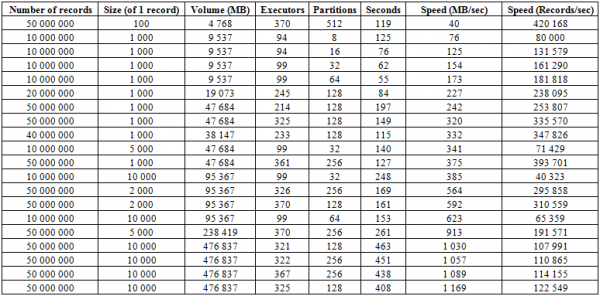
Këtu shihet se duke rritur numrin e particioneve (rajoneve) në tabelë, si dhe ekzekutorët e Spark, arrijmë një rritje të shpejtësisë së ngarkesës. Gjithashtu, shpejtësia varet nga volumi i shkruar. Blloqet e mëdha japin një rritje në matjen MB/sek, ndërsa ato të vogla në numrin e shënimeve të futur në një njësi kohe, nën kushte të barabarta.
Gjithashtu, mund të nisim ngarkimin në dy tabela njëkohësisht dhe të marrim dyfishin e shpejtësisë. Më poshtë shihet se shkruarja e blloqeve 10 KB menjëherë në dy tabela shkon me një shpejtësi prej rreth 600 Mb/sek në secilën (shuma 1275 Mb/sek), që përputhet me shpejtësinë e shkruarjes në një tabelë 623 MB/sek (shih №11 më sipër)
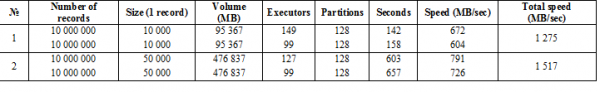
Ndërsa, ekzekutimi i dytë me shënime në 50 KB tregon se shpejtësia e ngarkesës rritet tashmë në mënyrë të vogël, që flet për afrim ndaj vlerave maksimale. Në të njëjtën kohë, duhet të merret parasysh se samë HBASE këtu nuk krijon ngarkesë të rëndë, gjithçka që kërkohet prej tij është së pari të dorëzojë të dhënat nga hbase:meta, dhe pas vendosjes së HFiles, të shkarkojë të dhënat BlockCache dhe të ruajë tamponin MemStore në disk, nëse ai nuk është bosh.
3. Leximi i të dhënave nga HBASE
Nëse merret parasysh se të gjitha informacionet nga hbase:meta tashmë i ka klienti (shih. p.2), atëherë kërkesa shkon menjëherë në atë RS, ku ruhet çelësi i nevojshëm. Fillimisht, kërkimi kryhet në MemCache. Pavarësisht nëse atje ka të dhëna apo jo, kërkimi kryhet gjithashtu në tamponin BlockCache dhe, nëse është e nevojshme, në HFiles. Nëse të dhënat janë gjetur në skedarin, ato vendosen në BlockCache dhe për kërkesën e ardhshme do të kthehen më shpejt. Kërkimi në HFile ndodh mjaft shpejt për shkak të përdorimit të filtrit Bloom, dmth duke lexuar një volum të vogël të dhënash, ai e përcakton menjëherë nëse ky skedar përmban çelësin e nevojshëm dhe, nëse nuk ka, kalon te i siguiente.
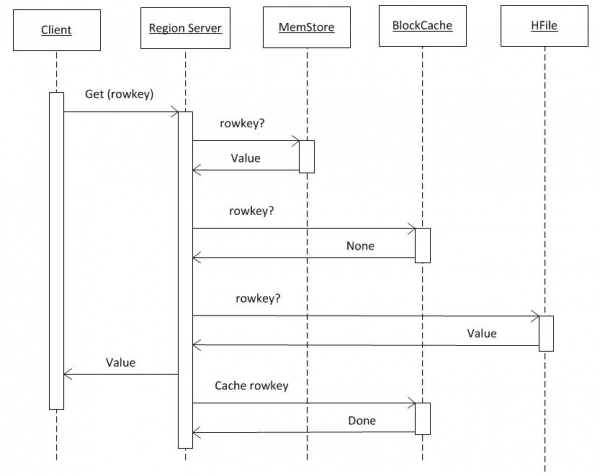
Duke marrë të dhënat nga këto tre burime, RS formon përgjigjen. Në veçanti, ai mund të transmetojë menjëherë disa versione të gjetura të objektit nëse klienti ka kërkuar versionim.
4. Keshimi i të dhënave
Buffers MemStore dhe BlockCache zënë deri në 80% të memories së rezervuar on-heap të RS (pjesa tjetër është rezervuar për detyra shërbimi të RS). Nëse modelet tipike të përdorimit janë të tilla që proceset shkruajnë dhe menjëherë lexojnë të njëjtat të dhëna, ka kuptim të ulet BlockCache dhe të rritet MemStore, pasi gjatë shkrimit të dhënat në cache nuk hyjnë për lexim, kështu që përdorimi i BlockCache do të ndodhë më rrallë. Buffer BlockCache përbëhet nga dy pjesë: LruBlockCache (përherë on-heap) dhe BucketCache (në përgjithësi off-heap ose në SSD). BucketCache duhet të përdoret kur ka shumë kërkesa për lexim dhe ato nuk hyjnë në LruBlockCache, gjë që rezulton në një punë aktive të Garbage Collector. Megjithatë, nuk duhet pritur një rritje dramatike të performancës nga përdorimi i cache për lexim, por për këtë do të kthehemi përsëri në p. 8.
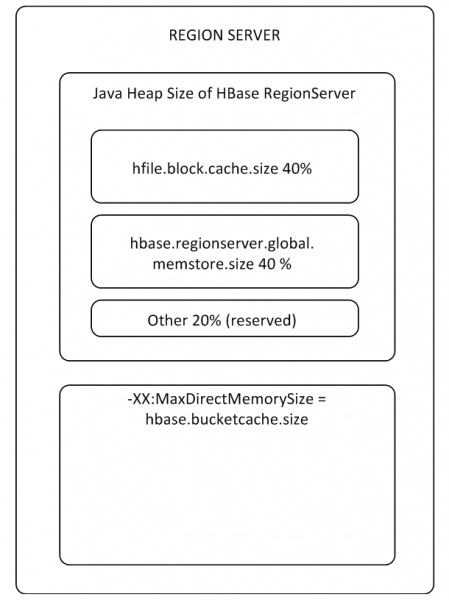
BlockCache është një për të gjithë RS, ndërsa MemStore është specifike për secilën tabelë (një për çdo Column Family).
Si Në teori, gjatë shkrimit, të dhënat nuk hyjnë në cache, dhe me të vërtetë, parametrat e tillë CACHE_DATA_ON_WRITE për tabelën dhe "Cache DATA on Write" për RS janë vendosur në false. Megjithatë, në praktikë, nëse shkruani të dhëna në MemStore, më pas e shfryni atë në disk (duke e pastruar kështu), pastaj fshini skedarin që është krijuar, duke realizuar një kërkesë get, ne e marrim me sukses të dhënat. Madje, edhe nëse e fikni krejt BlockCache dhe mbushni tabelën me të dhëna të reja, më pas arritni të shfryni MemStore në disk, duke i fshirë ato dhe kërkuar nga një sesion tjetër, ato do të nxirren sërish nga diku. Pra, HBase ruan në vetvete jo vetëm të dhëna, por edhe misteret e çuditshme.
hbase(main):001:0> krijo 'ns:magic', 'cf'
Tabela ns:magic u krijua
Mori 1.1533 sekonda
hbase(main):002:0> vendos 'ns:magic', 'key1', 'cf:c', 'provo_të_fshihem'
Mori 0.2610 sekonda
hbase(main):003:0> flush 'ns:magic'
Mori 0.6161 sekonda
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> merr 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, vlera=provo_të_fshihem
Parametri "Cache DATA on Read" është vendosur false. Nëse keni ide, mirëpriteni të diskutojmë këtë në komentet.
5. Përpunimi i grupeve të të dhënave MultiGet/MultiPut
Përpunimi i kërkesave të vetme (Get/Put/Delete) është një operacion mjaft i kushtueshëm, prandaj është e rekomandueshme t'i gruposh sa më shumë të jetë e mundur në List ose List, duke lejuar kështu një rritje të konsiderueshme të performancës. Kjo veçanërisht vlen për operacionin e shkrimit, ndërsa në lexim ka një pengesë tjetër. Në grafikun më poshtë është treguar koha e leximit të 50,000 regjistrimeve nga MemStore. Leximi është bërë në një të vetëm dhe në boshtin horizontal është treguar numri i çelësave në kërkesë. Këtu shihet se me rritjen deri në një mijë çelësa në një kërkesë, koha e ekzekutimit bie, pra shpejtësia rritet. Megjithatë, me modalitetin MSLAB të aktivizuar në mënyrë të paracaktuar, pas këtij prag, fillon një rënien dramatike të performancës, ndërsa më shumë është volumi i të dhënave në regjistër, aq më shumë është koha e punës.
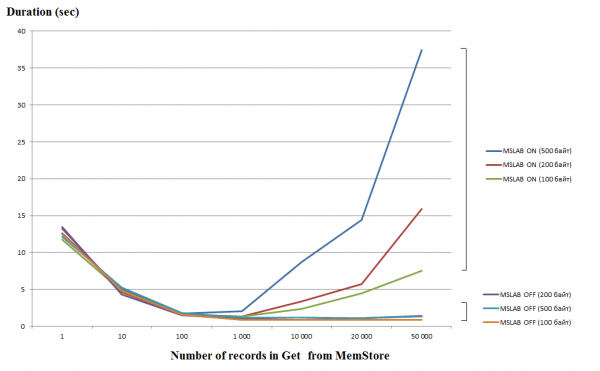
Testet janë kryer në një virtualka, 8 bërthama, versioni HBase 2.0.0-cdh6.0.0-beta1.
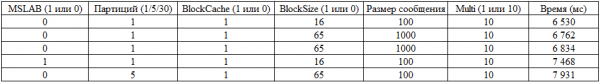
Modaliteti MSLAB është krijuar për të zvogëluar fragmentimin e heap-it, që ndodh për shkak të përzierjes së të dhënave të brezit të ri dhe atyre të vjetër. Si zgjidhje e problemit, kur aktivizohet MSLAB, të dhënat vendosen në qeliza (chunk) relativisht të vogla dhe përpunohen në grupe. Si rezultat, kur volumi në paketën e të dhënave të kërkuara tejkalon madhësinë e caktuar, performanca bie në mënyrë drastike. Në anën tjetër, çaktivizimi i këtij modaliteti gjithashtu nuk është i dëshirueshëm, pasi do të çojë në ndalime për shkak të GC në momentet e punës intensive me të dhëna. Një zgjidhje e mirë është rritja e madhësive të qelizave, në rastin e shkrimit aktiv përmes put-it në të njëjtën kohë me leximin. Duhet të theksohet se problemi nuk ndodh nëse pas shkrimit ekzekutohet komandë flush, e cila dërgon MemStore në disk ose nëse bëhet ngarkesa përmes BulkLoad. Në tabelën më poshtë tregohet se kërkesat nga MemStore për të dhëna të mëdha (dhe në të njëjtin numër) çojnë në ngadalësim. Megjithatë, duke rritur chunksize, rikthejmë kohën e përpunimit në normë.
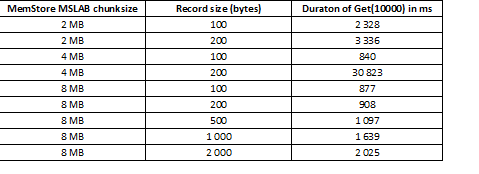
Përveç rritjes së chunksize, ndihmon ndarja e të dhënave sipas rajoneve, pra, ndarja e tabelave. Kjo çon në atë që në çdo rajon vijnë më pak kërkesa dhe nëse ato vendosen në një qelizë, përgjigja mbetet e mirë.
6. Strategjia e ndarjes së tabelave në rajone (splitting)
Duke qenë se HBase është një magazinë çelës-vlerë dhe ndarja bëhet sipas çelësit, është shumë e rëndësishme të ndahet të dhënat në mënyrë të barabartë në të gjitha rajonet. Për shembull, ndarja e një tabele të tillë në tre pjesë do të çonte në atë që të dhënat do të ishin të ndara në tri rajone:
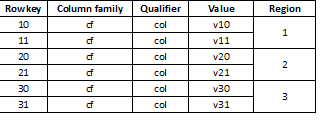
Ndodh që kjo të çojë në ngadalësim të menjëhershëm, nëse të dhënat që do të ngarkohen më pas kanë formë për shembull vlerash të gjata, shumica e të cilave fillojnë me të njëjtën shifër, për shembull:
1000001
1000002
…
1100003
Duke qenë se çelësat ruhen si një array bajtesh, të gjithë do të fillojnë njësoj dhe do t'i përkasin një rajoni të vetëm #1 që ruan këtë gamë çelësash. Ka disa strategji ndarje:
HexStringSplit – Kthen çelësin në një varg me kodim gjashtëmbëdhjetëshe në gamën «00000000» => «FFFFFFFF» dhe e mbush atë nga e majta me zero.
UniformSplit – Kthen çelësin në një array bajtesh me kodim gjashtëmbëdhjetëshe në gamën «00» => «FF» dhe e mbush atë nga e djathta me zero.
Për më tepër, mund të specifikoni çdo gamë ose set çelësash për ndarje dhe të konfiguroni ndarjen automatike. Megjithatë, një nga qasjet më të thjeshta dhe efikase është UniformSplit dhe përdorimi i konkatenimit të hash-it, për shembull, çifti më i lartë i bajtëve nga ekzekutimi i çelësit përmes funksionit CRC32(rowkey) dhe vetë rowkey:
hash + rowkey
Atëherë të gjitha të dhënat do të shpërndahen në mënyrë të barabartë në rajone. Gjatë leximit, dy bajtët e parë thjesht hiqen dhe mbetet çelësi origjinal. Gjithashtu, RS kontrollon sasinë e të dhënave dhe çelësave në rajon dhe në rast të tejkalimit të kufijve, automatikisht e ndan atë në pjesë.
7. Qëndrueshmëria dhe lokaliteti i të dhënave
Dukeqë çdo grup çelësash menaxhohet nga një rajon i vetëm, zgjidhja e problemeve që lidhen me rëniet e RS ose me daljen nga përdorimi është ruajtja e të dhënave të nevojshme në HDFS. Kur ndodh një rënie e RS, masteri e zbulon këtë përmes mungesës së heartbeat në nyjën ZooKeeper. Atëherë ai i cakton një rajon tjetër të menaxhuar një RS të ri dhe pasi që HFiles ruhen në sistemin e skedarëve të shpërndarë, pronari i ri i lexon dhe vazhdon të shërbejë të dhënat. Megjithatë, pasi një pjesë e të dhënave mund të jetë në MemStore dhe nuk është ruajtur ende në HFiles, për rikthimin e historisë së operacioneve përdoret WAL, i cili gjithashtu ruhet në HDFS. Pas vendosjes së ndryshimeve, RS është në gjendje të përgjigjet ndaj kërkesave, megjithatë kalimi çon në faktin se një pjesë e të dhënave dhe proceset që i shërbejnë atyre janë në nyja të ndryshme, dmth, lokaliteti zvogëlohet.
Zgjidhja për këtë problem është major compaction – kjo procedurë transferon skedarët në ato nyja që janë përgjegjëse për ta (aty ku ndodhen rajonet e tyre), si rezultat i të cilës gjatë kësaj procedure ngarkesa në rrjet dhe disqet rritet ndjeshëm. Megjithatë, më vonë, qasja në të dhëna përmirësohet ndjeshëm. Për më tepër, major_compaction kombinon të gjitha HFiles në një skedar të vetëm në kuadër të rajonit, si dhe pastron të dhënat në varësi të cilësimeve të tabelës. Për shembull, mund të caktohet numri i versioneve të objektit që duhet të ruhen ose koha e jetës së tij, pas kalimit të së cilës objekti fshihet fizikisht.
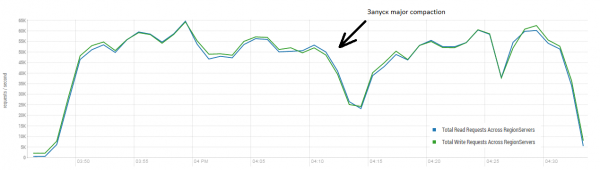
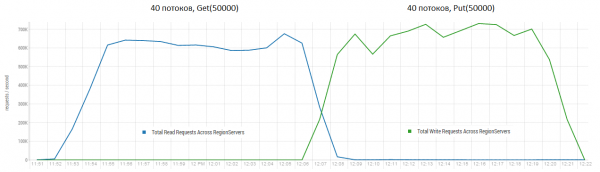
Kjo procedurë mund të ketë një ndikim shumë pozitiv në funksionimin e HBase. Në imazhin më poshtë shihet si degradoi performanca si rezultat i shkrimit aktiv të të dhënave. Këtu shihet si 40 rrjedha shkruajnë në një tabelë dhe 40 rrjedha lexojnë të dhëna njëkohësisht. Rrjedhat shkruese formojnë gjithnjë e më shumë HFiles, të cilat lexohen nga rrjedhat e tjera. Si rezultat, gjithnjë e më shumë të dhëna duhet të fshihen nga memoria dhe në fund fillon të funksionojë GC, që pothuajse paralizon të gjithë punën. Aktivizimi i major compaction çoi në pastrimin e mbetjeve të krijuara dhe rikthimin e performancës.
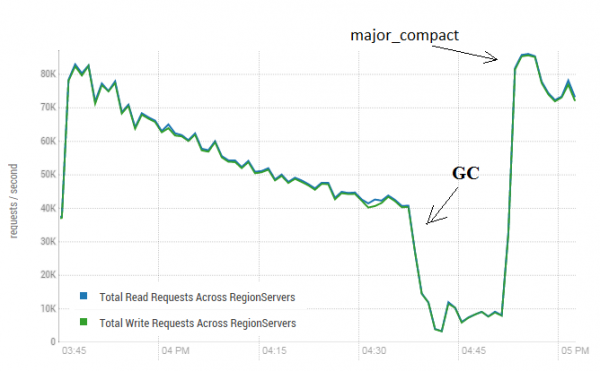
Testi u krye në 3 DataNode dhe 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 rrjedha). Versioni HBase 1.2.0-cdh5.14.2
Është e rëndësishme të theksohet se lançimi i major compaction u krye në një tavëll "live", në të cilën ishin duke u shkruar dhe lexuar të dhëna aktivisht. Në internet ka pasur deklarata që sugjerojnë se kjo mund të çojë në përgjigje të gabuar gjatë leximit të të dhënave. Për të verifikuar, u aktivizua një proces që gjeneronte të dhëna të reja dhe i shkruante ato në tavëll. Pas kësaj, menjëherë lexonte dhe krahasonte nëse vlera e marrë përputhej me atë që ishte shkruar. Gjatë punës së këtij procesi, major compaction u lançua rreth 200 herë dhe asnjë dështim nuk u regjistrua. Ndoshta problemi shfaqet së shpejti dhe vetëm gjatë ngarkesës së lartë, prandaj është më e sigurt të ndaloni procedurat e shkrimit dhe leximit në mënyrë planifikuese dhe të kryeni pastrimin pa lejuar rëniet e tilla GC.
Po ashtu, major compaction nuk ndikon në gjendjen e MemStore, për të hedhur atë në disk dhe për kompaktim duhet të përdoret flush (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Cilësimet dhe Performanca
Siç është thënë më parë, HBase tregon suksesin më të madh atje ku nuk ka nevojë të bëjë asgjë, gjatë realizimit të BulkLoad. Megjithatë, kjo i përket shumicës së sistemeve dhe njerëzve. Sidoqoftë, ky instrument është më i përshtatshëm për vendosjen masive të të dhënave në blloqe të mëdha, ndërsa nëse procesi kërkon realizimin e shumë kërkesave konkurruese për lexim dhe shkrim, përdoren komandat e përshkruara më sipër Get dhe Put. Për të përcaktuar parametrat optimalë, u zhvilluan lançime me kombinime të ndryshme të parametrave të tavllave dhe cilësimeve:
- U lançuan 10 rrjedha njëkohësisht 3 herë radhazi (të quajmë këtë një bllok rrjedhash).
- Koha e punës së të gjitha rrjedhave në bllok u mesataua dhe ishte rezultati përfundimtar i punës së bllokut.
- Të gjitha rrjedhat punuan me të njëjtën tavëll.
- Para çdo lançimi të bllokut të rrjedhave, u krye një major compaction.
- Çdo bllok kryente vetëm një nga operacionet e mëposhtme:
— Put
— Get
— Get+Put
- Çdo bllok kryente 50,000 përsëritje të operacionit të tij.
- Madhësia e regjistrimit në bllok ishte 100 byte, 1000 byte ose 10000 byte (random).
- Blloqet u lançuan me sasi të ndryshme të çelësave të kërkuar (ose një çelës ose 10).
- Blloqet u lançuan nën cilësime të ndryshme të tavllës. Parametrat u ndërruan:
— BlockCache = u aktivizua ose u deaktivizua
— BlockSize = 65 Kb ose 16 Kb
— Pjesët = 1, 5 ose 30
— MSLAB = aktivizuar ose deaktivizuar
Kështu, blloku duket kështu:
a. Mënyra MSLAB u aktivizua/aktivizua.
b. U krijua një tabelë, për të cilën u vendosën parametrat e mëposhtëm: BlockCache = true/në, BlockSize = 65/16 Kb, Partita = 1/5/30.
c. U vendos kompresimi GZ.
d. U nisën 10 përcjellës në të njëjtën kohë që kryenin 1/10 operacione put/get/get+put në këtë tabelë me shënime prej 100/1000/10000 byte, duke realizuar 50,000 kërkesa radhazi (çelësat ishin të rastësishëm).
e. Pika d u përsërit tri herë.
f. Koha e punës së të gjitha përcjellësve u mesatua.
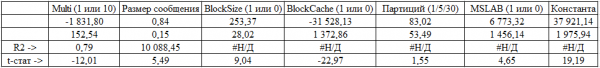
U kontrolluan të gjitha kombinimet e mundshme. Është e parashikueshme se me rritjen e madhësisë së shënimit, shpejtësia do të bjerë ose se deaktivizimi i kapjes do të çojë në ngadalësim. Megjithatë, qëllimi ishte të kuptohej shkalla dhe rëndësia e ndikimit të secilit parametr, prandaj të dhënat e mbledhura u japën si input në funksionin e regresionit linear, që ofron mundësinë për të vlerësuar saktësinë përmes statistikës t. Më poshtë janë rezultatat e punës së bllokëve që kryejnë operacionet Put. Grupi i plotë i kombinimeve 2*2*3*2*3 = 144 variante + 72 për shkak se disa u realizuan dy herë. Prandaj, në total janë 216 nisje:
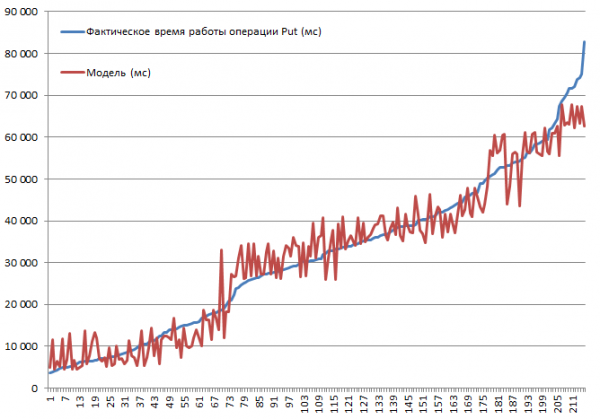
Testimi u krye në një mini-klaster që përbëhej nga 3 DataNode dhe 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 përcjellës). Versioni HBase 1.2.0-cdh5.14.2.
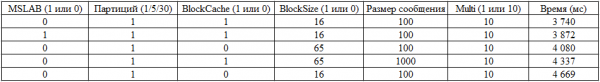
Shpejtësia më e lartë e futjes, 3.7 sekonda, u arrit kur nuk ishte aktivizuar moda MSLAB, në një tabelë me një parti, me BlockCache të aktivizuar, BlockSize = 16, shënime prej 100 byte në 10 copë në paketë.
Shpejtësia më e ulët e futjes, 82.8 sekonda, u arrit kur ishte aktivizuar moda MSLAB, në një tabelë me një parti, me BlockCache të aktivizuar, BlockSize = 16, shënime prej 10000 byte në 1 copë.
Tani le të shohim modelin. Ne shohim cilësi të mirë të modelit sipas R2, por plotësisht e qartë se ekstrapolimi këtu është i padëshiruar. Sjellja e vërtetë e sistemit gjatë ndryshimit të parametreve do të jetë jo lineare, ky model është i nevojshëm, jo për prognoza, por për të kuptuar se çfarë ndodhi brenda parametrave të caktuara. Për shembull, këtu ne shohim sipas kritereve të Studentit, që për operacionin Put, parametrat BlockSize dhe BlockCache nuk kanë rëndësi (çka është në përgjithësi krejt e parashikueshme):
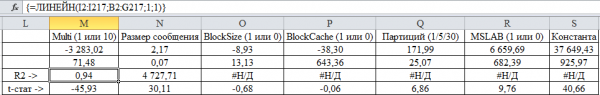
E megjithatë, rritja e numrit të particioneve çon në një ulje të performancës, që është disi befasuese (ne kemi parë një ndikim pozitiv nga rritja e numrit të particioneve gjatë BulkLoad), ndonëse është e shpjegueshme. Së pari, për përpunim duhet të formohen kërkesa për 30 rajone në vend të një siç ishte më parë, dhe volumi i të dhënave nuk është i tillë që të ofrojë përfitime. Së dyti, koha total e punës përcaktohet nga RS më i ngadalshëm, dhe pasi numri i DataNode është më i vogël se numri i RS, disa rajone kanë lokalitet zero. Tani le të shikojmë pesë liderët:
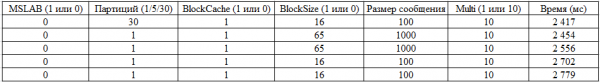
Tani le të vlerësojmë rezultatet e ekzekutimit të blloqeve Get:
Numri i particioneve ka humbur rëndësinë, gjë që ndoshta shpjegohet nga fakti se të dhënat janë të mirë-kesh dhe keši për lexim është parametrat më të rëndësishëm (statistikisht). Natyrisht, rritja e numrit të mesazheve në kërkesë është gjithashtu shumë e dobishme për performancën. Rezultatet më të mira:
Dhe së fundmi, le të shikojmë në modelin e bllokut që fillimisht kryente get, dhe pastaj put:
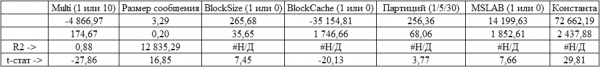
Këtu të gjithë parametrat janë të rëndësishëm. Dhe rezultatet e liderëve:
9. Testimi i ngarkesës
Dhe së fundmi, le të aktivizojmë një ngarkesë më të pranueshme, por gjithmonë është më interesante kur ka çfarë të krahasojmë. Në faqen e internetit të DataStax – zhvilluesi kryesor i Cassandra, ka HN të disa depozitave NoSQL, duke përfshirë HBase versionin 0.98.6-1. Ngarkesa u realizua me 40 rrjedha, madhësia e të dhënave 100 byte, disqet SSD. Rezultati i testit të operacioneve Read-Modify-Write tregoi këto rezultate.
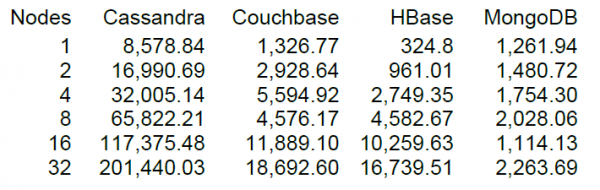
Sa kuptova, leximi u krye blok pas bloku prej 100 regjistrimesh dhe për 16 node HBase testi i DataStax tregoi një performancë prej 10 mijë operacioneve në sekondë.
Është e mirë që në klasterin tonë ka gjithashtu 16 nod dhe jo shumë 'e mirë' që në secilin ka 64 bërthama (rrjedha), ndërsa në testin DataStax vetëm nga 4. Nga ana tjetër, ata kanë dysk SSD, ndërsa ne kemi HDD dhe një version më të ri të HBase, dhe shfrytëzimi i CPU gjatë ngarkesës rritet praktikisht shumë pak (vizualisht nga 5-10 përqind). Sidoqoftë, do të përpiqemi të startojmë në këtë konfigurim. Cilësimet e tabelave janë përparësisht, leximi kryhet në një interval çelesh nga 0 deri në 50 milion, në mënyrë rastësore (dmth, për sonin e vërtetë çdo herë një të ri). Në tabelë ka 50 milion regjistrime, të ndara në 64 pjesë. Çelësat janë hash-uar sipas crc32. Cilësimet e tabelave janë standarde, MSLAB është aktiv. Duke filluar 40 rrjedha, secila rrjedhë lexon një set prej 100 çelësash të rastësishëm dhe menjëherë shkruan 100 byte të gjeneruara pas këtyre çelësave.
Stendi: 16 DataNode dhe 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 rrjedha). Versioni HBase 1.2.0-cdh5.14.2.
Rezultati mesatar është më afër 40 mijë operacioneve në sekondë, që është ndjeshëm më mirë sesa në testin DataStax. Megjithatë, për qëllime eksperimentale, mund të ndryshojmë pak kushtet. Është tepër e pabesueshme që të gjithë punët do të kryhen ekskluzivisht me një tabelë dhe vetëm me çelësa unikë. Le të supozojmë se ka një grup 'të nxehtë' çelësash që gjeneron ngarkesën kryesore. Prandaj, do të përpiqemi të krijojmë ngarkesë me regjistrime më të mëdha (10 KB), gjithashtu në grupe prej 100, në 4 tabela të ndryshme dhe duke kufizuar intervalin e çelësave të kërkuar në 50 mijë. Në grafikun më poshtë tregohet startimi i 40 rrjedhave, secila rrjedhë lexon një set prej 100 çelësash dhe menjëherë shkruan të rastësishme 10 KB pas këtyre çelësave përsëri.
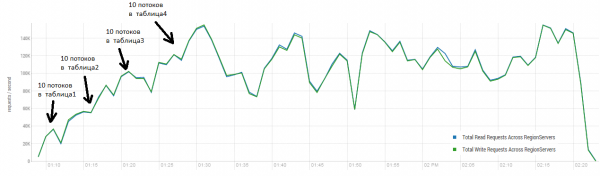
Stendi: 16 DataNode dhe 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 rrjedha). Versioni HBase 1.2.0-cdh5.14.2.
Gjatë ngarkesës, disa herë është startuar kompakti major, siç u tregua më sipër, pa këtë procedurë performanca do të degradojë gradualisht, megjithatë gjatë ekzekutimit ndodhen gjithashtu ngarkesa shtesë. Rëniet shkaktohen nga shkak të ndryshëm. Ndonjëherë rrjedhat përfundonin punën dhe ndërsa ato rinisnin, ndodhte një pauzë, ndonjëherë aplikacione të tjera krijonin ngarkesë në klaster.
Leximi dhe menjëherë shkruaj, është një nga skenarët më të vështirë për punë për HBase. Nëse bëhen vetëm kërkesa put me madhësi të vogla, për shembull nga 100 byte, duke i bashkuar ato në paketa prej 10-50 mijë copësh, mund të arrihen qindra mijëra operacione në sekondë dhe ashtu ndodhin gjërat me kërkesat vetëm për lexim. Duhet të theksohet se rezultatet janë radikalisht më të mira se ato që u arritën nga DataStax kryesisht për shkak të kërkesave në grupe prej 50 mijë.
Stendi: 16 DataNode dhe 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 rrjedha). Versioni HBase 1.2.0-cdh5.14.2.
10. Përfundime
Ky sistem konfiguracioni është mjaft fleksibël, megjithatë ndikimi i një numri të madh parametrash mbetet ende i panjohur. Disa prej tyre janë testuar, por nuk janë përfshirë në grupin e rezultateve. Për shembull, eksperimet preliminare treguan një rëndësi të vogël për parametrin si DATA_BLOCK_ENCODING, i cili kodon informacionin duke përdorur vlerat nga qelizat fqinje, gjë që është mjaft e shpjegueshme për të dhënat e gjeneruara në mënyrë të rastësishme. Në rastin e përdorimit të një numri të madh objektesh të përsëritura, fitimi mund të jetë i konsiderueshëm. Në përgjithësi, mund të thuhet se HBase bëhet një bazë të dhënash që duket mjaft serioze dhe e menduar, e cila gjatë operacioneve me blloqe të mëdha të të dhënave mund të jetë mjaft e fuqishme. Sidomos nëse ka mundësi të ndahen në kohë proceset e leximit dhe shkrimit.
Nëse mendoni se ndonjë gjë nuk është shpjeguar mjaftueshëm, jam i gatshëm të flas më shumë. E inkurajojmë të ndajmë përvojën tonë ose të diskutojmë nëse nuk pajtoheni me diçka.
Burimi: habr.com
