

Përshëndetje të gjithëve, unë quhem Aleksandër dhe jam inxhinier i Cilësisë së të Dhënave, i cili merret me kontrollin e cilësisë së të dhënave. Në këtë artikull do të flas për mënyrën si e arrita këtë nivel dhe pse në vitin 2020 kjo drejtim testimi u bë i njohur.
Tendenca globale
Bota e sotme po kalon një revolucion tjetër teknologjik, një nga aspektet e të cilit është përdorimi nga kompanitë e të dhënave të grumbulluara për të rritur shitjet, fitimet dhe marketingun e tyre. Dukej se pikërisht disponimi i të dhënave të mira (cilësore), si dhe idetë e mençura që mund të prodhojnë para prej tyre (të përpunojnë, të vizualizojnë, të ndërtojnë modele të mësimit të makinerive etj.), janë çelësi i suksesit për shumë kompani sot. Nëse 15-20 vjet më parë, puna me grumbullimin dhe monetizimin e të dhënave ishin kryesisht në duar të kompanive të mëdha, sot kjo është një domosdoshmëri për çdo kompani që mendon për të ardhmen.
Për këtë arsye, disa vite më parë, të gjitha portalet që merren me kërkimin e punës në të gjithë botën filluan të mbushen me pozita për Data Scientists, pasi të gjithë ishin të sigurt se duke punësuar një specialist të tillë mund të ndërtojnë një supermodel të mësimit të makinerive, të parashikojnë të ardhmen dhe të bëjnë një «kërkesë kuantike» për kompaninë. Me kalimin e kohës, njerëzit kuptuan se ky qasje nuk funksiononte në shumicën e rasteve, pasi jo të gjithë të dhënat që vijnë në duar të specialistëve të tillë janë të përshtatshme për trajnim modelesh.
Dhe filluan kërkesat nga Data Scientists: «Le të blejmë më shumë të dhëna nga këta e ata...», «Na mungojnë të dhënat...», «Na nevojiten disa të dhëna, dhe sa më cilësore që të jenë...». Duke u bazuar në këto kërkesa, filluan të krijoheshin shumë ndërveprime midis kompanive që kishin në pronësi një sërë të dhënash. Natyrisht, kjo kërkoi organizimin teknik të këtij procesi — të lidhen me burimin e të dhënave, t'i shkarkojnë ato, të verifikojnë që ato janë ngarkuar në mënyrë të plotë etj. Numri i këtyre proceseve filloi të rritet, dhe sot kemi nevojë të madhe për specialistë të tjerë — inxhinierë të Cilësisë së të Dhënave — ata që do të mbikëqyrin rrjedhën e të dhënave në sistem (data pipelines), cilësinë e të dhënave në hyrje dhe dalje, do të bëjnë përfundime mbi mjaftueshmërinë, integritetin dhe karakteristika të tjera të tyre.
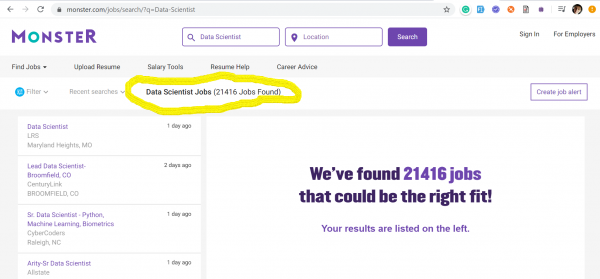
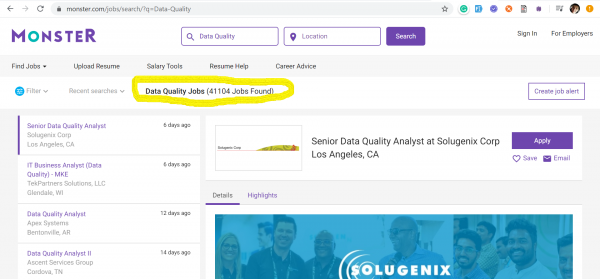
Trendi i inxhinierëve të Data Quality erdhi nga SHBA, ku në mesin e epokës që ka trazuar kapitalizmin, askush nuk është i gatshëm të humbasë betejën për të dhënat. Më poshtë kam paraqitur screenshot-e nga dy nga faqet më të njohura të kërkimit të punës në SHBA: dhe — ku janë shfaqur të dhënat e datës 17 mars 2020 në lidhje me numrin e vendeve të punës të postuara, sipas fjalëve kyçe: Data Quality dhe Data Scientist.
Data Scientists – 21416 vende pune
Data Quality – 41104 vende pune
Data Scientists – 404 vende pune
Data Quality – 2020 vende pune
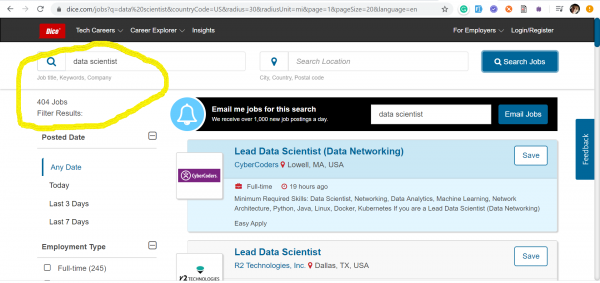
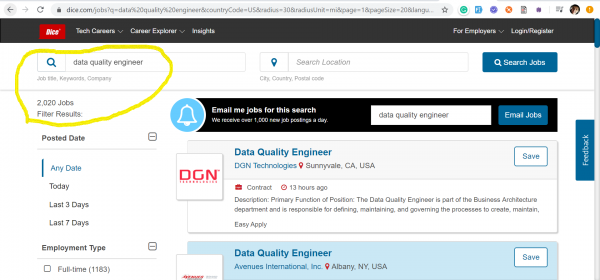
Është e qartë se këto profesione në asnjë mënyrë nuk konkurrojnë mes tyre. Me screenshot-et thjesht kam dashur të ilustroj situatën aktuale në tregun e punës në lidhje me kërkesat për inxhinierë të Data Quality, të cilët tani kërkohen shumë më tepër sesa Data Scientists.
Në qershor 2019, EPAM, duke u përgjigjur nevojave të tregut modern të IT-së, ndau fushën e Data Quality në një praktikë të veçantë. Inxhinierët e Data Quality gjatë punës së tyre të përditshme menaxhojnë të dhënat, kontrollojnë sjelljen e tyre në kushte dhe sisteme të reja, monitorojnë relevancën e të dhënave, mjaftueshmërinë dhe aktualitetin e tyre. Megjithatë, në praktikë, inxhinierët e Data Quality në të vërtetë i kushtojnë pak kohë testimit funksional klasik, POR kjo varet shumë nga projekti (shembuj do të jap më pas).
Detyrat e inxhinierit të Data Quality nuk kufizohen vetëm në kontrollet manuale/automatikë rutinë për "nulls, count dhe sums" në tabelat e DB, por kërkojnë një kuptim të thellë të nevojave të biznesit të klientit dhe, për pasojë, aftësinë për të transformuar të dhënat ekzistuese në informacion të dobishëm për biznesin.
Teoria e Data Quality
Për të kuptuar më së miri rolin e një inxhinieri të tillë, le të shqyrtojmë se çfarë është Data Quality në teori.
Data Quality — është një nga fazat e Data Management (një botë e tërë, të cilën do ta lëmë për studim të pavarur) dhe është përgjegjëse për analizimin e të dhënave sipas kritereve të mëposhtme:
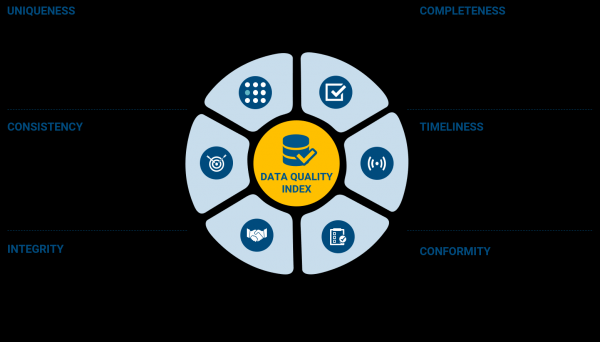
Mendoj se nuk ka nevojë të shpjegohet çdo pikë (teorikisht quhen «dimensionet e të dhënave»), ato janë përshkruar mirë në imazh. Por vetë procesi i testimit nuk nënkupton kopjimin e rreptë të këtyre veçorive në rastet e testimit dhe verifikimin e tyre. Në Cilësinë e të Dhënave, ashtu si në çdo formë tjetër testimi, është thelbësore të merret parasysh kërkesat për cilësinë e të dhënave, të dakorduar me pjesëmarrësit e projektit që marrin vendime biznesi.
Në varësi të projektit, inxhinieri i Cilësisë së të Dhënave mund të realizojë funksione të ndryshme: nga testuesi i zakonshëm i automatizuar me një vlerësim të sipërfaqshëm të cilësisë së të dhënave, deri te personi që kryen profilizimin e thellë në lidhje me veçoritë e përmendura më sipër.
Një përshkrim shumë i detajuar i proceseve të Menaxhimit të të Dhënave, Cilësisë së të Dhënave dhe të afërmve është përshkruar në një libër me titullin «DAMA-DMBOK: Trupi i Njohurive për Menaxhimin e të Dhënave: Botimi i 2-të». E rekomandoj këtë libër si një hyrje në këtë temë (mënyrën për ta gjetur do ta bëni në fund të artikullit).
Historia ime
Në industrinë IT kam kaluar nga Junior testues në kompanitë produktive deri në Lead Data Quality Engineer në kompaninë EPAM. Pas rreth dy vitesh pune si testues, kisha një bindje të fortë se kisha kryer të gjitha llojet e testimeve: regresion, funksional, stres, stabiliteti, siguria, UI, etj. — dhe kisha provuar shumë mjete testimi, duke punuar në të njëjtat kohë me tri gjuhë programimi: Java, Scala, Python.
Duke u kthyer pas, kuptoj pse grupi im i aftësive profesionale doli kaq i larmishëm — morem pjesë në projekte të lidhura me punën me të dhëna, të mëdha dhe të vogla. Kjo më çoi në botën e shumë mjeteve dhe mundësive për rritje.
Për të vlerësuar shumëllojshmërinë e mjeteve dhe mundësive për të marrë njohuri dhe aftësi të reja, mjafton të shikoni imazhin më poshtë, në të cilin janë përshkruar ato më popullore në botën e «Data & AI».
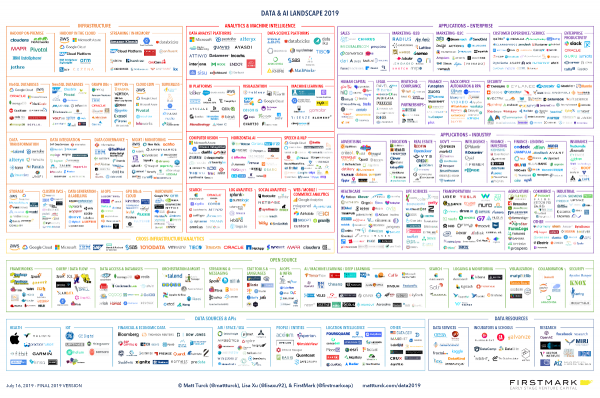
Të tilla ilustime përgatitet çdo vit nga një nga kapitalistët e njohur të riskut, Matt Turck, të cilit ka dalë nga zhvillimi i softuerit. Këtu është blogu i tij dhe , ku ai punon si partner.
Veçanërisht kam arritur të rritem profesionalisht shumë shpejt, kur isha testuesi i vetëm në projekt, ose, të paktën, në fillim të projektit. Në atë moment duhet të marr përgjegjësinë për të gjithë procesin e testimit, dhe nuk ke mundësinë të tërhiqesh, vetëm përpara. Në fillim kjo më frikësonte, megjithatë tani janë të qarta të gjitha përfitimet e një sfide të tillë:
- Fillon të komunikosh me të gjithë ekipin si kurrë më parë, sepse nuk ka asnjë ndërmjetës për komunikimin: as menaxher testi, as kolegë testuesish.
- Zhytesh në projekt në mënyrë të jashtëzakonshme të thellë, dhe ke informacion mbi të gjitha komponentët si në përgjithësi ashtu edhe në detaje.
- Zhvilluesit nuk të shohin si "atë djalin nga testi që nuk dihet çfarë bën", por më tepër si një të barabartë, i cili sjell një përfitim të jashtëzakonshëm për ekipin me testet e tij të automatizuara dhe parashikimin e shfaqjes së defekteve në një nyje specifike të produktit.
- Si rezultat — je më i efektshëm, më i kualifikuar, më i kërkuar.
Me rritjen e projektit, në 100% të rasteve unë bëhesha mentor për testuesit e rinj që vinin në të, i trajnoja ata dhe i kaloja njohuritë që kisha mësuar vetë. Për më tepër, varësisht nga projekti, nuk kam marrë gjithmonë nga menaxhmenti specialistë të testimit të automatizuar me nivel të lartë dhe ka qenë e nevojshme ose t'i trajnoj ata për automatizimin (për ata që dëshirojnë), ose të krijoj mjete për t'i përdorur ata në aktivitete të përditshme (mjete për gjenerimin e të dhënave dhe ngarkimin e tyre në sistem, mjet për kryerjen e testimeve të ngarkesës / testimeve të stabilitetit "me shpejtësi" etj.).
Shembulli i një projekti konkret
Fatkeqësisht, për shkak të angazhimeve për moszbulim, nuk mund të flas në detaje për projektet në të cilat kam punuar, megjithatë do të jap shembuj të detyrave tipike për Inxhinierin e Cilësisë së Të Dhënave në një nga projektet.
Thelbi i projektit — realizimi i një platforme për përgatitjen e të dhënave për trajnimin e modeleve të mësimit të makinerive mbi bazën e atyre të dhënave. Klienti ishte një kompani e madhe farmaceutike nga Shtetet e Bashkuara. Teknikisht ishte një klaster , që ngritej në instancave, me disa mikroshërbime dhe me një projekt Open Source në thelb nga kompania EPAM — , i adaptuar për nevojat e klientit të caktuar ( aktualisht projekti është transformuar në ). Proceset ETL u organizuan përmes dhe transferuan të dhënat nga sistemi i klientit në Buckets. Pastaj, në platformë u depërtua një imazh Docker i modelit të mësimit të makinerive, i cili u stërvit me të dhëna të reja dhe përmes ndërfaqes REST API ofronte parashikime që ishin të rëndësishme për biznesin dhe zgjidhnin probleme të veçanta.
Vizualisht, gjithçka dukej më pak kështu:
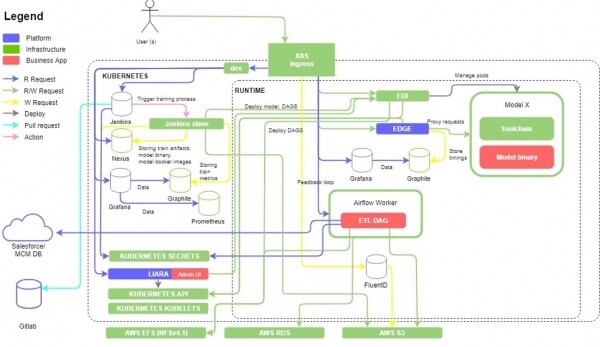
Testimi funksional në këtë projekt ishte më thanë mjaft i mjaftueshëm, dhe duke marrë parasysh shpejtësinë e zhvillimit të tipareve dhe nevojën për të ruajtur ritmin e ciklit të lëshimit (sprint-e dyjavore), ishte e nevojshme të mendoheshim menjëherë për automatizimin e testimit të nyjave më kritike të sistemit. Pjesa më e madhe e platformës, e cila kishte bazën e Kubernetes, ishte e mbuluar me teste automatike të realizuara në + Python, por ishte gjithashtu e nevojshme të ruhej dhe zgjerohej. Për më tepër, për lehtësinë e klientit, u krijua një GUI për menaxhimin e modeleve të mësimit të makinerive të deponuara në klaster, si dhe mundësia për të specifikuar se nga ku dhe ku duheshin transferuar të dhënat për stërvitjen e modeleve. Ky zgjerim i gjerë solli me vete zgjerimin e kontrollave funksionale automatike, të cilat kryesisht janë realizuar përmes thirrjeve REST API dhe një numri të vogël testesh end-2-end UI. Rreth ekuatorit të gjithë këtij procesi, na u bashkua një tester manual, i cili e menaxhoi mjaft mirë testimin e pranimit të versioneve të produktit dhe bisedën me klientin në lidhje me pranimin e lëshimit të radhës. Për më tepër, me shfaqjen e specialistit të ri, mundëm të dokumentojmë punën tonë dhe të shtojmë disa kontrolle manuale shumë të rëndësishme, të cilat ishte e vështirë t'i automatizojmë menjëherë.
Dhe fund, pasi arritëm stabilitetin nga platforma dhe ndërfaqja grafike që e mbështet atë, ne filluam ndërtimin e pipeline-ve ETL duke përdorur DAG-të e Apache Airflow. Kontrolli automatizuar i cilësisë së të dhënave u realizua duke shkruar DAG të veçantë Airflow që kontrollonin të dhënat sipas rezultateve të procesit ETL. Në kuadër të këtij projekti, pata fatin, dhe klienti na ofroi akses në grupe të dhënash të anonomizuara, në të cilat ne testoheshim. Këto të dhëna u kontrolluan rresht për rresht për përputhshmërinë me llojet, praninë e të dhënave të prishura, numrin total të regjistrimeve para dhe pas, krahasimin e transformimeve të kryera nga procesi ETL për agregimin, ndryshimin e emrave të kolonave dhe të tjera. Për më tepër, këto kontrollime u zgjeruan në burime të ndryshme të të dhënave, për shembull përveç SalesForce, gjithashtu edhe në MySQL.
Kontrollimet e cilësisë së fundit të të dhënave u realizuan tashmë në nivelin S3, ku ato ruheshin dhe ishin në gjendje ready-to-use për trajnimin e modeleve të mësimit të makinës. Për të marrë të dhënat nga skedari përfundimtar CSV, që ndodhej në S3 Bucket dhe për validimin e tyre, u shkrua një kod duke përdorur .
Gjithashtu, nga ana e klientit kishte një kërkesë për ruajtjen e një pjese të të dhënave në një S3 Bucket, një pjese në një tjetër. Për këtë gjithashtu ishte e nevojshme të shkruheshin kontrollime shtesë, që kontrollojnë besueshmërinë e kësaj renditjeje.
Përvoja e përgjithshme nga projekte të tjera
Shembulli i listës më të gjerë të aktiviteteve të inxhinierit të Cilësisë së të Dhënave:
- Të përgatisë të dhëna testuese (të vlefshme, të pavlefshme, të mëdha, të vogla) përmes një instrumenti automatizuar.
- Të ngarkojë grupin e përgatitur të të dhënave në burimin origjinal dhe të verifikojë gatishmërinë e tij për përdorim.
- Të aktivizojë proceset ETL për trajtimin e grupit të të dhënave nga depoja origjinale në atë përfundimtare apo ndërmjet një seti të caktuar të parametrave (në rast se është e mundur të jepen parametra konfiguroheshëm për detyrën ETL).
- Të verifikojë të dhënat e përpunuara nga procesi ETL për cilësinë e tyre dhe përputhshmërinë me kërkesat e biznesit.
Megjithatë, theksi kryesor i kontrolleve duhet të bie jo vetëm në atë që fluksi i të dhënave në sistem ka funksionuar në përgjithësi dhe ka arritur në fund (çka është pjesë e testimit funksional), por për më shumë në kontrollin dhe validimin e të dhënave për t'iu përmbajtur kërkesave të pritur, identifikimin e anomalive dhe të tjera.
Mjetet
Një nga teknikat e tilla të kontrollit të të dhënave mund të jetë organizimi i kontrollit të zinxhirëve në çdo fazë të përpunimit të të dhënave, i njohur në literaturë si 'data chain' — kontrolli i të dhënave nga burimi deri në pikën e përdorimit përfundimtar. Kontrolli i këtij lloji realizohet më së shumti përmes shkruarjes së pyetjeve SQL kontrolluese. E kuptueshme, këto pyetje duhet të jenë sa më të lehta dhe kontrollojnë pjesët e veçanta të cilësisë së të dhënave (metadata e tabelave, rreshta bosh, NULL, gabime në sintaksë — atributet e tjera të kërkuara për kontroll).
Në rastin e testimit regresiv, në të cilin përdoren tashmë grupe të dhënash të gatshme (të palëvizshme ose të ndryshueshme pak), në kodin e testave automatike mund të ruhen tashmë modele të gatshme të kontrollit të të dhënave për përputhshmëri me cilësinë (përshkrimet e metadatave të pritura të tabelave; objektet përzgjedhëse të rastësishme që mund të përzgjidhen gjatë testit dhe të tjera).
Po ashtu, gjatë testimit është e nevojshme të shkruhen procese testuese ETL, përmes strukturave të tilla si Apache Airflow, ose plotësisht mjete cloud black-box si , dhe të tjera. Ky rrethanë e detyron inxhinierin e testimit të thellohet në parimet e funksionimit të mjeteve të përmendura dhe të realizojë më efektivisht si testimin funksional (për shembull, të proceseve ETL ekzistuese në projekt), ashtu edhe t'i përdorë ato për kontrollin e të dhënave. Në veçanti, për Apache Airflow ekzistojnë tashmë operatorë të gatshëm për punë me bazat e të dhënave analitike popullore siç është . Një shembull themelor i përdorimit të tij tashmë është paraqitur, prandaj nuk do të përsëris.
Përveç zgjidhjeve të gatshme, askush nuk e ndalon që të realizoni teknikat dhe mjetet tuaja. Kjo do të jetë e dobishme për projektin, por edhe për vetë Inxhinierin e Cilësisë së të Dhënave, i cili kështu do të përmirësojë horizontin e tij teknik dhe aftësitë e kodimit.
Si funksionon kjo në një projekt real
Një ilustërim i mirë i paragrafëve të fundit rreth 'data chain', ETL dhe kontrollit të gjithanshëm është procesi i mëposhtëm nga një prej projekteve reale:
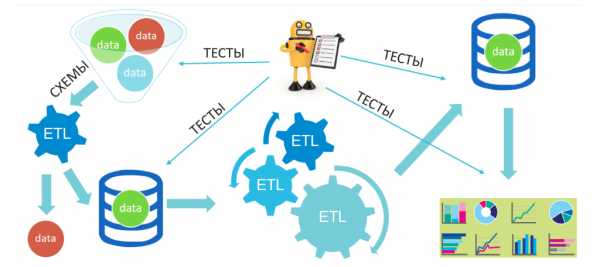
Këtu në 'funnel'-in e sistemit tonë hyjnë të dhëna të ndryshme (natyrisht, të përgatitura nga ne): të sakta, të pasakta, të kombinuara etj., pastaj ato filtrohen dhe kalojnë në një depo ndërmjetëse, më pas i pret një seri e re transformimesh dhe vendosja në depozita përfundimtare, nga e cila, për pasojë, do të kryhet analiza, ndërtimi i paneleve të dhënash dhe kërkimi i njohurive të biznesit. Në një sistem të tillë, pa kontrolluar funksionalitetin e proceseve ETL, ne fokusohemi në cilësinë e të dhënave para dhe pas transformimeve, si dhe në daljen në analizë.
Përmbledhja e asaj që u tha më sipër, pavarësisht nga vendet ku kam punuar, kam qenë gjithmonë i përfshirë në projekte Data, të cilat kishin këto karakteristika:
- Vetëm përmes automatizimit mund të kontrollohen disa raste dhe të arrihet një cikël lëshimi i pranueshëm për biznesin.
- Testuesi në një projekt të tillë është një nga anëtarët më të respektuar të ekipit, pasi sjell një dobi të madhe për të gjithë pjesëtarët (shpejtimi i testimeve, të dhëna të mira për Data Scientist, identifikimi i defekteve në fazat e hershme).
- Nuk ka rëndësi në pajisjet tuaja punoni apo në re — të gjitha burimet janë të abstractuara në një klasë si Hortonworks, Cloudera, Mesos, Kubernetes etj.
- Projektet ndërtohen mbi një qasje mikroshërbimi, dominuese janë llogaritjet e shpërndara dhe paralel.
Dua të theksoj se, duke u marrë me testimin në fushën e Cilësisë së Të Dhënave, specialisti i testimit e zhvendos profesionin e tij në kodin e produktit dhe mjetet e përdorura.
Karakteristikat dalluese të testimit të Cilësisë së Të Dhënave
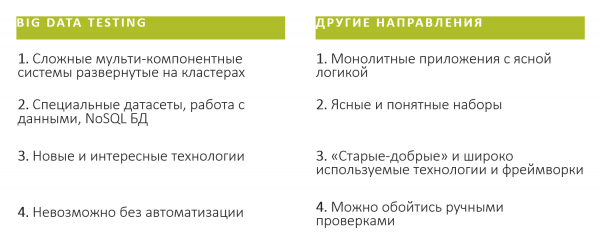
Përveç kësaj, për veten time, kam identifikuar karakateristika të tjera (dhe dua të theksoj SHUMË të përgjithësuara dhe ekskluzivisht subjektive) dalluese të testimit në projektet Data (Big Data) dhe drejtime të tjera:
Useful links
- Teoria: .
- EPAM
- Materiale të rekomanduara për inxhinierët e rinj të Cilësisë së Të Dhënave:
- Kurs falas në Stepik: .
- Kurs në LinkedIn Learning: .
- Artikuj:
- ;
- ;
- ;
- Video:
- ;
- ;
Përfundim
Data Quality — kjo është një drejtim shumë i ri dhe perspektivë, të jesh pjesë e të cilit do të thotë të jesh pjesë e një startup-i. Duke u futur në Data Quality, do të zhytësh në një sërë të madhe teknologjish moderne dhe të kërkuara, por më e rëndësishmja — do të hapen para teje mundësi të mëdha për të gjeneruar dhe realizuar idetë tuaja. Do të mund të aplikosh qasjen e përmirësimit të vazhdueshëm jo vetëm në projekt, por edhe për veten, duke u zhvilluar vazhdimisht si specialist.
Burimi: habr.com
