

Kanarinë — një zog i vogël që këndon vazhdimisht. Këto zogj janë të ndjeshëm ndaj metanit dhe gazit të karbonit. Edhe nga përqendrimi i vogël i gazrave në ajër, ata humbasin ndjenjat ose vdesin. Gjuetarët e arit dhe minatorët i marrin zogjtë me vete: përderisa kanarinat këndojnë, mund të punosh, po u ndalën — ka gaz në minierë dhe është koha për të ikur. Minatorët sakrifikojnë këtë zog të vogël për të dalë nga minierat të gjallë.
Një praktikë e tillë ka gjetur vend edhe në IT. Për shembull, në detyrën standarde të vendosjes së një versi të ri të shërbimit ose aplikacionit në prodhim me testim përpara. Mjedisi i testimit mund të jetë shumë i shtrenjtë, testet e automatizuara nuk mbulojnë gjithçka që do të donim, dhe të mos testohet duke sakrifikuar cilësinë është e rrezikshme. Në raste si këto ndihmon qasja e Canary Deployment, kur një pjesë e saktë e trafikut të prodhimit lëshohet në versionin e ri. Qasja ndihmon sigurisht të verifikohet versione e re në prodhim, duke sakrifikuar pak për një qëllim të madh. Më shumë, si funksionon qasja, çfarë përfitimesh ofron dhe si mund të realizohet, do të tregojë Andrei Markelov (), me shembuj nga realizimi në kompaninë Infobip.
Andrei Markelov — inxhinier kryesor programues në Infobip, i cili tashmë 11 vjet merret me zhvillimin e aplikacioneve në Java në fushën e financave dhe telekomunikacioneve. Zhvillon produkte Open Source, merr pjesë aktivisht në Atlassian Community dhe shkruan plugin-e për produktet e Atlassian. Evangelist për Prometheus, Docker dhe Redis.
Rreth kompanisë Infobip
Kjo është një platformë globale telekomunikacionesh që lejon bankat, ata që merren me pakicat, dyqanet online dhe kompanitë e transportit të dërgojnë mesazhe klientëve të tyre nëpërmjet SMS, push, email-e dhe mesazheve me zë. Në këtë biznes, stabiliteti dhe besueshmëria janë të rëndësishme, që klientët të marrin mesazhet në kohë.
Infrastruktura IT e Infobip në numra:
- 15 qendra të dhënash në të gjithë botën;
- 500 shërbime unike në përdorim;
- 2500 ekzemplarë shërbimesh, shumë më tepër se numri i ekipeve;
- 4.5 Tbyte trafik muajor;
- 4.5 miliardë numra telefoni;
Biznesi po rritet, dhe për pasojë edhe numri i lëshimeve. Ne realizojmë rreth 60 lëshime në ditë, sepse klientët dëshirojnë më shumë funksionalitete dhe kapacitete. Por kjo është e komplikuar — ka shumë shërbime, dhe pak ekipe. Kjo na detyron të shkruajmë shpejt kod, i cili duhet të funksionojë në prodhim pa gabime.
Lëshimet
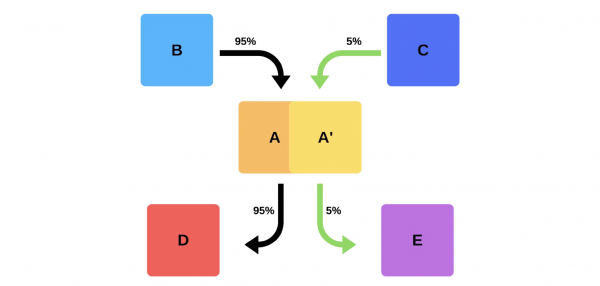
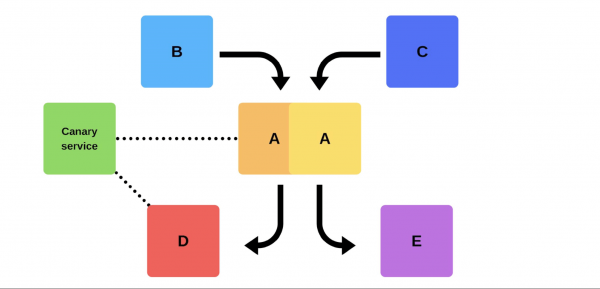
Një publikim tipik në kompaninë tonë ndodh kështu. Për shembull, kemi shërbimet A, B, C, D dhe E, secili prej tyre zhvillohet nga një ekip i veçantë.
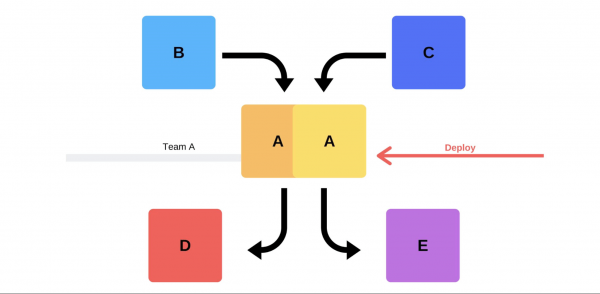
Në një moment, ekipi i shërbimit A vendos të publikojë një version të ri, por ekipet e shërbimeve B, C, D dhe E nuk e dinë këtë. Janë dy mundësi se si do të veprojë ekipi i shërbimit A.
Do të kryejë lëshim incremental: fillimisht do të zëvendësojë një version, pastaj versionin tjetër.
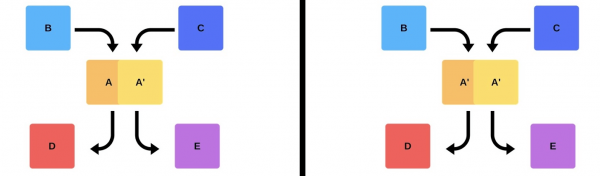
Por ka një mundësi të dytë: ekipi do të gjejë burime dhe makineri shtesë, do të publikojë versionin e ri dhe pastaj do të kalojë në router, dhe versioni do të fillojë të funksionojë në prodhim.
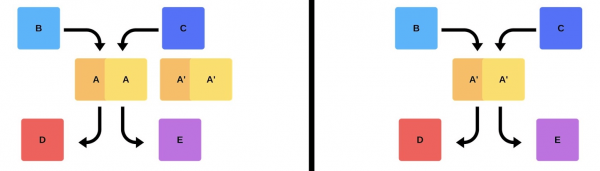
Në çdo rast, pas publikimit pothuajse gjithmonë ndodhin probleme, edhe nëse versioni është testuar. Testimi mund të bëhet manualisht, mund të jetë automatizuar, ose mund të mos testohet fare — problemet do të ndodhin pa marrë parasysh. Mënyra më e thjeshtë dhe e saktë për t'i zgjidhur është të kthehemi në një version funksional. Më pas mund të merremi me dëmin, shkaqet dhe t'i korrigjojmë ato.
Pra, çfarë duam?
Nuk na duhen probleme. Nëse klientët i zbulojnë ato më shpejt se ne, kjo do të dëmtojë reputacionin tonë. Kështu që ne duhet të gjejmë problemet më shpejt se klientët. Duke punuar në avancim, minimizojmë dëmin.
Në të njëjtën kohë, ne duam të përshpejtojmë publikimin, që kjo të ndodhë shpejt, lehtë, natyrshëm dhe pa stres nga ana e ekipit. Inxhinierët, inxhinierët DevOps dhe programuesit duhet të ruhen — publikimi i një versioni të ri është stresues. Ekipi nuk është një material shpenzues, ne synojmë të përdorim racionalisht burimet njerëzore..
Problemet e publikimit
Trafiku i klientëve është i paparashikueshëm.Nuk është e mundur të parashikohet kur trafiku i klientëve do të jetë minimal. Ne nuk e dimë se ku dhe kur klientët do të fillojnë fushatat e tyre — ndoshta sonte në Indi, dhe nesër në Hong Kong. Duke marrë parasysh diferencat e mëdha në kohë, publikimi madje edhe në orën 2 të natës nuk garanton që klientët nuk do të dëmtohen.
Problemet me ofruesit.Mesazhet dhe ofruesit janë partnerët tanë. Ndonjëherë ata përballen me ndërprerje, të cilat shkaktojnë gabime gjatë publikimit të versioneve të reja.
Ekipet e shpërndara.Ekipet që zhvillojnë pjesën klientike dhe back-end janë në zona të ndryshme kohore. Për shkak të kësaj, shpesh ata nuk arrijnë të bien dakord mes tyre.
Qendrat e të dhënave nuk mund të ripërseriten në skenë.Në një qendër të dhënash ka 200 raftë — ta ripërsërisësh këtë në një ambient testimi nuk do të arrijë as edhe në afërsisht.
Përgjigjetnuk janë të pranueshme! Ne kemi një nivel të pranueshëm të disponueshmërisë (Error Budget), kur punojmë 99,99% të kohës, dhe përqindjet e mbetura janë "të drejta për gabime". Ardhja në 100% besueshmëri është e pamundur, por është e rëndësishme të monitorosh vazhdimisht rënie dhe ndërprerje.
Zgjidhje klasike
Të shkruash kod pa gabime. Kur isha një zhvillues i ri, menaxherët më afrojnë me kërkesa për të bërë një lansim pa gabime, por kjo nuk është gjithmonë e mundur.
Të shkruash teste. Testet funksionojnë, por ndonjëherë jo ashtu siç e dëshiron biznesi. Të fitosh para nuk është detyra e testeve.
Të testosh në skenë. Gjatë 3.5 viteve të punës sime në Infobip, nuk kam parë asnjëherë që gjendja e skenës të përputhet edhe pjesërisht me prodhimin.
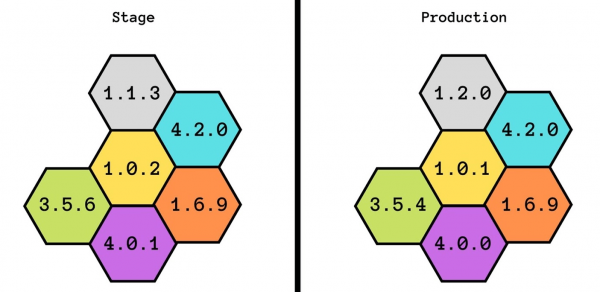
Ne madje përpiqeshim të zhvillonim këtë ide: fillimisht kishim skenën, pastaj para-produksionin, dhe më pas para-produksionin e para-produksionit. Por as kjo nuk ndihmoi - nuk përputheshin as në kapacitet. Me skenën mund të garantojmë funksionalitetin bazë, por nuk e dimë se si do të funksionojë nën ngarkesa.
Lansimin e bën ai që e zhvilloi. Kjo është një praktikë e mirë: madje nëse dikush ndryshon emrin e komentit, e shton menjëherë në prodhim. Kjo ndihmon në zhvillimin e përgjegjësisë dhe në të mos harruar ndryshimet e bëra.
Ka edhe vështirësi të tjera. Për zhvilluesin, është stresuese të kalosh shumë kohë për të kontrolluar gjithçka manualisht.
Lansime të dakorduara. Kjo mundësi zakonisht ofrohet nga menaxhmenti: "Le të biem dakord që çdo ditë të testoni dhe të shtoni versione të reja". Kjo nuk funksionon: gjithmonë ka një ekip që pret të tjerët ose anasjelltas.
Teste smoke
Një mënyrë tjetër për të zgjidhur problemet tona me-deploy. Le të shqyrtojmë se si funksionojnë testet smoke në shembullin e mëparshëm, kur ekipi A dëshiron të bëjë deploy një version të ri.
Fillimisht ekipi bën deploy një instance në prodhim. Me mesazhe në instance nga mock imitohet trafiku real, në mënyrë që të përputhet me trafikun normal të përditshëm. Nëse gjithçka shkon mirë, ekipi kalon versionin e ri në trafikun e përdoruesve.
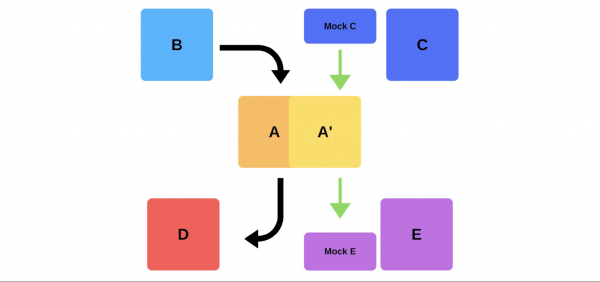
Varianti i dytë është të bësh deploy me pajisje shtesë. Ekipi e teston në prodhim, pastaj kalon, dhe gjithçka funksionon.
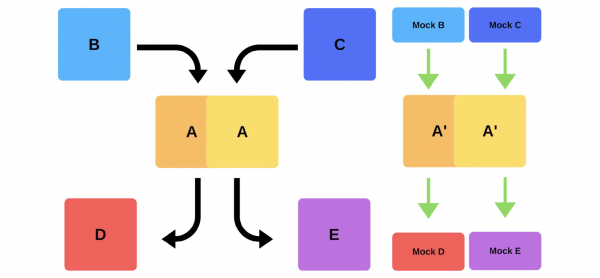
Këto janë disavantazhet e testeve smoke:
- Testimeve nuk mund t’i besohet. Ku mund të marrim të njëjtin trafik si në prodhimin? Mund të përdorim atë të djeshmin ose të javës së kaluar, por nuk përputhet gjithmonë me të tanishmin.
- E vështirë për t'u mbajtur. Do duhet të mbajmë llogaritë testuese, t’i rikthejmë vazhdimisht para çdo deploy-i, kur në depo dërgohen të dhëna aktive. Kjo është më e komplikuar se të shkruash një test në sandboxes-in e tua.
Bonusi i vetëm këtu është mund të kontrollosh performancën.
Lëshime Canary
Për shkak të disavantazheve të testeve smoke, filluam të përdorim lëshimet canary.
Një praktikë, e ngjashme me mënyrën se si minatorët përdorin kanarinat për të treguar nivelin e gazrave, ka gjetur vend dhe në IT. Ne lëshojmë pak trafik të vërtetë nga prodhimi në versionin e ri, duke u përpjekur të respektojmë Marrëveshjen e Nivelit të Shërbimit (SLA). SLA është e drejta jonë për gabim, që mund ta përdorim një herë në vit (ose për një periudhë tjetër). Nëse gjithçka shkon mirë, do të shtojmë më shumë trafik. Nëse jo, do të rikthejmë versionet e mëparshme.
Zbatimi dhe nuancat
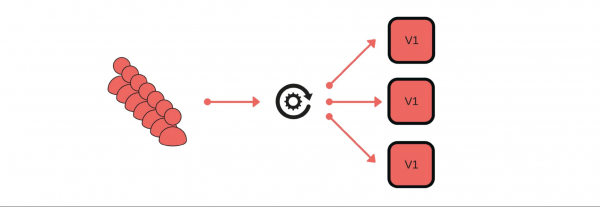
Si e implementuam lëshimin canary? Për shembull, një grup klientësh dërgon mesazhe përmes shërbimit tonë.
Deploy-i kalon kështu: heqim një nyje nga balancuesi (1), ndryshojmë versionin (2) dhe veç do të lëshojmë pak trafik (3).
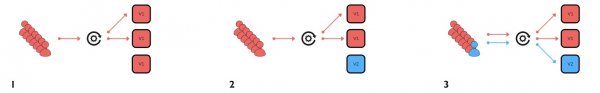
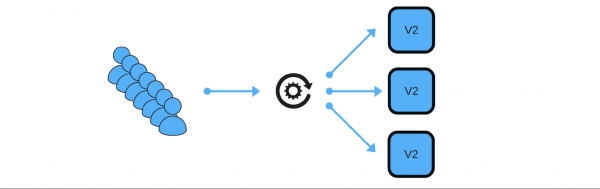
Në përgjithësi, në grup do të jenë të lumtur të gjithë, edhe nëse një përdorues është i pakënaqur. Nëse gjithçka shkon mirë, i ndryshojmë të gjitha versionet.
Do të tregoj diagramikisht se si duket kjo për mikroshërbimet në shumicën e rasteve.
Ka Zbulim Shërbimi dhe dy shërbime të tjera: S1N1 dhe S2. Shërbimi i parë (S1N1) njofton Zbulimin e Shërbimit kur nis, dhe Zbulimi i Shërbimit e mban mend. Shërbimi i dytë me dy nyje (S2N1 dhe S2N2) gjithashtu njofton Zbulimin e Shërbimit në fillim.
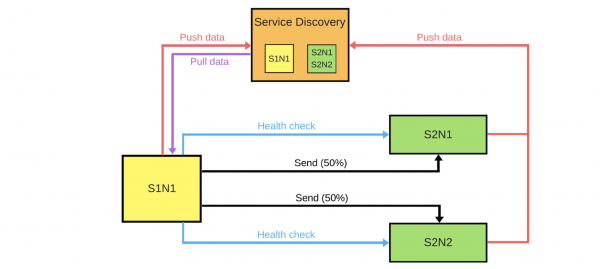
Shërbimi i dytë për të parin funksionon si server. I pari kërkon nga Zbulimi i Shërbimit informacionin për serverët e tij, dhe kur e merr, kërkon dhe verifikon ata (‘kontrolli i shëndetit’). Kur e verifikon, do t’i dërgojë ata mesazhe.
Kur dikush dëshiron të lëshojë një version të ri të shërbimit të dytë, informon Zbulimin e Shërbimit se nyja e dytë do të jetë nyjë canary: do të dërgohet më pak trafik në të, sepse tani do të kalojë deploy-i. Heqim nyjën canary nga balancuesi dhe shërbimi i parë nuk dërgon trafik në të.
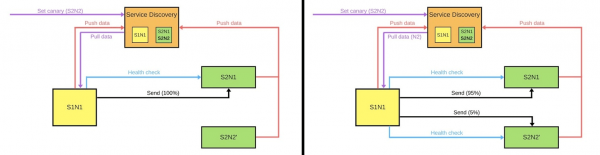
Ndryshojmë versionin dhe Shërbimi i Zbulimit e di se skena e dytë tani është canary — mund t'i japim asaj më pak ngarkesë (5%). Nëse gjithçka shkon mirë, ndryshojmë versionin, kthejmë ngarkesat dhe vazhdojmë punën.
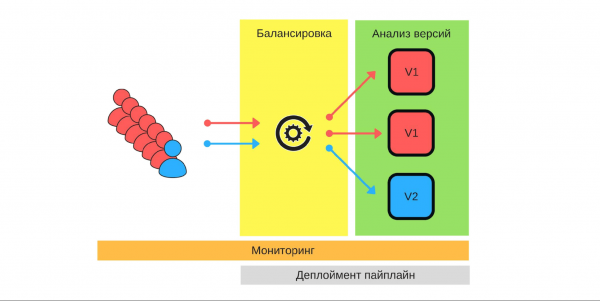
Për të realizuar të gjithë këtë, na nevojiten:
- balancimi;
- monitorimi, pasi është e rëndësishme të dimë se çfarë pret çdo përdorues dhe si funksionojnë detajisht shërbimet tona;
- analiza e versioneve, për të kuptuar sa mirë do të funksionojë versioni i ri në prodhim;
- automatizimi — shkruajmë sekuencën e zhvillimit (deployment pipeline).
Balancimi
Ky është i pari çështje për të cilën duhet të mendojmë. Ka dy strategji balancimi.
Varianti më i thjeshtë, kur një skenë gjithmonë është canary.Kjo skenë gjithmonë merr më pak trafik dhe ne fillojmë me të. Në rast problemesh, ne do të krahasojmë punën e saj para dhe gjatë zhvillimit. Për shembull, nëse numri i gabimeve është dyfishuar, atëherë edhe dëmi është rritur dyfish.
Skena canary përcaktohet gjatë procesit të zhvillimit. Kur zhvillimi të përfundojë dhe ne t'i heqim statusin e canary-së, balanca e trafikut do të rikthehet. Me një numër më të vogël makinash do të kemi një shpërndarje të ndershme.
Monitorimi
Pika thelbësore e canary-releases. Duhet të kuptojmë saktësisht pse po e bëjmë këtë dhe cilat metrika duam të mbledhim.
Shembuj metrikash që ne mbledhim nga shërbimet tona.
- Numri i gabimeve, të cilat shkruhen në loge. Ky është një tregues i qartë se gjithçka funksionon siç duhet. Në përgjithësi, kjo është një metrikë e mirë.
- Koha e ekzekutimit të kërkesave (latency). Këtë metrikë e monitorojnë të gjithë, sepse të gjithë duan të punojnë shpejt.
- Madhësia e radhës (throughput).
- Numri i përgjigjeve të suksesshme në sekondë.
- Koha e ekzekutimit për 95% të të gjitha kërkesave.
- Metrikat e biznesit: sa para fiton biznesi në një kohë të caktuar apo ndjeshmërinë e përdoruesve. Këto metrika për versionin tonë të ri mund të jenë më të rëndësishme se ato që shtojnë inxhinierët.
Shembuj të metrikave në shumicën e sistemeve të njohura të monitorimit.
Counter. Ky është një sasi në rritje, për shembull, numri i gabimeve. Këtë metrikë është e thjeshtë ta interpolosh dhe të studiohet grafiku: dje kishte 2 gabime, ndërsa sot 500, pra diçka shkoi keq.
Numri i gabimeve më të minutë apo sekondë, është një tregues kritike që mund të llogaritet duke përdorur Counter. Këto të dhëna ofrojnë një pamje të qartë mbi funksionimin e sistemit në distancë. Le të shqyrtojmë një shembull të grafikut të numrit të gabimeve në sekondë për dy versionet e sistemit prodhues.
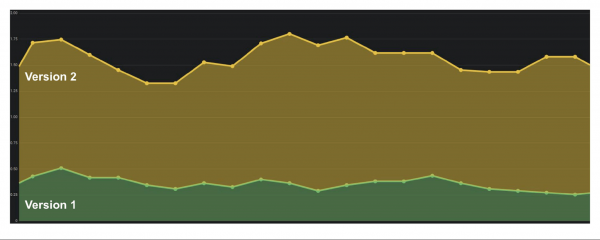
Në versionin e parë kishte pak gabime, ndoshta nuk funksiononte auditi. Në versionin e dytë është shumë më keq. Mund të themi me siguri se ka probleme, prandaj duhet të kthejmë këtë version.
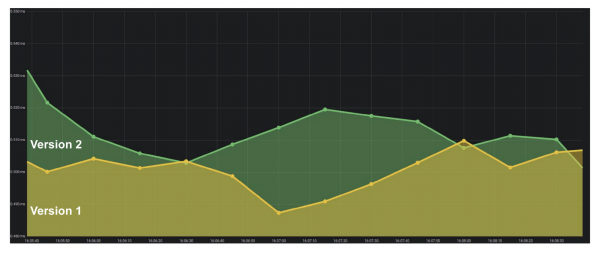
Gauge. Metriçet janë të ngjashme me Counter, por ne regjistrojmë vlera që mund të rriten ose të ulen. Për shembull, koha e ekzekutimit të pyetjeve ose madhësia e radhës.
Në grafik është një shembull i kohës së përgjigjes (latency). Nga grafiku duket se versionet janë të ngjashme, dhe mund të punojmë me to. Por nëse e shikoni me kujdes, do të vëreni se si ndryshon madhësia. Nëse koha e ekzekutimit të pyetjeve rritet kur shtohen përdoruesit, atëherë menjëherë kuptohet se ka probleme — më parë nuk kishte diçka të tillë.
Përmbledhje. Një nga treguesit më të rëndësishëm për biznesin janë percentilet. Metriça tregon se në 95% të rasteve sistemi ynë funksionon ashtu siç duam. Mund të pajtohemi nëse ndodhin probleme ndonjëherë, sepse e kuptojmë tendencën e përgjithshme, sesa mirë ose keq është gjithçka.
Mjetet
ELK Stack. Mund të realizohet canary duke përdorur Elasticsearch — e regjistrojmë atë në sistem për gabimet që ndodhin. Me një thirrje të thjeshtë API mund të marrim numrin e gabimeve në çdo moment dhe të krahasojmë me periudhat e kaluara: GET /applg/_cunt?q=level:errr.
Prometheus. U tregua mirë në Infobip. Ai lejon të realizojmë metriça multidimensionale, për shkak se përdoren etiketat.
Mund të përdorim level, instance, shërbim, të kombinojmë ato në një sistem. Me ndihmën e offset mund të shikojmë, për shembull, vlerën e madhësisë një javë më parë vetëm me një komandë GET /api/v1/query?query={query}index {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Analiza e Versioneve
Ka disa strategji për analizën e versioneve.
Të shikojmë metriçet e vetëm canary-nodës. Një nga opsionet më të thjeshta: kemi vendosur një version të ri dhe studiojmë vetëm funksionimin. Por nëse inxhinieri në atë kohë fillon të studiojë log-et, duke e rifreskuar vazhdimisht faqen, atëherë kjo zgjidhje nuk është ndryshe nga të tjerat.
Canary-noda krahasohet me çdo nodë tjetër. Kjo është një krahasim me instance të tjera që punojnë me trafik të plotë. Për shembull, nëse me trafik të vogël gjërat shkojnë më keq, ose jo më mirë se në instance reale, atëherë diçka nuk është në rregull.
Canary-noda krahasohet me veten e saj në të kaluarën. Nodet e caktuara për canary mund të krahasohen me të dhënat historike. Për shembull, nëse një javë më parë gjithçka shkonte mirë, atëherë mund të bazojmë në këto të dhëna për të kuptuar situatën aktuale.
Automatizimi
Duam t'i çlironi inxhinierët nga krahasimi manual, prandaj është e rëndësishme të realizohet automatizimi. Procesi i depolimit (deployment pipeline) zakonisht duket kështu:
- fillojmë;
- heqim nodën nga balanceri;
- vendosim nodën canary;
- aktivizojmë balancerin tashmë me një sasi të kufizuar trafiku;
- krahasoni.
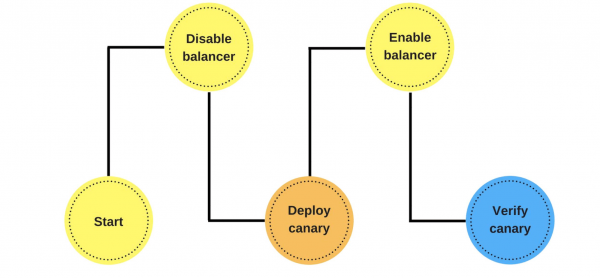
Në këtë fazë realizojmë krahasimin automatik. Si mund të duket dhe pse është më mirë sesa kontrolli pas depolimit, do ta shqyrtojmë me një shembull nga Jenkins.
Ky është pipeline në Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary dështoi, duhet të kthehemi"
        return false
    }
}
Këtu në cikël caktojmë se do të krahasojmë nodën e re për një orë. Nëse procesi canary ende nuk ka përfunduar — thërrasim funksionin. Ai njofton nëse gjithçka është mirë apo jo: def isOk = compare(srv, canary, time, base, offset, metrics).
Nëse gjithçka është mirë — sleep DEFAULT SLEEP, për shembull, për një sekondë, dhe vazhdojmë. Nëse jo, dalim — depolimi dështoi.
Përshkrimi i metrikës. Të shohim se si mund të duket funksioni compare në shembullin DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Supozoni se po krahasojmë numrin e gabimeve dhe duam të dimë numrin e gabimeve për sekondë në pesë minutat e fundit.
Kemi dy vlera: bazën dhe nodën canary. Vlera në nodën canary — aktuale. Baza është baseValue — kjo është vlera e çdo nodë tjetër që nuk është canary. Krahasojmë vlerat me njëri-tjetrin sipas formulës që vendosim bazuar në përvojën dhe vëzhgimet tona. Nëse vlera canaryValue është e keqe, atëherë depolimi dështoi dhe ne kthehemi mbrapa.
Pse është e nevojshme gjithë kjo?
Njeriu nuk mund të kontrollojë qindra dhe mijëra metrika, aq më tepër ta bëjë këtë shpejt. Krahasimi automatik ndihmon në kontrollimin e të gjitha metrikave dhe njofton shpejt për problemet. Koha e njoftimit është kritike: nëse diçka ndodh në dy sekondat e fundit, atëherë dëmi do të jetë jo aq i madh sa nëse do të kishte ndodhur 15 minuta më parë. Ndërkohë që dikush do ta vërë re problemin, do të kontaktojë mbështetje, dhe mbështetja do të na kthejë, mund të humbasim klientë.
Nëse procesi kaloi dhe gjithçka ishte në rregull, ne automatizojmë zhvillimin e të gjitha node-ve të tjera. Në këtë kohë, inxhinierët nuk bëjnë asgjë. Vetëm kur ata nisin canary, vendosin se cilat metrika të përdorin, sa kohë të krahasojnë, cila strategji të ndjekin.
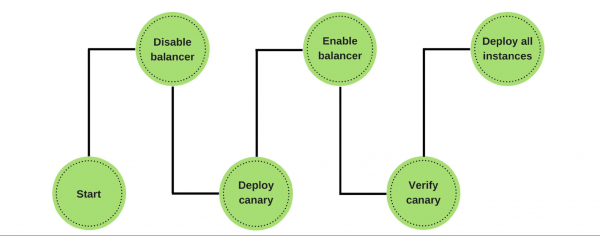
Nëse ndodhin probleme, ne automatizojmë rikthimin e node-së canary, punojmë me versionet e kaluara dhe rregullojmë gabimet që kemi gjetur. Me metrikat, ato janë të lehta për t'u gjetur dhe për të parë dëmin nga versioni i ri.
Pengesat
Të realizosh këtë, natyrisht, nuk është e lehtë. Para së gjithash, nevojitet një sistem i përbashkët monitorimi. Inxhinierët kanë metrikat e tyre, mbështetja dhe analistët kanë të tjera, biznesi ka të treta. Një sistem i përbashkët është gjuha e përbashkët me të cilën flasin biznesi dhe zhvillimi.
Duhet të kontrollojmë në praktikë stabilitetin e metrikave. Kontrolli ndihmon të kuptojmë, cili është seti minimal i metrikave që nevojitet për të siguruar cilësinë.
Si ta arrijmë këtë? Të përdorim shërbimin canary jo në momentin e zhvillimit. Shtojmë në versionin e vjetër një shërbim të caktuar, i cili në çdo moment mund të marrë ndonjë node të veçantë, të zvogëlojë trafikun pa zhvillim. Pas kësaj, krahasojmë: studiojmë gabimet dhe kërkojmë atë pikën, kur arrijmë cilësinë.
Cila është përfitimi nga lirimet canary?
Minimizuam përqindjen e dëmit nga gabimet. Shumica e gabimeve gjatë zhvillimit ndodhin për shkak të moskoherencës së disa të dhënave ose prioriteteve. Të tilla gabime kanë ndodhur shumë më pak, sepse mund ta zgjidhim problemin në sekondat e para.
Optimizuam punën e ekipeve. Të rinjtë kanë "të drejtën e gabimit": ata mund të zhvillojnë në prodhim pa frikë se do të gabojnë, shfaqet një iniciativë shtesë, stimuj për të punuar. Nëse ata bëjnë ndonjë gjë që e prish, atëherë nuk do të jetë kritike, dhe nuk do të pushohen për atë që ka gabuar.
Automatizuam zhvillimin. Kjo tashmë nuk është një proces manual, siç ishte më parë, por një proces i vërtetë automatik. Por zgjat më shumë.
Identifikuam metrikat e rëndësishme. I gjithë kompania, duke filluar nga biznesi dhe inxhinierët, kupton se çfarë është me të vërtetë e rëndësishme në produktin tonë, cilat metrika, për shembull, janë shkëputja dhe prurja e përdoruesve. Ne kontrollojmë procesin: testojmë metrikat, prezantojmë të reja, shohim se si punojnë të vjetrat, për të ndërtuar një sistem që do të fitojë para më produktivisht.
Kemi shumë praktika dhe sisteme të shkëlqyera që na ndihmojnë. Pavarësisht kësaj, ne përpiqemi të jemi profesionistë dhe ta bëjmë punën tonë me cilësi, pa marrë parasysh nëse kemi një sistem që na ndihmon apo jo.
Qasjet dhe praktikat inxhinierike — . Nëse keni arritur suksese në rrugën drejt përsosmërisë teknike dhe jeni të gatshëm të ndani se çfarë ju ka ndihmuar, — .
Ne planifikojmë të organizojmë më 8 qershor. Ne kuptojmë se tani është e vështirë të merret një vendim për pjesëmarrjen në konferencë. Por në të njëjtën kohë mendojmë se karantina nuk është një arsye për të ndaluar komunikimin dhe zhvillimin profesional. Prandaj, ne do të gjejmë një mënyrë për të diskutuar çështjet e liderëve teknikë dhe qasjet për zgjidhjen e tyre — nëse është e nevojshme, do të kalojmë në internet dhe do të zhvillojmë netërrikim atje!
Burimi: habr.com
