

Përkthimi i artikullit është përgatitur veçanërisht për studentët e kursit .
— zhvillues softueri, adhurues i Go dhe i apasionuar pas zgjidhjes së problemeve të ndërlikuara. Ai është gjithashtu mjaftues i Prometheus dhe bashkreator i Kubernetes SIG instrumentation. Në të kaluarën, ai ka qenë inxhinier në SoundCloud dhe ka drejtuar grupin e monitorimit në CoreOS. Aktualisht punon në Google.
— inxhinier infrastrukture në Improbable. Ai është i apasionuar pas teknologjive të reja dhe problemeve të sistemeve të shpërndara. Ka përvojë në programimin në nivel të ulët te Intel, përvojë si kontributor në Mesos dhe përvojë në SRE në shkallë globale në Improbable. Ai merret me përmirësimin e botës së mikroshërbimeve. Tre pasionet e tij: Golang, open source dhe volejboll.
Duke parë produktin tonë më të njohur, SpatialOS, mund të kuptoni se Improbable ka nevojë për një infrastrukturë cloud të lëvizshme në shkallë globale me dhjetëra klasterë Kubernetes. Ne ishim disa nga të parët që filluam të përdorim sistemin e monitorimit . Prometheus është në gjendje të ndjekë miliona metrika në kohë reale dhe vjen me një gjuhë të fuqishme pyetjesh që lejon nxjerrjen e informacionit të nevojshëm.
Thjeshtësia dhe besueshmëria e Prometheus janë disa nga përfitimet e tij kryesore. Megjithatë, pas arritjes së një shkalle të caktuar, ne u përballëm me disa disavantazhe. Për të zgjidhur këto probleme, ne zhvilluam — një projekt me kod të hapur, i krijuar nga Improbable, për transformimin e menjëhershëm të klasterëve ekzistues të Prometheus në një sistem të vetëm monitorimi me ruajtje të pafundme të të dhënave historike. Thanos është i disponueshëm në Github .
Qëllimet tona me Thanos
Kur arrijmë një shkallë të caktuar, lindin probleme që shkëlqejnë përtej mundësive të Prometheus vanilje. Si të ruajmë besueshëm dhe me kostot më të ulta petabajt të të dhënave historike? A mund të bëhet kjo pa e dëmtuar kohën e përgjigjes në kërkesat? A mund të kemi qasje në të gjitha metrikat që ndodhen në serverët e ndryshëm Prometheus me një kërkesë API? A mund të bashkojmë ndonjëherë të dhënat e riprodhuara të mbledhura nga Prometheus HA?
Për të zgjidhur këto pyetje, krijuam Thanos. Në seksionet e ardhshme përshkruhet si i qasëm këtyre pyetjeve dhe shpjegohen qëllimet që kemi ndjekur.
Kërkesa e të dhënave nga disa instanca Prometheus (kërkesa globale)
Prometheus ofron një qasje funksionale ndaj sharding-ut. Edhe një server Prometheus siguron mjaftueshëm shkallëzim për të çliruar përdoruesit nga kompleksitetet e sharding-ut horizontal në pothuajse të gjitha rastet e përdorimit.
Megjithëse kjo është një model i shkëlqyer implementimi, shpesh kërkohet qasje në të dhëna nga servera të ndryshëm Prometheus përmes një API ose UI të vetëm — pamja globale. Sigurisht, ekziston mundësia për të shfaqur disa kërkesa në një panel Grafana, por secila kërkesë mund të ekzekutohet vetëm në një server Prometheus. Nga ana tjetër, me Thanos mund të kërkoni dhe agregoni të dhëna nga disa servera Prometheus, pasi të gjitha janë të aksesueshme nga një pikë fundore.
Më parë, për të marrë pamjen globale në Improbable, ne organizuam instancat tona Prometheus në një shumë-niveli . Kjo do të thoshte të krijohej një server meta Prometheus që grumbullonte një pjesë të metrikeve nga çdo server "gjethtar".
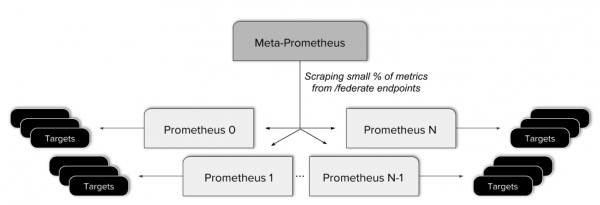
Ky qasje u tregua problematike. Ai çoi në ngarkesë të konfigurimit, shtimin e një pikë të mundshme dështimi dhe zbatimin e rregullave komplekse për të ofruar pikën e fundore të federuar vetëm të dhënat e nevojshme. Për më tepër, federata e këtij lloji nuk lejon të merret një pamje globale reale, pasi jo të gjitha të dhënat janë të aksesueshme nga një kërkesë API.
Kjo lidhet ngushtësisht me një pamje të unifikuar të të dhënave të grumbulluara në serverat Prometheus me disponueshmëri të lartë (high-availability, HA). Modeli HA i Prometheus grumbullon të dhëna në mënyrë të pavarur dy herë, çka është aq e thjeshtë sa nuk mund të jetë më e thjeshtë. Megjithatë, do të ishte shumë më e përshtatshme të përdorej një pamje e bashkuar dhe e deduplicuar e të dy rrjedhave.
Sigurisht, ekziston një nevojë për serverat Prometheus me disponueshmëri të lartë. Në Improbable ne e marrim seriozisht monitorimin minutë pas minute të të dhënave, por prania e një instance Prometheus në klasër është një pikë e vetme dështimi. Çdo gabim konfigurimi ose dështim të pajisjeve mund potencialisht të çojë në humbje të të dhënave të rëndësishme. Edhe një implementim i thjeshtë mund të shkaktojë disa probleme në grumbullimin e metrikeve, pasi rinisja mund të jetë shumë më e gjatë se intervali i skrapimit.
Ruajtja e besueshme e të dhënave historike
Një ruajtje e lirë, e shpejtë dhe me afat të gjatë për metrikat është ëndrra jonë (të ndarë nga shumica e përdoruesve të Prometheus). Në Improbable, na duhej të konfiguronim afatin e ruajtjes së metrikave në nëntë ditë (për Prometheus 1.8). Kjo sjell kufizime të dukshme në sa larg mund të shkojmë mbrapa.
Prometheus 2.0 u përmirësua në këtë aspekt, pasi numri i serive temporale nuk ndikon më në performancën e përgjithshme të serverit (shiko. ). Megjithatë, Prometheus ruan të dhënat në diskun lokal. Edhe pse kompresimi i drejtpërdrejtë i të dhënave mund të reduktojë ndjeshëm përdorimin e SSD-së lokale, prapëseprapë, ekziston një kufizim në sasinë e të dhënave historike që mund të ruhen.
Për më tepër, në Improbable ne kujdesemi për besueshmërinë, thjeshtësinë dhe costin. Disket e mëdhenj lokal janë më të vështirë për t'u operuar dhe për t'u bërë kopje rezervë. Ato kushtojnë më shumë dhe kërkojnë më shumë mjete për kopje rezervë, duke sjellë kompleksitet të tepruar.
Downsampling
Sapo filluam të punojmë me të dhënat historike, kuptuam se ekzistojnë komplekse themelore me O-madhësi, që bëjnë që kërkesat të bëhen gjithnjë e më të ngadalta kur punojmë me të dhëna për javë, muaj dhe vite.
Zgjidhja standarde për këtë problem do të jetë (redukimi i frekuencës së mostrave) — duke ulur frekuencën e mostrave të sinjalit. Me downsampling mund të 'përmasojmë' në një interval më të madh kohor dhe të mbajmë të njëjtin numër mostrash, gjë që do të ruajë përgjigjen e shpejtë të kërkesave.
Downsampling i të dhënave të vjetra është një kërkesë e pashmangshme për çdo zgjidhje afatgjatë ruajtjeje dhe kalon përtej Prometheus-it vanilje.
Objektiva të tjera
Një nga qëllimet fillestare të projektit Thanos ishte integrimi pa ndërprerje me çdo instalim ekzistues të Prometheus. Qëllimi i dytë ishte operimi i thjeshtë me një pengesë minimale në hyrje. Çdo varësi duhet të plotësohet lehtësisht për përdoruesit e vegjël dhe ata të mëdhenj, që gjithashtu nënkupton një kostod të ulët bazë.
Arkitektura e Thanos
Pasi të kemi listuar qëllimet tona në seksionin e mëparshëm, le të punojmë mbi to dhe të shikojmë se si Thanos i zgjidh këto probleme.
Pamja globale
Për të marrë një pamje globale mbi ekzistencat ekzistuese të Prometheus, na nevojitet lidhja e një pikë të vetme hyrjeje për kërkesat me të gjitha serverët. Këtë punë e kryen komponenti Thanos. . Ai deploy-het pranë çdo serveri Prometheus dhe funksionon si një proxy, duke shërbyer të dhënat lokale të Prometheus përmes interfesës gRPC të Store API, e cila lejon zgjedhjen e të dhënave time series sipas etiketave dhe intervalit të kohës.
Nga ana tjetër ndodhet komponenti i shkallëzueshëm horizontalisht Querier pa ruajtje të gjendjes, i cili bën pak më shumë se thjesht përgjigjet në kërkesat PromQL përmes standardit HTTP API të Prometheus. Komponentët Querier, Sidecar dhe Thanos të tjerë komunikojnë përmes .
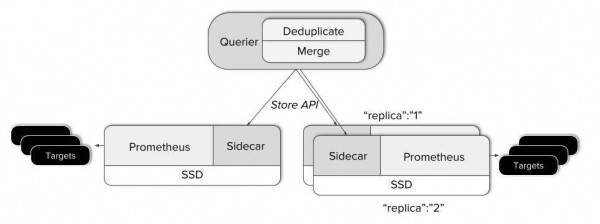
- Kur Querier merr një kërkesë, ai lidhet me serverin përkatës të Store API, pra me Sidecar-ët tanë dhe merr të dhënat time series nga serverët përkatës të Prometheus.
- Pas kësaj, ai kombinon përgjigjet dhe realizon kërkesën në PromQL. Querier mund të bashkojë si të dhëna që nuk prahendin ashtu edhe të dhëna të përsëritura nga serverët HA të Prometheus.
Kjo zgjidh pjesën kryesore të misterit tonë — bashkimin e të dhënave nga serverët e izoluar të Prometheus në një përfaqësim të vetëm. Në fakt, Thanos mund të përdoret thjesht për këtë mundësi. Nuk kërkohen ndryshime në serverët ekzistues të Prometheus!
Kohë ruajtjeje të pakufizuar!
Megjithatë, herët a vonë do të dëshirojmë të ruajmë të dhëna që kalojnë përtej kohës standarde të ruajtjes së Prometheus. Për ruajtjen e të dhënave historike, ne kemi zgjedhur një ruajtje objektive. Ajo është gjerësisht e disponueshme në çdo cloud, si dhe në qendrat lokale të të dhënave dhe është shumë ekonomike. Gjithashtu, praktikuese çdo ruajtje objektiv është në dispozicion përmes njohur S3 API.
Prometheus shkruan të dhënat nga memorja në disk çdo rreth dy orë. Blloku i të dhënave të ruajtura përmban të gjitha të dhënat për një periudhë fikse të kohës dhe është i pandryshueshëm. Kjo është shumë praktike, pasi Thanos Sidecar mund të shikojë thjesht katalogun e të dhënave të Prometheus dhe, ndërsa shfaqen blloqe të reja, t'i ngarkojë ato në kapacitetet e ruajtjes objektive.
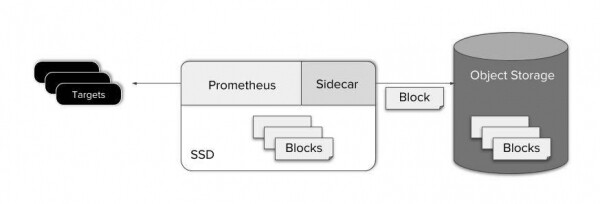
Ngarkimi në ruajtjen objektive menjëherë pasi shkruhet në disk gjithashtu lejon ruajtjen e thjeshtësisë së "skraperit" (Prometheus dhe Thanos Sidecar). Kjo e bën më të lehtë mbështetje, kosto dhe dizajnin e sistemit.
Si e shihni, kopjimi i të dhënave realizohet shumë lehtë. Por çfarë ndodh me kërkesën për të dhëna në ruajtjen objektore?
Komponenti Thanos Store vepron si një proxy për marrjen e të dhënave nga ruajtja objektore. Siç është Thanos Sidecar, ai merr pjesë në klasterin gossip dhe implementon API-në e Store. Kështu, Querier-ët ekzistues mund ta konsiderojnë atë si Sidecar, si një burim të tjera të dhënash të kohës — nuk kërkohet ndonjë konfigurim të veçantë.
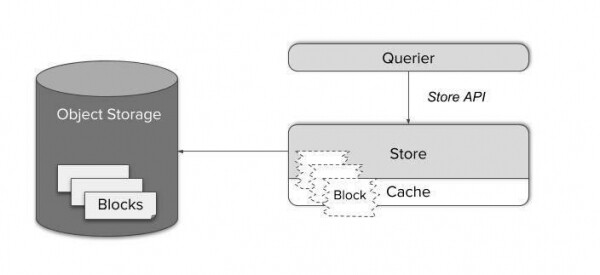
Blloqet e të dhënave të kohës përbëhen nga disa skedarë të mëdhenj. Ngarkimi i tyre sipas kërkesës do të ishte mjaft i paefektshëm, dhe keqmenaxhimi lokal do të kërkonte një memorie dhe hapësirë disku të madhe.
Në vend të kësaj, Store Gateway di si të trajtojë formatin e ruajtjes Prometheus. Falë planifikuesit të zgjuar të kërkesave dhe keqmenaxhimit vetëm të pjesëve të nevojshme të indekseve të blloqeve, është bërë e mundur të reduktohen kërkesat e komplikuara në një numër minimal HTTP-shkresash për skedarët e ruajtjes objektore. Kështu, numri i kërkesave mund të reduktohet nga katër deri në gjashtë rendi dhe të arrihet një kohë përgjigjeje që është në përgjithësi e vështirë të ndahen nga kërkesat për të dhëna në SSD-në lokale.
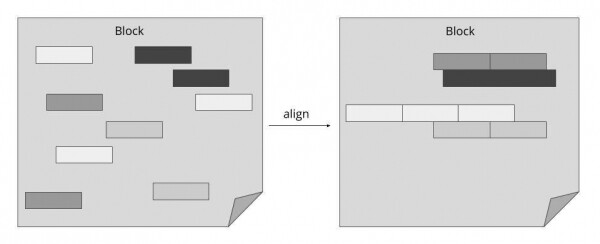
Siç tregohet në diagramin e mësipërm, Thanos Querier e zvogëlon ndjeshëm koston e kërkesës për të dhëna në ruajtjen objektore, duke përdorur formatin e ruajtjes Prometheus dhe duke vendosur të dhënat e lidhura afër. Duke përdorur këtë qasje, mund të kombinojmë shumë kërkesa individuale në një numër minimal operacionesh bulk.
Kompaktimi dhe ulja e mostrave
Pasi blloku i ri i të dhënave të kohës është ngarkuar me sukses në ruajtjen objektore, ne e konsiderojmë atë si të dhëna "historike" që menjëherë bëhen të disponueshme përmes Store Gateway.
Megjithatë, pas një kohe, blloqet nga një burim (Prometheus me Sidecar) grumbullohen dhe tashmë nuk përdorin të gjithë potencialin e indekseve. Për të zgjidhur këtë problem, ne kemi futur një komponent të ri të quajtur Compactor. Ai thjesht aplikon mekanizmin lokal të kompresimit Prometheus në të dhënat historike në ruajtjen objektore dhe mund të nisë si një detyrë periodike të thjeshtë.
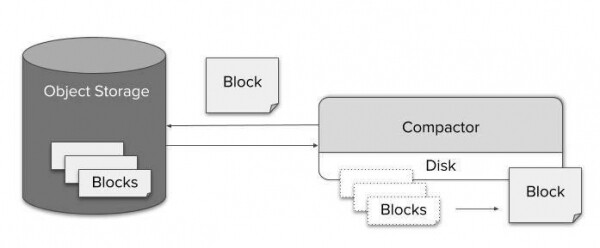
Falë shkrirjes efikase, një kërkesë për ruajtje për një kohë të gjatë nuk paraqet probleme nga pikëpamja e madhësisë së të dhënave. Megjithatë, kostoja e mundshme e shpërndarjes së një miliardi vlerash dhe kalimit të tyre përmes procesorit të kërkesave do të çojë me siguri në një rritje drastike të kohës së ekzekutimit të kërkesës. Nga ana tjetër, për shkak se për çdo piksel ekrani ka qindra pika të dhënash, bëhet e pamundur madje edhe të vizualizohen të dhënat në një rezolucion të plotë. Prandaj, downsampling jo vetëm që është i mundur, por gjithashtu nuk do të çojë në një humbje të dukshme të saktësisë.
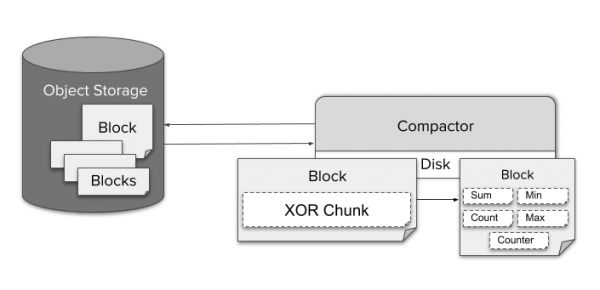
Për downsampling të të dhënave, Compactor grumbullon vazhdimisht të dhënat me rezolucion pesë minuta dhe një orë. Për çdo fragment të pa përpunuar, të koduar me kompresimin TSDB XOR, ruhet një gamë e llojeve të ndryshme të të dhënave të agreguar, si min, max apo sum për një bllok. Kjo i lejon Querier-it të zgjedhë automatikisht agregatin që është i përshtatshëm për kërkesën përkatëse PromQL.
Për të përdorur të dhënat me saktësi të ulur, përdoruesi nuk ka nevojë për asnjë konfigurim të veçantë. Querier automatikisht kalon midis rezolucioneve të ndryshme dhe të dhënave të pa përpunuara ndërsa përdoruesi rrit dhe zvogëlon shkallën. Nëse dëshiron, përdoruesi mund ta menaxhojë këtë drejtpërdrejt përmes parametrave "step" në kërkesë.
Duke qenë se kostoja e ruajtjes së një GB është e vogël, Thanos për default ruan të dhënat origjinale, të dhënat me rezolucion pesë minuta dhe një orë. Nuk ka nevojë të fshihen të dhënat origjinale.
Rregullat e regjistrimit
Edhe me Thanos, rregullat e regjistrimit janë një pjesë thelbësore e grumbullit të monitorimit. Ato reduktojnë kompleksitetin, vonesën dhe kostot e kërkesave. Ato gjithashtu janë të dobishme për përdoruesit për të marrë të dhëna të agreguara mbi metrikat. Thanos bazohet në instancat vanilla të Prometheus, prandaj është krejtësisht e pranueshme të ruhet rregullat e regjistrimit dhe rregullat e alarmit në serverin ekzistues Prometheus. Sidoqoftë, në disa raste, kjo mund të mos jetë e mjaftueshme:
- Alarmet dhe rregulla globale (për shembull, alarmi kur shërbimi nuk funksionon në më shumë se dy nga tre grupe).
- Rregulla për të dhënat jashtë ruajtjes lokale.
- Dëshira për të ruajtur të gjitha rregullat dhe alarmet në një vend.
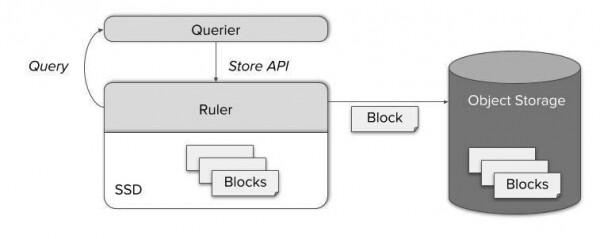
Për të gjitha këto raste, Thanos përfshin një komponent të veçantë të quajtur Ruler, i cili llogarit rregullat dhe alarmin përmes Thanos Queries. Duke ofruar një StoreAPI të njohur mirë, nodi Query mund të aksesojë metrikat e reja të llogaritura. Më vonë, ato gjithashtu ruhet në një depo objektesh dhe bëhen të aksesueshme përmes Store Gateway.
Forca e Thanos
Thanos është mjaft fleksibël për t'u konfiguruar sipas kërkesave tuaja. Kjo është veçanërisht e dobishme gjatë migrimit nga Prometheus e thjeshtë. Le të kujtojmë shpejt, me një shembull të vogël, se çfarë kemi mësuar për komponentët e Thanos. Këtu është si të transferoni Prometheus tuaj të vaniljës në botën e "ruajtjes së paafërsishme të metrikave":
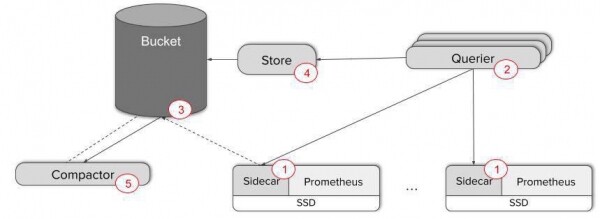
- Shto Thanos Sidecar në serverat tuaj Prometheus - për shembull, një kontejner fqinj në pod të Kubernetes.
- Shpërndani disa replika Thanos Querier për mundësinë e shikimit të të dhënave. Në këtë fazë është e lehtë të konfiguroni gossip midis Scraper dhe Querier. Për të verifikuar ndërveprimin e komponentëve, përdorni metrikën 'thanos_cluster_members'.
Vetëm këto dy hapa janë të mjaftueshëm për të siguruar një pamje globale dhe deduplikimin e paqëndrueshëm të të dhënave nga potencialet HA-replikat e Prometheus! Thjesht lidheni dashboardet tuaja me pikën përfundimtare HTTP Querier ose përdorni ndërfaqen Thanos UI direkt.
Megjithatë, nëse keni nevojë për backup të metrikave dhe ruajtje afatgjatë, do të duhet të kryeni edhe tre hapa të tjerë:
- Krijoni një bucket AWS S3 ose GCS. Konfiguroni Sidecar për të kopjuar të dhënat në këto buckets. Tani mund të minimizoni ruajtjen lokale të të dhënave.
- Shpërndani Store Gateway dhe lidheni atë me klasterin ekzistues gossip. Tani mund të dërgoni pyetje për të dhënat në backups!
- Shpërndani Compactor për të rritur efikasitetin e kërkesave për periudha të gjata, duke përdorur kompaktimin dhe downsamping.
Nëse dëshironi të dini më shumë, mos hezitoni, shikoni shembujt tanë dhe !
Në vetëm pesë hapa ne transformuam Prometheus në një sistem të besueshëm monitorimi me pamje globale, kohë të pakufizuar ruajtjeje dhe potencial të lartë disponueshmërie për metrikat.
Pull request: na nevojiten!
që nga fillimi ka qenë një projekt me kod të hapur. Integrimi pa probleme me Prometheus dhe mundësia për të përdorur vetëm një pjesë të Thanos e bën atë një zgjedhje të shkëlqyer për shkallëzimin e sistemit të monitorimit pa ndonjë përpjekje të tepërt.
Ne jemi gjithmonë të gëzuar për GitHub Pull Request dhe Issues. Në të njëjtën kohë, mos hezitoni të na kontaktoni përmes Github Issues ose slack., nëse keni pyetje ose komente, ose dëshironi të ndani përvojën tuaj të përdorimit! Nëse ju pëlqen ajo që bëjmë në Improbable, mos hezitni të na kontaktoni — !
Burimi: habr.com
