

Ju propozoj të njiheni me transkriptin e prezantimit të fillimit të vitit 2016 nga Andrey Salnikov, "Gabimet tipike në aplikacione që çojnë në bloat në PostgreSQL"
Në këtë prezantim do të shqyrtoj gabimet kryesore në aplikacione që shfaqen në fazën e projektimit dhe shkrimit të kodit të aplikacionit. Do të ndalem vetëm te ato gabime që çojnë në bloat në PostgreSQL. Zakonisht, ky është fillimi i fundit të performancës së sistemit tuaj në tërësi, edhe pse në fillim nuk dukej se kishte asnjë shenjë paralajmëruese.
Përshëndetje të gjithëve! Ky prezantim nuk është aq teknik sa ai i mëparshmi nga kolegu im. Ai u drejtohet kryesisht zhvilluesve të sistemeve backend, sepse kemi një numër të madh klientësh. Dhe të gjithë ata bëjnë të njëjtat gabime. Pikërisht për to do t’ju flas. Do të shpjegoj se në çfarë pasojash serioze dhe të dëmshme çojnë këto gabime.
Pse bëhen këto gabime? Ato ndodhin për dy arsye: nga mendësia “ndoshta funksionon kështu” dhe nga mungesa e njohjes së disa mekanizmave që veprojnë në nivelin midis bazës së të dhënave dhe aplikacionit, si edhe brenda vetë bazës.
Do t’ju sjell tre shembuj me ilustrime të frikshme se si gjithçka përkeqësohet. Shkurt do të tregoj edhe për mekanizmin që vepron aty. Po ashtu do të shpjegoj si të përballeni me to kur tashmë kanë ndodhur dhe cilat metoda parandaluese duhen përdorur për të shmangur gabimet. Do të flas edhe për mjetet ndihmëse dhe do të jap lidhje të dobishme.
Kam përdorur një bazë të dhënash testuese, ku kisha dy tabela. Njëra tabelë përmbante llogaritë e klientëve, ndërsa tjetra operacionet mbi këto llogari. Dhe me një periodicitet të caktuar ne përditësojmë gjendjet në këto llogari.
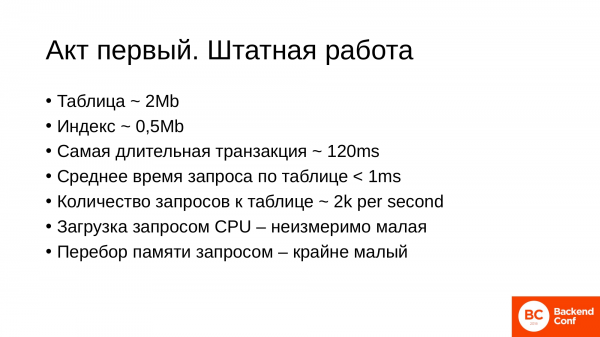
Të dhënat fillestare të tabelës: ajo është mjaft e vogël, 2 MB. Koha e përgjigjes së bazës së të dhënave dhe konkretisht e kësaj tabele është gjithashtu shumë e mirë. Edhe ngarkesa është mjaft e lartë – 2 000 operacione në sekondë mbi tabelën.
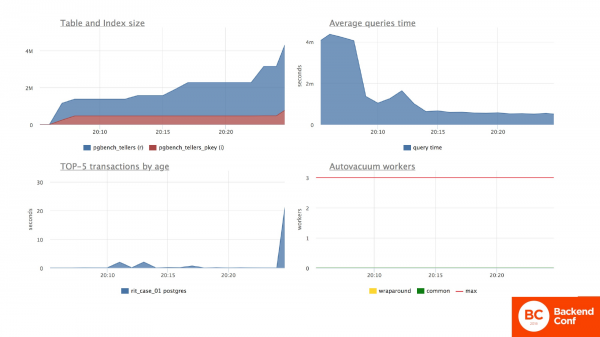
Gjatë këtij prezantimi do t’ju tregoj grafiqe që të kuptohet qartë çfarë po ndodh. Gjithmonë do të ketë 2 slajde me grafiqe. Slajdi i parë tregon se çfarë po ndodh në përgjithësi në server.
Dhe në këtë situatë shohim se tabela është vërtet me përmasa të vogla. Indeksi është i vogël, 2 MB. Ky është grafiku i parë majtas.
Koha mesatare e përgjigjes së serverit është gjithashtu e qëndrueshme dhe e ulët. Ky është grafiku i sipërm djathtas.
Grafiku poshtë majtas paraqet transaksionet më të gjata. Shohim se transaksionet ekzekutohen shpejt. Autovacuum këtu ende nuk po punon, sepse ky ishte një test fillestar. Më pas ai do të aktivizohet dhe do të na jetë i dobishëm.
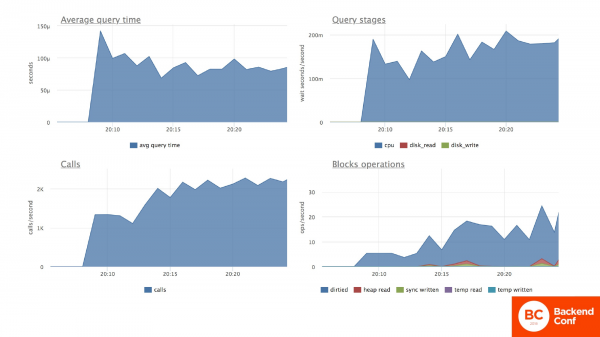
Slajdi i dytë do t'i kushtohet gjithmonë tabelës që po testohet. Në këtë rast, ne përditësojmë vazhdimisht gjendjet e llogarive të klientit. Dhe shohim se koha mesatare e përgjigjes për operacionin e përditësimit është mjaft e mirë, më pak se një milisekondë. Shohim gjithashtu se burimet e procesorit (grafiku sipër djathtas) konsumohen në mënyrë të njëtrajtshme dhe në sasi relativisht të vogla.
Grafiku poshtë djathtas tregon sa memorie operative dhe disku përshkojmë në kërkim të rreshtit që na duhet përpara se ta përditësojmë. Dhe numri i operacioneve në tabelë është 2 000 në sekondë, siç e përmenda edhe në fillim.
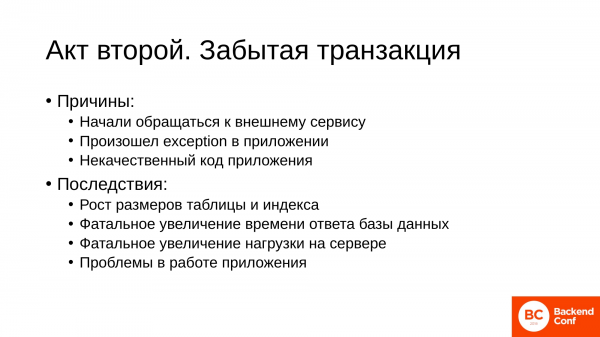
Dhe tani përballemi me një problem serioz. Për ndonjë arsye shfaqet një transaksion i gjatë i harruar. Arsyet zakonisht janë fare të zakonshme:
- Një nga rastet më të shpeshta është kur në kodin e aplikacionit fillojmë të komunikojmë me një shërbim të jashtëm. Dhe ky shërbim nuk na përgjigjet. Pra, ne hapëm një transaksion, bëmë një ndryshim në bazën e të dhënave dhe më pas shkuam nga aplikacioni të lexonim postën ose të kontaktonim një shërbim tjetër brenda infrastrukturës sonë, por ai për ndonjë arsye nuk na përgjigjet. Si rezultat, seanca mbetet e varur në një gjendje ku nuk dihet se kur do të zgjidhet.
- Situata e dytë është kur në kod, për ndonjë arsye, ndodh një exception. Dhe në exception nuk e kemi trajtuar mbylljen e transaksionit. Si rezultat, kemi një seancë të varur me një transaksion të hapur.
- Dhe rasti i fundit, gjithashtu mjaft i zakonshëm, është kodi me cilësi të dobët. Disa framework hapin një transaksion. Ai mbetet i varur dhe ju mund të mos e dini fare në aplikacion që ai është ende i hapur.
Ku çojnë gjëra të tilla?
Ato çojnë në fryrje të shpejtë të tabelave dhe indekseve. Pikërisht ky është efekti i quajtur bloat. Për bazën e të dhënave kjo do të shfaqet me një rritje shumë të shpejtë të kohës së përgjigjes dhe me rritje të ngarkesës në serverin e bazës së të dhënave. Si përfundim, do të vuajë aplikacioni. Sepse nëse më parë në kod shpenzonit 10 milisekonda për një kërkesë ndaj bazës së të dhënave dhe 10 milisekonda për logjikën tuaj, funksioni ekzekutohej për 20 milisekonda. Tani situata do të jetë shumë më e vështirë.
Dhe le të shohim çfarë po ndodh. Grafiku poshtë majtas tregon se kemi një transaksion të gjatë. Dhe nëse shohim grafikun sipër majtas, vërejmë se madhësia e tabelës është rritur papritur nga dy megabajt në 300 megabajt. Ndërkohë, sasia e të dhënave në tabelë nuk ka ndryshuar, pra aty ka një sasi mjaft të madhe të dhënash të panevojshme.
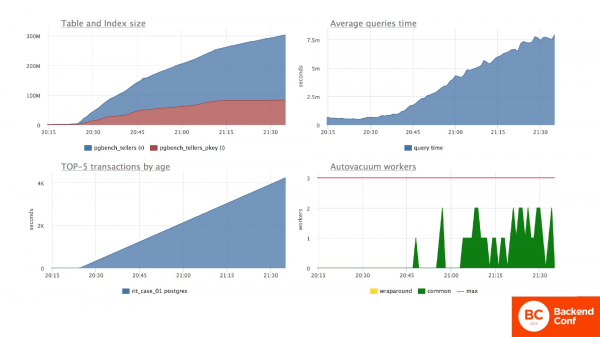
Situata e përgjithshme me kohën mesatare të përgjigjes së serverit gjithashtu ka ndryshuar me disa rendë madhësie. Pra, të gjitha kërkesat në server kanë nisur të ngadalësohen ndjeshëm. Njëkohësisht janë aktivizuar proceset e brendshme të Postgres, konkretisht autovacuum, të cilat po përpiqen të bëjnë diçka dhe po konsumojnë burime.
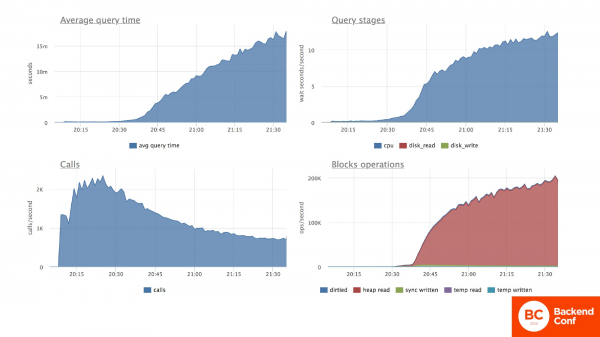
Çfarë po ndodh me tabelën tonë? E njëjta gjë. Koha mesatare e përgjigjes për tabelën është rritur me disa rendë madhësie. Sa u përket konkretisht burimeve të përdorura, shohim se ngarkesa në CPU është rritur shumë. Ky është grafiku sipër djathtas. Dhe është rritur sepse CPU-së i duhet të kalojë nëpër një numër të madh rreshtash të padobishëm për të gjetur një të vetëm që duhet. Ky është grafiku poshtë djathtas. Si rezultat, numri i thirrjeve në sekondë ka nisur të bjerë ndjeshëm, sepse baza e të dhënave nuk arrin më të përpunojë të njëjtin numër kërkesash.
Duhet ta rikthejmë sistemin në gjendje normale. Hyjmë në internet dhe mësojmë se transaksionet e gjata çojnë te ky problem. E gjejmë dhe e ndërpresim këtë transaksion. Dhe gjithçka kthehet në normalitet. Gjithçka funksionon siç duhet.
U qetësuam, por pas njëfarë kohe fillojmë të vërejmë se aplikacioni nuk po punon më si para incidentit. Kërkesat gjithsesi përpunohen më ngadalë, madje dukshëm më ngadalë. Në shembullin tim konkret, rreth një herë e gjysmë deri në dy herë më ngadalë. Edhe ngarkesa në server është më e lartë se para incidentit.
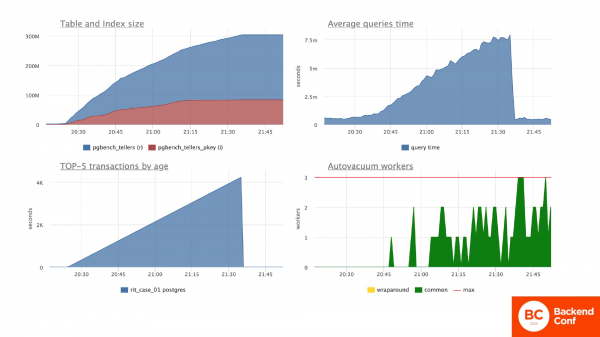
Dhe pyetja është: «Çfarë po ndodh me bazën e të dhënave në këtë moment?». Me bazën e të dhënave po ndodh kjo situatë. Në grafikun e transaksioneve shihni se ajo është ndalur dhe aty vërtet nuk ka transaksione të gjata. Por madhësia e tabelës gjatë incidentit është rritur në mënyrë drastike. Dhe që atëherë nuk është zvogëluar. Koha mesatare për bazën e të dhënave është stabilizuar. Dhe përgjigjet, në dukje, vijnë normalisht me një shpejtësi të pranueshme për ne. Autovacuum është bërë më aktiv dhe ka nisur të bëjë diçka me tabelën, sepse tani duhet të përpunojë një sasi më të madhe të dhënash.
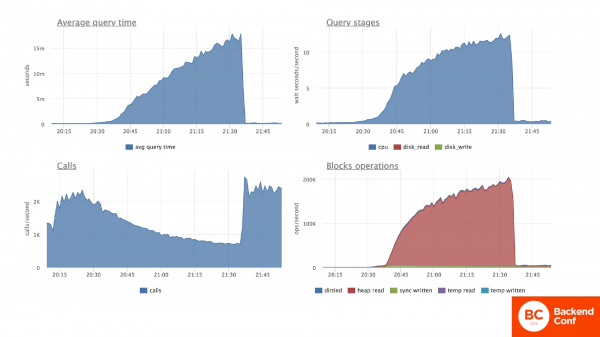
Konkretisht për tabelën e testuar me llogari, ku po ndryshojmë gjendjet: koha e përgjigjes së kërkesës duket se është kthyer në normë. Por në fakt ajo është një herë e gjysmë më e lartë.
Edhe nga ngarkesa e CPU-së shohim se ajo nuk është kthyer në nivelin e duhur para incidentit. Arsyet fshihen pikërisht te grafiku poshtë djathtas. Shihet se aty po ndodh skanimi i një sasie të caktuar memorieje. Pra, për të gjetur rreshtin e duhur, po shpenzojmë burimet e serverit të bazës së të dhënave duke kaluar nëpër të dhëna të panevojshme. Numri i transaksioneve për sekondë është stabilizuar.
Në përgjithësi është mirë, por situata është më e keqe se më parë. Kjo është një degradim i qartë i bazës së të dhënave si pasojë e aplikacionit tonë, i cili punon me këtë bazë të dhënash.
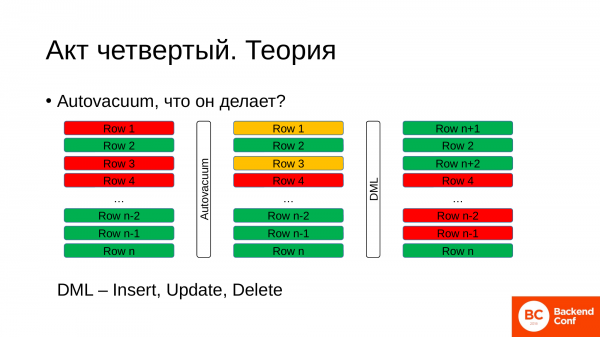
Dhe për të kuptuar çfarë po ndodh aty, nëse nuk keni qenë në prezantimin e mëparshëm, tani pak teori. Teori për procesin e brendshëm. Pse nevojitet autovacuum dhe çfarë bën ai?
Shumë shkurt, për ta kuptuar. Në një moment të caktuar kemi një tabelë. Në tabelë kemi rreshta. Këta rreshta mund të jenë aktivë, të vlefshëm, që na duhen tani. Në figurë ata janë shënuar me ngjyrë të gjelbër. Ka edhe rreshta të vdekur, që e kanë kryer tashmë funksionin e tyre, janë përditësuar dhe për ta janë krijuar regjistrime të reja. Ata janë shënuar si jo më me interes për bazën e të dhënave. Por mbeten në tabelë për shkak të veçorive të Postgres.
Pse nevojitet autovacuum? Në një moment të caktuar, autovacuum vjen, i drejtohet bazës së të dhënave dhe i kërkon: «Më jep, të lutem, ID-në e transaksionit më të vjetër që është aktualisht i hapur në bazën e të dhënave». Baza e të dhënave e kthen këtë ID. Pastaj autovacuum, duke u mbështetur te ajo, kalon nëpër rreshtat e tabelës. Dhe nëse sheh se disa rreshta janë ndryshuar nga transaksione shumë më të vjetra, ai ka të drejtë t’i shënojë si rreshta që mund t’i ripërdorim në të ardhmen duke shkruar aty të dhëna të reja. Ky është një proces në sfond.
Ndërkohë ne vazhdojmë të punojmë me bazën e të dhënave dhe të bëjmë ndryshime në tabelë. Në këta rreshta që mund t’i ripërdorim, shkruajmë të dhëna të reja. Dhe në këtë mënyrë krijohet një qarkullim i vazhdueshëm: aty shfaqen vazhdimisht rreshta të vjetër të vdekur, ndërsa në vend të tyre shkruajmë rreshta të rinj që na duhen. Dhe kjo është një gjendje normale për funksionimin e PostgreSQL.
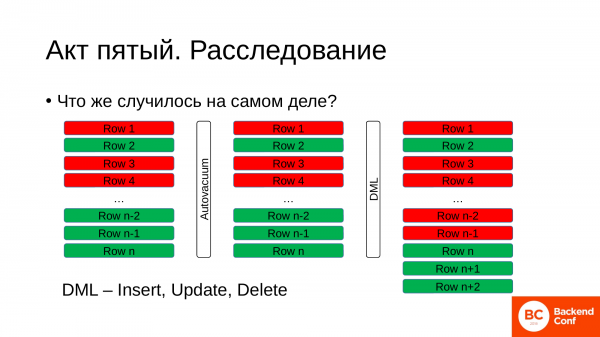
Çfarë ndodhi gjatë incidentit? Si zhvillohej ky proces?
Kishim një tabelë në një gjendje të caktuar: disa rreshta ishin aktivë, disa të tjerë të vdekur. Erdhi autovacuum. Ai pyeti bazën e të dhënave se cila ishte transaksioni ynë më i vjetër dhe cili ishte ID-ja e tij. Mori këtë ID, e cila mund të ishte prej shumë orësh më parë ose prej dhjetë minutash. Kjo varet nga sa e lartë është ngarkesa në bazën tuaj të të dhënave. Pastaj nisi të kërkojë rreshtat që mund t’i shënonte si të ripërdorshëm. Dhe nuk gjeti të tillë në tabelën tonë.
Por ndërkohë ne vazhdojmë të punojmë me tabelën. Bëjmë diçka në të, përditësojmë dhe ndryshojmë të dhënat. Po baza e të dhënave çfarë duhet të bëjë në këtë moment? Asaj nuk i mbetet gjë tjetër veçse të shtojë rreshta të rinj në fund të tabelës ekzistuese. Si rezultat, madhësia e tabelës fillon të fryhet.
Në praktikë, për punë na duhen rreshtat e gjelbër. Por gjatë një problemi të tillë, rezulton që përqindja e rreshtave të gjelbër është jashtëzakonisht e ulët në të gjithë vëllimin e tabelës.
Dhe kur ekzekutojmë një kërkesë, baza e të dhënave detyrohet të kalojë nëpër të gjithë rreshtat, si të kuq ashtu edhe të gjelbër, për të gjetur rreshtin e nevojshëm. Efekti i fryrjes së tabelës me të dhëna të padobishme quhet “bloat”, dhe ai gjithashtu konsumon hapësirën tonë në disk. Ju kujtohet, ishin 2 MB, u bënë 300 MB? Tani zëvendësoni megabajtët me gigabajtë dhe shumë shpejt do të mbeteni pa të gjitha rezervat e burimeve tuaja në disk.
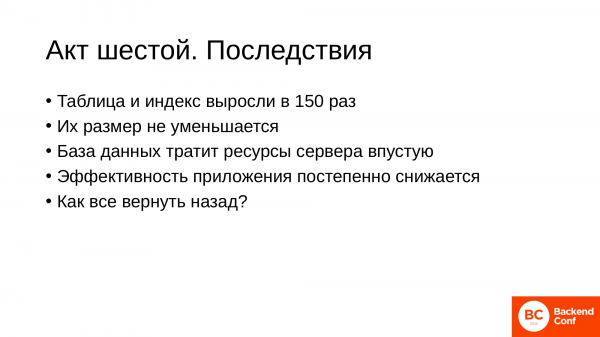
Çfarë pasojash mund të ketë kjo për ne?
- Në shembullin tim, tabela dhe indeksi u rritën 150 herë. Te disa nga klientët tanë ka pasur raste edhe më kritike, kur thjesht fillonte të mbaronte hapësira në disk.
- Madhësia e tabelave në vetvete nuk do të zvogëlohet kurrë. Autovacuum në disa raste mund të presë pjesën e fundit të tabelës, nëse aty ka vetëm rreshta të vdekur. Por, duke qenë se ndodh rotacion i vazhdueshëm, një rresht i gjelbër mund të mbetet në fund dhe të mos përditësohet, ndërsa të gjithë të tjerët do të shkruhen diku në fillim të tabelës. Megjithatë, që tabela të zvogëlohet vetvetiu është një skenar aq i pamundur, sa nuk ia vlen të shpresoni te kjo.
- Baza e të dhënave duhet të kalojë nëpër të gjithë grumbullin e rreshtave të padobishëm. Dhe ne harxhojmë burime të diskut, burime të procesorit dhe energji elektrike.
- Dhe kjo ndikon drejtpërdrejt te aplikacioni ynë, sepse nëse në fillim shpenzonim 10 milisekonda për query-n, 10 milisekonda për kodin tonë, atëherë gjatë incidentit filluam të shpenzonim 1 sekondë për query-n dhe 10 milisekonda për kodin, pra performanca e aplikacionit ra me një rend madhësie. Dhe kur incidenti u zgjidh, filluam të shpenzonim 20 milisekonda për query-n dhe 10 milisekonda për kodin. Kjo do të thotë se gjithsesi humbëm rreth 1.5 herë në performancë. Dhe e gjitha kjo për shkak të një transaksioni të vetëm që mbeti i bllokuar, madje ndoshta për fajin tonë.
- Dhe pyetja është: «Si ta kthejmë gjithçka mbrapsht?», që çdo gjë të rikthehet në normalitet dhe query-t të ekzekutohen sërish po aq shpejt sa para incidentit.
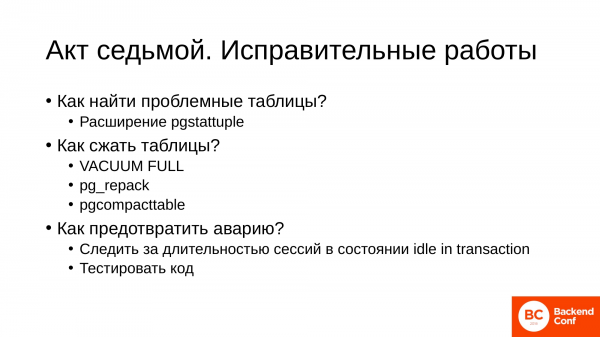
Për këtë ekziston një cikël i caktuar pune që duhet ndjekur.
Së pari duhet të gjejmë tabelat problematike që janë fryrë. E kuptojmë se në disa tabela shkrimet bëhen më aktivisht, ndërsa në disa të tjera më pak. Për këtë përdoret zgjerimi . Pasi ta instaloni këtë zgjerim, mund të shkruani query që do t’ju ndihmojnë të gjeni tabelat që janë fryrë ndjeshëm.
Pasi t’i keni gjetur këto tabela, ato duhet të kompaktohen. Për këtë tashmë ekzistojnë mjete. Në kompaninë tonë përdorim tre mjete. I pari është VACUUM FULL i integruar. Është i ashpër, i fortë dhe i pamëshirshëm, por ndonjëherë është shumë i dobishëm. dhe janë utilitete të palëve të treta për kompaktimin e tabelave. Dhe ato sillen më me kujdes ndaj bazës së të dhënave.
Ato përdoren në varësi të asaj që ju leverdis më shumë. Por për këtë do të flas në fund. E rëndësishme është se ka tre mjete. Pra, keni mundësi zgjedhjeje.
Pasi të kemi rregulluar gjithçka dhe të jemi siguruar se çdo gjë është në rregull, duhet të dimë si ta parandalojmë këtë situatë në të ardhmen:
- Kjo parandalohet mjaft lehtë. Duhet të monitoroni kohëzgjatjen e sesioneve në serverin Master. Veçanërisht të rrezikshme janë sesionet në gjendjen idle in transaction. Këto janë ato që kanë hapur një transaksion, kanë bërë diçka dhe më pas janë lënë pas dore ose thjesht kanë mbetur të varura, të humbura në kod.
- Dhe për ju, si zhvillues, është e rëndësishme ta testoni kodin për raste kur krijohen situata të tilla. Kjo nuk është e vështirë për t’u bërë. Do të jetë një kontroll i dobishëm. Do të shmangni një numër të madh problemesh «fillestare» që lidhen me transaksionet e gjata.
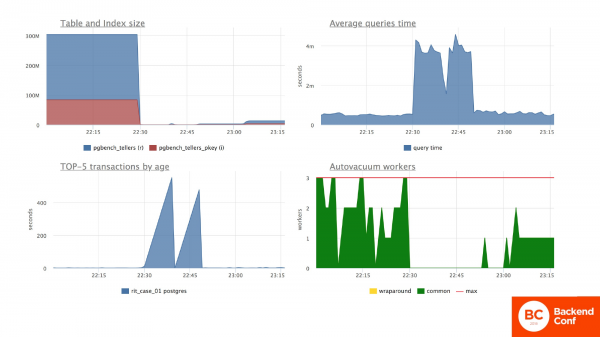
Në këto grafikë doja t’ju tregoja se si ndryshuan tabela dhe sjellja e bazës së të dhënave pasi, në këtë rast, kalova mbi tabelë me VACUUM FULL. Kjo te unë nuk është production.
Madhësia e tabelës u kthye menjëherë në gjendjen normale të punës, në disa megabajt. Kjo nuk ndikoi shumë në kohën mesatare të përgjigjes së serverit.
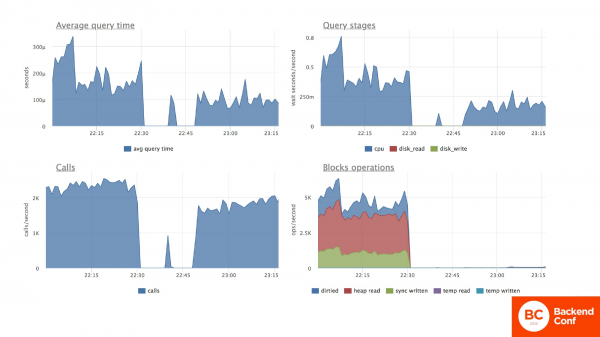
Por pikërisht për tabelën tonë të testimit, ku përditësonim gjendjet e llogarive, shohim se koha mesatare e përgjigjes për kërkesën e përditësimit të të dhënave në tabelë u ul në nivelin para incidentit. Edhe burimet e CPU të përdorura për ekzekutimin e kësaj kërkese ranë në nivelin para incidentit. Grafiku poshtë djathtas tregon gjithashtu se tani po gjejmë menjëherë saktësisht rreshtin që na duhet, pa kaluar nëpër një grumbull rreshtash të vdekur që ishin para kompresimit të tabelës. Ndërsa koha mesatare e kërkesave mbeti afërsisht në të njëjtin nivel. Por këtu, me shumë gjasa, bëhet fjalë për kufizimet e harduerit tim.
Këtu përfundon historia e parë. Ajo është më e zakonshmja. Dhe u ndodh të gjithëve, pavarësisht nga përvoja e klientit apo sa të kualifikuar janë programuesit. Herët a vonë, kjo ndodh.
Historia e dytë, ku shpërndajmë ngarkesën dhe optimizojmë burimet e serverit
- Tashmë jemi rritur dhe jemi bërë lojtarë seriozë. E kuptojmë se kemi një replikë dhe se do të ishte mirë të balanconim ngarkesën: të shkruajmë në Master dhe të lexojmë nga replika. Zakonisht kjo situatë lind kur duam të përgatisim raporte ose ETL. Dhe biznesi gëzohet shumë për këtë. Ai kërkon shumë lloje raportesh me një sasi të madhe analitike të ndërlikuar.
- Raportet zgjasin me orë të tëra, sepse analitika e ndërlikuar nuk llogaritet në milisekonda. Ne, si djem të zotë, shkruajmë kod. Në aplikacion vendosim që shkrimet t’i bëjmë në Master, ndërsa raportet t’i ekzekutojmë në replikë.
- Shpërndajmë ngarkesën.
- Gjithçka funksionon shkëlqyeshëm. Jemi të zotët.
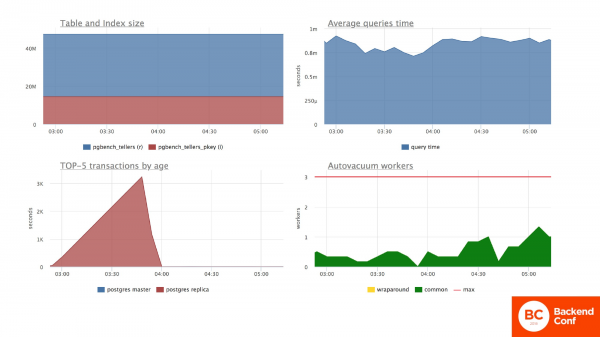
Po si duket kjo situatë? Pikërisht në këta grafikë, për kohëzgjatjen e transaksionit, kam shtuar edhe kohëzgjatjen e transaksioneve nga replika. Të gjithë grafikët e tjerë i referohen vetëm serverit Master.
Tabela me raportet deri në këtë moment ishte rritur. Ato u shtuan. Shohim se koha mesatare e përgjigjes së serverit është e qëndrueshme. Shohim se në replikë kemi një transaksion të gjatë që po punon prej 2 orësh. Shohim punën e qetë të autovacuum-it, i cili pastron rreshtat e vdekur. Dhe gjithçka është në rregull.
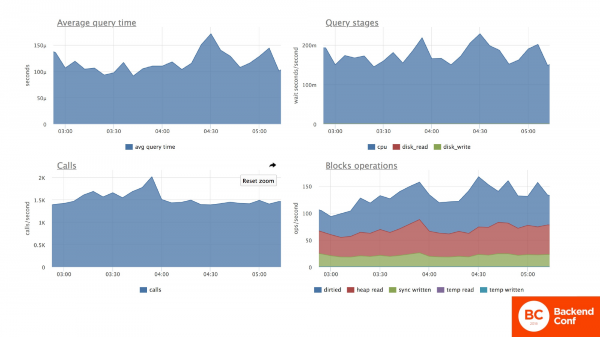
Sa i përket tabelës në testim, ne vazhdojmë të përditësojmë bilancet në llogari. Edhe këtu kemi kohë të qëndrueshme përgjigjeje për kërkesat dhe konsum të qëndrueshëm të burimeve. Gjithçka është në rregull.
Gjithçka është mirë derisa këto raporte fillojnë të ndërpriten për shkak të konfliktit me replikimin. Dhe ndërpriten me periodicitet të vazhdueshëm.
Hymë në internet dhe fillojmë të lexojmë pse po ndodh kjo. Dhe gjejmë zgjidhjen.
Zgjidhja e parë është të rrisim vonesën e replikimit. E dimë që raporti ynë zgjat 3 orë. Vendosim vonesën e replikimit në 3 orë. E nisim gjithçka, por sërish vazhdojmë të kemi probleme, sepse raportet herë pas here përsëri ndërpriten.
Ne duam që gjithçka të jetë perfekte. Vazhdojmë të kërkojmë. Dhe gjejmë në internet një konfigurim shumë të mirë: hot_standby_feedback. E aktivizojmë. Hot_standby_feedback na lejon të ngadalësojmë punën e autovacuum-it në Master. Kështu i eliminojmë plotësisht konfliktet e replikimit. Dhe raportet fillojnë të funksionojnë si duhet.
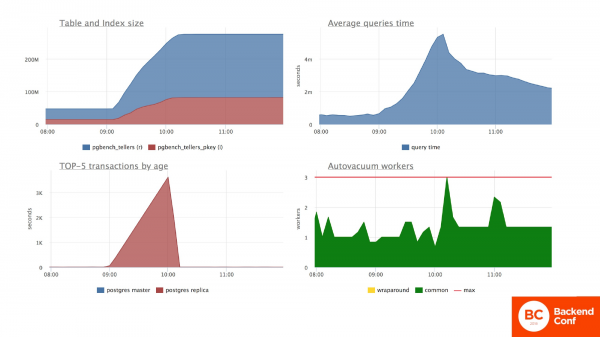
Po me serverin Master çfarë po ndodh ndërkohë? Me serverin Master po ndodh një katastrofë e vërtetë. Tani po shohim grafiqet e momentit kur aktivizova të dyja këto konfigurime. Dhe shohim se sesioni në replikë, në njëfarë mënyre, ka filluar të ndikojë në situatën në serverin Master. Në fakt ndikon, sepse ndaloi autovacuum-in që pastron rreshtat e vdekur. Madhësia e tabelës na kërceu sërish në nivele ekstreme. Edhe koha mesatare e ekzekutimit të kërkesave në të gjithë bazën e të dhënave u rrit jashtëzakonisht shumë. Autovacuum-et u ngarkuan disi më tepër.
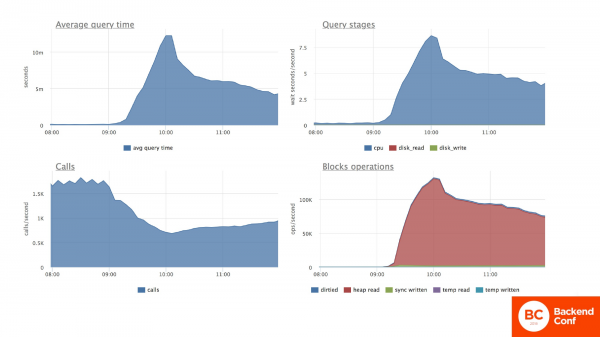
Konkretisht për tabelën tonë, shohim se edhe përditësimi i të dhënave aty u rrit në nivele ekstreme. Konsumi i burimeve të CPU gjithashtu u rrit shumë. Sërish po kalojmë nëpër një numër të madh rreshtash të vdekur e të padobishëm. Dhe koha e përgjigjes për këtë tabelë, ndërsa numri i transaksioneve, ra.
Si do të dukej kjo nëse nuk do ta dinim se për çfarë fola më parë?
- Nisim të kërkojmë problemet. Nëse në pjesën e parë jemi përballur me probleme, e dimë se shkaku mund të jetë një transaksion i gjatë dhe futemi te Master. Problemi është te Master. Ai po lëkundet. Po mbinxehet, Load Average i shkon deri afër njëqind.
- Kërkesat atje ngadalësohen, por nuk shohim asnjë transaksion të gjatë. Dhe nuk e kuptojmë ku është problemi. Nuk e dimë ku të kërkojmë.
- Kontrollojmë pajisjet e serverit. Ndoshta na është prishur RAID. Ndoshta na është djegur një modul RAM. Mund të jetë çfarëdo. Por jo, serverët janë të rinj, gjithçka funksionon në mënyrë perfekte.
- Të gjithë vrapojnë: administratorët, zhvilluesit dhe drejtori. Asgjë nuk ndihmon.
- Dhe në një moment gjithçka, krejt papritur, fillon të rregullohet vetë.
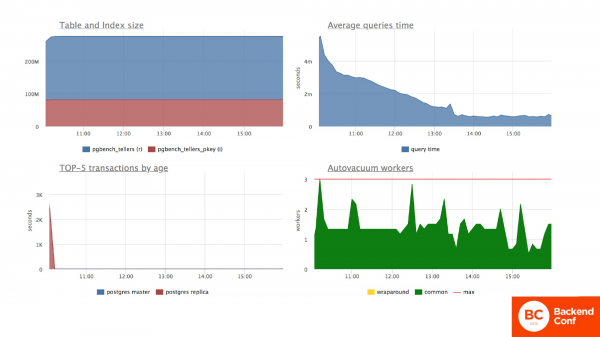
Në replikë, ndërkohë, kërkesa u përpunua dhe përfundoi. E morëm raportin. Biznesi është ende i kënaqur. Siç e shohim, tabela është rritur sërish dhe nuk ka ndërmend të zvogëlohet. Në grafikun e sesioneve lashë një pjesë të këtij transaksioni të gjatë nga replika, që të mund të vlerësoni sa shumë kohë kalon derisa situata të stabilizohet.
Sesioni përfundoi. Dhe vetëm pas njëfarë kohe serveri kthehet pak a shumë në gjendje normale. Edhe koha mesatare e përgjigjes së kërkesave në serverin Master kthehet në normë. Sepse, më në fund, autovacuum mori mundësinë të pastrojë dhe të shënojë këto rreshta të vdekur. Dhe filloi të bëjë punën e vet. Dhe sa më shpejt ta bëjë, aq më shpejt do të rikthehemi në normalitet.
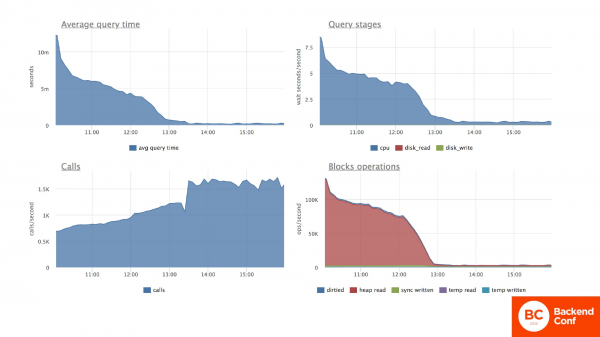
Për tabelën që po testohet, ku përditësojmë gjendjet e llogarive, shohim pikërisht të njëjtën pamje. Edhe koha mesatare e përditësimit të llogarisë normalizohet gradualisht. Burimet e përdorura nga CPU gjithashtu ulen. Edhe numri i transaksioneve për sekondë kthehet në normë. Por jo më në atë normë që kishim përpara incidentit.
Në çdo rast kemi një rënie performance, si edhe në rastin e parë, me 1,5 deri në 2 herë, e ndonjëherë edhe më shumë.
Duket sikur bëmë gjithçka siç duhet. E shpërndamë ngarkesën. Pajisjet nuk rrinë bosh. I ndamë kërkesat siç duhet, por prapëseprapë gjithçka doli keq.
- Të mos aktivizohet hot_standby_feedback? Po, pa arsye vërtet të forta nuk rekomandohet të aktivizohet. Sepse ky parametër ndikon drejtpërdrejt në serverin Master dhe ndalon punën e autovacuum atje. Nëse e aktivizoni në një replikë dhe pastaj e harroni, mund të rrëzoni Master-in dhe të krijoni probleme serioze për aplikacionin.
- Të rritet max_standby_streaming_delay? Po, për raportet kjo është e arsyeshme. Nëse keni një raport që zgjat tre orë dhe nuk doni që ai të dështojë për shkak të konflikteve të replikimit, thjesht rrisni vonesën. Një raport i gjatë nuk ka nevojë për të dhëna që sapo kanë mbërritur në bazë. Nëse raporti zgjat tre orë, do të thotë se e nisni për një periudhë më të hershme të të dhënave. Prandaj, qoftë vonesë tre orë apo gjashtë orë, për ju nuk bën ndonjë ndryshim, por ndërkohë do t’i merrni raportet në mënyrë të qëndrueshme pa hasur probleme me ndërprerjen e tyre.
- Natyrisht, duhet të monitorohen sesionet e gjata në replika, veçanërisht nëse keni vendosur të aktivizoni hot_standby_feedback në replikë. Sepse mund të ndodhë gjithçka. Ia dhamë këtë replikë një zhvilluesi që të testonte query-t. Ai shkroi një query të çmendur. E nisi dhe shkoi të pinte çaj, ndërsa ne morëm një Master të bllokuar. Ose kemi lejuar aty aplikacionin e gabuar. Situatat mund të jenë të ndryshme. Sesionet në replika duhen monitoruar po aq me kujdes sa edhe në Master.
- Dhe nëse në replika keni si query të shpejta ashtu edhe të gjata, në këtë rast është më mirë t’i ndani për shpërndarjen e ngarkesës. Kjo lidhet me streaming_delay. Për query-t e shpejta, mbani një replikë me vonesë të vogël replikimi. Për query-t e gjata të raportimit, përdorni një replikë që mund të mbetet pas 6 orë ose edhe një ditë. Kjo është krejtësisht normale.
Pasojat i eliminojmë me të njëjtën mënyrë:
- Gjejmë tabelat e fryra.
- Dhe i ngjeshim me mjetin më të përshtatshëm për ne.
Këtu përfundon historia e dytë. Kalojmë te historia e tretë.
Edhe kjo është një situatë mjaft e zakonshme për ne, ku kryejmë migrim.
- Çdo produkt softuerik rritet. Kërkesat ndaj tij ndryshojnë. Ne gjithsesi duam të zhvillohemi. Dhe ndodh që të na duhet të përditësojmë të dhënat në tabelë, pra të ekzekutojmë një update si pjesë e migrimit tonë për funksionalitetin e ri që po zbatojmë në kuadër të zhvillimit tonë.
- Formati i vjetër i të dhënave nuk na përshtatet. Të themi se tani i referohemi tabelës së dytë, ku kam operacionet për këto llogari. Dhe supozojmë se ato ishin në rubla, por ne vendosëm të rrisim saktësinë dhe t’i regjistrojmë në kopekë. Për këtë duhet të bëjmë një update: fusha me shumën e operacionit të shumëzohet me njëqind.
- Në botën moderne ne përdorim mjete të automatizuara për kontrollin e versioneve të bazës së të dhënave. Për shembull, . E përfshijmë aty migrimin tonë. E testojmë në bazën tonë testuese. Gjithçka është në rregull. Update kalon. E bllokon punën për njëfarë kohe, por në këmbim marrim të dhëna të përditësuara. Dhe mbi këtë mund të nisim funksionalitetin e ri. I testuam dhe i verifikuam të gjitha. Të gjithë e konfirmuan.
- U kryen punimet e planifikuara, u realizua migrimi.
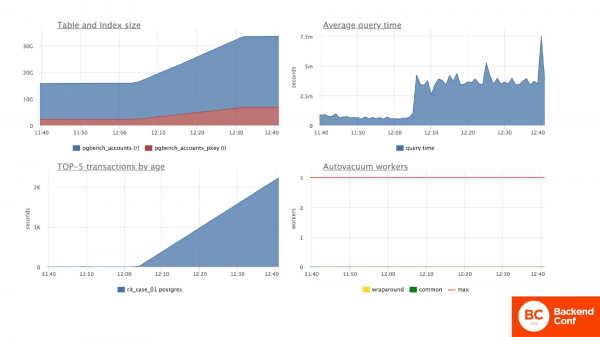
Këtu para jush është paraqitur migrimi me update. Meqë këto ishin operacione për llogari, tabela ishte 15 GB. Dhe duke qenë se përditësojmë çdo rresht, me update e frymëzuam tabelën dyfish, sepse rishkruam çdo rresht.
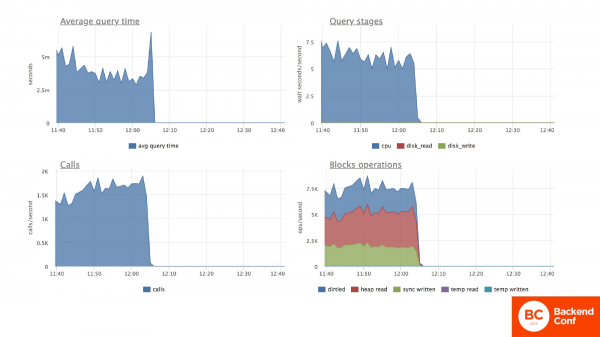
Gjatë migrimit nuk mund të bënim asgjë me këtë tabelë, sepse të gjitha kërkesat ndaj saj hynë në radhë dhe prisnin derisa të përfundonte ky update. Por këtu dua t’ju tërheq vëmendjen te shifrat në boshtin vertikal. Pra, kemi kohë mesatare të kërkesës para migrimit rreth 5 milisekonda dhe ngarkesa e CPU-së, si edhe numri i operacioneve bllok të leximit nga disku, është më i ulët se 7,5.
E kryem migrimin dhe përsëri morëm probleme.
Migrimi përfundoi me sukses, por:
- Funksionaliteti i vjetër filloi të ekzekutohej më ngadalë.
- Tabela u rrit sërish në madhësi.
- Ngarkesa në server u bë sërish më e lartë se më parë.
- Dhe, natyrisht, ndërkohë që ende po merremi me atë funksionalitet që punonte mirë, e përmirësuam pak.
Dhe kjo është sërish bloat, që po na e vështirëson përsëri punën.
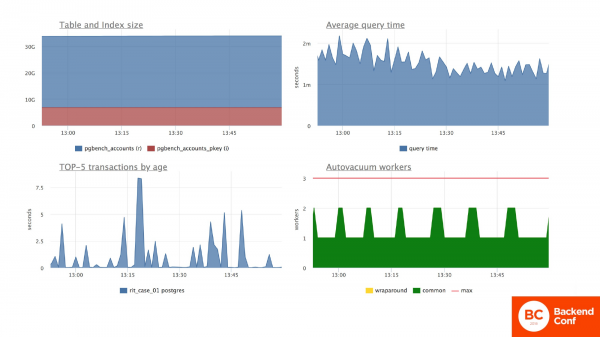
Këtu demonstroj se tabela, ashtu si në dy rastet e mëparshme, nuk ka ndërmend të kthehet në madhësinë e saj të mëparshme. Ngarkesa mesatare e serverit duket në rregull.
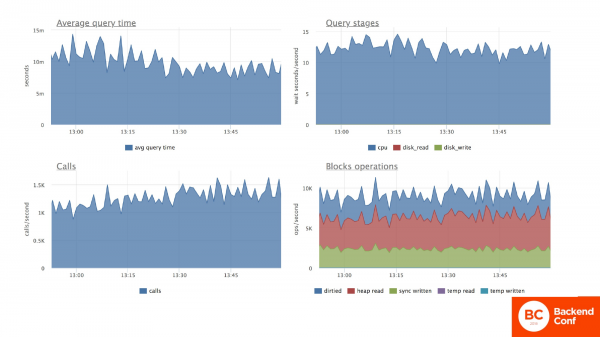
Nëse i referohemi tabelës së llogarive, do të shohim se koha mesatare e kërkesës është rritur dyfish për këtë tabelë. Ngarkesa në CPU dhe numri i rreshtave të përpunuar në memorie u rrit mbi 7,5, ndërsa më parë ishte më e ulët. Për CPU-t kjo u rrit 2 herë, ndërsa për operacionet me blloqe 1,5 herë, pra morëm degradim të performancës së serverit. Dhe si pasojë, edhe degradim të performancës së aplikacionit tonë. Ndërkohë, numri i thirrjeve mbeti afërsisht në të njëjtin nivel.
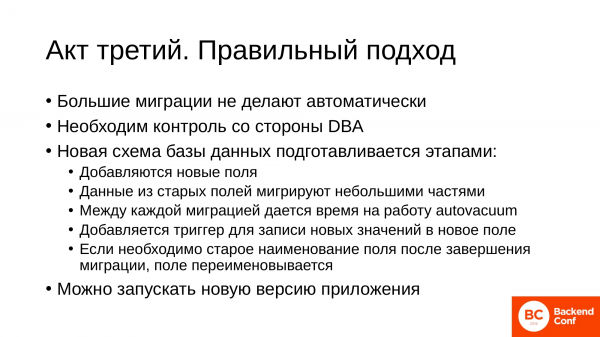
Dhe këtu gjëja kryesore është të kuptoni si të kryhen saktë migrime të tilla. Ato duhen bërë patjetër. Ne i bëjmë këto migrime rregullisht.
- Migrime kaq të mëdha nuk kryhen automatikisht. Ato duhet të jenë gjithmonë nën kontroll.
- Kërkohet mbikëqyrje nga një person me njohuri. Nëse keni një DBA në ekip, le ta bëjë DBA-ja. Kjo është puna e tij. Nëse jo, atëherë duhet ta bëjë personi më me përvojë, që di të punojë me databazat.
- Skemën e re të databazës, edhe kur përditësojmë vetëm një kolonë, e përgatisim gjithmonë me faza, pra paraprakisht, përpara se të publikohet versioni i ri i aplikacionit:
- Shtohen fusha të reja, ku do të shkruhen pikërisht të dhënat e përditësuara.
- I transferojmë të dhënat nga fusha e vjetër në fushën e re në pjesë të vogla. Pse e bëjmë këtë? Së pari, ne e kontrollojmë vazhdimisht procesin. E dimë sa batch-e kemi transferuar tashmë dhe sa kanë mbetur.
- Efekti i dytë pozitiv është se ndërmjet çdo batch-i të tillë mbyllim transaksionin, hapim një të ri dhe kjo i jep mundësi autovacuum-it të përpunojë tabelën dhe të shënojë rreshtat e vdekur për ripërdorim.
- Për rreshtat që do të shtohen gjatë funksionimit të aplikacionit (ndërkohë aplikacioni i vjetër vazhdon të punojë) shtojmë një trigger që shkruan vlerat e reja në fushat e reja. Në rastin tonë, kjo është shumëzimi me njëqind i vlerës së vjetër.
- Nëse jemi shumë këmbëngulës dhe duam të përdorim të njëjtën fushë, atëherë pas përfundimit të të gjitha migrimeve dhe përpara vendosjes së versionit të ri të aplikacionit, thjesht i riemërtojmë fushat. Të vjetrat i kalojmë në ndonjë emër të përkohshëm, ndërsa fushat e reja i riemërtojmë me emrat e vjetër.
- Dhe vetëm pas kësaj nisim versionin e ri të aplikacionit.
Dhe në këtë mënyrë nuk do të kemi bloat dhe nuk do të pësojmë rënie të performancës.
Këtu përfundoi historia e tretë.
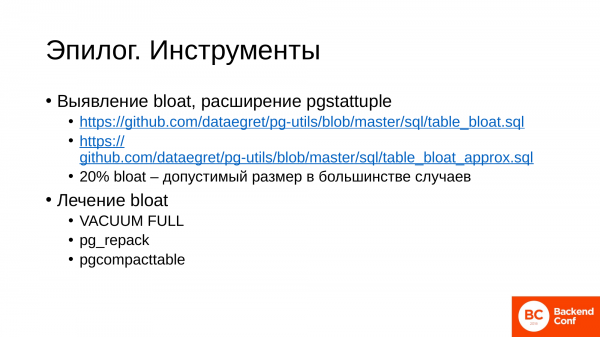
Dhe tani pak më hollësisht për mjetet që përmenda në historinë e parë.
Para se të kërkoni bloat, duhet patjetër të instaloni shtesën .
Që të mos shpikni vetë kërkesa, ne i kemi përgatitur tashmë këto kërkesa në punën tonë. Mund t'i përdorni. Këtu paraqiten dy kërkesa.
- E para ekzekutohet për një kohë më të gjatë, por ju tregon vlerat e sakta të bloat për tabelën.
- E dyta punon më shpejt dhe është shumë efektive kur duhet të vlerësoni shpejt nëse tabela ka apo jo bloat. Duhet të kuptoni gjithashtu se bloat në tabelat Postgres ekziston gjithmonë. Kjo është një veçori e modelit të tij MVCC.
- Dhe 20% bloat është normale për tabelat në shumicën e rasteve. Pra, nuk keni pse të shqetësoheni dhe ta kompaktoni këtë tabelë.
Si të identifikojmë tabelat që janë fryrë, konkretisht kur janë fryrë me të dhëna të panevojshme, e sqaruam.
Tani, si të korrigjohet bloat:
- Nëse kemi një tabelë të vogël dhe disqe të mira, pra për një tabelë deri në 1 GB është plotësisht e mundur të përdoret VACUUM FULL. Do të vendosë një bllokim ekskluziv në tabelë për disa sekonda, por nga ana tjetër e kryen punën shpejt dhe në mënyrë vendimtare. Çfarë bën VACUUM FULL? Ai vendos një bllokim ekskluziv në tabelë dhe i rishkruan rreshtat aktivë nga tabela e vjetër në një tabelë të re. Në fund, i ndërron vendet e tyre. Skedarët e vjetër i fshin dhe vendos skedarët e rinj në vend të tyre. Por gjatë ekzekutimit të tij, ai mban një bllokim ekskluziv mbi tabelën. Kjo do të thotë se me këtë tabelë nuk do të mund të bëni asgjë: as të shkruani në të, as të lexoni prej saj, as ta modifikoni. Dhe VACUUM FULL kërkon hapësirë shtesë në disk për të shkruar të dhënat.
- Mjeti tjetër . Sipas parimit të funksionimit, ai është shumë i ngjashëm me VACUUM FULL, sepse edhe ai i rishkruan të dhënat nga skedarët e vjetër në të rinj dhe i zëvendëson ato në tabelë. Por ai nuk merr bllokim ekskluziv mbi tabelën që në fillim të punës së tij; e merr vetëm në momentin kur të dhënat janë gati për zëvendësimin e skedarëve. Kërkesat për burimet e diskut janë të ngjashme me ato të VACUUM FULL. Ju duhet hapësirë shtesë në disk, dhe kjo ndonjëherë bëhet kritike nëse keni tabela me përmasa terabajtësh. Ai është gjithashtu mjaft kërkues për CPU, sepse punon intensivisht me hyrje-daljet.
- Vegla e tretë është . Ajo i trajton më me kujdes burimet, sepse funksionon sipas parimeve paksa të ndryshme. Thelbi i pgcompacttable është se, me anë të update-ve në tabelë, i zhvendos të gjitha rreshtat aktivë në fillim të tabelës. Më pas ekzekuton vacuum për atë tabelë, sepse e dimë që në fillim kemi rreshta aktivë, ndërsa në fund rreshta të vdekur. Pastaj vacuum-i vetë e pret atë bisht, pra nuk kërkon shumë hapësirë shtesë në disk. Për më tepër, mund të kufizohet edhe për sa i përket konsumit të burimeve.
Kaq për mjetet.
Nëse tema e bloat ju duket interesante për ta studiuar më thellë, ja disa lidhje të dobishme:
- – ky është prezantimi i kolegut tim. Është një material i përgjithshëm për atë se ku shkon hapësira në Postgres gjatë punës së tij. Aty ka edhe një pjesë shumë të madhe dhe të detajuar teknike për administratorët e bazave të të dhënave rreth bloat.
- – kjo është lidhja për te repository ynë, ku ruajmë shumë skripte të dobishme për kontrollin e gjendjes së bazës së të dhënave. Aty mund të gjeni skripte për zbulimin e bloat.
- dhe lidhje për mjetet që do t’ju ndihmojnë të ngjeshni tabelat.
- – ky është një postim i kolegut tim. Aty ai e analizon bloat në mënyrë mjaft serioze dhe të detajuar nga pikëpamja teknike, në një nivel tashmë të afërt me administratorët.
Unë këtu u përpoqa më shumë të tregoj një skenar alarmues për zhvilluesit, sepse ata janë përdoruesit tanë të drejtpërdrejtë të bazave të të dhënave dhe duhet të kuptojnë se çfarë pasojash sjellin veprimet e caktuara. Shpresoj që ia kam dalë. Faleminderit për vëmendjen!
Pyetje
Faleminderit për prezantimin! Ju folët për mënyrat se si mund të zbulohen problemet. Po si mund të parandalohen? Pra, kam pasur një situatë kur query-t nuk rrinin pezull vetëm sepse i drejtoheshin disa shërbimeve të jashtme. Ishin thjesht disa joins krejt të çmendura. Kishte edhe query shumë të vogla, në dukje të padëmshme, që rrinin pezull për një ditë të tërë e më pas fillonin të bënin gjëra të pakuptimta. Pra, është shumë e ngjashme me atë që përshkruat ju. Si mund të monitorohet kjo? Të rrish dhe të kontrollosh vazhdimisht se cili query ka ngecur? Si mund të parandalohet kjo?
Në këtë rast, kjo është një detyrë për administratorët e kompanisë suaj, jo domosdoshmërisht për DBA.
Unë jam administratore.
Në PostgreSQL ekziston një view i quajtur pg_stat_activity, ku shfaqen query-t e ngecura. Dhe ju mund të shihni sa kohë kanë qëndruar aty.
Duhet të hyj e ta kontrolloj çdo 5 minuta?
Konfiguroni cron dhe monitorojeni. Nëse keni një kërkesë që zgjat shumë, mjafton të dërgoni një email. Pra, nuk keni nevojë ta kontrolloni me sy — kjo mund të automatizohet. Do t’ju vijë një email dhe ju reagoni ndaj tij. Ose mund ta automatizoni edhe ekzekutimin e veprimeve.
A ka arsye të qarta pse ndodh kjo?
Disa prej tyre i përmenda. Shembujt e tjerë janë më të ndërlikuar. Dhe aty biseda mund të zgjasë shumë.
Faleminderit për prezantimin! Doja të sqaroja diçka për utilitën pg_repack. Nëse ajo nuk vendos bllokim ekskluziv, atëherë…
Ajo vendos bllokim ekskluziv.
… atëherë unë potencialisht mund të humbas të dhëna. Aplikacioni im nuk duhet të shkruajë asgjë gjatë asaj kohe?
Jo, ai punon normalisht me tabelën, pra pg_repack fillimisht zhvendos të gjitha rreshtat aktivë që ekzistojnë. Natyrisht, gjatë kësaj kohe ndodh edhe ndonjë shkrim në tabelë. Ai thjesht e shton edhe këtë pjesë të mbetur në fund.
Pra, në fund gjithsesi e bën?
Në fund ai merr një bllokim ekskluziv për të zëvendësuar këta skedarë me njëri-tjetrin.
A do të jetë kjo më e shpejtë se VACUUM FULL?
VACUUM FULL, sapo nis, merr menjëherë bllokim ekskluziv. Dhe derisa të përfundojë gjithçka, nuk e lëshon. Ndërsa pg_repack merr bllokim ekskluziv vetëm në momentin e zëvendësimit të skedarëve. Në atë moment nuk do të mund të shkruani aty, por të dhënat nuk do të humbasin, gjithçka do të jetë në rregull.
Përshëndetje! Ju folët për mënyrën si funksionon autovacuum. Aty ishte një grafik me qeliza shkrimi të kuqe, të verdha dhe të gjelbra. Pra, të verdhat — ai i ka shënuar si të fshira. Dhe si pasojë, a mund të shkruhet diçka e re në to?
Po. Postgres nuk i fshin rreshtat. Kjo është një veçori e tij. Nëse përditësojmë një rresht, të vjetrin e shënojmë si të fshirë. Aty vendoset ID e transaksionit që e ndryshoi atë rresht, dhe shkruajmë një rresht të ri. Dhe kemi sesione që potencialisht mund t’i lexojnë ato. Në një moment ato bëhen krejtësisht të vjetra. Thelbi i punës së autovacuum është që ai kalon mbi këta rreshta dhe i shënon si të panevojshëm. Dhe aty mund të rishkruhen të dhënat.
E kuptova. Por pyetja nuk është tamam për këtë. Nuk e përfundova. Supozojmë që kemi një tabelë. Në të ka fusha me madhësi të ndryshueshme. Dhe nëse përpiqem të fus diçka të re, kjo mund të mos futet thjesht në qelizën e vjetër.
Jo, në çdo rast përditësohet i gjithë rreshti. Në Postgres ka dy modele të ruajtjes së të dhënave. Zgjedhja varet nga lloji i të dhënave. Ka të dhëna që ruhen drejtpërdrejt në tabelë, dhe ka edhe të dhëna TOAST. Këto janë vëllime të mëdha të dhënash: tekst, JSON. Ato ruhen në tabela të veçanta. Dhe me këto tabela ndodh e njëjta histori me bloat, pra gjithçka është njësoj. Thjesht janë nxjerrë veçmas.
Faleminderit për prezantimin! Sa e pranueshme është të përdoret statement timeout për të kufizuar kohëzgjatjen e kërkesave?
Është plotësisht e pranueshme. Ne e përdorim kudo. Duke qenë se nuk kemi shërbimet tona, por ofrojmë mbështetje në distancë, kemi klientë shumë të ndryshëm. Dhe të gjithë janë plotësisht të kënaqur me këtë. Pra, kemi detyra në cron që e kontrollojnë këtë. Me klientin thjesht bihet dakord për kohëzgjatjen e sesioneve, para së cilës ne nuk i ndërpresim. Mund të jetë një minutë, mund të jenë 10 minuta. Kjo varet nga ngarkesa e bazës dhe nga qëllimi i saj. Por te të gjithë ne përdorim pg_stat_activity.
Faleminderit për prezantimin! Po përpiqem ta përshtat atë me aplikacionet e mia. Dhe duket se ne e nisim transaksionin kudo dhe e përfundojmë gjithmonë në mënyrë eksplicite. Nëse ka ndonjë exception, gjithsesi ndodh rollback. Dhe këtu u mendova. A mund të nisë transaksioni jo në mënyrë eksplicite? Ndoshta kjo është një pyetje me sugjerim për zonjushën. Nëse thjesht bëj një përditësim të një regjistrimi, a do të nisë transaksioni në PostgreSQL dhe do të përfundojë vetëm kur të mbyllet lidhja?
Nëse po flisni tani për nivelin e aplikacionit, kjo varet nga driver-i që përdorni dhe nga ORM-i që përdoret. Ka shumë konfigurime aty. Nëse e keni të aktivizuar auto commit on, atëherë transaksioni nis dhe mbyllet menjëherë.
Pra, mbyllet menjëherë pas update-it?
Kjo varet nga konfigurimet. Njërin konfigurim e përmenda: auto commit on. Është mjaft i zakonshëm. Nëse është i aktivizuar, transaksioni hapet dhe mbyllet menjëherë. Nëse nuk keni thënë në mënyrë eksplicite “start transaction” dhe “end transaction”, por thjesht keni nisur një kërkesë në sesion.
Përshëndetje! Faleminderit për prezantimin! Le të imagjinojmë që kemi një bazë që fryhet e fryhet dhe pastaj në server mbaron hapësira. A ka ndonjë mjet për ta rregulluar këtë situatë?
Hapësira në server, në mënyrë ideale, duhet monitoruar.
Për shembull, DBA shkoi të pijë çaj, ishte me pushime e kështu me radhë.
Kur krijohet sistemi i skedarëve, aty zakonisht rezervohet të paktën një hapësirë ku të dhënat nuk shkruhen.
Po nëse s’mbetet fare asnjë hapësirë?
Aty quhet pikërisht reserved space, domethënë mund të lirohet dhe, në varësi të madhësisë me të cilën është krijuar, ju fitoni hapësirë të lirë. Si parazgjedhje nuk e di sa është. Në rastin tjetër, duhet të shtoni disqe që të keni hapësirë për të kryer operacionin e rikuperimit. Mund të fshini ndonjë tabelë për të cilën jeni të sigurt se nuk ju duhet.
Nuk ka mjete të tjera?
Kjo është gjithmonë punë manuale. Dhe në vend përcaktohet çfarë është më mirë të bëhet, sepse ka të dhëna kritike dhe të tjera jokritike. Për çdo bazë të dhënash dhe aplikacion që punon me të, kjo varet nga biznesi. Gjithmonë vendoset sipas situatës konkrete.
Faleminderit për prezantimin! Kam dy pyetje. Së pari, ju treguat slide ku shihej se, në rastin e transaksioneve të bllokuara, rritet si vëllimi i tablespace-it, ashtu edhe madhësia e indeksit. Më pas gjatë prezantimit pati shumë utilitete që e kompaktuan tabelën. Po me indeksin çfarë ndodh?
Edhe ato i kompaktojnë.
Por vacuum nuk e prek indeksin?
Disa prej tyre punojnë edhe me indeksin. Për shembull, pg_rapack, pgcompacttable. Vacuum i rikrijon indekset, pra i prek ato. Thelbi i VACUUM FULL është të rishkruajë gjithçka, domethënë ai punon me të gjitha.
Dhe pyetja e dytë. Nuk e kuptova pse raportet në replika varen kaq shumë nga vetë replikimi. Mua më dukej se raportet janë lexim, ndërsa replikimi është shkrim.
Ku lind konflikti i replikimit? Kemi Master-in, ku zhvillohen proceset. Kemi autovacuum. Çfarë bën realisht autovacuum? Ai heq disa rreshta të vjetër. Nëse në atë moment në replikë po ekzekutohet një query që lexon këta rreshta të vjetër, dhe në Master ka ndodhur situata që autovacuum i ka shënuar këta rreshta si të gatshëm për rishkrim, atëherë ne i kemi rishkruar. Pastaj vjen paketa e të dhënave kur duhet të rishkruajmë ato rreshta që i duhen query-t në replikë, dhe procesi i replikimit do të presë timeout-in që keni konfiguruar. Më pas PostgreSQL do të vendosë çfarë është më e rëndësishme për të. Dhe për të, replikimi është më i rëndësishëm se query, ndaj ai do ta ndërpresë query-n që të zbatojë këto ndryshime në replikë.
Andrej, kam një pyetje. Këto grafikë të shkëlqyer që treguat gjatë prezantimit, a janë rezultat i punës së ndonjë utilitari tuaj? Me çfarë i keni ndërtuar grafikët?
Është një shërbim .
A është produkt komercial?
Po. Është produkt komercial.
Burimi: habr.com
