

Më quajnë Yuri, unë jam udhëheqës i grupit të administratës sistemike në Sitimobil. Sot do të ndaj përvojën time mbi teknologjinë e rezervimit të hollë (thin provisioning) të sistemeve të skedarëve Linux dhe do të flas për mënyrën si mund të aplikohet në proceset CI/CD të kompanisë. Ne do të shqyrtojmë situatën kur për testimin automatizuar të kodit gjatë dorëzimit në producim na nevojiten sa më shpejt kopjet e bazës së të dhënave MySQL, që janë sa më afër versionit 'aktive', të disponueshme për lexim dhe shkrim.
Hyrje: përse të japësh këshilla të dëmshme?
Një pyetje logjike, sepse ekzistojnë mekanizma të provuar për migrimin e skemave të DB në ambientet testuese. Pse ta çojmë bazën e të dhënave që nuk është e ndarë në këto përmasa? Plus, për testimin nuk nevojiten të dhëna të gjitha. Do të përpiqem ta shpjegoj.
Rreth një vit më parë, në sfondin e rritjes aktive të agregatorit tonë të taksave (në vitin 2018 u rritëm për afro 15 herë në lidhje me udhëtimet e përfunduara), u rritën volumet e të dhënave, ngarkesa mbi serverët, frekuenca e lëshimeve. Ne u gjendëm në situatën e mëposhtme:
- Baza e të dhënave MySQL u rrit në rreth 1000 tabela me një vëllim total prej 2.5 TB dhe vazhdoi të rritet.
- Nuk kishte mundësi të shpejtë për të bërë sharding dhe për të shpërndarë bazën. Kjo nuk e lejonte qasja e vjetër "shkruaj në bazë se çfarë dua dhe si dua", një mori JOIN-esh dhe varësish tabelash.
- Nuk kishte mekanizëm për migrimin e skemave të bazës së të dhënave në ambientet testuese.
- Nuk kishte testim automatizuar të kodit gjatë lëshimeve në prodhim.
Dëshira për të zgjidhur problemin e fundit ishte e madhe. Të testet Postman për verifikimin e monolitit kryesor PHP ishin tashmë shkruar, por na mungonte një bazë të dhënash aktuale. Megjithatë, nuk mund të krijonim një replikë gjatë natës, ta bëjmë atë master dhe ta japim për përdorim gjatë ditës: numri shumë i madh i lëshimeve dhe ndryshimeve, përfshirë ato në të dhëna dhe skemën e bazës së të dhënave, do të bënte që skenari të kishte probleme si në mesditë. Po ashtu, kufizimi i lëshimeve vetëm në ditën e punës do të ishte i paefektshëm.
Megjithatë, detyra u përmbush: ne morëm skenarin e parë funksional pas vetëm dy javësh. Gjatë vitit të kaluar ai ka undergone shumë ndryshime dhe vazhdon të përdoret.
Më pas, do të përshkruaj në detaje të gjitha hapat dhe fazat e zhvillimit të zgjidhjes sonë. Do të bindeni se ky metodë meritojnë të ekzistojë.
Çfarë është rezervimi i hollë?
Kjo është një teknologji harduerike ose softuerike (emri tjetër - volumet sparse), që lejon alokimin e një sasi më të madhe burimi të nevojshëm se sa është në dispozicion. Sasia e alokuar duhet të përmbushë kriteret just-enough (aq sa është e nevojshme) dhe just-in-time (në kohën e nevojshme). Kryesisht, rezervimi i hollë aplikohet në sisteme të ndryshme ruajtjeje për të ofruar hapësirë disk për sasi të nevojshme që e tejkalojnë atë që është aktualisht e disponueshme. Kjo teknologji është e mbështetur nga sisteme të ndryshme skedarësh, si LVM2, ZFS, BTRFS. Ajo përdoret gjerësisht në hipervizorët e virtualizimit. Rezervimi i hollë na lejojti të krijonim shpejt kaq shumë kopje të sistemit kryesor të të dhënave sa na duhej nga snapshot-et (direktorinë data të DBMS MySQL).
Stenda e parë, teknologjia Thin LVM
Këtë kapítull mund ta quajmë gjithashtu "Si të krijoni snapshot-e sa më të shpejtë për sasi të mëdha të të dhënave duke përdorur ", duke e ulur stabilitetin e sistemit të skedarëve dhe DBMS MySQL në tregues të papërshtatshëm."
Pasi kemi përdorur LVM për të ndërtuar pjesët kryesore të OS-së, vendosëm të fillojmë pikërisht nga ajo. Fillimisht na nevojitej një makinë fizike e veçantë - një kopje e bazës sonë kryesore MySQL, në të cilën mund të krijonim me kërkesë një snapshot të kopjes dhe të ngrihej kjo pranë me një ekzemplar të veçantë MySQL. Gjatë testimit, lejuam që të aplikoheshin operacione të ndryshimit në këtë ekzemplar, dhe pas përfundimit të testeve e fshihnim me sukses atë. Konfiguracioni i serverit ishte si më poshtë:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD në kontrolerin RAID Adaptec në RAID-10
Në lidhje me zgjedhjen midis kontrolerit RAID dhe RAID-it programatik MD, mund të shkruhet një artikull të veçantë. Do të them vetëm se zgjedhja jonë u ndikua nga dy faktorë:
- Në kohën e formulimit të detyrës, ne instalonim të gjitha DBMS-të në kontrolerë RAID, prandaj mund të themi se kështu krijohej historikisht.
- Dallimi në performancë në testet sintetike të sistemit të skedarëve dhe testet me operacione të ndryshme në MySQL ishte minimal.
Ne e ndarë RAID-10: kemi krijuar një grup volumesh (VG) për të gjithë kapacitetin (me shpenzime të përgjithshme rreth 6.7 GB) dhe kemi krijuar një ndarje logjike (Logical Volume, LV) për sistemin me 50 GB. Në situata normale, hapësira tjetër përdoret për ndarjen e MySQL. Por na nevojitej rezervimi i hollë, prandaj fillimisht kemi krijuar një të ashtuquajtur pool, brenda të cilit kemi krijuar një ndarje për \/var\lib\/mysql me 3.5 TB (duke u bazuar në volumet e parashikuara të DB):
lvcreate -l 100%FREE -T vga\/thin
lvcreate -V 3.5T -T vga\/thin -n mysql
Formatizuam ndarjen në ext4, e montuam atë, shkruam një replikë dhe morëm skenarin origjinal. Më pas bëri një API që duhet të krijojë snapshot-e, të ngrejë një instancë DB MySQL në portin e caktuar dhe të fshijë instancën e krijuar. Duke përdorur thirrje sistemike të vetëm, gjuha që zgjodhëm për shkruarjen e skenarëve ishte bashkimi, dhe për lidhjen e API-së HTTP → bash kemi zbatuar një zgjidhje open source. , e shkruar në Go.
Një ditë do t'i publikojmë skenarët tanë bash në open source, por tani do të përshkruaj algoritmin kryesor:
Krijimi i snapshot-it kryesor snapmain:
- Ndalojmë replikën kryesore.
- Vëmë një bllokim në operacionet me snapshot-in snapmain.
- Krijojmë një snapshot të ri snapmain.
- Nisemi MySQL dhe heqim bllokimin.
Krijimi i DB-së në një port të rastësishëm nga snapmain:
- Vëmë një bllokim në instancën specifike të DB-së (port).
- Kontrollojmë nëse ka një bllokim për krijimin e snapshot-it kryesor. Nëse po, presim dhe kontrollojmë përsëri çdo 5 sekonda.
- Kontrollojmë nëse ka një ndarje LV të vjetër të instancës.
3.1 Nëse ka, ndalojmë instancën MySQL me kill -9 dhe fshijmë ndarjen LV. - Krijojmë një instancë të re nga snapmain.
- Përgatitim dhe montojmë direktorët për këtë instancë.
- Heqim shenjat e skllavit (skedarët) dhe nisemi instancën MySQL.
- E bëjmë atë master.
- Heqim bllokimin.
Fshirja e DB-së në një port të rastësishëm:
- Vëmë një bllokim në instancën specifike të DB-së (port).
- Vrasim instancën MySQL me kill -9.
- Shkëputim direktorët.
- Fshijmë ndarjen LV dhe heqim bllokimin.
Shembuj komandash për klonimin e ndarjeve të instancës së re të DB-së:
lvcreate -n stage_3307 -s vga\/snapmain
lvchange -ay -K vga\/stage_3307
mount -o noatime,nodiratime,data=writeback \/dev\/mapper\/vga-stage_3307 \/mnt\/stage_3307
Tani tani, unë do t'ju flas për problemin kryesor me të cilin u përballëm gjatë përdorimit të rezervimit të hollë. Ne u përballëm me performancën e disqeve SSD. Kjo ndodhi për shkak të veçorive të Thin LVM: ajo operon në nivelin e pajisjes me blloqe të ulta me një madhësi default prej 4 MB. Si dukej kjo:
- Krijojmë një snapshot nga pjesa kryesore /var/lib/mysql.
- Nisim replikimin për të arritur master-in.
- Çdo ndryshim në tabelat e klonit detyron ruajtjen e blloqeve të dhënash të vjetra, të pandryshuara në seksionin e snapshot-it.
- Çdo ndryshim në instancën e ngritur për testim detyron ruajtjen e blloqeve të dhënash të vjetra, të pandryshuara në seksionin e snapshot-it të klonuar për këtë instancë.
- Përfundojmë me një ngarkesë të operacioneve të hyrjes-daljes prej 100% në pajisje, ngadalësim të çdo operacioni dhe ngadalësim të vazhdueshëm të replikës.
- Në fund të ditës së punës, kemi një qëndrim të prapambetur për disa orë.
Si e trajtuam këtë për të marrë një rezultat më të arsyeshëm (piketat kryesore):
Kontrolluesi RAID:
- Çdo lloj caching-u u çaktivizua nga default-i.
- Vendosëm writeback (kur të dhënat hyjnë në bufer, regjistrimi përfundon përpara se të ruhet me të vërtetë në disk).
Sistemi i skedarëve:
- Në pikën e montimit /var/lib/mysql shkruam noatime,nodiratime,data=writeback
- Çaktivizuam regjistrimin ext4 me mbështetje tuning 2fs.
MySQL:
- Shkruam innodb_flush_method = O_DSYNC (rritëm shpejtësinë e regjistrimit, në këtë mënyrë duke ulur besueshmërinë).
- Çaktivizuam regjistrimin, logjet nuk na nevojiten.
- Shkruam innodb_buffer_pool_size = 4G (sa më i vogël të jetë madhësia e pool-it InnoDB, aq më shpejt do të ndaloj MySQL gjatë ndalimit, dhe aq më shpejt do të krijojmë një snapshot).
Ky nuk është një listë e plotë, sidomos për MySQL. Megjithatë, ndryshimet e tjera janë të vogla dhe shpesh nuk janë gjithmonë dhe saktësisht të aplikueshme. Për shembull, në përpjekje për të shkarkuar disqet, madje kemi zhvendosur innodb_parallel_doublewrite_path në /dev/shm, që në disa raste, kur fillon një instancë që nuk është mbyllur në mënyrë të duhur, na kursente deri në 5 sekonda.
Pse e ndalojmë MySQL-in përpara se të bëjmë një snapshot? Sepse mund ta marrim atë nga një replikë që po punon. Kjo është e vërtetë, por instanca e re e DB-së në këtë snapshot do të konsiderohet automatikisht e dëmtuar dhe do të kërkojë një skanim të plotë gjatë nisjes. Të ndalosh replikën është sigurisht më e shpejtë, ndonëse kjo përfundimisht është operacioni më i gjatë në të gjithë procesin.
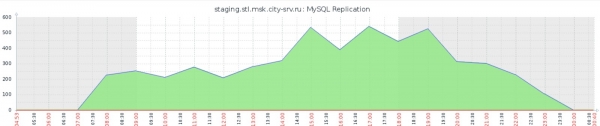
Si pasë kemi arritur rezultate më të pranueshme në kohëzgjatje dhe një qëndër funksionale. Megjithatë, siç është e dukshme nga grafiku më konkludues i vonesës së replikimit të replikës kryesore, situata ende është shumë larg idealit:
Nga mangësitë e tjera, duhet të theksohet pamundësia praktike e monitorimit të rezervuarit Thin LVM: përveç funksioneve standarde sistemore si iostat, të kuptosh, p.sh., se cili element i rezervuarit aktualisht shkakton ngarkesën më të madhe në sistemin e skedarëve është e pamundur.
Veçanërisht duhet theksuar një mangësi të madhe të lidhur me optimizimin e përshkruar më lart: ne fituam një qëndër YOLO. Rreth çdo një deri në dy muaj, ext4 nuk përballonte këto abuzime mbi veten dhe thyehej përfundimisht, duke kërkuar formatimin dhe ripunimin e replikës. Duke fituar në shpejtësi, ne e shkatërruam pa shpresë stabilitetin.
Cilat metrika duhet të ndjekin gjatë përdorimit të Thin LVM:
- Përqindja e të dhënave në rezervuarin e hollë
- Përqindja e metadata në rezervuarin e hollë
Nëse rezervuari ynë do ta kalonte mungesën e hapësirës për të dhëna (mjafton të pastroni disqet), mungesa e hapësirës për metadata do të çonte në një dështim të plotë të rezervuarit dhe nevojën për ta krijuar nga e para.
Sistemi i skedarëve brenda rezervuarit me kalimin e kohës fragmentohet shumë. Rekomandoj të ekzekutoni çdo ditë me cron komandën fstrim -v /var/lib/mysql.
Përfundimet ndërmjetëse:
- Teknologjia është lehtësisht e aplikueshme, ashtu si LVM vetë, dhe nuk kërkon një kualifikim të veçantë të inxhinierit.
- Ajo do të përshtatet mirë për baza të dhënash të vogla dhe jo shumë të ngarkuara. Sa më e vogël baza e të dhënave, aq më pak blloqe lëvizin në sistemin e skedarëve brenda rezervuarit, dhe aq më e ulët është ngarkesa në disqe.
- Për detyrën tonë ne filluam të kërkonim zgjidhje të tjera, për të cilat do të flasim në seksionin e ardhshëm.
Qëndra e dytë, teknologjia ZFS
Dikur, unë kam pasur përvoja me sistemin e skedarëve ZFS, por atëherë ZFS funksiononte mjaft mirë në familjen e tij të origjinës, OS Solaris. Ekzistonte një version i portuar në FreeBSD me një nivel të kënaqshëm implementimi. Po ashtu kishte një port të papërfunduar në Linux, i cili përdorej nga pak. Për shkak të strukturës së ruajtjes së të dhënave B-tree (e cila, për t'u theksuar, është njësoj si struktura e ruajtjes në InnoDB MySQL), ZFS tregonte një performancë të dobët në instalimet me një numër shumë të madh skedash. Të gjitha këto, së bashku me nevojën për të mësuar aspektet teknike para përdorimit, e hoqën për një kohë të gjatë këtë sistem skedarësh nga praktika ime. U shfaqën ext4 dhe xfs, të cilat u bënë standarde. Por duke pasur parasysh se për ne ZFS është më se e përshtatshme dhe duke ditur se versioni Linux, sipas të dhënave, është rritur në një produkt të arsyeshëm (edhe pse jo me mbështetje të plotë, gjë që e bën instalimin e sistemit nga zero në ZFS vetëm me ndihmën e disa trukeve), ne vendosëm ta provojmë.
Për arsye të dukshme, ne zgjodhëm një konfigurim të ngjashëm (përveç kontrolerëve RAID). Vendosëm tetë disqe SSD me 1920 Gb secili. Nuk kishte dëshirë të shkruanim imazhin e rrjetit tonë për përgatitjen e serverit në ZFS të pastër, prandaj ne prenotëm 50 Gb nga secili disk dhe bëmë një RAID-10 me MD për sistemin. Mbeturinat prej 1950 Gb në çdo disk u bashkuan në një ZFS të ngjashëm me RAID-10:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Krijuam seksione për MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Vini re se ne aktivizuam kompresimin standard të të dhënave gzip. Ne kemi shumë burime procesori në serverin tonë dhe ato nuk janë plotësisht të përdorura. Si rezultat, 3 Tb e bazës sonë të të dhënave u shndërruan në 1.6 Tb, dhe duke marrë parasysh se pika e dobët, ashtu si në rastin e kaluar, është performanca maksimale e disqeve, sa më pak të dhëna - aq më mirë, ne që në fillim marrim një bonus të shkëlqyer nga ZFS! Në kohët e ngarkesës maksimale, ruajtja e funksionit gzip përdor deri në 4 bërthama procesorësh, por ne nuk e kemi problem.
Më pas, implementimi shkoi më shpejt. Ne transferuam konfigurimet e replikës MySQL nga stendi LVM. Na mori ca kohë për të riparë scriptet në komandat e ZFS, por në përgjithësi algoritmet mbetën të njëjta. Shembulli i krijimit të një snapshot-i:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
Nga tuning-u shtesë: kemi hequr në memorie ndarjet e ZFS me metadata dhe loge l2arc dhe zil. Për ne, siç u bë e dukshme më vonë, kjo ishte e tepërt, por deri tani e kemi lënë këtë optimizim, ndryshimi nuk është i vështirë në rastin e duhur. Nga efektet negative — duhet të ricreojmë hapësirat përkatëse në memorie pas ribashkimit të serverit. Të dhëna nuk humbasin. Nxjerrja e zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
Në këtë konfigurim filluam të testojmë standin dhe përfituam rezultate të shkëlqyera: me dy instanca BD që funksiononin në të njëjtën kohë (dhe me replikën kryesore aktive) mbi snapshots arritëm një ngarkesë të disqeve prej 50-60%.
Kemi zbatuar problemin tonë kryesor, që shihet në grafikun e vonesës së replikimit (krahaso me grafikun e mëparshëm në seksionin Thin LVM):
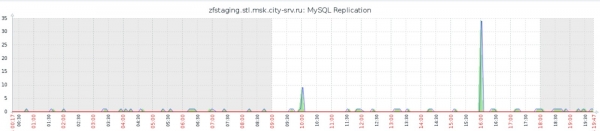
Përveç dhe falë kësaj, u përshpejtua ndjeshëm në të gjitha operacionet: krijimi i plotë i një snapshot-i me ndalimin dhe nisjen e replikës zgjat deri në 40 sekonda, ndërsa zhvillimi nga snapshot-i një ekzemplar i ri MySQL zgjat deri në 20 sekonda. Kjo na kënaq si ne, ashtu dhe testet tona të kodit.
Përfundimet ndërmjetëse:
- Rezultatet plotësisht mbuluan nevojën tonë për të marrë një kopje të BD-së aktive për testimin e kodit.
- Teknologjia kërkon njohuri: duhet të kuptoni se çfarë është ZFS dhe si funksionon.
- Nuk e kemi kontrolluar statusin aktual të punës së ZFS me një numër të madh (më shumë se 1 milion) skedarësh të vegjël. Por supozojmë që problemi ekziston ende, prandaj nuk do ta rekomandoja këtë sistem skedari për ndonjë depo të skedarëve.
Çfarë ndodh më tej?
Në kuadër të panelit, nuk kemi bërë asgjë tjetër, rezultati na kënaq. Mundësisht, në të ardhmen do të shtojmë në konfigurimin e replikimit të panelit përjashtime të tabelave që nuk janë të nevojshme për testim, kjo do të zvogëlojë edhe më shumë volumin e DB. Nuk kemi testuar sistemin BTRFS dhe zbatimin e teknologjisë së ruajtjes së hollë. Megjithatë, një detyrë e tillë nuk është më e nevojshme, pasi që objektivi kryesor është arritur. Në përgjithësi, natyrisht, dëshirojmë të largohemi nga qasja e përshkruar më sipër - të realizojmë migrazhime funksionale të DB në mjedisin e testimit, të krijojmë një kontur të veçantë testimi për DB, të merremi me shardingun e bazës kryesore. Shumica e kësaj tashmë po e realizojmë, për të cilën do të flasim patjetër në artikujt e ardhshëm.
Përfundime
Detyra fillestare u zgjidh, edhe pse në një mënyrë të pazakontë. Në përfundimet ndërmjetëse u përmendën përparësitë dhe dobësitë e secilës nga teknologjitë e aplikuara, kështu që le të vendosim se cila teknologji dhe kur mund të përdoret:
- Thin LVM - për DB të vogla dhe kur nuk dëshiron ose nuk ke kohë të studioj ZFS.
- ZFS - nëse ke përvojë në punën me të ose mundësinë për të shpenzuar kohë në studim në çdo situatë.
Në një nivel më të lartë, ky artikull nuk është vetëm një krahasim i teknologjisë së dy sistemeve të skedarëve. Ideja kryesore, që do doja të përcillja dhe konsolidoja, është se nuk duhet të frikësohemi të mendojmë në mënyrë jo standarde në situata të kritike për biznesin dhe të marrim vetëm receta të gatshme. Disa herë mund të ishim të gjithë duke tundur kokën dhe thënë se detyra e krijimit të kopjeve të DB prej tre terabajtësh për më pak se një minutë është e pamundur, dhe nuk na duhen teknologji të rrezikshme, le të bëjmë siç duhet. Kjo do ishte e mundur, por do të kishim humbur rreth gjashtë muaj deri një vit dhe shumë udhëtime të klientëve (udhëtimet janë treguesi ynë kryesor i biznesit) pa teste dhe gjatë implementimit. Duke vepruar në mënyrë jo standarde, humbëm jo aq shumë kohë në implementim, fituam përvojë në teknologji të reja dhe të harruara më parë, dhe ofruam testim pikërisht në momentin kur kishim shumë nevojë për të. Pa dyshim, kjo ka ndikuar pozitivisht në të gjitha treguesit tanë. Zgjedhja gjithmonë është e juaja, dhe ne nga ana jonë do të vazhdojmë të flasim në blogun tonë për arritjet interesante aktuale dhe të ardhshme.
Burimi: habr.com
