

Mirësi për të gjithë!
Më quajnë Nikita, unë jam lideri i ekipit të inxhinierëve në Cian. Një nga detyrat e mia në kompani është të reduktoj ngjarjet që lidhen me infrastrukturën në prodhim, deri në zero.
Ajo që do të diskutohet më poshtë na ka sjellë shumë dhimbje, dhe qëllimi i këtij artikulli është të mos lejojmë që të tjerët të përsërisin gabimet tona ose të paktën të minimalizojnë ndikimin e tyre.
Preambula
Kohë më parë, kur Cian ishte një monolit dhe nuk kishte asnjë shenjë të mikroshërbimeve, ne matnim disponueshmërinë e burimit duke kontrolluar 3–5 faqe.
Nëse përgjigjen - gjithçka është në rregull, dhe nëse nuk përgjigjen për një kohë të gjatë - alarëm. Sa kohë duhet të mos funksionojnë për ta konsideruar si një ngjarje, e vendosnin njerëzit në mbledhje. Ekipi i inxhinierëve gjithmonë merrte pjesë në hetimin e ngjarjes. Kur hetimi përfundonte, shkruanin një postmortem - një raport të veçantë që dërgohej me email në format: çfarë ndodhi, sa zgjati, çfarë bëmë në momentin e ngjarjes, çfarë do të bëjmë në të ardhmen.
Faqet kryesore të faqes ose si kuptojmë se e kemi arritur fundin
Për të kuptuar siç duhet përparësinë e gabimeve, ne kemi identifikuar faqet më kritike për funksionalitetin e biznesit. Për to, ne llogarisim numrin e kërkesave të sukseshme/dështuar dhe kohëzgjatjet. Kështu masim uptime-in.
Le të themi se kemi zbuluar se ekzistojnë disa seksione super të rëndësishme të faqes që janë përgjegjëse për shërbimin kryesor - kërkimi dhe paraqitja e shpalljeve. Nëse numri i kërkesave që përfunduan me gabim kalon 1% - është një ngjarje kritike. Nëse brenda 15 minutash në orar të pikut përqindja e gabimeve kalon 0,1% - atëherë kjo gjithashtu konsiderohet si një ngjarje kritike. Këto kritere mbulojnë pjesën më të madhe të ngjarjeve, të tjera dalin jashtë këtij artikulli.
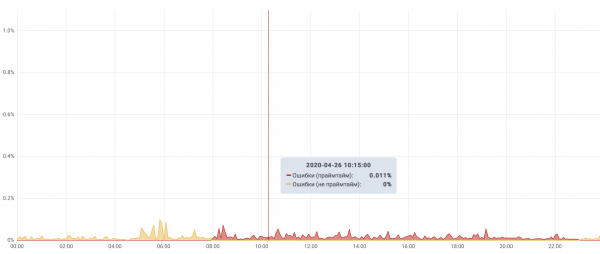
Top ngjarjet më të mira të Cian
Pra, ne me siguri kemi mësuar të përcaktojmë faktin që ka ndodhur një ngjarje.
Tani çdo ngjarje është e përshkruar në detaje dhe pasqyrohet në epikën Jira. Për ta thënë këtë: për këtë ne nisëm një projekt të veçantë dhe e quajtëm FAIL - në të mund të krijohet vetëm epikë.
Nëse mbledhim të gjitha dështimet e vitet e fundit, ato kryesojnë:
- ngjarjet që lidhen me mssql;
- ngjarjet që u shkaktuan nga faktorë të jashtëm;
- gabimet e administratës.
Do të përqendrohemi më në detaje në gabimet e administratorëve, si dhe në disa dështime të tjera interesante.
Vendi i pestë - "Renditja e DNS-it"
Ishte një martë e ndotur. Vendosëm të rregullojmë rendin në DNS-klusterin tonë.
U dëshiruam të kalonim serverat e brendshëm DNS nga bind në powerdns, duke rezervuar për këtë servera krejtësisht të veçantë, ku nuk ka asgjë tjetër përveç DNS.
Vendosëm nga një server DNS në çdo vendndodhje të qendrave tona të të dhënave, dhe erdhi momenti i kalimit të zonave nga bind në powerdns dhe kalimin e infrastrukturës në serverat e rinj.
Në kulmin e kalimit nga të gjitha serverësh, që ishin shënuar në cache-local bind në të gjitha serverat, mbeti vetëm një, që ishte në qendrën e të dhënave në Shën Petersburg. Ky DC në fillim ishte deklaruar si jo kritik për ne, por papritmas u bë një pikë e vetme dështimi.
Pikërisht në këtë periudhë kalimi ra lidhja midis Moskës dhe Shën Petersburgut. Në fakt, mbetëm pa DNS për pesë minuta dhe u rikthyem, kur hosti zgjidhi problemet.
Përfundimet:
Nëse më parë e neglizhonim faktorët e jashtëm gjatë përgatitjes për punë, tani i përfshimë ato në listën e asaj për të cilën po përgatitemi. Dhe tani synojmë që të gjithë komponentët të jenë të rezervuar n-2, ndërsa gjatë punëve mund të ulim këtë nivel në n-1.
- Gjatë hartimit të planit të veprimit, shënoni pikat ku shërbimi mund të bjerë, dhe mendoni për skenarin ku gjithçka shkon "më keq se asnjëherë" paraprakisht.
- Rregulloni serverat e brendshëm DNS në lokacione të ndryshme gjeografike/qendra të të dhënave/rrafshina/switch-e/influx.
- Në çdo server vendosni një server lokal të cache DNS, i cili redirekton kërkesat në serverat kryesorë të DNS, dhe në rast të papërshtatshmërisë do të përgjigjet nga cache.
Vendi i katërt — "Rregullojmë rregullat në Nginx"
Në një ditë të bukur, ekipi ynë vendosi se "mjafton të durojmë", dhe procesi i riorganizimit të konfigurimeve të nginx filloi. Qëllimi kryesor — të sjellim konfigurimet në një strukturë intuitivisht të kuptueshme. Më parë gjithçka ishte "historikisht e krijuar" dhe nuk kishte logjikë. Tani çdo server_name është nxjerrë në një skedar të quajtur në të njëjtën emër dhe të gjitha konfigurimet janë shpërndarë në dosje. Për t'u thënë — konfigurimi përmban 253949 rreshta ose 7836520 karaktere dhe zë pothuajse 7 megabajt. Niveli i sipërm i strukturës:
Struktura e Nginx
├── akses
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dinamik
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Ka ishte shumë më mirë, por gjatë procesit të rinomimit dhe shpërndarjes së konfigurations, disa prej tyre kishin një zgjerim të gabuar dhe nuk u futën në direktivën include *.conf. Si pasojë, disa hoste u bënë të paqëndrueshëm dhe kthyen 301 në kryefaqe. Për shkak se kodi i përgjigjes nuk ishte 5xx/4xx, këtë nuk e vunë re menjëherë, por vetëm në mëngjes. Pas kësaj, filluam të shkruajmë teste për kontrollet e komponenteve infrastrukturore.
Përfundimet:
- Strukturoni me saktësi konfigurat (jo vetëm nginx) dhe mendoni për strukturën në fazën fillestare të projektit. Kështu do t’i bëni ato më të kuptueshme për ekipin, çka nga ana tjetër do të ulë TTM-në.
- Për disa komponente infrastrukturore shkruani teste. Për shembull: kontrolloni që të gjithë server_name kyç t’i japin statusin e duhur, + trupin e përgjigjes. Mjafton të keni disa skripte që kontrollojnë funksionet kryesore të komponentit, në mënyrë që të mos kujtoni me panik në 3 të mëngjesit çfarë duhet të kontrolloni.
Vendi i tretë — "Papritur mbaroi vendi në Cassandra"
Të dhënat rriteshin rregullisht, dhe gjithçka ishte mirë deri në momentin kur në klasterin Cassandra filluan të dështojnë riparimet e case-space-ve të mëdha, sepse nuk mund të funksiononte kompaktimi.
Në një ditë të errët, klasteri u shndërrua pothuajse në një kungull, konkretisht:
- mbetën rreth 20% e përgjithshme për klasterin;
- nuk mund të shtohen nodet në mënyrë të plotë, sepse nuk kalon pastrimin pas shtimit të nodit për shkak të mungesës së vendit në seksionet;
- performanca po ulet ngadalë, pasi kompaktimi nuk punon;
- klasteri punon në një modalitet emergjent.
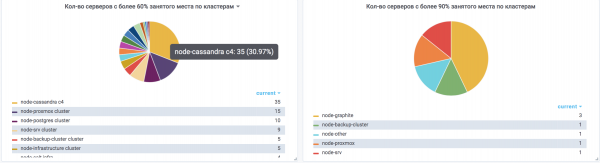
Ixit — kemi shtuar edhe 5 nodë pa pastrimin, pas të cilave filluam ta nxjerrim gradualisht nga klasteri dhe ta rikthejmë përsëri, si nodë të pastra, në të cilat kishte përfunduar hapësira. Koha e shpenzuar është shumë më e madhe se sa do të doja. Ishte një rrezik i disponueshmërisë pjesore ose të plotë të klasterit.
Përfundimet:
- Në të gjitha serverat cassandra, hapësira në secilin seksion nuk duhet të jetë më shumë se 60%.
- Të ngarkuarit nuk duhet të jenë më shumë se 50% për CPU.
- Nuk duhet të neglizhohet planifikimi i kapacitetit dhe ai duhet menduar për secilin komponent, në bazë të specifikave të tij.
- Sa më shumë nodë të jenë në klaster, aq më mirë. Serverat që mbajnë një volum të vogël të të dhënave janë më të shpejtë në rikthim, dhe një klaster i tillë është më i lehtë për t'u ringjallur.
Vendi i dytë — “Të dhënat u zhdukën nga konsoli i ruajtjes key-value.”
Për zbulimin e shërbimeve, ne, ashtu si shumë të tjerë, përdorim konsolën. Por KV i saj përdoret gjithashtu për shpërndarjen blue-green të monolit. Atje ruhet informacioni mbi upstream-et aktiv dhe jo aktiv, të cilët ndërruan vende gjatë deplojit. Për këtë, është shkruar një shërbim deploy-i, që ndërvepronte me KV. Në një moment, të dhënat nga KV u humbën. U rikuperuan nga memoria, por me disa gabime. Si pasojë, gjatë shpërndarjes, ngarkesa në upstream ishte e shpërndarë në mënyrë të pabarabartë, dhe ne morëm shumë gabime 502 për shkak të ngarkesës në backend për CPU. Në fund, u transferuam nga konsolë KV në postgres, nga e cila është më e vështirë për t'i fshirë tashmë.
Përfundimet:
- Shërbimet pa ndonjë autorizim nuk duhet të përmbajnë të dhëna kritike për funksionimin e faqes. Për shembull, nëse nuk keni autorizim në ES — do të ishte më mirë të ndalonit qasje në nivelin e rrjetit nga çdo vend që nuk është e nevojshme, të lini vetëm ato të nevojshme, dhe gjithashtu të bëni action.destructive_requires_name: true.
- Punoni për mekanizmin e rezervës dhe rikuperimit paraprakisht. Për shembull, krijoni një skenar (për shembull, në python), që di të bëjë backup dhe rikthim.
Vendi i parë — “Kapiteni i paqartësisë.”
Në një moment, ne vëmë re një shpërndarje të pandershme të ngarkesës në upstream-et e nginx në rastet kur në backend kishte 10+ serverë. Për shkak se round-robin drejtonte kërkesat nga 1 në upstream-in e fundit me radhë, dhe çdo rinovim i nginx fillonte nga e para, gjithmonë kishte më shumë kërkesa për upstream-et e parë sesa për të tjerët. Si pasojë, ata punonin më ngadalë dhe të gjithë u ndikuan nga kjo. Kjo bëhej gjithnjë e më e dukshme me rritjen e sasisë së trafikut. Një thjeshtë azhurnim në nginx për të aktivizuar random nuk e zgjidhi problemin — duhej të rregullohej shumë kod LUA, i cili nuk λειτουργonte në versionin 1.15 (në atë kohë). Iu desh të patchonim nginx 1.14.2 tonin, duke futur mbështetje për random. Kjo e zgjidhi problemin. Ky defekt është fitues në kategorinë «kapitani i padukshmërisë».
Përfundimet:
Ishte shumë interesante dhe emocionuese të hetoja këtë defekt).
- Ndërtoni monitorimin në mënyrë që ai të ndihmojë në gjetjen e fluktuacioneve të tilla shpejt. Për shembull, mund të përdorni ELK për të vëzhguar rps për çdo backend të çdo upstream, duke ndjekur kohën e tyre të përgjigjes nga perspektiva e nginx. Në këtë rast, kjo na ndihmoi të identifikohemi problemin.
Si rezultat, shumë prej dështimeve do të ishin shmangur me një qëndrim më të kujdesshëm në ato që bëni. Duhet gjithmonë të mbani mend ligjin e Murphy: Çdo gjë që mund të shkojë keq do të shkojë keq, dhe të ndërtoni komponente duke u udhëhequr nga ajo.
Burimi: habr.com
