

Principi i pasigurisë i Heisenbergut thotë se nuk mund të matet njëkohësisht pozita e një objekti dhe shpejtësia e tij. Nëse objekti lëviz, atëherë ai nuk ka vendndodhje. Ndërsa nëse ekziston një vendndodhje – atëherë ai nuk ka shpejtësi.
Sa i përket mikroshërbimeve në platformën Red Hat OpenShift (dhe nën menaxhimin e Kubernetes-it), falë softuerit përkatës me kod të hapur, ato mund të raportohet njëkohësisht mbi performancën e tyre dhe funksionalitetin. Kjo, natyrisht, nuk e kundërshton z. Heisenberg, por ndihmon në eliminimin e pasigurisë gjatë punës me aplikacionet në re. Istio lejon që të organizohet lehtësisht ndjekja (kërcimi) dhe monitorimi i këtyre aplikacioneve për të mbajtur gjithçka nën kontroll.
Po e përcaktojmë terminologjinë
Nën kërcimin (Tracing) kuptojmë logimin e aktiviteteve sistemike. Dëgjohet mjaft përgjithësisht, por në të vërtetë një nga rregullat kryesore këtu është që të derdhen të dhënat e kërcimit në një ruajtje të përshtatshme, pa u shqetësuar për formatizimin e tyre. E gjithë puna e kërkimit dhe analizës së të dhënave i besohet përdoruesit të tyre. Në Istio përdoret sistemi i kërcimit Jaeger, që implementon modelin e të dhënave OpenTracing.
Kërcimet (Traces, dhe fjala "kërcime" këtu përdoret në kuptimin e "gjurmëve", si për shembull në ekspertizën ballistike) ne do t’i quajmë të dhënat që përshkruajnë plotësisht kalimin e një kërkese ose një njësie pune, siç thuhet, "nga fillimi në fund". Për shembull, gjithçka që ndodh që nga momenti kur përdoruesi shtyp një buton në një faqe web dhe deri në momentin e kthimit të të dhënave, duke përfshirë të gjitha mikroshërbimet e angazhuara në të. Mund të thuhet se një kërcim përshkruan plotësisht (apo modelon) kalimin e një kërkese përpara dhe prapa. Në ndërfaqen Jaeger, kërcimet janë të ndara në komponentë sipas boshtit të kohës, siç mund të ndahet një zinxhir në lidhje të veçanta. Vetëm se në vend të lidhjeve, kërcimi përbëhet nga ato që quhen span.
Span – është intervali nga fillimi i ekzekutimit të një njësie pune deri në përfundimin e saj. Duke vijuar analogjinë, mund të thuhet se secili span është një lidhje e veçantë e zinxhirit. Span mund të ketë (ose nuk ka) një ose më shumë span të fëmijëve. Si pasojë, span i nivelit më të lartë (root span) do të ketë të njëjtën kohë totale si dhe pista që i përket.
Monitorimi – është, në thelb, vetë vëzhgimi i sistemit tuaj – me sy, përmes UI ose mjeteve të automatizimit. Në thelb të monitorimit janë të dhënat e gjurmimit. Në Istio, monitorimi realizohet përmes Prometheus dhe ka UI përkatës. Prometheus mbështet automatikisht monitorimin me përdorimin e alarmet Alerts dhe Menaxherëve të Alarmit.
Lëmë shenjat
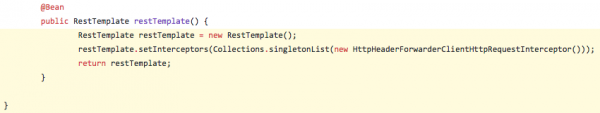
Për të bërë të mundur gjurmimin, aplikacioni duhet të krijojë një koleksion span-esh. Më pas, ato duhet të eksportohen në Jaeger, në mënyrë që ai gjithashtu të krijojë një përfaqësim grafik të gjurmimit. Mes të tjerash, këto span shënojnë emrin e operacionit, si dhe etiketat e kohës për fillimin dhe përfundimin e tij. Transferimi i span-ëve realizohet përmes riadresimit të titujve të HTTP që janë të destinuara për Jaeger nga kërkesat hyrëse në ato dalëse. Në varësi të gjuhës së përdorur të programimit, kjo mund të kërkojë disa modifikime të vogla të kodit burimor të aplikacioneve. Më poshtë jepet një shembull kodi në Java (ndërsa përdorim kornizën Spring Boot), e cila shton titujt B3 (në stilin Zipkin) në kërkesën tuaj në klasën konfigurimit të Spring:
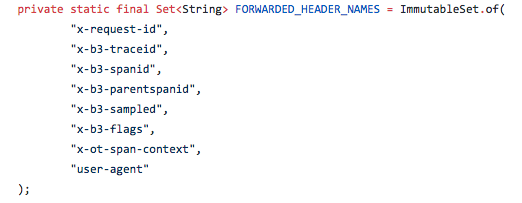
Për këtë përdoren cilësimet e mëposhtme të titujve:
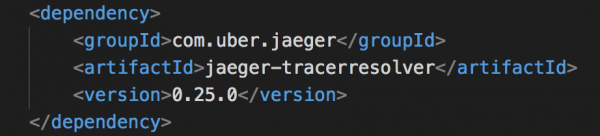
Nëse përdorni Java, kodin nuk është e nevojshme ta prekni, por thjesht addoni disa rreshta në skedarin POM dhe caktoni variablat e ambientit. Ja cilat rreshta duhet të shtoni në skedarin POM.XML për të futur Jaeger Tracer Resolver:
Dhe variablat përkatës të ambientit caktosh në Dockerfile:
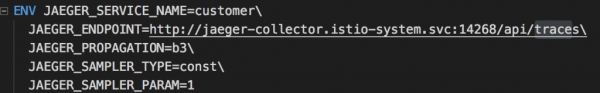
E gjithë, tani gjithçka është e konfiguruar, dhe mikroshërbimet tona do të fillojnë të gjenerojnë të dhëna gjurmimi.
Shikojmë në përgjithësi
Në përbërje të Istio ndodhet një panel kontrolli të thjeshtë të bazuar në Grafana. Kur të gjitha janë të konfiguruara dhe funksionojnë në platformën Red Hat OpenShift PaaS (në shembulin tonë, Red Hat OpenShift dhe Kubernetes janë vendosur në minishift), ky panel fillon me komandën e mëposhtme:
open "$(minishift openshift service grafana -u)/d/1/istio-dashboard?refresh=5⩝Id=1"
Pana Grafana lejon të vlerësojë shpejt performancën e sistemit. Një fragment i kësaj panele është treguar në figurën më poshtë:
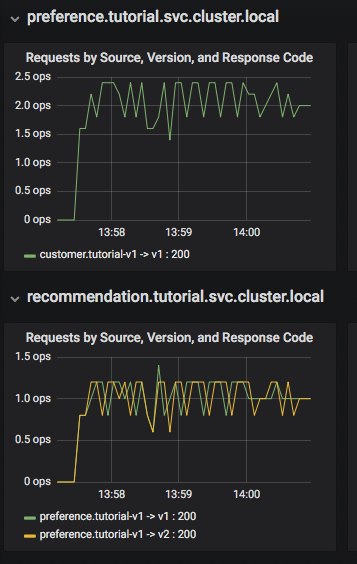
Këtu shihet se mikroshërbimi customer thërret mikroshërbimin preference v1, dhe ky i fundit thërret mikroshërbimet recommendation v1 dhe v2. Në panën Grafana ka një bllok Dashboard Row për metrika të nivelit të lartë, siç janë numri i përgjithshëm i kërkesave (Global Request Volume), shkalla e sukseseve (success rates), gabimet 4xx. Për më tepër, atje ka një pamje Server Mesh me grafika për çdo shërbim dhe një bllok Services Row për të parë detajet e hollësishme për çdo kontejner për çdo shërbim.
Tani do të thellojmë më thellë
Me konfigurimin e duhur të gjurmimit Istio, çfarëdo që quhet, lejon një analizë të thelluar të performancës së sistemit direkt nga kutia. Në UI-në Jaeger mund të shihni gjurmimet dhe të shihni se si arrijnë deri në thellësi, si dhe të lokalizoni vizualisht ngushticat në performancë. Duke përdorur Red Hat OpenShift në platformën minishift, mund të nisni UI-në Jaeger me komandën e mëposhtme:
minishift openshift service jaeger-query --in-browser
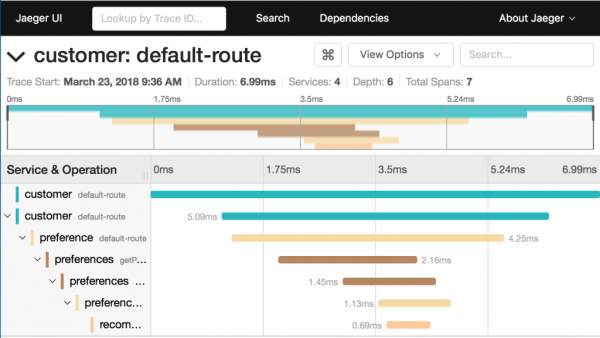
Çfarë mund të themi mbi gjurmimin në këtë ekran:
- Ajo ndahen në 7 span’ë.
- Koha e përgjithshme e ekzekutimit është 6.99 ms.
- Për mikroshërbimin recommendation, i cili është i fundit në zinxhir, shpenzohen 0.69 ms.
Diagramet e këtij lloji lejojnë shpejt të kuptohet situata kur një shërbim jo shumë funksional ndikon në performancën e gjithë sistemit.
Tani do të ndërlikojmë situatën dhe do të nisnim dy ekzemplarë të mikroshërbimit recommendation:v2 me komandën oc scale --replicas=2 deployment/recommendation-v2. Këto do të jenë pod’ët tanë pas kësaj:
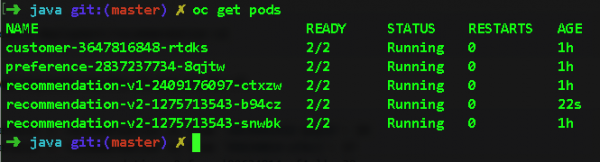
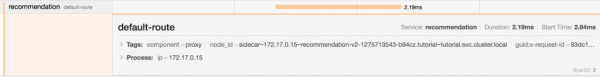
Nëse tani kalojmë përsëri në Jaeger dhe zgjerojmë span për shërbimin recommendation, do të shohim se në cilin pod po ruten kërkesat. Kështu, mund të lokalizojmë lehtësisht ngadalësimet në nivelin e një pod’i të veçantë. Duhet të shohim në fushën node_id:
Ku dhe si shkojnë të gjitha
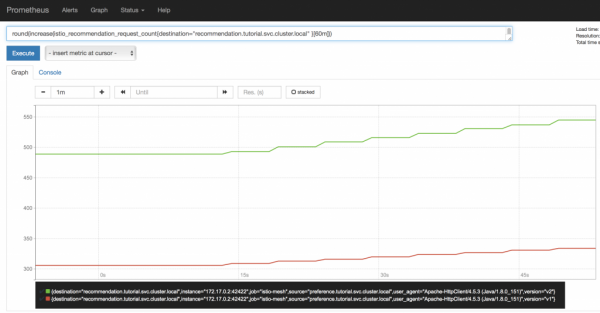
Tani kalojmë në ndërfaqen e Prometheus dhe pritet të shohim atje se kërkesat midis versioneve të dyta dhe të para të shërbimit recommendation ndahen në raportin 2:1, rreptësisht sipas numrit të pod’ëve që punojnë. Ky grafik do të ndryshojë dinamikisht kur të shkallëzojmë pod’ët lart-poshtë, që do të jetë veçanërisht e dobishme gjatë Canary Deployment (ne do ta shqyrtojmë këtë skemë shpërndarjeje më pas).
E gjitha sapo ka filluar
Në të vërtetë, sot ne, ashtu siç thuhet, prekem vetëm lehtësisht një minierë informacioni të dobishëm rreth Jaeger, Grafana dhe Prometheus. Në të vërtetë, ky ishte qëllimi ynë – t'ju drejtojmë në drejtimin e duhur dhe të hapim perspektivat për Istio.
Dhe mbani mend, e gjithë kjo është e ndërtuar tashmë brenda Istio. Kur përdoren disa gjuhë programimi (si Java) dhe framework-e (si Spring Boot), të gjitha këto mund të realizohen pa e prekur kodin e aplikacioneve. Po, do t'ju duhet të modifikoni pak kodin nëse përdorni gjuhë të tjera, sidomos Nodejs ose C#. Por, pasi që ndjekshmëria (lexo "gjurmimi") është një nga kushtet e domosdoshme për ndërtimin e sistemeve të besueshme në re, në çdo rast do t'ju duhet të rregulloni kodin, qofshi me Istio apo jo. Pra, pse të mos e shfrytëzoni këtë mundësi në mënyrë më të dobishme?
Të paktën për t'iu përgjigjur gjithmonë pyetjeve "ku?" dhe "sa shpejt?" me 100% siguri.
Inxhinieria e kaosit në Istio: kështu ishte menduar
Aftësia për të thyer gjëra ndihmon që ato të mos thyhen.
Testimi i softuerit është diçka jo vetëm e komplikuar, por edhe e rëndësishme. Në të njëjtën kohë, testimi i saktësisë (për shembull, a kthen funksioni rezultatin e duhur) është një gjë, ndërsa testimi në kushte të një rrjeti të paparashikueshëm është një detyrë krejtësisht e ndryshme (shpesh besohet se rrjeti gjithmonë funksionon pa probleme, dhe kjo është një nga tetë mitet kryesore mbi llogaritë e shpërndara). Një nga vështirësitë në zgjidhjen e kësaj përgjegjësie është se si të imitosh dështimet në sistem ose t'i sjellësh ato qëllimisht, duke kryer atë që quhet "injeksion dështimi". Kjo mund të bëhet duke modifikuar kodin burimor të vetë aplikacionit. Por atëherë do të jeni në testimin e një versioni që simulohet posaçërisht për dështime. Si rezultat, rrezikoni të bini në përqafimet vdekjeprurëse të injeksionit të dështimit dhe të përballeni me "gajzenbagët" – dështime që zhduken gjatë përpjekjes për t'i zbuluar ato.
Tani do të tregojmë se si Istio ndihmon për të përballuar këto vështirësi lehtësisht.
Si duket gjithçka kur gjithçka shkon siç duhet.
Le të shqyrtojmë skenarin e mëposhtëm: ne kemi dy pod-e për mikroserevizin tonë të rekomandimeve, të cilin e morëm nga një manual për Istio. Një pod është etiketuar si v1, ndërsa tjetri si v2. Siç e shohim, deri tani gjithçka funksionon siç duhet:
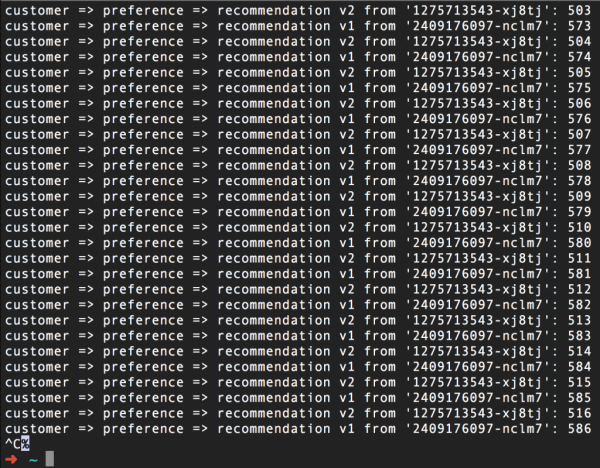
(Nga ana tjetër, numri në të djathtë është thjesht një numërues i thirrjeve për çdo pod)
Por ne na duhet aspak kjo, apo jo? Epo, do të përpiqemi ta dërgojmë në dështim, pa prekur fare kodin burimor.
Po organizojmë ndërprerje në funksionimin e mikroshërbimit
Më poshtë është një skedar yaml për rregullin e routing-ut Istio, i cili në gjysmën e rasteve do të dështojë (gabim) serverë 503):
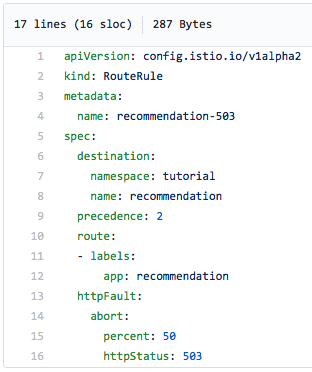
Vini re, ne qartë shkruajmë se në gjysmën e rasteve duhet të kthehet një gabim 503.
Këtu është si do të duket një screenshot i komandës curl të ekzekutuar në cikël pasi ta aktivizojmë këtë rregull për të simuluar dështimet. Siç shohim, gjysma e kërkesave kthejnë gabim 503, pavarësisht nga pod-i – v1 ose v2 – ku ato dërgohen:
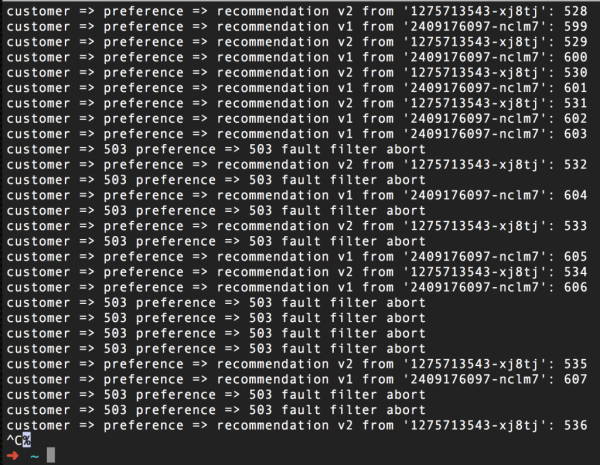
Për të rikthyer funksionimin normal, mjafton të hiqni këtë rregull, në rastin tonë me komandën istioctl delete routerule recommendation-503 -n tutorial. Këtu Tutorial është emri i projektit Red Hat OpenShift, në të cilin po punojmë me udhëzimet tona për Istio.
Shtojmë vonesa artificiale
Gabimet artificiale 503 ndihmojnë për të testuar sistemin për qëndrushmërinë ndaj dështimeve, por aftësia për të parashikuar dhe trajtuar vonesat duhet t'ju impresionojë edhe më shumë. Vonesat në realitet ndodhin më shpesh se dështimet. Një mikroshërbim i ngadalshëm është kancer, nga i cili vuan i gjithë sistemi. Me ndihmën e Istio, mund të testoni kodin që lidhet me trajtimin e vonesave, pa e ndryshuar atë. Fillimisht, ne do të tregojmë se si ta bëjmë këtë në rastin e vonesave artificiale të rrjetit.
Vini re se pas një testimi të tillë, mund t'ju nevojitet (ose do të dëshironit) të përmirësoni kodin tuaj. Lajmi i mirë këtu është se në këtë rast do të veproni proaktivisht dhe jo reaktivisht. Ky është cikli i duhur i zhvillimit: kodim – testim – feedback – kodim – testim…
Këtu është si duket rregulli, i cili... Megjithatë, e dini çfarë? Istio është kaq i thjeshtë, dhe ky skedar yaml është kaq i qartë, sa çdo gjë në këtë shembull flet për vete, thjesht shikoni:
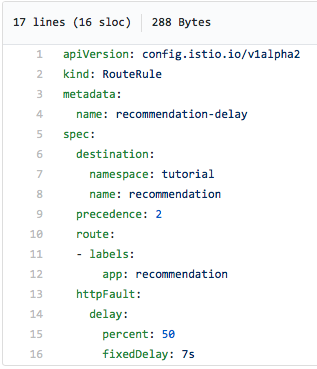
Në gjysmën e rasteve do të kemi një vonesë prej 7 sekondash. Dhe kjo nuk është aspak e njëjtë me sa do të ndodhte nëse do të përdornim një komandë spanjolle në kodin burimor, sepse Istio realisht ndalon kërkesën për 7 sekonda. Duke qenë se Istio mbështet gjurmimin Jaeger, kjo vonesë vërtetë vërehet në UI të Jaeger, siç tregohet në skrinin më poshtë. Vini re kërkesën e gjatë në këndin e sipërm të djathtë të diagramit – koha e saj është 7.02 sekonda:
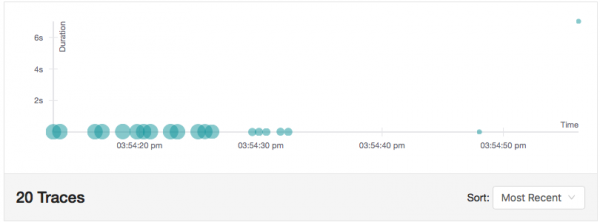
Ky skenar lejon testimin e kodit në kushte vonesash në rrjet. Dhe është e qartë se, duke hequr këtë rregull, ne do të heqim vonesën artificiale. E përsërisim, por ne sërish e bëmë të gjithë këtë pa prekur kodin burimor.
Të mos heqim dorë dhe të mos dorëzohemi
Një funksion tjetër i dobishëm për inxhinierinë e kaosit në Istio është përsëritja e kërkesave ndaj shërbimit një numër të caktuar herësh. Qëllimi këtu është të mos ndalojmë përpjekjet kur kërkesa e parë përfundon me një gabim 503 – dhe atëherë, ndoshta, në herën e N-të do të kemi fat. Mund të jetë që shërbimi thjesht ka qenë në gjumë për një arsye apo një tjetër. Po, arsyeja duhet të zbulohet dhe të eliminohet. Por kjo është për më vonë, ndërsa tani ne do të përpiqemi të bëjmë që sistemi të vazhdojë të punojë.
Pra, ne duam që shërbimi herë pas here të japë një gabim 503, dhe Istio pas kësaj të provojë përsëri të lidhet me të. Dhe këtu na nevojitet një mënyrë për të gjeneruar gabimin 503, pa prekur kodin e vet...
Stop, prit! Ne sapo e bëmë këtë.
Ky skedar do ta bëjë që shërbimi recommendation-v2 në gjysmën e rasteve të japë një gabim 503:
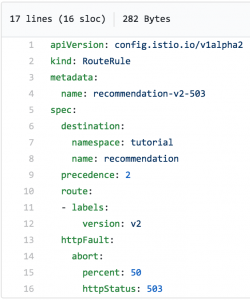
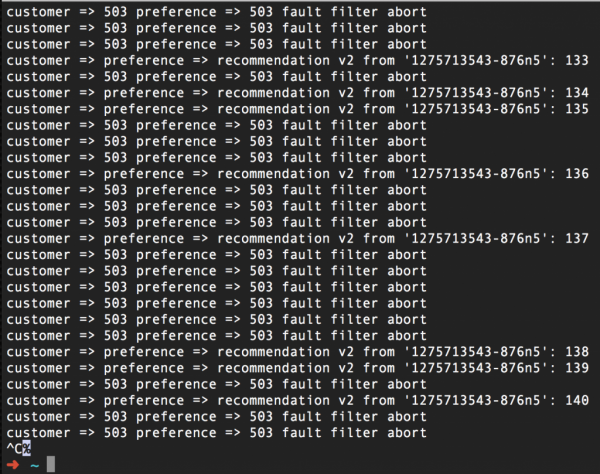
E dukshme është se disa nga kërkesat do të përfundojnë me dështim:
Tani do të aktivizojmë funksionin Retry të Istio:
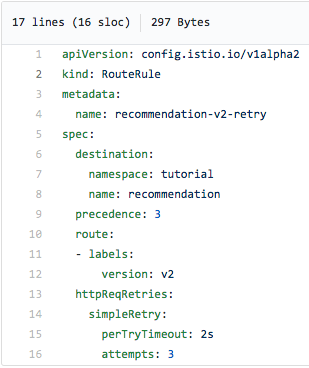
Ky rregull i маршрутизацијата bën tre përsëritje me një interval prej dy sekondash dhe duhet të reduktojë (dhe në ide të heqë përfundimisht nga radarët) gabimet 503:
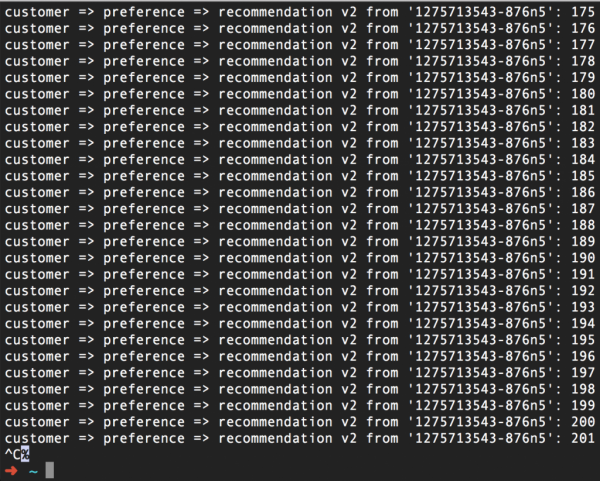
Përmbledhim: ne e bëmë që Istio, së pari, të gjeneronte një gabim 503 për gjysmën e kërkesave. Dhe së dyti, po ai Istio bën tre përpjekje për të lidhur sërish me shërbimin në rastin e një gabimi 503. Si rezultat, gjithçka funksionon thjesht shkëlqyese. Kështu, duke përdorur funksionin Retry, ne përmbushëm premtimin tonë për të mos hequr dorë dhe për të mos u dorëzuar.
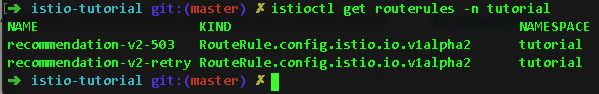
Po, ne e bëmë këtë përsëri, pa prekur fare kodin. E vetmja gjë që na duhej, ishin dy rregulla маршрутизације të Istio:
Si të mos e lëshosh përdoruesin ose shtatë njëri të presë
Tani tani, do ta shohim situatën nga një këndvështrim të ndryshuar dhe do të shqyrtojmë skenarin ku nuk është e nevojshme të tërhiqemi ose dorëzohemi vetëm për një kohë të caktuar. Pas kësaj, duhet thjesht të ndalim përpjekjet për të përpunuar kërkesën, në mënyrë që të mos i bëjmë të gjithë të presin për një shërbim të ngadaltë. Në terma të tjerë, nuk do ta mbrojmë pozitat e humbura, por do të tërhiqemi në një linjë rezervë, që të mos e dështojmë përdoruesin e sitit dhe të mos e lëmë atë në paqartësi.
Në Istio është e mundur të vendoset një kufi për kohën e ekzekutimit të kërkesës. Nëse shërbimi e kalon këtë kufi, kthehet një gabim 504 (Gateway Timeout) – përsëri, të gjitha këto bëhen përmes konfigurimit të Istio. Por ne do të duhet të shtojmë një komandë sleep në kodin burimor të shërbimit (dhe pastaj, sigurisht, të kryejmë rebuild dhe redeploy), për të imituar një punë të ngadaltë të shërbimit. Me keqardhje, ndryshe nuk do t'ia dalim.
Pra, ne kemi inseruar një sleep prej tre sekondash në kodin e shërbimit rekomandimi v2, kemi ndërtuar përsëri imazhin përkatës dhe kemi bërë redeploy të kontejnerit, tani do të shtojmë kufizimin me anë të rregullit të ardhshëm të rrugëzgjidhjes Istio:
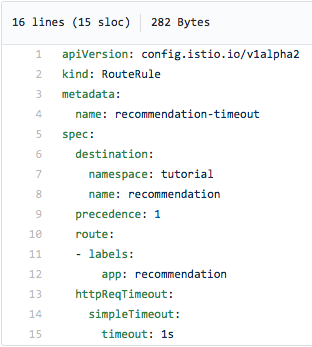
Në imazhin e përmendur më sipër, shihet se ne heqim dorë nga përpjekjet për të kontaktuar shërbimin e rekomandimit, nëse nuk marrim përgjigje brenda një sekonde, domethënë akoma para se të ndodhi gabimi 504. Pas aplikimit të këtij rregulli të rrugëzgjidhjes (dhe shtimit të sleep prej tre sekondash në kodin e shërbimit rekomandimi:v2), ne do të marrim këtë rezultatin e mëposhtëm:
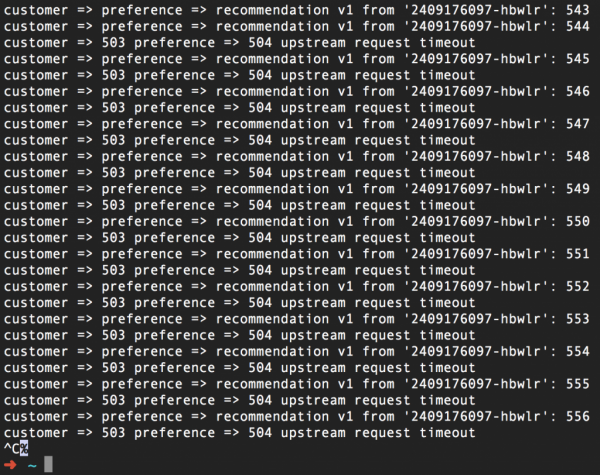
Sërish po e përsërim, por kufiri i kohës mund të vendoset pa prekur kodin burimor. Një bonus shtesë këtu është se tani mund të modifikoni kodin tuaj në mënyrë që ai të reagojë ndaj kufirit të kohës, dhe lehtësisht të testoni këto përmirësime me anë të Istio.
Tani së bashku
Shtimi i pak kaosit me anë të Istio është një mënyrë e shkëlqyer për të testuar kodin tuaj dhe qëndrueshmërinë e sistemit tuaj në përgjithësi. Shabllonet fallback, bulkhead dhe circuit breaker, mekanizmat për krijimin e dështimeve dhe vonesave artificiale, si dhe rikthimet dhe kufijtë e kohës, do të jenë shumë të dobishme për ndërtimin e sistemeve të qëndrueshme në cloud. Në kombinim me Kubernetes dhe Red Hat OpenShift, këto mjete do të ndihmojnë për të përballuar të ardhmen me siguri.
Burimi: habr.com
