

Një fjalë hyrëse e vogël
Mendoj se do të mund të bënim më shumë punë nëse do të na ofroheshin udhëzime hapi pas hapi që do të tregojnë se çfarë dhe si të bëjmë. Edhe unë e kujtoj në jetën time momente kur nuk mund të filloja një përpjekje për shkak se ishte e vështirë të kuptoja nga duhet të filloja. Ndoshta, dikur në të kaluarën, ke parë fjalët "Data Science" në internet dhe ke menduar se ishe shumë larg kësaj, ndërsa njerëzit që merreshin me këtë ishin diku tjetër, në një botë tjetër. Por jo, ata janë pikërisht këtu. Dhe, ndoshta, falë njerëzve nga ky sektor, një artikull të tillë e gjete në rrjedhën tënde. Ekzistojnë shumë kurse që do të të ndihmojnë të zotërosh këtë zanat, ndërsa unë do të ndihmoj të bësh hapin e parë.
Mirë, je i gatshëm? Të them menjëherë se duhet të dish Python 3, sepse atë do ta përdorim këtu. Gjithashtu, të rekomandoj të instalosh përpara Jupyter Notebook ose të shikosh se si të përdorësh google colab.
Hapi i parë
Kaggle është ndihmës i rëndësishëm në këtë çështje. Në thelb, mund të rimarrësh, por për këtë do të flas në një artikull tjetër. Kjo është një platformë ku organizohen gara në Data Science. Në çdo garë të tillë, në fazat e para do të marrësh një sasi të paimagjinueshme përvoje për zgjidhjen e problemeve të ndryshme, për zhvillimin e projekteve dhe për punën në ekip, që është e rëndësishme në kohët tona.
Ne do ta marrim detyrën tonë nga aty. Quhet "Titanic". Kushti është: të parashikohet nëse çdo person i veçantë mbijeton. Në përgjithësi, detyra e atij që merret me DS është mbledhja e të dhënave, përpunimi i tyre, trajnimi i modelit, parashikimi etj. Në Kaggle na lejojnë të anashkalojmë fazën e mbledhjes së të dhënave - ato janë të disponueshme në platformë. Na nevojitet t'i ngarkojmë dhe mund të fillojmë punën!
Këtë mund ta bëjmë në këtë mënyrë:
në seksionin Data gjenden skedarët që përmbajnë të dhënat


Ngarkuam të dhënat, përgatitëm shënimet tona Jupyter dhe...
Hapi i dytë
Si më tani të ngarkojmë këto të dhëna?
Së pari, importojmë bibliotekat e nevojshme:
import pandas as pd
import numpy as np
Pandas do të na lejojë të ngarkojmë skedarët .csv për përpunimin e mëtejshëm.
Numpy është i nevojshëm për të përfaqësuar tabelën tonë të të dhënave në formën e një matrice me numra.
Të vazhdojmë. Të marrim skedarin train.csv dhe ta ngarkojmë atë:
dataset = pd.read_csv('train.csv')
Ne do të referohemi në koleksionin tonë të të dhënave train.csv përmes përcaktimit dataset. Le të shohim se çfarë ka aty:
dataset.head()
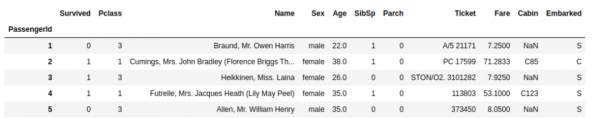
Funksioni head() na lejon të shohim rreshtat e parë të DataFrame-it.
Kolona Survived janë, pikërisht, rezultatet tona, të cilat në këtë DataFrame janë të njohura. Duke u bazuar në detyrë, na nevojitet të parashikojmë kolonën Survived për të dhënat test.csv. Në këto të dhëna janë informacionet për pasagjerët e tjerë të Titanikut, për të cilët ne, që po zgjidhim problemin, nuk e dimë rezultatin.
Kështu, do ta ndajmë tabelën tonë në të dhëna të varura dhe të pavarura. Këtu është e thjeshtë. Të dhënat e varura janë ato të dhëna që varen nga ato të pavarura, që gjenden te rezultatet. Të dhënat e pavarura janë ato të dhëna që ndikojnë në rezultat.
Për shembull, kemi një set të dhënash:
«Vova ka mësuar informatika — jo.
Vova ka marrë 2 në informatika.»
Nota në informatika varet nga përgjigja e pyetjes: a ka mësuar Vova informatika? E kuptove? Le të vazhdojmë, po afrohemi te qëllimi!
Variabla tradicionale për të dhënat e pavarura është X. Për të dhënat e varura — y.
Po kryejmë si vijon:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Çfarë është kjo? Me funksionin iloc[:, 2: ] i tregojmë Python-it: dua të shoh të dhënat që fillojnë nga kolona e dytë (duke përfshirë dhe duke pasur parasysh që numërimi fillon nga zero). Në rreshtin e dytë po themi se duam të shohim në y të dhënat nga kolona e parë.
[ a:b, c:d ] — është struktura që përdorim në kllapat. Nëse nuk përcaktojmë ndonjë variabël, ato do të ruhen si të parazgjedhura. Pra, mund të përcaktojmë [:,: d] dhe atëherë do të marrim në DataFrame të gjitha kolonat, përveç atyre që fillojnë nga numri d e më tej. Variablat a dhe b përcaktojnë rreshtat, por na duhen gjithsej, kështu që e lëmë këtë si të parazgjedhur.
Le të shohim se çfarë kemi arritur:
X.head() 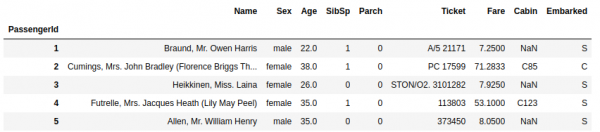
y.head() 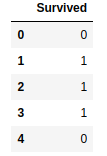
Për ta thjeshtuar këtë mësim të vogël, do të heqim kolonat që kërkojnë një "kujdes të veçantë", ose që nuk ndikojnë në mbijetesë. Ato përmbajnë të dhëna të tipit str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Super! Të kalojmë në hapin e ardhshëm.
Hapi i tretë
Këtu ne do të kërkojmë të kodojmë të dhënat tona, që makina të kuptojë më mirë se si këto të dhëna ndikojnë në rezultat. Por do të kodojmë vetëm të dhënat e tipit str që kemi lënë. Kolona "Sex". Si dëshirojmë ta kodojmë? Le të imagjinojmë të dhënat për gjininë e njeriut si një vektor: 10 — mashkull, 01 — femër.
Së pari, le t'i kthejmë tabelat tona në një matricë NumPy:
X = np.array(X)
y = np.array(y)
Tani le të shikojmë:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
Biblioteka sklearn është një bibliotekë shumë e fuqishme që na lejon të kryejmë punën e plotë në Data Science. Ajo përmban një numër të madh modelesh interesante të mësimit makinerik dhe gjithashtu na lejon të merremi me përgatitjen e të dhënave.
OneHotEncoder do na lejojë të kodojmë gjininë e njeriut në atë përfaqësim që e përshkruam. Do të krijohen 2 klasa: mashkullore dhe femërore. Nëse personi është mashkull, në kolonën "mashkull" do të shkruhet 1, ndërsa në "femër", përkatësisht, 0.
Pas OneHotEncoder() vjen [1] — kjo do të thotë që duam të kodojmë kolonën numër 1 (numërimi fillon nga zero).
Super. Po ecim më tej!
Më shpesh ndodh që disa të dhëna mbesin pa plotësuar (domethënë NaN — not a number). Për shembull, ka informacion për një person: emri i tij, gjinia. Por nuk ka të dhëna për moshën e tij. Në këtë rast do të aplikojmë një metodë të tillë: do të gjejmë mesataren aritmetike për të gjitha kolonat dhe, nëse ndonjë të dhënë është e humbur në një kolondë, do të plotësojmë boshllëkun me mesataren aritmetike.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Tani le të merremi me rastet kur të dhënat janë shumë të shpërndara. Disa të dhëna ndodhen në intervalin [0:1], ndërsa disa mund të kalojnë qindrat dhe mijërat. Për të përjashtuar një shpërndarje të tillë dhe që kompjuteri të jetë më i saktë në llogaritje, ne do t'i kalojmë të dhënat në një shkallë më të vogël. Le të bëjmë që të gjitha numrat të mos kalojnë tre. Për këtë do të përdorim funksionin StandartScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Tani të dhënat tona duken kështu:

Klasa. Ne jemi afër qëllimit tonë!
Hapi i katërt
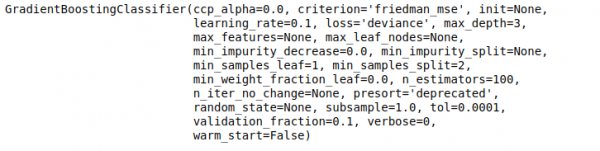
Do t'i mësojmë modelin tonë të parë! Nga biblioteka sklearn mund të gjejmë një sasi të madhe gjërash interesante. Kam aplikuar modelin Gradient Boosting Classifier për këtë detyrë. Përdorim një klasifikues, pasi objekti ynë është një detyrë klasifikimi. Duhet të parashikojmë nëse përkufizimi është 1 (ka mbijetuar) ose 0 (nuk ka mbijetuar).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
Funksioni fit i thotë Python-it: Le të kërkojë modeli lidhjet mes X dhe y.
Më pak se një sekondë dhe modeli është gati.
Si ta aplikojmë atë? Tani do ta shohim!
Hapi i pestë. Përfundimi
Tani duhet të ngarkojmë tabelën me të dhënat tona testuese, për të cilat duhet të bëjmë parashikimin. Me këtë tabelë do të realizojmë të njëjtat veprime që bëmë me X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Të aplikojmë tani modelin tonë!
gbc_predict = gbc.predict(X_test)
Gati. Ne kemi bërë parashikimin. Tani duhet ta regjistrojmë në csv dhe ta dërgojmë në sajt.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Gati. Kemi marrë një skedar që përmban parashikimet për çdo pasagjer. Njësoj duhet ta ngarkojmë këtë zgjidhje në sajt dhe të marrim vlerësimin e parashikimit. Ky zgjidhje primare ofron jo vetëm 74% përgjigje të sakta në publik, por gjithashtu dhe një ndihmë në Data Science. Të gjithë të kuriozët mund të më shkruajnë në mesazhe private dhe të bëjnë pyetje. Faleminderit të gjithëve!
Burimi: habr.com
