

Përshëndetje, Habr!
Në dritën e ngjarjeve aktuale për shkak të koronavirusit, disa shërbime në internet kanë filluar të përballen me ngarkesa të shtuar. Për shembull, , sepse nuk kishte mjaft kapacitete. Dhe jo gjithmonë është e mundur të shpejtohet serveri thjesht duke shtuar pajisje më të fuqishme, megjithatë kërkesat e klientëve duhet të përpunohen (ose ata do të ikin tek konkurrencat).
Në këtë artikull do t'ju tregoj shkurtimisht për praktikat e njohura që do të lejojnë krijimin e një shërbimi të shpejtë dhe të qëndrueshëm. Megjithatë, nga format e mundshme të zhvillimit kam përzgjedhur vetëm ato me të cilat është lehtë të përdoren. Për çdo pikë, ju tashmë keni biblioteka të gatshme ose keni mundësinë të zgjidhni problemin përmes një platforme në re.
Shkallëzim horizontal
Një nga pikat më të thjeshta dhe të njohura. Në mënyrë kategorizuese, zakonisht ndodhin dy skema të shpërndarjes së ngarkesës—shkallëzimi horizontal dhe vertikal. ju lejoni shërbimet të punojnë paralelisht, duke shpërndarë kështu ngarkesën midis tyre. ju porositni servera më të fuqishëm ose optimizoni kodin.
Për shembull, do të marr një ruajtje të tillë abstrakte të skedarëve në re, pra një analog të OwnCloud, OneDrive dhe kështu me radhë.
Imazhi standard i një skeme të tillë është më poshtë, megjithatë ajo tregon vetëm kompleksitetin e sistemit. Sepse duhet të sinkronizojmë ndonjëherë shërbimet. Çfarë do të ndodhë nëse një përdorues ruan një skedar nga tableti dhe më pas dëshiron ta shikojë atë nga telefoni?
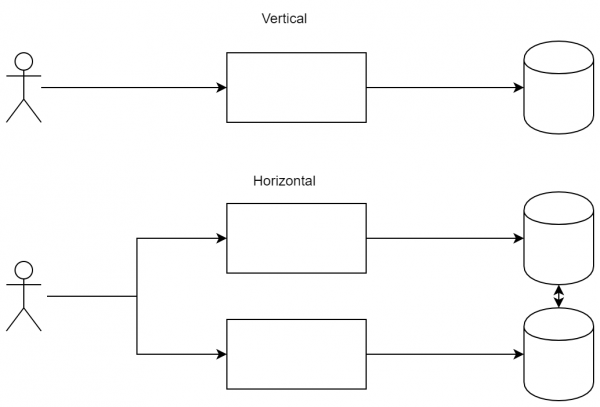
Dallimi midis qasjeve: në shkallëzimin vertikal ne jemi të gatshëm të rrisim fuqinë e nyjeve, ndërsa në atë horizontal—të shtojmë nyje të reja për të shpërndarë ngarkesën.
CQRS
është një model mjaft i rëndësishëm, pasi ndihmon klientët e ndryshëm të lidhen me shërbime të ndryshme dhe gjithashtu të marrin të njëjtat rrjedha ngjarjesh. Avantazhet e tij nuk janë aq të dukshme për një aplikacion të thjeshtë, megjithatë ai është jashtëzakonisht i rëndësishëm (dhe i thjeshtë) për një shërbim të ngarkuar. Pika e tij thelbësore: rrjedhat hyrëse dhe dalëse të të dhënave nuk duhet të ndërthuren. Kështu që nuk mund të dërgoni një kërkesë dhe të prisni një përgjigje, përkundrazi, ju dërgoni një kërkesë në shërbimin A, por merrni përgjigjen në shërbimin B.
Bonusi i parë i këtij qasje është mundësia e ndërprerjes së lidhjes (në kuptimin e gjerë të kësaj fjale) gjatë realizimit të një kërkese të gjatë. Si një shembull, le të marrim një sekuencë më shumë-më pak standarde:
- Klienti dërgoi një kërkesë në server.
- Serveri filloi përpunimin e gjatë.
- Serveri iu përgjigj klientit me rezultatin.
Imagjinoni se në pikën 2 ndodhi një ndërprerje e lidhjes (ose rrjeti u rivendos, ose përdoruesi kaloi në një faqe tjetër, duke ndërprerë lidhjen). Në këtë rast, serverit do t’i jetë e vështirë të dërgojë një përgjigje përdoruesit me informacionin se çfarë u procesua. Duke aplikuar CQRS, sekuenca do të jetë pak më ndryshe:
- Klienti u regjistrua për përditësime.
- Klienti dërgoi një kërkesë në server.
- Serveri iu përgjigj: "kërkesa u pranua".
- Serveri iu përgjigj me rezultatin nëpërmjet kanalit të pikës "1".
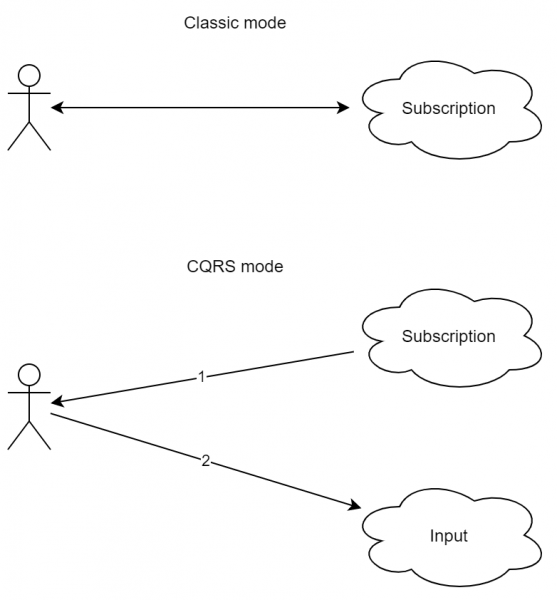
Siç shihet, skema është pak më e komplikuar. Më shumë se kaq, qasja intuitive kërkesë-përgjigje këtu mungon. Megjithatë, siç shihet, ndërprerja e lidhjes gjatë përpunimit të kërkesës nuk do të shkaktojë një gabim. Për më tepër, nëse përdoruesi është në të vërtetë i lidhur me shërbimin nga disa pajisje (për shembull, nga telefoni celular dhe nga tableta), është e mundur të bëhet që përgjigja të vijë në të dy pajisjet.
E veçanta është se kodi për përpunimin e mesazheve të ardhshme bëhet i njëjtë (jo 100%) si për ngjarjet që ndikon vetë klienti, ashtu edhe për ngjarjet e tjera, duke përfshirë ato nga klientë të tjerë.
Megjithatë, në realitet, ne marrim bonuset e tjera që lidhen me faktin se rrjedha njëkahëshe mund të përpunohet në stilin funksional (duke përdorur RX dhe analoge). Dhe kjo është një përfitim serioz, sepse në thelb aplikacioni mund të bëhet plotësisht reaktiv, madje duke përdorur qasjen funksionale. Për programet e mëdha, kjo mund të kursejë ndjeshëm burimet për zhvillim dhe mbështetje.
Nëse e bashkojmë këtë qasje me shkallëzimin horizontal, atëherë kemi mundësinë për të dërguar kërkesa në një server, ndërsa të marrim përgjigje nga një tjetër. Kështu, klienti mund të zgjedhë shërbimin që i përshtatet më mirë, ndërsa sistemi brenda do të jetë ende në gjendje të procesojë ngjarjet në mënyrë korrekte.
Event Sourcing
Si keni, një nga karakteristikat kryesore të një sistemi të shpërndarë është mungesa e një kohe të përbashkët, një seksioni kritik të përbashkët. Për një proces, mund të bëni sinkronizimin (në të njëjtat mutex), brenda të cilit jeni të sigurt se askush tjetër nuk po ekzekuton këtë kod. Megjithatë, për një sistem të shpërndarë, diçka e tillë është e rrezikshme, pasi do të kërkohen kostot shtesë, dhe gjithashtu do të dëmtohet e gjithë bukuria e shkallëzimit - gjithsesi të gjithë komponentët do të pretendojnë një gjë.
Nga këtu marrim një fakt të rëndësishëm - një sistem të shpërndarë të shpejtë nuk mund të sinkronizohet, sepse ndryshe do të zvogëlojmë performancën. Nga ana tjetër, shpesh na nevojitet një konsistencë e caktuar e komponentëve. Dhe për këtë mund të përdorim qasjen me , ku garanton se në mungesë të ndryshimeve të të dhënave përmes një periudhe të caktuar kohe pas përditësimit të fundit (“në fund të fundit”) të gjithë kërkesat do të kthejnë vlerën e fundit të përditësuar.
Është e rëndësishme të kuptohet se për bazat e të dhënave klasike aplikohet mjaft shpesh , ku çdo nyje zotëron të njëjtat informacione (kjo shpesh arrihet kur një transaksion konsiderohet i vendosur vetëm pas përgjigjes nga serveri i dytë). Këtu ka disa lehtësira për shkak të niveleve të izolimit, megjithatë thelbi i përgjithshëm mbetet i njëjtë - mund të jetoni në një botë plotësisht të konsoliduar.
Megjithatë, le të kthehemi në detyrën fillestare. Nëse një pjesë e sistemit mund të ndërtohet me , atëherë mund të ndërtojmë skemën e mëposhtme.
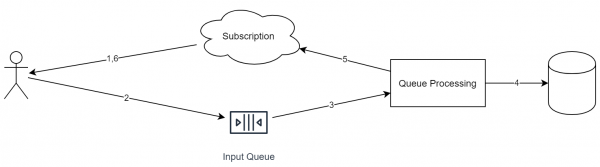
Karakteristikat e rëndësishme të këtij Qasjeje:
- Çdo kërkesë hyrëse vendoset në një radhë.
- Në procesin e përpunimit të kërkesës, shërbimi gjithashtu mund të vendosë detyra në radhë të tjera.
- Çdo ngjarje hyrëse ka një identifikues (i cili është i nevojshëm për deduplication).
- Radhë funksionon ideologjikisht sipas skemës "shto vetëm". Nga ajo nuk mund të hiqen elementë ose të rregullohen ato.
- Radhë punon sipas skemës FIFO (ndjesë për tautologjinë). Nëse është e nevojshme të bëhet ekzekutim paralel, atëherë në një nga fazat duhen transferuar objektet në radhë të ndryshme.
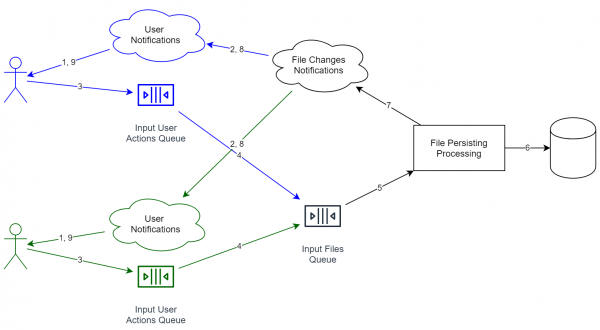
Të kujtoj se po shqyrtojmë rastin e një ruajtjeje online të skedarëve. Në këtë rast, sistemi do të duket, përafërsisht, kështu:
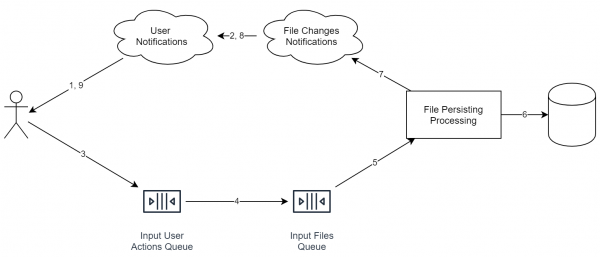
Është e rëndësishme që shërbimet në Diagram janë të domosdoshme për t'u kuptuar si serverë të ndarë. Edhe procesi mund të jetë i njëjtë. E rëndësishme është që ideologjikisht këto gjëra janë ndarë në këtë mënyrë, që të mund të aplikohet lehtë shkallëzimi horizontal.
Dhe për dy përdorues, skema do të duket kështu (shërbimet që janë për përdorues të ndryshëm janë treguar me ngjyra të ndryshme):
Bonusët nga një kombinim të tillë:
- Shërbimet e përpunimit të informacionit janë të ndara. Radhët gjithashtu janë të ndara. Nëse na nevojitet të rrisim kapacitetin e sistemit, atëherë mjafton të nisni më shumë shërbime në numër më të madh serverësh.
- Kur marrim informacion nga përdoruesi, nuk është e domosdoshme që të presim ruajtjen e plotë të të dhënave. Përkundrazi, na mjafton të përgjigjemi me 'ok', dhe pastaj fillojmë gradualisht punën. Po ashtu, radha zbut kulmin, pasi shtimi i një objekti të ri ndodh shpejt, dhe përdoruesi nuk duhet të presë një kalim të plotë përmes gjithë ciklit.
- Si një shembull, kam shtuar shërbimin e deduplikimit, i cili përpiqet të bashkojë skedarët e njëjtë. Nëse ai punon për një kohë të gjatë në 1% të rasteve, klienti s'ka për ta vënë re atë (shih më sipër), që është një avantazh i madh, pasi nuk kërkohet nga ne një shpejtësi dhe qëndrushmëri njëqind përqind.
Megjithatë, menjëherë duken edhe disavantazhet:
- Sistemi ynë ka humbur marrëveshjen e estrikтівë. Kjo do të thotë, për shembull, se nëse regjistrohemi në shërbime të ndryshme, teorikisht mund të marrim një gjendje të ndryshme (pasi një nga shërbimet mund të mos arrijë t'i pranojë njoftimin nga radha e brendshme). Si një pasojë tjetër, sistemi tani nuk ka një kohë të përgjithshme. Do të thotë se nuk është e mundur, për shembull, të renditni të gjitha ngjarjet vetëm sipas kohës së mbërritjes, pasi orët midis serverëve mund të mos jenë sinkronike (më shumë, një kohë e njëjtë në dy servera është një utopi).
- Asnjë ngjarje nuk mund të rikthehet thjesht tani (siç do të mund të bëhej me një bazë të dhënash). Në vend të kësaj, është e nevojshme ta shtoni një ngjarje të re — , e cila do ta ndryshojë gjendjen e fundit në atë që nevojitet. Si një shembull nga një fushë e ngjashme: pa ripërsëritjen e historisë (çfarë është e këqij në disa raste) në git, nuk mund të rikthehet një commit, megjithatë mund të bëhet një , i cili në thelb do ta rikthejë gjendjen e vjetër. Megjithatë, historia do të ruajë si komitin e gabuar ashtu edhe rollback-un.
- Schemat e të dhënave mund të ndryshojnë nga një publikim në tjetrin, megjithatë ngjarjet e vjetra tani nuk mund të përditësohen në standardin e ri (sepse ngjarjet në parim nuk mund të ndryshohen).
Siç duket, Event Sourcing përputhet plotësisht me CQRS. Për më tepër, implementimi i një sistemi me radhë efektive dhe të rehatshme, por pa ndarjen e rrjedhave të të dhënave, është vetë një sfidë, pasi do të ketë nevojë për shtimin e pikave të sinkronizimit, të cilat do të neutralizojnë të gjithë efektin pozitiv të radhëve. Duke aplikuar të dy qasjet njëkohësisht, është e nevojshme të bëhen disa rregullime të vogla në kodin e programit. Në rastin tonë, kur dërgohet një skedar në server, përgjigja është vetëm "ok", që do të thotë se "operacioni i shtimit të skedarit është ruajtur". Formalisht, kjo nuk do të thotë se të dhënat janë tashmë të aksesueshme në pajisje të tjera (për shembull, shërbimi i deduplikimit mund të rindërtojë indeksin). Megjithatë, pas një kohe, klientit do t'i vijë një njoftim në stilin "skedari X është ruajtur."
Si rezultat:
- Numri i statusëve të dërgesës së skedarëve rritet: përveç "skedari është dërguar" klasik, tani marrim dy: "skedari është shtuar në radhë në server" dhe "skedari është ruajtur në ruajtje". E fundit do të thotë se pajisje të tjera mund të fillojnë të marrin skedarin (me përjashtim të faktit që radhët punojnë me shpejtësi të ndryshme).
- Për shkak se informacioni rreth dërgesës tani vjen përmes kanaleve të ndryshme, na nevojitet të gjejmë zgjidhje për të marrë statusin e përpunimit të skedarit. Si rezultat i kësaj: ndryshe nga request-response klasik, klienti mund të riaktivizohet gjatë përpunimit të skedarit, megjithatë statusi i përpunimit do të jetë i saktë. Dhe ky pikë funksionon, në thelb, nga fabrika. Si pasojë: tani jemi më tolerant ndaj dështimeve.
Sharding
Siç u përmend më sipër, në sistemet me event sourcing mungon konsistenca e rreptë. Kështu, mund të përdorim disa depo pa ndonjë sinkronizim midis tyre. Duke u afruar me detyrën tonë, ne mund:
- Të ndajmë skedarët sipas tipave. Për shembull, imazhet/video mund të dekodohen dhe të zgjidhet një format më efikas.
- Të ndara llogaritë sipas vendeve. Për shkak të shumë ligjeve, kjo mund të jetë e nevojshme, megjithatë, kjo strukturë arkitekturore jep mundësinë për ta bërë automatikisht.
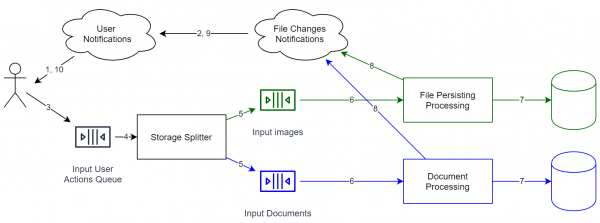
Nëse dëshironi të transferoni të dhënat nga një depo në një tjetër, atëherë këtu standardet nuk mjaftojnë. Fatkeqësisht, në këtë rast është e nevojshme të ndaloni radhën, të bëni migrimin, dhe pastaj ta nisni përsëri. Në përgjithësi, të dhënat nuk mund të transferohen "në flakë", megjithatë, nëse radhët e ngjarjeve ruhen plotësisht dhe ju keni kopje të gjendjeve të mëparshme të depozitave, atëherë ne mund të ripërjetojmë ngjarjet si më poshtë:
- Në Event Source çdo ngjarje ka identifikuesin e saj (idealisht – që nuk zvogëlohet). Pra, në depozitë ne mund të shtojmë një fushë – id e elementit të fundit të përpunuar.
- Dubloni radhën, në mënyrë që të gjitha ngjarjet të mund të përpunohen për disa depo të pavarura (e para është ajo, në të cilën tashmë ruhen të dhënat, dhe e dyta është e re, megjithatë për momentin e zbrazët). Radhë e dytë, natyrisht, për kohën e tanishme nuk përpunoset.
- Nisim radhën e dytë (domethënë fillojmë ripërjetimin e ngjarjeve).
- Kur radhë e re të jetë relativisht e zbrazët (dmth. diferenca mes mesatare kohore midis shtimit të një elementi dhe nxjerrjes së tij do të jetë e pranueshme), mund të fillojmë të kalojmë lexuesit në depozita të re.
Siç shihet, sistemi ynë si nuk kishte as nuk ka një konsistencë të rreptë. Ka vetëm eventual constistency, domethënë garancia që ngjarjet përpunohen në të njëjtin rend (megjithatë, ndoshta, me vonesa të ndryshme). Dhe, duke e përdorur këtë, ne mund ta transferojmë relativisht lehtësisht të dhënat pa ndaluar sistemin në anën tjetër të globit.
Kështu, duke vazhduar shembullin tonë për depozitimin online të skedarëve, një arkitekturë e tillë tashmë na jep disa përfitime:
- Ne mund të lëvizim objektet më afër përdoruesve, duke e bërë këtë në mënyrë dinamike. Kështu, mund të përmirësojmë cilësinë e shërbimit.
- Ne mund të ruajmë pjesën e të dhënave brenda kompanive. Për shembull, përdoruesit Enterprise shpesh kërkojnë që të dhënat e tyre të ruhen në qendrat e të dhënave të kontrolluara (për të shmangur rrjedhjen e të dhënave). Falë sharding, ne mund ta mbështesim lehtësisht këtë. Dhe detyra bëhet edhe më e thjeshtë nëse klienti ka një cloud të përputhshëm (për shembull, ).
- Dhe gjëja më e rëndësishme është se ne nuk e kemi obligimin të bëjmë këtë. Në fillim, një depo do të ishte e mjaftueshme për të gjitha llogaritë (që të fillojmë të punojmë më shpejt). Dhe veçoria kyçe e këtij sistemi — ndonëse është e zgjerueshme, në fillim është mjaft e thjeshtë. Thjesht nuk duhet të shkruajmë menjëherë kodin që punon me një milion radhë të pavarura, etj. Nëse është e nevojshme, mund ta bëjmë këtë në të ardhmen.
Hostimi i Përmbajtjes Statike
Ky punkt mund të duket krejtësisht i qartë, por prapë është e nevojshme për një aplikacion të ngarkuar më shumë-më pak standard. Thelbi i tij është i thjeshtë: i gjithë përmbajtja statike shpërndahet jo nga atë server që ndodhet aplikacioni, por nga serverë të veçuar vetëm për këtë qëllim. Si pasojë, këto operacione kryhen më shpejt (një nginx i zakonshëm dorëzon skedarët më shpejt dhe më me pak kosto se një server Java). Plus, arkitektura CDN () na lejon të vendosim skedarët tanë më afër përdoruesve përfundimtarë, gjë që ndihmon në përmirësimin e komfortit të punës me shërbimin.
Shembulli më i thjeshtë dhe standard i përmbajtjes statike është një grup skenesh dhe imazhesh për një faqe. Me to gjithçka është e thjeshtë — ato janë të njohura më parë, pastaj arkivi ngarkohet në serverët CDN, nga ku shpërndahen për përdoruesit përfundimtarë.
Megjithatë, në praktikë, për përmbajtjen statike mund të aplikojmë një qasje që është diçka e ngjashme me arkitekturën lambda. Le të kthehemi në detyrën tonë (depo online e skedarëve), në të cilën na nevojitet të shpërndajmë skedarët për përdoruesit. Zgjidhja më e thjeshtë është të krijojmë një shërbim, i cili për çdo kërkesë të përdoruesit bën të gjitha kontrollimet e nevojshme (autorizimi, etj.), dhe më pas shkarkon skedarin drejtpërdrejt nga depoja jonë. Disavantazhi kryesor i kësaj qasje është se përmbajtja statike (dhe skedari me një version të caktuar, në thelb, është përmbajtje statike) shpërndahet nga të njëjtin server që përmban logjikën biznesore. Në vend të kësaj, mund të krijohet skema e mëposhtme:
- Serveri lëshon një URL për shkarkim. Ajo mund të jetë forma file_id + key, ku key është një nënshkrim i vogël numerik, që i jep të drejtën për akses në burimin për 24 orët e ardhshme.
- Shpërndarja e skedarit merret nga një nginx i thjeshtë me opsionet e mëposhtme:
- Caching of content. Since this service may be located on a separate server, we have left ourselves a buffer for the future with the possibility of storing all the recently downloaded files on the disk.
- Key verification at the moment of establishing a connection
- Optional: streaming content processing. For example, if we compress all files in the service, we can perform unarchiving directly in this module. As a result: IO operations are done where they belong. A Java archiver can easily consume a lot of excess memory, but rewriting the service with business logic in conditional Rust/C++ may also prove ineffective. In our case, different processes (or even services) are used, so we can quite effectively separate business logic from IO operations.
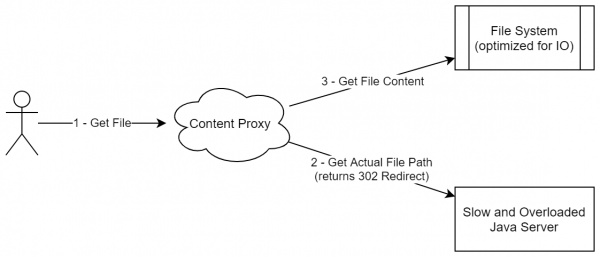
Such a scheme does not resemble static content delivery very closely (as we do not unload the entire static package somewhere), however, in reality, this approach does indeed deal with the distribution of immutable data. Moreover, this scheme can be generalized to other cases where content is not just static but may be represented as a set of immutable and non-deletable blocks (although they can be added).
As another example (for reinforcement): if you have worked with Jenkins/TeamCity, you know that both solutions are written in Java. They both represent a Java process that handles both build orchestration and content management. In particular, they both have tasks such as "transferring a file/folder from the server". For example: issuing artifacts, transferring source code (when the agent does not directly download the code from the repository but the server does it on its behalf), accessing logs. All these tasks differ in their IO load. Thus, it turns out that the server responsible for complex business logic must also efficiently push large streams of data through itself. Interestingly, such an operation can be delegated to nginx using exactly the same scheme (except that a data key should be added to the request).
However, if we return to our system, the scheme looks like this:
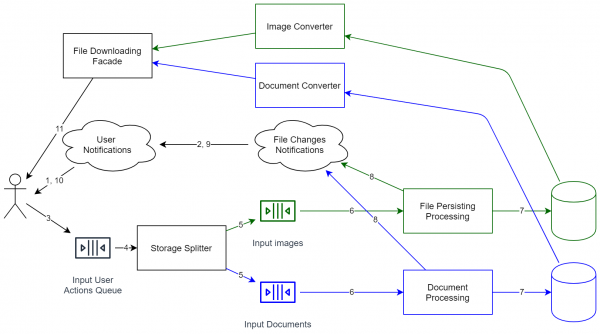
Siç duket, sistemi është komplikuar radikalisht. Tani nuk është thjesht një mini-proces që ruan skedarët lokalish. Tani kërkohet mbështetje e dëshmuar, kontrolle për versionet e API etj. Prandaj, pasi të gjitha diagramet janë bërë, më mirë është të vlerësohet me kujdes nëse përballueshmëria e këtyre kostove është e arsyeshme. Megjithatë, nëse dëshironi të keni mundësinë për të zgjeruar sistemin (përfshirë për të punuar me një numër edhe më të madh përdoruesish), do t'ju duhet të pranoni zgjidhje të tilla. Si rezultat, sistemi arkitektonik është i gatshëm për rritjen e ngarkesës (praktikisht çdo komponent mund të klonohet për shkallëzim horizontal). Sistemi mund të përditësohet pa u ndaluar (thjesht, disa operacione do të ngadalësohen paksa).
Siç kam thënë në fillim, një numër shërbimesh në internet tani kanë filluar të përballen me një ngarkesë të rritur. Disa prej tyre thjesht kanë filluar të ndihen të paefektshëm. Në thelb, sistemet kanë dështuar saktësisht në atë moment kur biznesi do të duhej të bënte para. Pra, në vend që të ofronin një shpërndarje të vonuar, në vend që të ofronin klientëve 'planifikoni shpërndarjen për muajt e afërt', sistemi thjesht tha 'shkoni te konkurentët'. Kjo është çmimi i performancës së ulët: humbjet do të ndodhin saktësisht kur fitimi do të ishte më i lartë.
Përfundim
Të gjitha këto qasje ishin të njohura edhe më parë. Edhe VK përdor prej kohësh idenë e Static Content Hosting për shpërndarjen e imazheve. Një mori lojërash online përdorin skemën e Sharding për të ndarë lojtarët sipas rajoneve ose për të ndarë lokacionet e lojërave (nëse bota është e vetme). Qasja Event Sourcing përdoret në mënyrë aktive në email. Shumica e aplikacioneve për tregtarët, ku të dhënat vijnë vazhdimisht, në të vërtetë janë ndërtuar mbi qasjen CQRS, për të pasur mundësinë të filtrojnë të dhënat që mbërrijnë. Po ashtu, shkallëzimi horizontal përdoret prej një kohe të gjatë në shumë shërbime.
Megjithatë, ajo që është më e rëndësishmja, të gjithë këta modele tani janë shumë të lehtë për t'u zbatuar në aplikacionet moderne (nëse ato janë të përshtatshme, sigurisht). Rezerbat ofrojnë Sharding dhe horizontale të shkallëzueshmërisë menjëherë, që është shumë më e lehtë se sa të porositesh serverë të ndryshëm të dedikuar në qendrat e të dhënave të ndryshme vetë. CQRS është bërë shumë më e lehtë, ndoshta për shkak të zhvillimit të bibliotekave, si RX. Disa vite më parë, një website i rrallë do të ishte në gjendje të përkrahë diçka të tillë. Event Sourcing konfigurimi gjithashtu është jashtzakonisht i lehtë falë kontenierëve të gatshëm me Apache Kafka. Disa vite më parë kjo do të ishte një inovacion, tani është një praktikë e zakonshme. Po ashtu ndodh me Static Content Hosting: për shkak të teknologjive më të përshtatshme (përfshirë faktin se ka dokumentacion të detajuar dhe një bazë të madhe përgjigjesh), një qasje e tillë është bërë edhe më e thjeshtë.
Si përfundim, implementimi i një sërë modeli arkitektonikësh mjaft të ndërlikuar tani ka bërë shumë më të lehtë, dhe kështu është më mirë të shikohet nga afër. Nëse në një aplikacion të dhjetëvjeçar, është hequr një nga zgjidhjet e mësipërme për shkak të kostos së lartë të implementimit dhe mbajtjes, tani, në një aplikacion të ri, ose pas refaktorizimit, mund të krijohet një shërbim që do të jetë arkitektonikisht i shkallëzueshëm (nga pikëpamja e performancës), si dhe i gatshëm për kërkesa të reja nga klientët (për shembull, për lokalizimin e të dhënave personale).
Dhe ajo që është më e rëndësishme: ju lutemi, mos i përdorni këto qasje nëse keni një aplikacion të thjeshtë. Po, ato janë të bukura dhe interesante, megjithatë për një faqe interneti me një vizitë maksimale prej 100 personash shpesh është e mjaftueshme të përdoret një monolit klasik (të paktën nga jashtë, brenda gjithçka mund të ndahet në module e kështu me radhë).
Burimi: habr.com
