

Në këtë artikull, do t'ju tregoj se si të konfiguroni një mjedis për mësimin e makinave për 30 minuta, të krijoni një rrjet nervor për njohjen e imazheve dhe pastaj ta ekzekutoni të njëjtin rrjet në një procesor grafik (GPU).
Së pari, le të përcaktojmë se çfarë është një rrjet nervor.
Në rastin tonë, ky është një model matematikor, si dhe një zbatim i tij programor ose harduerik, i ndërtuar sipas parimeve të organizimit dhe funksionimit të rrjeteve nervore biologjike - rrjetet e qelizave nervore në një organizëm të gjallë. Ky koncept lindi gjatë studimit të proceseve që ndodhin në tru dhe përpjekjeve për t'i modeli këto procese.
Rrjetet nervore nuk programohen në kuptimin e zakonshëm të fjalës; ato mësohen. Mundësia për të mësuar është një nga avantazhet kryesore të rrjeteve nervore krahasuar me algoritmet tradicionale. Teknikisht, të mësuarit përfshin gjetjen e koeficientëve të lidhjeve midis neuroneve. Gjatë procesit të të mësuarit, një rrjet nervor mund të identifikojë varësi të ndërlikuara midis të dhënave hyrëse dhe atyre dalëse, si dhe të kryejë përgjithësime.
Sipas pikëpamjes së mësimit të makinave, një rrjet nervor përbën një rast të veçantë të metodave të njohjes së modeleve, analizës diskriminuese, metodave të klasifikimit dhe metodave të tjera.
Pajisje
Së pari, le të merremi me pajisjet. Ne na nevojitet një server me një sistem operativ Linux të instaluar në të. Pajisjet për sistemet e mësimit të makinave kërkojnë të jenë mjaft të fuqishme dhe për pasojë, të shtrenjta. Ata që nuk kanë një makinë të mirë në dorë, u rekomandoj të shqyrtojnë ofertat e ofruesve të cloud. Serverin e nevojshëm mund ta merrni me qira shpejt dhe të paguani vetëm për kohën e përdorimit.
Në projektet ku nevojitet krijimi i rrjeteve nervore, unë përdor serverë nga një nga ofruesit e cloud në Rusi. Kompania ofron serverë cloud në qira të dizajnuar veçanërisht për mësimin e makinave me procesorë grafikë të fuqishëm (GPU) Tesla V100 nga NVIDIA. Në një përmbledhje: përdorimi i një serveri me GPU mund të jetë disa herë më efikas (i shpejtë) në krahasim me një server të ngjashëm në kosto ku për llogaritjet përdoret CPU (procesori qendror që është i njohur për të gjithë). Kjo arrihet përmes veçorive të arkitekturës së GPU-së, e cila e bën llogaritjen më të shpejtë.
Për të realizuar shembujt e përshkruar më poshtë, ne blëmë një server të tillë për disa ditë:
- Të dhëna SSD 150 GB
- RAM 32 GB
- Procesori Tesla V100 16 Gb me 4 bërthama
Në makinë na u instalua Ubuntu 18.04.
Instalojmë mjedisin
Tani do të instalojmë në server gjithçka e nevojshme për punë. Duke qenë se artikulli ynë është kryesisht për fillestarët, do të flas për disa pika që do t'i shërbejnë ata.
Pjesa më e madhe e punës gjatë konfigurimit të mjedisit bëhet përmes komandës. Shumica e përdoruesve si sistem operativ punues përdorin Windows. Konsola standarde në këtë OS lë për të dëshiruar. Prandaj do të përdorim një instrument të përshtatshëm. . Shkarkojmë versionin mini dhe hapim Cmder.exe. Më pas është e nevojshme të lidhemi me serverin përmes protokollit SSH:
ssh root@server-ip-or-hostnameNë vend të server-ip-or-hostname, jepni adresën IP ose emrin DNS të serverit tuaj. Më pas shkruani fjalëkalimin dhe, nëse lidheni me sukses, duhet të merrni një mesazh të tillë.
Mirë se erdhët në Ubuntu 18.04.3 LTS (GNU/Linux 4.15.0-74-generic x86_64)Gjuha kryesore për zhvillimin e modeleve ML është Python. Dhe platforma më e njohur për ta përdorur në Linux është .
Do ta instalojmë atë në serverin tonë.
Fillojmë me aktualizimin e menaxherit të pakot lokal:
sudo apt-get updateInstalojmë curl (programin ndihmës të komandës):
sudo apt-get install curlShkarkojmë versionin më të fundit të Anaconda Distribution:
cd /tmp
curl –O https://repo.anaconda.com/archive/Anaconda3-2019.10-Linux-x86_64.sh
Fillojmë instalimin:
bash Anaconda3-2019.10-Linux-x86_64.shGjatë instalimit do t'ju duhet të konfirmoni marrëveshjen e licencës. Pas instalimit të suksesshëm, duhet të shihni këtë:
Faleminderit që instaluat Anaconda3!Për zhvillimin e modeleve ML tani janë krijuar shumë framework-e, ne punojmë me ato më të njohura: dhe .
Përdorimi i framework-ut lejon të rritet shpejtësia e zhvillimit dhe të përdoren tashmë mjete të gatshme për detyra standarde.
Në këtë shembull do të punojmë me PyTorch. Le të instalojmë atë:
conda install pytorch torchvision cudatoolkit=10.1 -c pytorchTani na nevojitet të fillojmë Jupyter Notebook — një instrument zhvillimi popullor për specialistët e ML. Ai lejon të shkruajmë kod dhe të shohim menjëherë rezultatet e ekzekutimit të tij. Jupyter Notebook është pjesë e Anaconda dhe tashmë është instaluar në serverin tonë. Duhet të lidhemi me të nga sistemi ynë të desktopit.
Për këtë, fillimisht do ta nisnim Jupyter në serverin duke caktuar portin 8080:
jupyter notebook --no-browser --port=8080 --allow-rootMë pas, hapim një skedë tjetër në konsolën tonë Cmder (menyja e sipërme — dialogu New console) dhe lidhim përmes portit 8080 me serverin përmes SSH:
ssh -L 8080:localhost:8080 root@server-ip-or-hostnameKur të futim koman ndihmëse, do na ofrohen lidhje për të hapur Jupyter në shfletuesin tonë:
Për të aksesuar notebook-un, hapni këtë skedë në shfletues:
        file://root/.local/share/jupyter/runtime/nbserver-18788-open.html
    Ose kopjoni dhe ngjitni njërin nga këto URL:
        http://localhost:8080/?token=cca0bd0b30857821194b9018a5394a4ed2322236f116d311
     ose http://127.0.0.1:8080/?token=cca0bd0b30857821194b9018a5394a4ed2322236f116d311
Do të përdorim lidhjen për localhost:8080. Kopjoni rrugën e plotë dhe ngjitni atë në shiritin e adresës së shfletuesit tuaj lokal. Jupyter Notebook do të hapet.
Të krijojmë një notebook të ri: New — Notebook — Python 3.
Do të verifikojmë funksionimin e saktë të të gjithë komponenteve që kemi instaluar. Do të fusim në Jupyter një shembull të kodit PyTorch dhe do të fillojmë ekzekutimin (butoni Run):
from __future__ import print_function
import torch
x = torch.rand(5, 3)
print(x)
Rezultati duhet të jetë diçka e tillë:
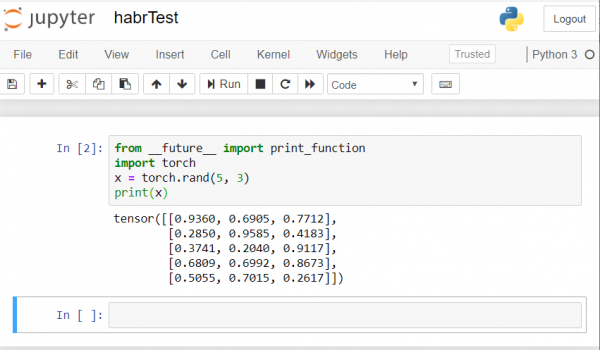
Nëse keni një rezultat të ngjashëm — atëherë e kemi konfigurimin e saktë dhe mund të fillojmë me zhvillimin e rrjetit nervor!
Krijojmë një rrjet nervor
Do të krijojmë një rrjet nervor për njohjen e imazheve. Do të marrim këtë si bazë .
Për trajnimin e rrjetit do të përdorim një set të dhënash të hapura, CIFAR10. Ai ka klasat: «avioni», «automobili», «zogu», «maca», «gjahu», «qeni», «frëngjia», «kalorësi», «anija», «kamioni». Imazhet në CIFAR10 kanë madhësi 3x32x32, pra janë imazhe me ngjyra me 3 kanale, me përmasat 32×32 piksel.
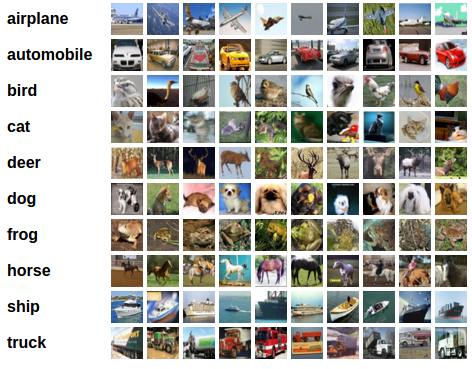
Për punë do të përdorim paketën e krijuar në PyTorch për të punuar me imazhet — torchvision.
Do të kryejmë hapat e mëposhtëm në rend:
- Shkarkimi dhe normalizimi i setit të të dhënave për trajnim dhe testim
- Përcaktimi i rrjetit nervor
- Trajnimi i rrjetit me të dhënat e trajnimit
- Testimi i rrjetit me të dhënat e testimit
- Do ta përsërisim trajnimin dhe testimin me përdorimin e GPU-së
I gjithë kodi i mësipërm do ta kryejmë në Jupyter Notebook.
Shkarkimi dhe normalizimi i CIFAR10
Kopjoni dhe ekzekutoni në Jupyter kodin e mëposhtëm:
import torch
import torchvision
import torchvision.transforms as transforms

transform = transforms.Compose(
    [transforms.ToTensor(),
     transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

trainset = torchvision.datasets.CIFAR10(root='./data', train=True,
                                        download=True, transform=transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=4,
                                          shuffle=True, num_workers=2)

testset = torchvision.datasets.CIFAR10(root='./data', train=False,
                                       download=True, transform=transform)
testloader = torch.utils.data.DataLoader(testset, batch_size=4,
                                         shuffle=False, num_workers=2)

classes = ('plane', 'car', 'bird', 'cat',
           'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
Përgjigjja duhet të jetë kështu:
Po shkarkoj https://www.cs.toronto.edu/~kriz/cifar-10-python.tar.gz te ./data/cifar-10-python.tar.gz
Duke e nxjerrë ./data/cifar-10-python.tar.gz në ./data
Skedarët tashmë janë shkarkuar dhe verifikuar
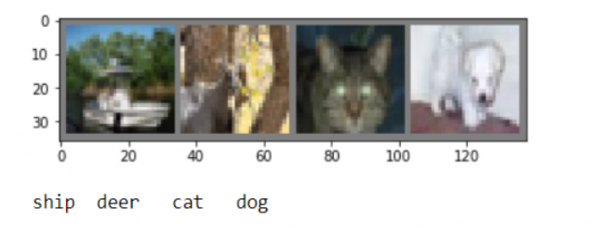
Le të shfaqim disa imazhe trajnimi për verifikim:
import matplotlib.pyplot as plt
import numpy as np

# funksionet për të treguar një imazh

def imshow(img):
    img = img / 2 + 0.5     # pa normalizim
    npimg = img.numpy()
    plt.imshow(np.transpose(npimg, (1, 2, 0)))
    plt.show()

# merr disa imazhe të rastësishme të trajnimit
dataiter = iter(trainloader)
images, labels = dataiter.next()

# shfaq imazhet
imshow(torchvision.utils.make_grid(images))
# print etiketat
print(' '.join('%5s' % classes[labels[j]] for j in range(4)))
Përcaktimi i rrjetit nervor
Le të shqyrtojmë më parë se si funksionon një rrjet nervor për njohjen e imazheve. Ky është një rrjet i thjeshtë me lidhje direkte. Ai merr të dhënat hyrëse, i kalon ato përmes disa shtresash njëra pas tjetrës, dhe më në fund jep rezultatet.
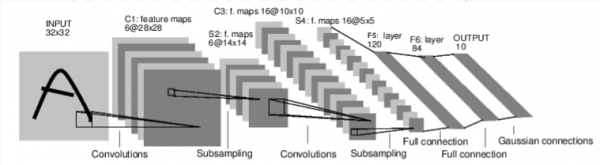
Le ta krijojmë një rrjet të tillë në ambientin tonë:
import torch.nn as nn
import torch.nn.functional as F

class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(3, 6, 5)
        self.pool = nn.MaxPool2d(2, 2)
        self.conv2 = nn.Conv2d(6, 16, 5)
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        self.fc2 = nn.Linear(120, 84)
        self.fc3 = nn.Linear(84, 10)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = self.pool(F.relu(self.conv2(x)))
        x = x.view(-1, 16 * 5 * 5)
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.fc3(x)
        return x

net = Net()
Po ashtu, le të përcaktojmë funksionin e humbjes dhe optimizuesin
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
Trajnimi i rrjetit me të dhënat e trajnimit
Nisemi me trajnimin e rrjetit tonë nervor. Vërej se pasi të ekzekuash këtë kod, do të duhet të presësh për një kohë deri në përfundimin e punës. Mua më mori 5 minuta. Për të trajnuar rrjetin, duhen kohë.
 për epokë në rang (2): # përsëritni përmbledhjen disa herë

 humbja_e_aktivitetit = 0.0
 për i, të dhëna në enumerate(trainloader, 0):
 # merrni hyrjet; të dhënat janë një listë e [hyrjeve, etiketave]
 hyrjet, etiketat = të dhëna

 # zero gradienët e parametrave
 optimizer.zero_grad()

 # përparë + prapa + optimizo
 daljet = net(hyrjet)
 humbja = kriteri(daljet, etiketat)
 humbja.backward()
 optimizer.step()

 # printoni statistikat
 humbja_e_aktivitetit += humbja.item()
 nëse i % 2000 == 1999: # printoni çdo 2000 mini-batch
 print('[%d, ] humbje: %.3f' %
 (epokë + 1, i + 1, humbja_e_aktivitetit / 2000))
 humbja_e_aktivitetit = 0.0

print('Trajnimi përfundoi')
Do të marrim një rezultat të tillë:
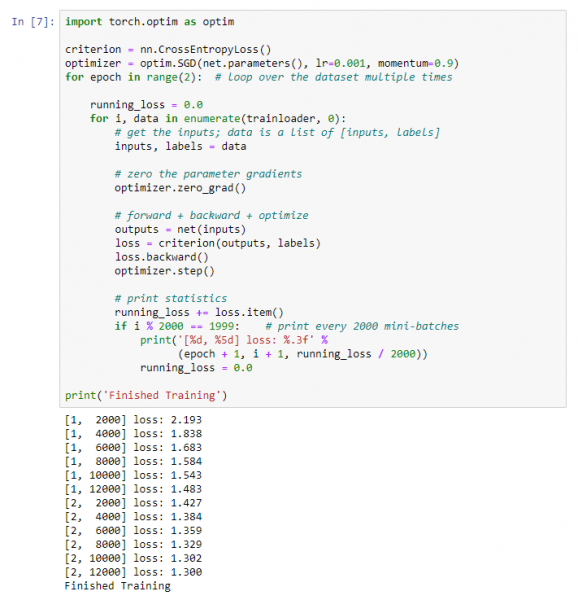
Ruajmë modelin tonë të trajnuar:
RRUGA = './cifar_net.pth'
torch.save(net.state_dict(), RRUGA)
Testimi i rrjetit me të dhënat e testimit
Kemi trajnuar rrjetin duke përdorur grupin e të dhënave të trajnimit. Por na nevojitet të verifikojmë nëse rrjeti ka mësuar diçka.
Ne do ta kontrollojmë këtë duke parashikuar etiketën e klasës që rrjeti nervor prodhon dhe duke e verifikuar atë për saktësi. Nëse parashikimi është i saktë, ne e shtojmë mostrat në listën e parashikimeve të sakta.
Le të tregojmë një imazh nga grupi testues:
dataiter = iter(testloader)
imazhet, etiketat = dataiter.next()

# printo imazhet
imshow(torchvision.utils.make_grid(imazhet))
print('E vërteta: ', ' '.join('%5s' % classes[etiketat[j]] për j në gamë(4))) 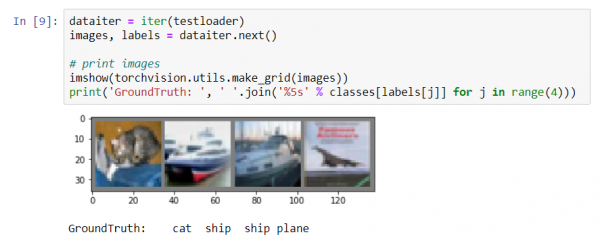
Tani le t'i kërkojmë rrjetit nervor të na tregojë se çfarë ka në këto imazhe:
net = Net()
net.load_state_dict(torch.load(RRUGA))

daljet = net(imazhet)

_, parashikuar = torch.max(daljet, 1)

print('Parashikuar: ', ' '.join('%5s' % classes[parashikuar[j]]
                              për j në gamë(4)))
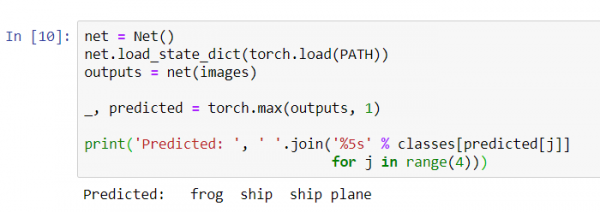
Rezultatet duken mjaft të mira: rrjeti ka identifikuar saktë tre imazhe nga katër.
Le të shohim si funksionon rrjeti në të gjithë grupin e të dhënave.
i saktë = 0
total = 0
me torch.no_grad():
    për të dhënat në testloader:
        imazhet, etiketat = të dhënat
        daljet = net(imazhet)
        _, parashikuar = torch.max(daljet.data, 1)
        total += etiketat.size(0)
        i saktë += (parashikuar == etiketat).sum().item()

print('Saktësia e rrjetit në 10000 imazhet e testit: %d %%' % (
100 * i saktë / total)) 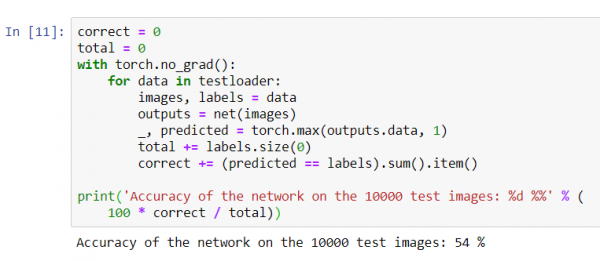
Duket se rrjeti di diçka dhe funksionon. Nëse ai do të parashikonte klasat me rastësi, saktësia do të ishte 10%.
Tani le të shohim se cilat klasa rrjeti identifikon më mirë:
klasa_e_saktë = list(0. për i në rang (10))
klasa_total = list(0. për i në rang (10))
me torch.no_grad():
 për të dhëna në testloader:
 imazhe, etiketat = të dhëna
 daljet = net(imazhe)
 _, parashikuar = torch.max(daljet, 1)
 c = (parashikuar == etiketat).squeeze()
 për i në rang (4):
 etiketë = etiketat[i]
 klasa_e_saktë[etiketë] += c[i].item()
 klasa_total[etiketë] += 1


për i në rang (10):
 print('Saktësia e %5s : %%' % (
klasat[i], 100 * klasa_e_saktë[i] / klasa_total[i])) 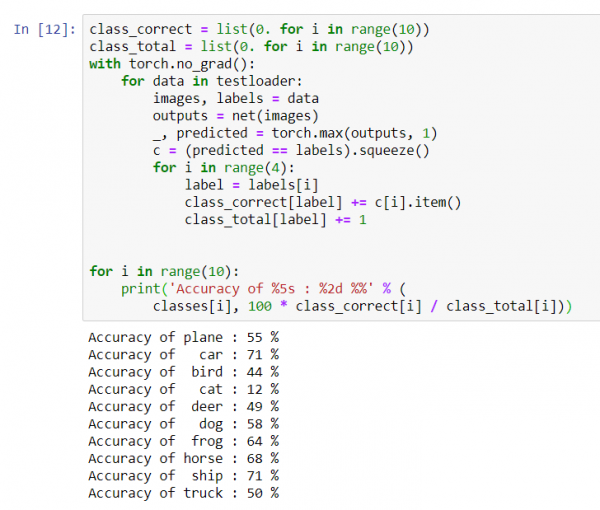
Duket se rrjeti e identifikon më së miri automjetet dhe anijet: 71% saktësi.
Pra, rrjeti funksionon. Tani le të përpiqemi ta transferojmë funksionin e tij në një procesor grafik (GPU) dhe të shohim çfarë do të ndryshojë.
Trajnimi i rrjetit nervor në GPU
Fillimi i parë do të shpjegoj shkurt se çfarë është CUDA. CUDA (Compute Unified Device Architecture) është një platformë për llogaritjet paralele, e zhvilluar nga NVIDIA, për llogaritjet e përgjithshme në procesorët grafikë (GPU). Me ndihmën e CUDA-s, zhvilluesit mund të përshpejtojnë ndjeshëm aplikacionet e llogaritjes, duke shfrytëzuar mundësitë e procesorëve grafikë. Në serverin tonë, që kemi blerë, kjo platformë është tashmë e instaluar.
Le të fillojmë së pari duke e definuar GPU-në tonë si pajisjen e parë të dukshme cuda.
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
# Duke supozuar që jemi në një makinë CUDA, kjo duhet të printojë një pajisje CUDA:
print(device) 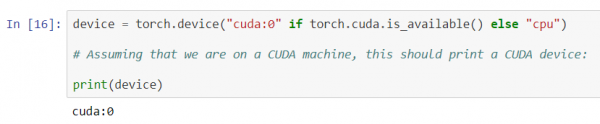
Dërgojmë rrjetin në GPU:
net.to(device)Po ashtu, do të na duhet të dërgojmë hyrjet dhe qëllimet në çdo hap dhe në GPU:
inputs, labels = data[0].to(device), data[1].to(device)Le të fillojmë trajnimin e rrjetit tashmë në GPU:
importo torch.optim si optim

kriteri = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
për epokë në rang (2): # përsëritni përmbledhjen disa herë

 humbja_e_aktivitetit = 0.0
 për i, të dhëna në enumerate(trainloader, 0):
 # merrni hyrjet; të dhënat janë një listë e [hyrjeve, etiketave]
 hyrjet, etiketat = të dhëna[0].to(device), të dhëna[1].to(device)

 # zero gradienët e parametrave
 optimizer.zero_grad()

 # përparë + prapa + optimizo
 daljet = net(hyrjet)
 humbja = kriteri(daljet, etiketat)
 humbja.backward()
 optimizer.step()

 # printoni statistikat
 humbja_e_aktivitetit += humbja.item()
 nëse i % 2000 == 1999: # printoni çdo 2000 mini-batch
 print('[%d, ] humbje: %.3f' %
 (epokë + 1, i + 1, humbja_e_aktivitetit / 2000))
 humbja_e_aktivitetit = 0.0

print('Trajnimi përfundoi')
Këtë herë, trajnimi i rrjetit zgjati rreth 3 minuta. Kujtojmë se po ai hap në një procesor të zakonshëm zgjati 5 minuta. Diferenca nuk është e madhe, kjo ndodh për shkak se rrjeti ynë nuk është kaq i madh. Ndërsa përdoren grupe më të mëdha për trajnim, diferenca ndërmjet shpejtësisë së punës së GPU-së dhe procesorit tradicional do të rritet.
Duket se për këtë është gjithçka. Çfarë arritëm të bëjmë:
- Ne shqyrtuam se çfarë është GPU dhe zgjodhëm serverin në të cilin është instaluar;
- Ne konfiguruam mjedisin programor për krijimin e një rrjeti nervor;
- Ne krijuam një rrjet nervor për njohjen e imazheve dhe e trajnuam atë;
- Ne përsëritëm trajnimin e rrjetit duke përdorur GPU dhe arritëm një rritje në shpejtësi.
Do të jem i lumtur të përgjigjem në pyetje në komentet.
Burimi: habr.com
