

Artikulli u shkrua nga një numër i madh materialesh mbi analizën statike që po shkonte gjithnjë e më shumë në sy. Në radhë të parë, ky është , i cili promovon vetveten aktivisht në Habrë me ndihmën e analizave të gabimeve që janë gjetur nga mjeti i tyre në projekte me kod të hapur. Së fundmi, PVS-studio kanë realizuar , dhe, sigurisht, zhvilluesit e IntelliJ IDEA, i cili ndoshta ka analizuesin më të avancuar për Java sot, .
Kur lexojmë analiza të tilla, ndjejmë se po flitet për një eliksir magjik: shtypni butonin dhe ja, lista e defekteve është para syve tanë. Duket se me përmirësimin e analizatorëve, do të gjenden gjithnjë e më shumë gabime automatikisht, dhe produktet që janë skanuar nga këta robota do të bëhen gjithnjë e më të mira, pa ndonjë përpjekje nga ana jonë.
Por eliksirët magjikë nuk ekzistojnë. Do doja të flisja për atë që zakonisht nuk diskutohet në postime të tilla si "ja çfarë mund të gjejë roboti ynë": çfarë nuk mund të bëjnë analizatorët, cili është roli dhe vendi i tyre real në procesin e dorëzimit të softuerit dhe si t'i implementojmë ato siç duhet.
Frenues (burimi: ).
Cilësitë që kurrë nuk do t'i arrijnë analizatorët statikë.
Çfarë është, nga një pikëpamje praktike, analiza e kodit burimor? Ne jemi duke dërguar disa burime në hyrje, dhe në dalje, në një kohë të shkurtër (ndoshta shumë më të shkurtër se ajo e testimeve) marrim disa informacione mbi sistemin tonë. Kufizimi themelor dhe matematikisht i pakapërcyeshëm është se çfarë mund të marrim në këtë mënyrë është vetëm një klasë mjaft e ngushtë informacioni.
Shembulli më i njohur i një problemi që nuk mund të zgjidhet me anë të analizës statike është kjo është një teoremë që provon se është e pamundur të zhvillohet një algoritëm universal që do të përcaktonte, nga kodi burimor i një programi, nëse do të bjerë në cikël apo do të përfundojë në një kohë të përcaktuar. Një zgjerim i kësaj teoreme është , e cila, për çdo pronë jo triviale të funksioneve të llogaritshme, përcaktimi nëse një program i caktuar llogarit një funksion me një pronë të tillë është një detyrë algoritmikisht e paqartë. Për shembull, është e pamundur të shkruhet një analizues që, për çdo kod burimi, përcakton nëse programi i analizuar është një implementim i një algoritmi që llogarit, le të themi, katrorin e një numri të plotë.
Prandaj, funksionaliteti i analizuesve statikë ka kufij të paevitueshëm. Një analizues statik kurrë nuk do të mund të përcaktojë në të gjitha rastet gjëra të tilla si, për shembull, ndodhia e ‘null pointer exception’ në gjuhët që lejojnë vlerën null, ose në të gjitha rastet të përcaktojë ndodhinë e ‘attribute not found’ në gjuhët me tipizim dinamik. Gjithçka që mund të bëjë një analizues statik i përsosur është të përzgjedhë raste të veçanta, numri i të cilave mes të gjitha problemeve të mundshme me kodin tuaj është, pa e ekzagjeruar, një pikë në det.
Analiza statike nuk është kërkimi i defekteve
Nga e gjitha që u përmend më sipër, del në përfundim se analiza statike nuk është një mjet për të ulur numrin e defekteve në program. Kam guximin të them se, kur aplikohet për herë të parë në projektin tuaj, ajo do të gjejë ‘vende interesante’ në kod, por me shumë të ngjarë nuk do të identifikojë asnjë defekt që ndikojnë në cilësinë e funksionimit të programit tuaj.
Shembujt e defekteve, të gjetura automatikisht nga analizuesit, janë të jashtëzakonshëm, por nuk duhet harruar se këto shembuj janë gjetur përmes skanimit të një numri të madh kodesh të mëdha. Në të njëjtën mënyrë, hakerët që kanë mundësinë të provojnë disa fjalëkalime të thjeshta në një numër të madh llogarish, përfundimisht gjejnë ato llogari ku ka një fjalëkalim të thjeshtë.
A do të thotë kjo se analiza statike nuk duhet aplikuar? Sigurisht jo! Dhe për të njëjtën arsye për të cilën është e arsyeshme të kontrolloni çdo fjalëkalim të ri për t'u siguruar që nuk është në listën e ndaluar të fjalëkalimeve ‘të thjeshta’.
Analiza statike është më shumë se kërkimi i defekteve
Në të vërtetë, detyrat që janë praktikisht të zgjidhshme përmes analizës janë shumë më të gjera. Sepse, në tërësi, analiza statike është çdo kontroll i burimeve që bëhet para se ato të ekzekutohen. Ja disa gjëra që mund të bëhen:
- Kontrolli i stilit të kodit në një kuptim të gjerë. Kjo përfshin si kontrollin e formatimit, ashtu edhe kërkimin e përdorimit të kornizave të panevojshme, vendosjen e pragjeve të metrikave siç është numri i linjave / kompleksiteti ciklomatik i metodës etj. - gjithçka që potencialisht vështirëson lexueshmërinë dhe mirëmbajtjen e kodit. Në Java, një mjet i tillë është Checkstyle, ndërsa në Python është flake8. Programet e këtij lloji zakonisht quhen "linters".
- Analiza mund të përfshijë jo vetëm kodin e ekzekutueshëm. Dosjet e burimeve, siç janë JSON, YAML, XML, .properties mund (dhe duhet!) të verifikohen automatikisht për vlefshmërinë. Sepse është më mirë të kësaj t'i dihet se ndonjëherë struktura e JSON është prishur për shkak të ndonjë cituar të paarritshëm në një fazë të hershme të verifikimit automatik të Pull Request sesa gjatë ekzekutimit të testeve ose në kohës së ekzekutimit? Instrumentet përkatëse ekzistojnë: për shembull, , .
- Kompilimi (ose parsing për gjuhët e programimit dinamik) është gjithashtu një lloj analize statike. Në përgjithësi, kompilatorët janë në gjendje të japin paralajmërime që sinjalizojnë probleme me cilësinë e kodit burimor, dhe ato nuk duhet të injorohen.
- Herë pas here, kompiliimi nuk është vetëm kompilim i kodit ekzekutues. Për shembull, nëse keni dokumentacion në formatin , në momentin që po e ktheni atë në HTML/PDF, përpunuesi AsciiDoctor () mund të japë paralajmërime, për shembull, për lidhjet e brendshme të prishura. Dhe kjo është një arsye e fortë për të mos pranuar një Pull Request me ndryshime në dokumentacion.
- Kontrolli i ortografisë është gjithashtu një lloj analize statike. Utility është në gjendje të kontrollojë ortografinë jo vetëm në dokumentacion, por edhe në kodet burimore të programeve (komentet dhe literalet) në gjuhë të ndryshme programimi, duke përfshirë C/C++, Java dhe Python. Një gabim ortografie në ndërfaqen e përdoruesit ose dokumentacionin është gjithashtu një defekt!
- Testet e konfigurimit (për ato që janë, shihni dhe raportet) megjithatë, që ekzekutohen në një mjedis të ekzekutimit të testeve modulare të tipit pytest, në të vërtetë janë gjithashtu një lloj analize statike, pasi nuk ekzekutojnë kodet burimore gjatë ekzekutimit të saj.
Siç e shohim, kërkimi i defekteve në këtë listë merr rolin më pak të rëndësishëm, ndërsa gjithçka tjetër është e aksesueshme përmes përdorimit të mjeteve open source falas.
Cilat nga këto lloje të analizës statike duhet të aplikoni në projektin tuaj? Natyrisht, të gjitha! Sa më shumë, aq më mirë! E rëndësishme është ta implementoni këtë në mënyrë të saktë, për çfarë do të flasim më tej.
Pipa e furnizimit si një filtrues me shumë nivele dhe analiza statike si kaskada e saj e parë
Metafora klasike e integrimit të vazhdueshëm është një tubacion (pipeline) përmes të cilit kalojnë ndryshimet — nga ndryshimi i kodit burimor deri te furnizimi në production. Renditja standart e fazave të këtij tubacioni duket kështu:
- analiza statike
- kompilimi
- testet modulore
- testet integruese
- testet UI
- kontrolli manual
Ndryshimet që nuk kalojnë fazën N, nuk transferohen në fazën N+1.
Pse pikërisht kështu dhe jo ndryshe? Në atë pjesë të tubacionit që ka të bëjë me testimin, testuesit njohin piramidën e njohur të testimit.
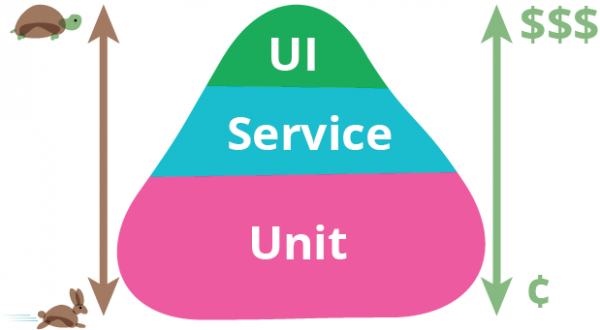
Piramida e testit. Burimi: Martin Fowler.
Në pjesën e poshtme të kësaj piramide ndodhen testet që janë më të lehta për t'u shkruar, që ekzekutohen më shpejt dhe nuk kanë tendencë për rrema false. Prandaj, ato duhet të jenë më të shumta, duhet të mbulojnë më shumë kod dhe të ekzekutohen të parat. Në pjesën e sipërme të piramidës është e kundërta, prandaj numri i testeve integruese dhe UI duhet të reduktohet në minimumin e nevojshëm. Njeriu në këtë zinxhir është burimi më i shtrenjtë, më i ngadalshëm dhe më i pasigurt, prandaj ai ndodhet në fund dhe kryen punën vetëm nëse fazat e mëparshme nuk zbulojnë asnjë defekt. Megjithatë, sipas të njëjtave parime ndërtimi, tubacioni ndërttohet edhe në pjesët që nuk lidhen drejtpërdrejt me testimin!
Deshiroj të propozoj një analogji në formën e një sistemi filtrues me shumë nivele. Në hyrje futet ujë i ndotur (ndryshime me defekte), ndërsa në dalje duhet të marrim ujë të pastër, të gjitha ndotjet e padëshiruara përjashtohen.
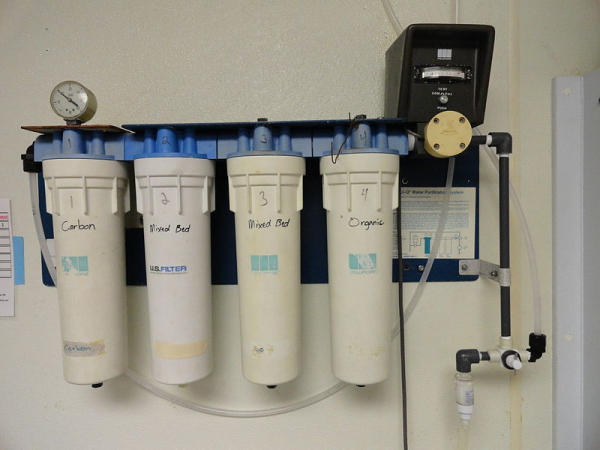
Filtri me shumë nivele. Burimi:
Si e dihet, filtrat e pastruar projektohen në mënyrë që çdo kaskadë e ardhshme të jetë në gjendje të filtrojë një fraksion gjithnjë e më të vogël të ndotjes. Në të njëjtën kohë, kaskadat e pastrimit më të rëndë kanë një kapacitet më të madh kalimi dhe një kostosh më të ulët. Në analogjinë tonë, kjo do të thotë se portat e cilësisë së hyrjes kanë performancë më të madhe, kërkojnë më pak përpjekje për të funksionuar dhe janë më të thjeshta për t'u funksionuar — dhe kjo është mënyra si janë radhitur. Roli i analizës statike, e cila, siç e kuptojmë tani, mund të filtrojë vetëm defektet më të dukshme — është roli i grilës së "ndotësit" në fillim të kaskadës së filtrave.
Analiza statike vetvetiu nuk e përmirëson cilësinë e produktit përfundimtar, ashtu si ndotësi nuk e bën ujin të pijshëm. Megjithatë, në lidhje me elementët e tjerë të procesit, rëndësia e saj është evidente. Megjithëse në një filtër me shumë kaskada, kaskadat dalëse janë potencialisht në gjendje të kapin të njëjtat gjëra si ato hyrëse — është e qartë se çfarë pasojash do të ketë përpjekja për të vepruar vetëm me kaskadat e pastrimit të hollë, pa kaskadat hyrëse.
Qëllimi i ndotësit është të shkarkojë kaskadat e mëvonshme nga kapja e defekteve më të dukshme. Për shembull, së paku, ndihmësit për kontrollin e kodit nuk duhet të shpërqendrohen nga kodet e formatuara keq dhe shkeljet e rregullave të kodifikimit (si përshtatjet e panevojshme ose ndarjet shumë të thella). Gabimet si NPE duhet të kapen nga testet modulare, por nëse analiza na tregon se një defekt do të ndodhë patjetër para testit — kjo do të përshpejtojë ndjeshëm rregullimin e tij.
Mendoj se tani është e qartë pse analiza statike nuk përmirëson cilësinë e produktit, nëse aplikohet episodikisht, dhe duhet të aplikohet vazhdimisht për të filtruar ndryshimet me defekte të dukshme. Pyetja nëse përdorimi i një analizatori statik do të përmirësojë cilësinë e produktit tuaj, është afërsisht e barabartë me pyetjen "a do të përmirësohet cilësia e ujit të pijshëm, nëse e kalojmë atë përmes një sitari nga një liqen i ndotur?"
Zbatimi në projektet legacy
Një pyetje e rëndësishme praktike: si ta implementojmë analizën statike në procesin e integrimit të vazhdueshëm si "quality gate"? Në rastin e testeve automatike, gjithçka është e qartë: ka një grup testesh, rënia e cilitdo prej tyre është një arsye e mjaftueshme për të konsideruar se ndërtimi nuk kaloi quality gate. Pëpjekja për të vendosur në mënyrë të ngjashme gate sipas rezultateve të analizës statike dështojnë: në kodin legacy ka shumë paralajmërime të analizës, nuk dëshirojmë t'i injorojmë ato plotësisht, por gjithashtu nuk është e mundur të ndalet shpërndarja e produktit thjesht sepse ka paralajmërime nga analizatori.
Duke qenë se aplikohet për herë të parë, në çdo projekt analizatori lëshon një sasi të madhe paralajmërimesh, shumica e të cilave nuk kanë lidhje me funksionimin e duhur të produktit. Të gjitha këto vërejtje është e pamundur t'i rregullojmë menjëherë, dhe shumë prej tyre — as nuk nevojiten. Në fund të fundit, ne e dimë se produkti ynë në përgjithësi funksionon, dhe madje edhe para se të implementonim analizën statike!
Si rezultat, shumë kufizohen në përdorimin episodik të analizës statike, ose e përdorin atë vetëm në mënyrë informative, kur gjatë ndërtimit thjesht lëshohet një raport nga analizatori. Kjo është ekuivalente me mungesën e çdo analize, sepse nëse ne tashmë kemi shumë paralajmërime, shfaqja e një tjetër (sa do që të rëndësishëm) gjatë ndryshimit të kodit kalon pa u vënë re.
Janë të njohura mënyra të dhënies së quality gates:
- Vendosja e një kufiri të numrit të përgjithshëm të paralajmërimeve ose numrit të paralajmërimeve të ndarë me numrin e linjave të kodit. Kjo funksionon keq, pasi një gate i tillë lejon lirshëm ndryshimet me defekte të reja, derisa kufiri i tyre të mos tejkalohet.
- Regjistrimi, në një moment të caktuar, i të gjitha paralajmërimeve të vjetra në kod si të injoruara, dhe ndalimi i ndërtimit në rast se shfaqen paralajmërime të reja. Këtë funksionalitet e ofron PVS-studio dhe disa burime online, për shembull, Codacy. Nuk kam punuar me PVS-studio, por në përvojën time me Codacy, problemi kryesor është që përcaktimi se çfarë është "e vjetra", dhe çfarë "e re" është një algoritëm mjaft i ndërlikuar dhe jo gjithmonë funksionon siç duhet, veçanërisht nëse skedaret ndryshojnë shumë ose rinovohen. Në kujtesën time, Codacy mund të kalonte paralajmërime të reja në një pull request, dhe në të njëjtën kohë të mos e kalonte pull request-in për shkak të paralajmërimeve që nuk i përkasin ndryshimeve në kodin e këtij PR.
- Sipas mendimit tim, zgjidhja më efektive është ajo që përshkruhet në libër "metoda e ratchet" ("ratcheting"). Ideja kryesore është se një atribut i çdo lëshimi është numri i paralajmërimeve të analizës statike, dhe lejohet vetëm ndryshime të tilla që nuk e rrisin numrin e përgjithshëm të paralajmërimeve.
Ratchet
Funksionon kështu:
- Në fazën fillestare, realizohet regjistrimi në metadata për lëshimin e numrit të paralajmërimeve në kod, të gjetura nga analizatorët. Kështu, gjatë ndërtimit të degës kryesore, në menaxherin tuaj të repositorëve regjistrohet jo thjesht "lëshimi 7.0.2", por "lëshimi 7.0.2, që përmban 100500 paralajmërime Checkstyle". Nëse përdorni një menaxher repositorësh të avancuar (si Artifactory), ruajtja e të tilla metadata për lëshimin tuaj është e lehtë.
- Tani çdo pull request gjatë ndërtimit krahason numrin e paralajmërimeve që rezultojnë me numrin që njëmend ekziston në lëshimin aktual. Nëse PR çon në rritjen e këtij numri, kodin nuk e kalon portën e cilësisë për analizën statike. Nëse numri i paralajmërimeve zvogëlohet ose nuk ndryshon — atëherë kalon.
- Në lëshimin e ardhshëm, numri i ripërllogaritur i paralajmërimeve do të regjistrohet përsëri në metadata të lëshimit.
Disa pak, por pa ndalur (sikur në funksionimin e një mekanizmi zëvendësues), numri i paralajmërimeve do të arrijë në zero. Sigurisht, sistemi mund të manipulohet duke futur një paralajmërim të ri, por duke rregulluar një të huaj. Kjo është e pranuar, pasi në një distancë të gjatë jep rezultat: paralajmërimet rregullohen, zakonisht, jo një për një, por të gjithë së bashku në një grup të caktuar, dhe paralajmërimet që janë lehtësisht të eliminueshme shpejt eliminohen.
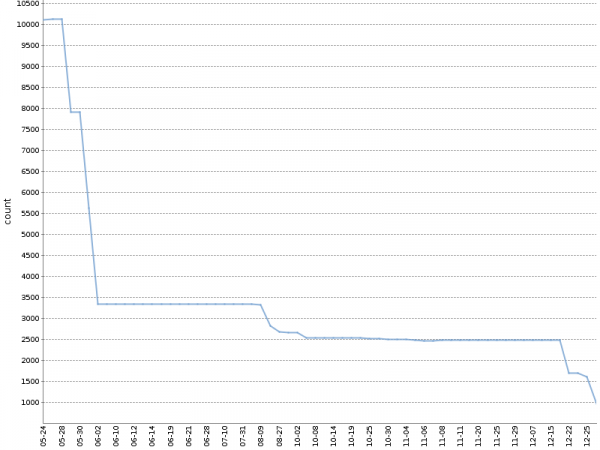
Në këtë grafik është treguar numri total i paralajmërimeve Checkstyle për gjashtë muaj punë të këtij "mekanizmi zëvendësues" në . Numri i paralajmërimeve është zvogëluar me një rend, dhe kjo ndodhi në mënyrë të natyrshme, paralel me zhvillimin e produktit!
Unë aplikoj një version të modifikuar të kësaj metode, duke llogaritur veçmas paralajmërimet në ndarje sipas moduleve të projektit dhe mjeteve të analizës, skedari YAML i krijuar me metadatat për ndërtimin duket më pak kështu:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
Në çdo sistem të avancuar CI, mekanizmi zëvendësues mund të realizohet për çdo mjet të analizës statike, pa u mbështetur në plugina dhe mjete të jashtme. Çdo një nga analizatorët jep raportin e tij në një format tekstual të thjeshtë ose XML, që lehtë mund të analizohet. Mbete vetëm të shkruash logjikën e nevojshme në skriptin CI. Mund të shikosh se si është realizuar në projektet tona open source mbi bazën e Jenkins dhe Artifactory, ose . Të dy shembujt varen nga biblioteka : metoda countWarnings() numëron zakonisht etiketat xml në skedarët e krijuar nga Checkstyle dhe Spotbugs, dhe compareWarningMaps() realizon pikërisht atë mekanizmin zëvendësues, duke hedhur një gabim në rast se numri i paralajmërimeve në ndonjë nga kategoritë rritet.
Një variant interesant i implementimit të «ratchet» është i mundshëm për analizën e drejtshkrimit të komenteve, literalëve tekstualë dhe dokumentacionit duke përdorur aspell. Siç dihet, gjatë kontrollit të drejtshkrimit, jo të gjitha fjalët që nuk janë të njohura për fjalorin standard janë të gabuara; ato mund të shtohen në fjalorin e përdoruesit. Nëse e bëni fjalorin e përdoruesit pjesë të kodit burimor të projektit, atëherë cilësia e portës për drejtshkrimin mund të formulohet kështu: ekzekutimi i aspell me fjalorin standard dhe atë të përdoruesit. të gjejë ndonjë gabim drejtshkrimor.
Për rëndësinë e fiksmantit të versionit të analizuesit
Në përfundim, duhet të theksohet se: sado që ta implementoni analizën në konvjerin tuaj të dorëzimit, versioni i analizuesit duhet të jetë i fikstuar. Nëse lejoni një përditësim spontan të analizuesit, atëherë gjatë ndërtimit të një pull request-i të ri mund të dalin defekte të reja, të cilat nuk janë të lidhura me ndryshimin e kodit, por me faktin se analizuesi i ri thjesht është në gjendje të gjejë më shumë defekte — dhe kjo do ta dështojë procesin tuaj të pranimit të pull request-eve. Përmirësimi i analizuesit duhet të jetë një veprim i vetëdijshëm. Megjithatë, fiksmanti i fortë i versionit të çdo komponenti të ndërtimit është një kërkesë e nevojshme dhe një temë për një bisedë të veçantë.
Përfundimet
- Analiza statike nuk do t'ju gjejë gabitë dhe nuk do të përmirësojë cilësinë e produktit tuaj si rezultat i një aplikimi të vetëm. Efekti pozitiv për cilësinë jepet vetëm nga aplikimi i saj të vazhdueshëm gjatë procesit të dorëzimit.
- Gjetja e gabive nuk është në të vërtetë detyra kryesore e analizës; shumica dërrmuese e funksioneve të dobishme janë të disponueshme në mjetet opensource.
- Implementoni cilësitë e portave sipas rezultateve të analizës statike në fazën e parë të konvjerit të dorëzimit, duke përdorur «ratchet» për kodin legacy.
Linket
- një referat mbi metoda të ndryshme të analizës së kodit (jo vetëm statike!)
Burimi: habr.com
