

Ky kjo shënim do të jetë i dobishëm për ata që përdorin bibliotekën përpunuese të të dhënave tabelare për R — data.table, dhe ndoshta do të jenë të kënaqur të shohin fleksibilitetin e aplikimit të saj në shembuj të ndryshëm.
Të frymëzuar nga një shembull i mirë , dhe duke shpresuar që tashmë keni lexuar artikullin e tij, propozoj të thellojmë më shumë në optimizimin e kodit dhe performancën bazuar në data.table.
Hyrje: nga vjen data.table?
Më së miri është të filloni njohjen me bibliotekën nga pak larg, pra, nga struktura e të dhënave, nga e cila mund të krijohet objekti data.table (në vazhdim, DT).
Array
Kodi
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Një nga ato struktura është array (?base::array). Ashtu si në gjuhët e tjera, array-t këtu janë shumë-dimensionale. Megjithatë, është interesante se, për shembull, array dy-dimensional fillon të trashëgojë cilësi nga klasa e matricës (?base::matrix), ndërsa array një-dimensional, çka është gjithashtu e rëndësishme, nuk trashëgon nga vektori (?base::vector).
Në këtë kontekst, është e nevojshme të kuptohet se lloji i të dhënave që përmban ndonjë objekt duhet të kontrollohet nga funksioni base::typeof, i cili kthen përshkrimin e brendshëm të llojit sipas R Internals — protokollin e përgjithshëm të gjuhës, i lidhur me origjinën C.
Një komandë tjetër, për të përcaktuar klasën e objektit, base::class, kthen në rastin e vektorëve llojin vektorial (ai ndryshon emrin nga ai i brendshëm, por gjithashtu lejon të kuptohet lloji i të dhënave).
Lista
Nga array dy-dimensional, që është matrica, mund të kaloni në listë (?base::list).
Kodi
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Këtu ndodhin disa gjëra njëherësh:
- Dimensioni i dytë i matrices shkurtohet, domethënë, ne marrim njëkohësisht një listë dhe një vektor.
- Lista, kështu, trashëgon nga këto klasa. Duhet pasur parasysh se njërit element të listës do t'i përgjigjet një vlerë (skalar) nga qelia e matrices-array.
Duke qenë se lista është gjithashtu një vektor, disa funksione për vektorët mund t'i aplikohen.
Dataframe
Nga lista, matrica ose vektori mund të kaloni në dataframe (?base::data.frame).
Kodi
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Çfarë është interesante në të: dataframe trashëgon nga lista! Kolonat e dataframe janë qeliza të listës. Kjo do të jetë e rëndësishme më tej, kur do të përdorim funksione të aplikuara në lista.
data.table
Mund të merrni DT (?data.table::data.table) nga dataframe, lista, vektori ose matrica. Për shembull, kështu (in place).
Kodi
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
E dobishme është që, ashtu si dataframe, DT trashëgon cilësitë e listës.
DT dhe memorja
Ndryshe nga të gjitha objektet e tjera në R base, DT kalojnë përmes lidhjes. Nëse duhet të bëni kopjim në një hapësirë të re kufij, nevojitet funksioni data.table::copy ose nevojitet të bëni selektim nga objekti i vjetër.
Kodi
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Këtu përfundon hyrja. DT është një vazhdim i zhvillimit të strukturave të dhënave në R, të cilat ndodhin kryesisht përmes zgjerimit dhe përshpejtimit të operacioneve që kryhen mbi objektet e klasës data.frame. Këtu ruhet trashëgimia nga primitivet e tjera.
Disa shembuj të përdorimit të pronave data.table
Si një listë…
Të iterosh mbi rreshtat e data.frame ose DT nuk është ideja më e mirë, pasi kodi i ciklit në gjuhën R është shumë më i ngadalshëm C, ndërsa të kalosh nëpër kolona, të cilat zakonisht janë shumë më të pakta, është plotësisht e mundshme. Duke ecur përmes kolonave, kujtojmë se çdo kolonë është një element liste, që përmban, zakonisht, një vektor. Dhe operacionet mbi vektorët janë mirë të vektorizuara në funksionet bazë të gjuhës. Gjithashtu, mund të përdoren operatorë seleksioni, të veçantë për listat dhe vektorët: `[[`, `$`.
Kodi
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vektoriza
Nëse ka nevojë për të kaluar përmes rreshtave të një DT të madh, zgjidhja më e mirë do të ishte të shkruhet një funksion me vektorizim. Por nëse kjo nuk është e mundur, duhet të kujtojmë se cikli brenda DT është gjithsesi më i shpejtë se cikli në R, pasi ekzekutohet në C.
Le të provojmë në një shembull më të madh me 100K rreshta. Do të nxjerrim shkronjën e parë nga fjalët, që përfshihen në kolonën vektor w.
Përditësuar
Kodi
library(magrittr)
library(microbenchmark)

## Shembuj më të mëdhenj ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vektorizimi

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# i dyti

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# i tretë

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Prova e parë me iterim mbi rreshtat:
Njësi: milisekonda
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
Rastër i dytë, ku vektorizimi bëhet përmes kthimit të listës në matricë dhe marrjes së elementeve në prerjen me indeksin 1 (kjo është vetë vektorizimi). Do të korrigjohem: vektorizimi në nivelin e funksionit strsplit, që di të pranojë një vektor si input. Duket se procedura e shndërrimit të listës në matricë është shumë më e rëndë se vetë vektorizimi, por në këtë rast është shumë më e shpejtë se varianti pa vektorizim.
Njësi: milisekonda
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Përshpejtimi në mesatare 3 herë.
Rast i tretë, ku është ndryshuar skema e shndërrimit në matricë.
Njësi: milisekonda
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Përshpejtimi në mesatare 13 herë.
Me këtë gjë duhet eksperimentuar, sa më shumë — aq më mirë do të jetë.
Një tjetër shembull me vektorizimin, ku gjithashtu ka tekst, por është më afër kushteve reale: gjatësi të ndryshme fjalësh, numër i ndryshëm fjalësh. Duhet të nxirren fjalët e para 3. Ja si:
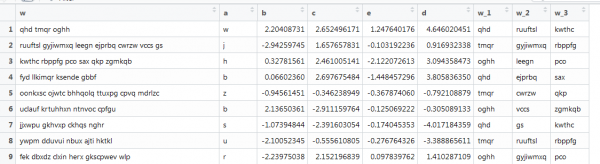
Këtu funksioni i mëparshëm nuk funksionon më, pasi vektorët kanë gjatësi të ndryshme, ndërsa ne kishim përcaktuar madhësinë e matricës. Do ta riparojmë këtë, duke kërkuar në internet.
Kodi
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Njësi: milisekonda
expr min lq mean median
{ dt[, `:=`((paste0("w_", 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Skedari funksionoi me një shpejtësi mesatare prej 1 sekonde. Jo keq.
Të lidhura me një zinxhir…
Me objektet DT mund të punosh duke përdorur chaining. Kjo duket si bashkim sintaksë brenda kllapave të djathta, në thelb, është një sheqer.
Kodi
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Përmes tubave…
Të njëjtat operacione mund të bëhen përmes piping, duket e ngjashme, por funksionalisht më e pasur, pasi mund të përdoren çdo metodë, jo vetëm DT. Do të nxjerrim koeficientët e regresionit logjistik për të dhënat tona sintetike me disa filtra në DT.
Kodi
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statistika, mësimi i makinës dhe gjëra të tjera brenda DT
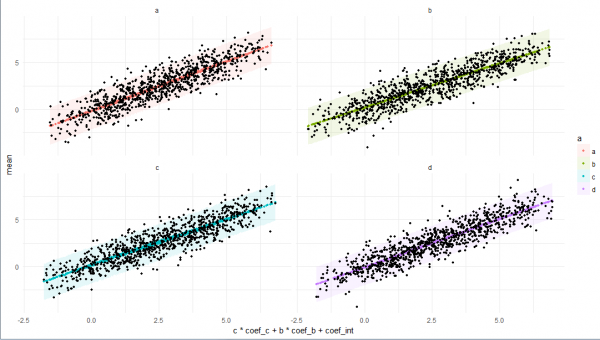
Mund të përdoren funksione lambda, por ndonjëherë është më mirë t'i krijosh ato veçmas, të shkruash të gjithë pipeline-in e analizës së të dhënave, dhe përpara — ato punojnë brenda DT. Shembulli është pasuruar me të gjitha veçoritë e lartpërmendura, plus disa gjëra të dobishme nga arsenali DT (të tilla si qasja në vetë DT brenda DT me lidhje, të vendosura ndonjëherë jo në radhë, por për të qenë).
Kodi
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Përfundim
Shpresoj se kam arritur të krijoj një pamje të plotë, por sigurisht jo të plotë, të një objekti si data.table, duke filluar nga pronat e tij të lidhura me trashëgiminë nga klasa R dhe duke përfunduar me karakteristikat e tij të veta dhe ambientin nga elementët tidyverse. Shpresoj se kjo do t'ju ndihmojë të studioni dhe aplikoni më mirë këtë bibliotekë për punë dhe argëtim.
Faleminderit!
Kodi i plotë
Kodi
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Burimi: habr.com
