

Përshëndetje të gjithëve. Më poshtë është një përmbledhje .
– një sistem monitorimi për sisteme dhe shërbime të ndryshme, përmes të cilit administratorët e sistemeve mund të mbledhin informacion mbi parametrat aktualë të sistemeve dhe të konfigurojnë njoftime për të marrë alarme në rast devijimesh në punën e sistemeve.
Në raport do të ketë krahasime dhe – projekte për ruajtjen afatgjatë të metrikave Prometheus.
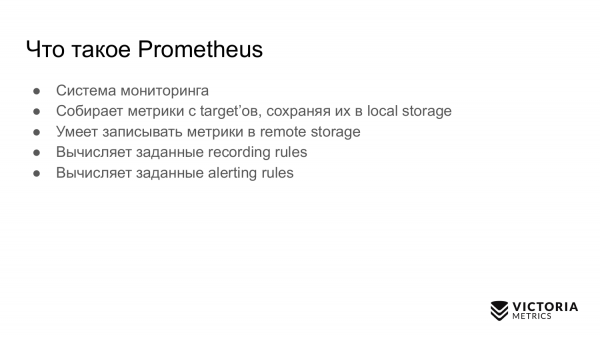
Së pari do të flas për Prometheus. Ky është një sistem monitorimi, i cili mbledh metrika nga target'ët e caktuar dhe i ruan ato në një ruajtje lokale. Prometheus di të regjistrojë metrika në një ruajtje të largët, di të gjenerojë alarme dhe rregulla regjistrimi.
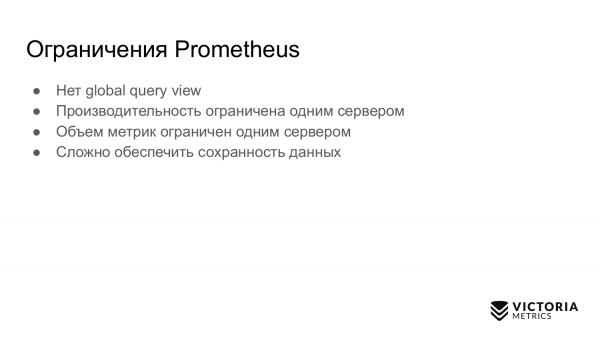
Kufizimet e Prometheus:
- Ai nuk ka pamje globale të kërkimit. Ky është rasti kur keni disa instance të pavarura të Prometheus. Ato mbledhin metrika. Dhe ju dëshironi të bëni një kërkesë mbi të gjitha këto metrika, të mbledhura nga instance të ndryshme të Prometheus. Prometheus nuk e lejon këtë.
- Performanca e Prometheus është e kufizuar vetëm në një server. Prometheus automatikisht nuk mund të shkallëzohet në disa servera. Ju vetëm mund të ndani manualisht target'ët tuaj midis disa Prometheus'ave.
- Vëllimi i metrikave në Prometheus është i kufizuar vetëm në një server për të njëjtën arsye, për të cilën ai automatikisht nuk mund të shkallëzohet në disa servera.
- Në Prometheus nuk është aq e lehtë të organizoni ruajtjen e të dhënave.
Zgjidhjet për këto probleme/çështje?
Zgjidhjet janë:
Të gjitha këto zgjidhje janë për ruajtjen e të dhënave të largëta, të mbledhura nga Prometheus. Ato zgjidhin problemin e ruajtjes së largët nga slide-i i mëparshëm në mënyra të ndryshme. Në këtë prezantim do të flas vetëm për dy zgjidhjet e para: dhe .
Për herë të parë informacioni mbi u shfaq në . Aty përshkruhet arkitektura dhe si funksionon.
Thanos merr të dhënat, të cilat Prometheus i ka ruajtur në diskun lokal, dhe i kopjon ato në S3, në ose në një ruajtje tjetër objekti.
Kështu, Thanos siguron pamjen globale të kërkimit. Ju mund të kërkoni të dhëna, të ruajtura në ruajtjen e objektit me disa instance të Prometheus.
Thanos mbështet PromQL dhe .
Thanos përdor kodin e Prometheus për ruajtjen e të dhënave.
Thanos zhvillohet nga të njëjtët zhvillues, që zhvillojnë edhe Prometheus.
Për . Ja , ku folëm për herë të parë për .
VictoriaMetrics merr të dhënat nga disa Prometheus përmes protokollit, të mbështetur nga Prometheus.
VictoriaMetrics ofron global query view, pasi disa instanca të Prometheus mund të shkruajnë të dhëna në një VictoriaMetrics. Prandaj, mund të bëni kërkesa mbi këto të dhëna.

VictoriaMetrics gjithashtu mbështet, ashtu si Thanos — PromQL dhe Prometheus querying API.
Në ndryshim nga Thanos, kodi burimor i VictoriaMetrics është shkruar nga e para dhe është optimizuar për shpejtësi dhe burime të konsumit.
VictoriaMetrics, ndryshe nga Thanos, shkallëzohet si verticalisht ashtu edhe horizontalisht. Ka , i cili shkallëzohet verticalisht. Mund të filloni me një procesor dhe 1 GB memorie dhe gradualisht të rriteni deri në qindra procesorë dhe 1TB memorie. VictoriaMetrics di të përdorë të gjitha këto burime. Performanca e saj do të rritet rreth 100 herë në krahasim me një sistem me 1 bërthamë.
Historia e Thanos filloi në nëntor 2017, kur u bë komiti i parë publik. Para kësaj, Thanos u zhvillua brenda kompanisë .
Në qershor 2019, pati një publikim të rëndësishëm 0.5.0, në të cilin gossip. E hoqëm atë nga Thanos, sepse tregoi se nuk funksiononte mirë. Shpesh, klasteri i Thanos nuk punonte siç duhej, node-t lidheshin gabim për shkak të protokollit gossip. Prandaj u vendos të hiqet nga aty. Mendoj se kjo është një vendim i drejtë.
Në të njëjtin qershor 2019, ata paraqitën aplikimin e numrit në .
Dhe pas disa muajsh Thanos u pranua në , e cila përfshin Prometheus, Kubernetes dhe projekte të tjera të njohura.
Në janar 2018, filloi zhvillimi i VictoriaMetrics.
Në shtator 2018 për herë të parë e përmenda publikisht VictoriaMetrics.
Në dhjetor 2018, u publikua versioni Single-node.
Në maj 2019 kode burimore si për versionin Single-node ashtu edhe për versionin klaster.
Në qershor 2019, ashtu si Thanos, ne dërguam një aplikim në CNCF foundation me numrin . Ne e dërguam aplikimin një ditë përpara se Thanos ta dërgonte atë.
Por, fatkeqësisht, ende nuk na kanë pranuar atje. Ne kemi nevojë për ndihmën e komunitetit.
Le të shqyrtojmë slidet më të rëndësishme, të cilat tregojnë arkitekturën e Thanos dhe VictoriaMetrics.
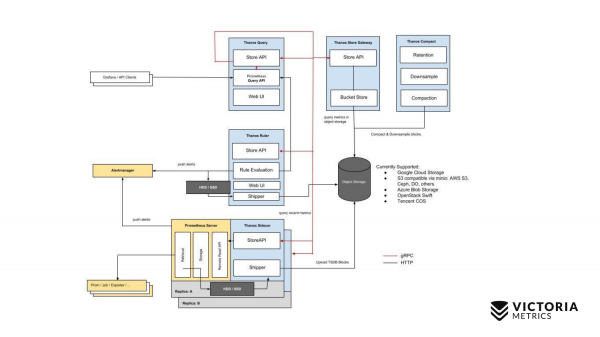
Le të fillojmë me Thanos. Komponentët e verdhë janë komponentët e Prometheus. Gjithçka tjetër është komponentë të Thanos. Le të fillojmë me komponentin më të rëndësishëm. Thanos Sidecar — është komponent që instalon përkrah çdo Prometheus. Ai merret me ngarkimin e të dhënave të Prometheus nga storage lokal në S3 ose në një Object Storage tjetër.
Kaftë edhe një komponent, si Thanos Store Gateway, i cili di të lexojë këto të dhëna nga Object Storage në kërkesat e ardhshme nga Thanos Query. Thanos Query implementon PromQL dhe Prometheus API. Pra, nga jashtë ai duket si Prometheus. Prisni kërkesat PromQL, i dërgon ato në Thanos Store Gateway, Thanos Store Gateway nxjerr të dhënat e nevojshme nga Object Storage dhe i dërgon ato prapa.
Por ne në Object Storage ruajmë të dhëna pa dy orët e fundit për shkak të veçorive të implementimit të Thanos Sidecar, i cili nuk mund të ngarkojë dy orët e fundit në Object Storage S3, pasi për këto dy orë Prometheus ende nuk ka krijuar skedarët në ruajtjen lokale.
Si e zgjidhëm këtë? Thanos Query, përveç se dërgon kërkesa në Thanos Store Gateway, dërgon paralelisht kërkesa në çdo Thanos Sidecar, i cili ndodhet afër Prometheus.
Dhe Thanos Sidecar, nga ana e tij, proksionon kërkesat më tej në Prometheus dhe shkarkon të dhënat për dy orët e fundit.
Përveç këtyre komponentëve, ka gjithashtu një komponent opsional, pa të cilin Thanos do të ndjehet keq. Ky është Thanos Compact, i cili merret me bashkimin e skedave të vegjël në Object Storage në skeda më të mëdha, të cilat janë ngarkuar këtu nga Thanos Sidecar. Thanos Sidecar ngarkon aty skedarët me të dhëna për dy orë. Këto skedarë, nëse nuk bashkohen në skedarë më të mëdhenj, mund të rriten shumë në numër. Sa më shumë të tillë skedarë, aq më shumë memorie nevojitet për Thanos Store Gateway, aq më shumë burime janë të nevojshme për transferimin e të dhënave përmes rrjetit, të metadantave. Funksionimi i Thanos Store Gateway bëhet i papërshtatshëm. Prandaj, është e domosdoshme të aktivizohet Thanos Compact, i cili bashkon skedarët e vegjël në më të mëdhenj, për të reduktuar numrin e skedarëve dhe për të zvogëluar overhead-in në Thanos Store Gateway.
Ka gjithashtu një komponent si Thanos Ruler. Ai realizon rregullat e alertimit të Prometheus dhe mund të llogarisë rregullat e regjistrimit të Prometheus, për të regjistruar përsëri të dhënat në Object Storage. Por ky komponent nuk rekomandohet për t'u përdorur, pasi ai .
Kjo është një skemë e thjeshtë e Thanos.
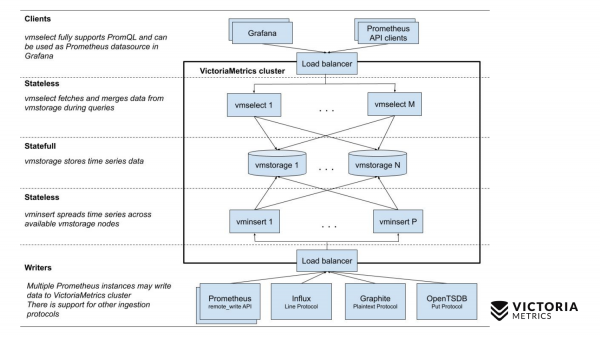
Tani, le të krahasojmë me skemën e VictoriaMetrics.
VictoriaMetrics ka 2 versione: Single-node dhe versione klustër. Single-node funksionon në një kompjuter. Në Single-node nuk ka këto komponentë, thjesht një binar. Ky binar në slajd duket si ky katror. Të gjitha ato që ndodhen brenda katrorit janë përmbajtja e skedarit binar të versionit Single-node. Nuk është e nevojshme të dini për të. Thjesht e aktivizoni binarin — dhe gjithçka funksionon.
Versioni e klasterëve është më e komplikuar. Brenda saj ndodhen tre komponentë të ndryshëm: vmselect, vminsert dhe vmstorage. Nga emrat e tyre duhet të bëhet e qartë se çfarë bën secili prej tyre. Komponenti Insert pranon të dhëna në formate të ndryshme: nga Prometheus remote write API, protokolli Influx line, protokolli Graphite dhe nga protokolli OpenTSDB. Komponenti Insert i pranon, i parse dhe i shpërndan mes komponentëve storage të disponueshëm, ku të dhënat ruhet tashmë. Komponenti Select, nga ana tjetër, pranon kërkesat PromQL. Ai realizon , si dhe API-në e kërkimeve të Prometheus, dhe ai mund të përdoret si një zëvendësim i Prometheus në Grafana ose në klientët e tjerë të API-së së Prometheus. Select pranon një kërkesë promql, e parse atë, lexon të dhënat e nevojshme për ekzekutimin e kësaj kërkese nga nodet storage, i proceson këto të dhëna dhe kthen përgjigjen.
Le të krahasojmë kompleksitetin e instalimit të Thanos dhe VictoriaMetrics.
Të fillojmë me Thanos. Para se të filloni të punoni me Thanos, duhet të krijoni një bucket në Object Storage, si S3 ose GCS, që Thanos Sidecar të mund të shkruajë të dhëna atje.
Pas kësaj, për çdo Prometheus duhet të instaloni Thanos Sidecar. Para kësaj, mos harroni të çaktivizoni kompresimin e të dhënave në Prometheus. Kompresimi i të dhënave përkohësisht kompreson të dhënat në magazinën lokale të Prometheus për të zvogëluar konsumimin e burimeve.
Kur instaloni Thanos Sidecar në Prometheusing tuaj, duhet të çaktivizoni këtë kompresim të të dhënave, sepse Thanos Sidecar nuk mund të funksionojë siç duhet kur kompresimi i të dhënave është i aktivizuar. Kjo do të thotë se Prometheus-i juaj fillon të ruajë të dhënat në blloqe nga dy orë dhe ndalon bashkimin e këtyre blloqeve në më të mëdha. Prandaj, nëse bëni kërkesa që tejkalojnë kohëzgjatjen e dy orëve të fundit, ato do të funksionojnë më pak efikas, krahasuar me si do të funksiononin nëse do të ishte aktivizuar kompresimi i të dhënave.
Prandaj, Thanos rekomandon të zvogëloni kohëzgjatjen e ruajtjes së të dhënave në magazinën lokale në 6-8 orë, për të reduktuar këtë overhead të shumë blloqeve të vogla.
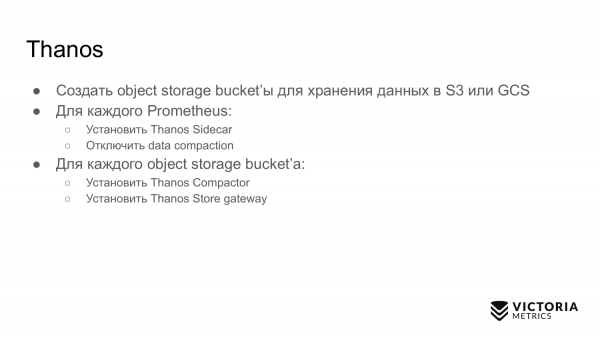
Pas instalimit të Thanos Sidecar, për çdo Object Storage Bucket duhet të instaloni dy komponentë. Këta janë Thanos Compactor dhe Thanos Store Gateway.
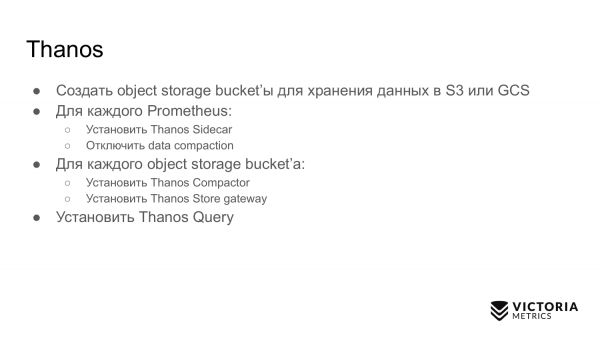
Pas kësaj, duhet të instaloni Thanos Query dhe ta konfiguroni atë që të mund të lidhet me të gjitha Thanos Store Gateway që keni, si dhe të mund të lidhet me të gjithë Thanos Sidecar.
Këtu mund të ketë një problem të vogël.
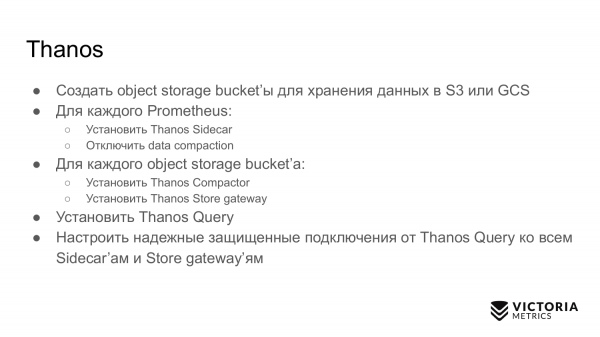
Ju duhet të konfiguroni një lidhje të besueshme dhe të sigurt nga Thanos Query në këto componente. Dhe nëse keni Prometheus në qendra të ndryshme të të dhënave, ose në VPC të ndryshme, atëherë lidhjet nga jashtë janë të ndaluara. Por për të punuar me Thanos Query, ju nevojitet ndonjë mënyrë për të konfiguruar lidhjen atje, dhe duhet të gjeni një zgjidhje.
Nëse keni shumë nga këto qendra të të dhënash, atëherë, natyrisht, besueshmëria e gjithë sistemit zvogëlohet. Sepse Thanos Query duhet të mbajë lidhjet me të gjitha Thanos Sidecar, të vendosura në qendra të ndryshme të të dhënave. Me çdo kërkesë që hyn, ai do të drejtojë kërkesat në të gjitha Thanos Sidecar. Nëse lidhja pritet, do të merrni ose një grup të papërfunduar të të dhënave, ose një përgjigje "klastri nuk funksionon".
Në VictoriaMetrics, gjithçka është pak më e thjeshtë. Për versionin me një nyjë, mjafton të nisni një binar dhe gjithçka funksionon.
Në versionin me klaster, mjafton të nisni tri llojet e përmendura më lart të komponenteve në çdo numër të nevojshëm, ose të përdorni për automatikën e nisjes së komponenteve në Kubernetes. Ne kemi planifikuar gjithashtu të krijojmë një operator Kubernetes. Helm chart nuk mbulon disa raste dhe ju lejon të qëlloni veten në këmbë. Për shembull, ai lejon të zvogëloni numrin e nyjeve të ruajtjes, çka do të çojë në humbjen e të dhënave.
Pas nisjes së një binari ose versionit me klaster, mjafton të shtoni në konfigurimin e Prometheus , në mënyrë që ai të fillojë të regjistrojë të dhënat paralelisht në ruajtjen lokale dhe në ruajtjen e largët. Siç e keni vënë re, një konfigurim i tillë duhet të funksionojë shumë më me besueshmëri krahasuar me konfigurimin e Thanos. Ne nuk duhet të mbajmë lidhjen nga VictoriaMetrics me të gjitha Prometheus, sepse Prometheus vetë lidhen me VictoriaMetrics dhe transferojnë të dhënat.
Le të shqyrtojmë mbështetje për Thanos dhe VictoriaMetrics.
Thanos duhet të monitorojë Sidecar-in, që ata të mos ndalojnë ngarkimin e të dhënave në Object Storage. Ata mund ta ndalin këtë ngarkim të dhënash për shkak të gabimeve të ngarkimit, për shembull nëse keni një ndërprerje të përkohshme të lidhjes rrjetore me Object Storage, ose Object Storage është përkohësisht i papërshtatshëm. Thanos Sidecar në atë moment do ta vërejë këtë, do ta njoftojë për gabimin, mund të bie dhe pas kësaj do të ndalojë së funksionuari. Nëse nuk e monitoroni atë, të dhënat do të ndalojnë së kaluar në Object Storage. Nëse kalon koha e retention (6-8 orë e rekomanduar), ju do të humbni të dhënat që nuk arritën në Object Storage.
Thanos compactorët mund të ndalojnë së funksionuari për shkak të . Compactorët marrin të dhënat nga Object Storage dhe i bashkojnë ato në copa më të mëdha të të dhënave. Duke qenë se compactorët nuk janë sinqagzuar me Sidecar-at, mund të ndodhin këto: Sidecar nuk ka përfunduar akoma të shkruajë bllokun, Compactor-i vendos se ky bllok është plotësisht i shkruar. Compactor-i fillon ta lexojë atë. Ai e lexon bllokun jo në një formë të plotë dhe ndalon së funksionuari. Shih detajet .
Store Gateway mund të japë të dhëna jo konsistente për shkak të konflikteve mes Compactor-it dhe Sidecar-ave. Këtu ndodh e njëjta gjë, sepse Store Gateway nuk është sinqagzuar me Compactor-ët dhe Sidecar-ët. Për rrjedhojë, mund të ndodhin gjendje konflikti, ku Store Gateway nuk sheh një pjesë të të dhënave, ose sheh të dhëna shtesë.
Komponenti Query në Thanos në mënyrë të paracaktuar jep rezultate parciale, nëse disa Sidecar-ë ose Store Gateway nuk janë të disponueshme në atë moment. Ju do të merrni një pjesë të dhënash, dhe madje nuk do ta dini që nuk keni marrë të gjitha të dhënat. Kështu funksionon ai me përparësi. Në një situatë të ngjashme, VictoriaMetrics kthen të dhënat e shenuara si parciale.
Në kundërshtim me Thanos, VictoriaMetrics rrallë humb të dhëna. Edhe nëse lidhja nga Prometheus në VictoriaMetrics është ndalur, nuk është problem, sepse Prometheus vazhdon të regjistrojë të dhënat e reja që vijnë në Write Ahead Log, i cili ka një madhësi prej 2 orësh. Nëse brenda dy orëve riktheni lidhjen me VictoriaMetrics, të dhënat nuk do të humbasin. Prometheus .
Ndryshe nga Thanos, i cili regjistron të dhënat në object storage vetëm pas dy orësh, Prometheus automatikisht riplikon të dhënat përmes protokollit remote write në remote storage, siç është VictoriaMetrics. Nuk keni frikë nga humbja e local storage në Prometheus. Nëse ndodhin të humbasë local storage, në rastin më të keq do të humbni vetëm të dhënat e fundit të sekondave, që nuk arritën të regjistroheshin në remote storage.
Kubernetes automatikisht menaxhon klorin e saj, ndryshe nga Thanos. Të gjitha komponentët e Thanos janë të komplikuar për t'u vendosur në një Kubernetes cluster, ndryshe nga komponentët e klastrit VictoriaMetrics.
VictoriaMetrics ka një përditësim shumë të thjeshtë në versionin e ri. Thjesht ndalni VictoriaMetrics, përditësoni binaret dhe rifilloni. Kur ndaloni përmes sinjalit SIGINT, të gjitha binaret e VictoriaMetrics bëjnë një gracefull shutdown. Ato ruajnë saktësisht të dhënat e nevojshme, mbyllin saktësisht lidhjet hyrëse për të mos humbur asgjë. Prandaj, nuk do të humbni asgjë gjatë përditësimit.
Me VictoriaMetrics është shumë e thjeshtë të zgjerohet klori. Thjesht shtoni komponentët e nevojshëm dhe vazhdoni të punoni.
Për pengesat në Thanos dhe VictoriaMetrics.
Thanos ka këto pengesa. Prometheus duhet të ruajë të dhënat për dy orët e fundit. Nëse ato humbasin, do t'i humbni plotësisht, pasi ato nuk kanë arritur ende të regjistrohen në Object Storage, si S3.
Komponenti Store Gateway dhe komponenti compactori mund të kërkojnë shumë memorie për të punuar me një Object Storage të madh, nëse atje ruhet shumë skedarë të vegjël. Sa më shumë të jenë numri dhe volumi i skedarëve, aq më shumë kërkohet memorie operative nga Store Gateway dhe compactori për të ruajtur metainformacionin. Thanos ka shumë probleme në lidhje me këtë. .
Thanos reklamohet se mund të skalohet pafundësisht me numrin e Prometheus tuaj. Në të vërtetë, kjo nuk është e vërtetë. Sepse të gjitha kërkesat kalojnë përmes komponenti Query, i cili duhet të pyet në mënyrë paralele të gjithë komponentët e Store Gateway dhe të gjithë komponentët e Sidecar, të nxjerrë të dhënat atje dhe pastaj t'i përpunojë ato. Sidomos, shpejtësia e kërkesave është e kufizuar nga pika më e dobët, Store Gateway më i ngadalshëm ose Sidecar më i ngadalshëm.
Këto komponentë mund të jenë të ngarkuara në mënyrë uniforme. Për shembull, keni një Prometheus që mbledh miliona metrika në sekondë. Dhe ka një Prometheus, në të cilin mblidhen mijëra metrika në sekondë. Prometheus që mbledh miliona metrika në sekondë ngarkon shumë më tepër serverin, mbi të cilin funksionon. Për rrjedhojë, Sidecar atje funksionon më ngadalë. Dhe në përgjithësi, gjithçka aty punon ngadalë. Komponenti Query do të nxjerrë të dhëna shumë ngadalë nga aty. Për rrjedhojë, performanca e tërë klasterit tuaj do të jetë e kufizuar nga ky Sidecar i ngadaltë.
Në parazgjedhje, Thanos ofron të dhëna të pjesshme nëse disa Sidecar dhe ose Store Gateway nuk janë në dispozicion. Për shembull, nëse keni Sidecar të shpërndara në të gjithë botën në qendra të ndryshme të të dhënave, probabiliteti i lidhjeve të prishura dhe i papasqyrimeve të komponenteve rritet ndjeshëm. Si rrjedhojë, në shumicën e rasteve do të merrni të dhëna të pjesshme, pa e ditur këtë.
VictoriaMetrics gjithashtu ka kapërcime të fshehura. Kapërcimi i parë është opsioni që kufizon sasinë e memories operative të përdorur nga cache VictoriaMetrics. Në parazgjedhje, ai është 60% e memories operative në pajisjen ku është e instaluar VictoriaMetrics ose 60% e RAM-it të pods-ve të VictoriaMetrics në Kubernetes.
Nëse ndërroni këtë vlerë në mënyrë të gabuar, mund të dëmtoni performancën e VictoriaMetrics. Për shembull, nëse vendosni një vlerë shumë të ulët, të dhënat mund të mos kenë hapësirë në cache-in e VictoriaMetrics. Kjo do ta bëjë atë të kryejë punë të tepërt dhe të ngarkojë procesorin me skedarin. Nëse e vendosni këtë opsion shumë të lartë, kjo rrit, së pari, probabilitetin që VictoriaMetrics të dështojë me gabimin e out of memory, dhe së dyti, do të sjellë nënkuptimin që sistemi operativ do të ketë shumë pak memorie operative për cache-in e skedarëve. Dhe VictoriaMetrics mbështetet në cache-in e skedarëve për performancën. Nëse është e pamjaftueshme, ngarkesa mbi disk mund të rritet ndjeshëm. Pra, këshilla është: mos e ndryshoni parametrin pa nevojë të madhe.
Opsioni i dytë. Ky është retentionPeriod — periudha që në parazgjedhje është e vendosur në 1 muaj. Ky është koha gjatë së cilës VictoriaMetrics ruan të dhënat. Pas përfundimit të kësaj periudhe, VictoriaMetrics i fshin të dhënat.
Shumë përdorues e fillojnë VictoriaMetrics pa këtë parametr, regjistrojnë të dhëna për një muaj. Pastaj pyesin: pse të dhënat humbën për muajin e kaluar? Sepse retentionPeriod në mënyrë të paracaktuar është 1 muaj. Prandaj, duhet të dini dhe të përcaktoni një retentionPeriod të saktë.
Le të kalojmë në mundësitë unike.
Thanos ka një veçori, siç është downsampling: intervale 5-minutëshe dhe njëorëshe, të cilat shpesh . Nëse e kërkoni në Google dhe shikoni çështjet e tyre në GitHub, ka shumë probleme që lidhen me këtë downsampling, se ai ndonjëherë nuk funksionon siç pritet, ose nuk funksionon ashtu siç e presin përdoruesit.
Thanos ofron deduplikimin e të dhënave për çiftet HA të Prometheus. Kur dy Prometheus regjistrojnë të njëjtat metrika nga të njëjtat target-e dhe Thanos i bashkon ato në Object Storage. Thanos di të deduplikojë saktësisht këto të dhëna, në ndryshim nga VictoriaMetrics.
Thanos ka komponentin e alarmit, i cili ishte në skemën Thanos. Por .
Avantazhi i Thanos është se kodi i Thanos dhe Prometheus është i përbashkët. Thanos dhe Prometheus janë zhvilluar nga e njëjta ekip zhvilluesish. Kur përmirësohet Thanos, ose Prometheus fiton edhe pala tjetër.
Veçoria kryesore e VictoriaMetrics është MetricsQL. Kjo është një zgjerim i VictoriaMetrics për PromQL, për të cilat folëm në takimin e mëparshëm të madhe për monitorim.
VictoriaMetrics mbështet ngarkimin e të dhënave përmes shumë protokollesh të ndryshme. VictoriaMetrics jo vetëm që mund të pranojë të dhëna nga Prometheus, por gjithashtu përmes protokolleve Influx, OpenTSDB dhe Graphite.
Të dhënat e VictoriaMetrics zakonisht zënë shumë më pak hapësirë krahasuar me Thanos dhe Prometheus.
Nëse regjistrohen të dhëna reale, përdoruesit flasin për një reduktim të madhësisë së të dhënave në disk nga 2-5 herë krahasuar me Prometheus dhe Thanos.
Një avantazh tjetër i VictoriaMetrics është se ajo është e optimizuar për shpejtësi.
Le të kalojmë në kostot e infrastrukturës.
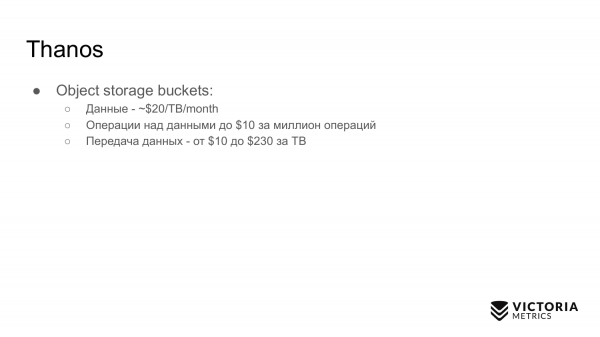
Një nga avantazhet e Thanos është se ai ruan të dhënat në object storage, i cili është relativisht i lirë.
Kur ruani të dhëna në object storage, ju duhet të paguani për operacionet e regjistrimit dhe leximin e të dhënave ($10 për milion operacione). Kur regjistroni të dhëna në object storage, ju paguani për shpenzimet e hostit tuaj për ngarkimin e të dhënave në internet, nëse klusteri juaj nuk ndodhet në AWS — atje është falas. Kur lexoni të dhëna, ju paguani nga $10 deri në $230 për 1TB. Kjo mund të jetë e rëndësishme, nëse shpesh kërkoni të dhëna historike nga klusteri Thanos.
Për klasterin Thanos, nevojiten serverë për komponentët Compact, Store Gateway, dhe Query, të cilët kërkojnë shumë memorje dhe CPU për volume të mëdha të dhënash.
Shpenzimet për VictoriaMetrics janë kështu. Nëse ruani të dhënat në diskët GCE HDD, del $40 për 1TB. Për VictoriaMetrics mjaftojnë diskët e zakonshëm HDD, nuk nevojiten SSD që kushtojnë pesë herë më shumë. VictoriaMetrics është optimizuar për HDD.
Për VictoriaMetrics nevojiten serverë për komponentët: ose Single-node ose për komponentët e klasterit, të cilët, ndryshe nga komponentët Thanos, kërkojnë shumë më pak CPU dhe RAM — prandaj do të jetë më e lirë.
Shembuj të zbatimit.
Një shembull zbatimi për Thanos është Gitlab. Gitlab funksionon plotësisht mbi Thanos. Por, nuk është gjithçka aq e lehtë. Nëse shikoni në , do të shihni se ata përballen vazhdimisht me ndonjë : u mungon memorja për komponentët Store Gateway ose Query. Ata duhet të rrisin vazhdimisht kapacitetin e memorjes.
Për këtë arsye, shpenzimet për zgjidhjen e këtyre problemeve rriten.
Zbatimi i dytë, i cili mund të jetë më i suksesshëm — është kompania Improbable, e cila filloi zhvillimin e Thanos. Ata publikuan kodin burimor të Thanos. Improbable — një kompani që merret me zhvillimin e motorëve të lojërave.
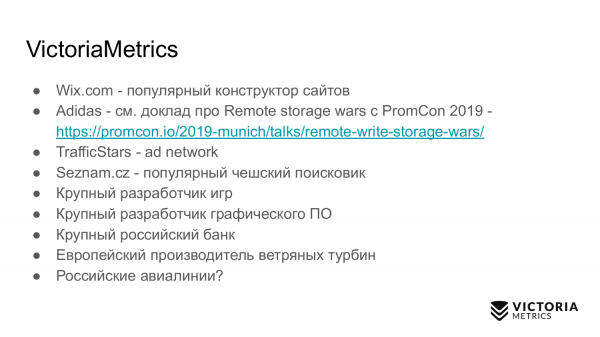
Shembuj publik të zbatimit të VictoriaMetrics janë:
- wix.com ndihmës për ndërtimin e faqeve
- Adidas po përdor VictoriaMetrics dhe madje bëri një prezantim në PromCon 2019 të fundit
- TrafficStars — rrjet reklamash
- Seznam.cz — një motor kërkimi popullor çek.
Më pas, ka kompani pa emër që nuk mund t'i përmend tani. Ata nuk e dhanë lejen.
- Një zhvillues i madh lojërash. Më i madh se ata të Improbable.
- Një zhvillues i madh i softuerit grafik.
- Një bankë e madhe ruse.
- Një prodhues evropian i turbinave me erë, i cili testoi me sukses VictoriaMetrics. Ky prodhues e zbaton VictoriaMetrics për monitorimin e të dhënave të marra nga turbinat me erë me një shpejtësi prej 50 mostrash në sekondë për secilën sensor. Në secilën turbinë ka disa qindra sensorë. Ata kanë disa qindra turbina me erë.
- Kompania ajrore ruse, e cila dëshiron të zbatojë VictoriaMetrics, por ende nuk po ia del. Ne jemi në fazën e kontratës me ta.
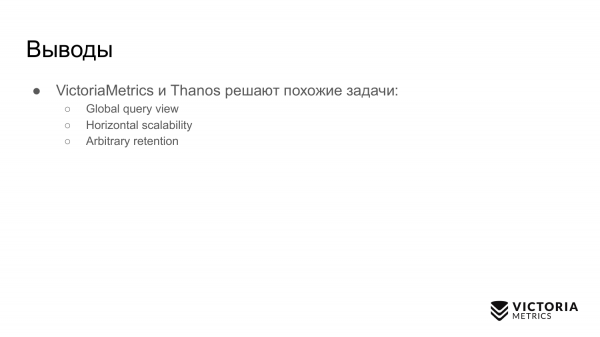 Përfundime.
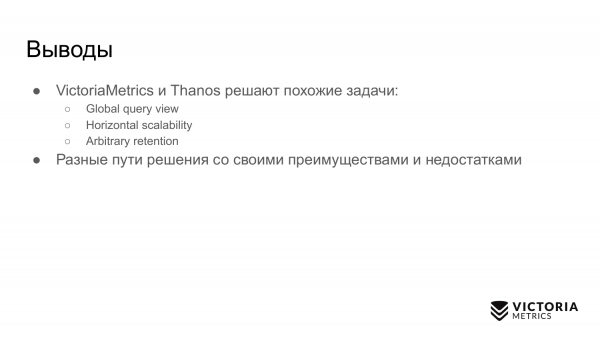
VictoriaMetrics dhe Thanos zgjidhin probleme të ngjashme, por me mënyra të ndryshme:
- Pamja globale e pyetjeve
- shkallëzimi horizontal
- ruajtje e rastësishme
Faleminderit.
Ju presim në .
Vetëm përdoruesit e regjistruar mund të marrin pjesë në anketë. , ju lutem.
Çfarë përdorni si ruajtje afatgjatë për Prometheus?
35,3%Thanos6
0,0%Cortex0
0,0%M3DB0
41,2%VictoriaMetrics7
23,5%tjetër4
17 përdorues kanë votuar. 16 përdorues janë abstenuar.
Burimi: habr.com
