

Zabbix është një sistem monitorimi. Si çdo sistem tjetër, ai përballet me tre probleme kryesore të çdo sistemi monitorimi: mbledhjen dhe përpunimin e të dhënave, ruajtjen e historisë dhe pastrimin e saj.
Etapet e marrjes, përpunimit dhe regjistrimit të të dhënave marrin kohë. Pak, por për një sistem të madh, kjo mund të rezultojë në vonesa të mëdha. Problemi i ruajtjes është një çështje e qasjes në të dhëna. Ato përdoren për raportet, verifikimet dhe trigger-at. Vonesat në qasjen në të dhëna gjithashtu ndikojnë në performancë. Kur DB-të rriten, të dhënat joaktuale duhet të fshihen. Fshirja është një operacion i rëndë, i cili gjithashtu konsumon një pjesë të burimeve.
Problemet e vonesave gjatë mbledhjes dhe ruajtjes në Zabbix zgjidhen me ndihmën e caching: disa lloje cache, caching në DB. Për të zgjidhur problemin e tretë, caching nuk është i përshtatshëm, prandaj në Zabbix është përdorur TimescaleDB. Për këtë do të flasë Andrei Gushchin — inxhinier i mbështetjes teknike . Andrei ka më shumë se 6 vite në mbështetje të Zabbix dhe përballët drejtpërdrejt me performancën.
Si funksionon TimescaleDB, çfarë performancë mund të japë krahasuar me PostgreSQL-në e zakonshme? Cila është roli i Zabbix për DB-në e TimescaleDB? Si të fillosh nga fillimi dhe si të migrosh nga PostgreSQL dhe cilat janë konfigurimet më të mira për performancë? Për gjithë këtë më poshtë.

Sfidat e Performancës
Çdo sistem monitorimi përballet me sfida të caktuara të performancës. Unë do të flas për tre prej tyre: mbledhja dhe përpunimi i të dhënave, ruajtja, pastrimi i historisë.
Mbledhja dhe përpunimi i të dhënave të shpejta. Një sistem i mirë monitorimi duhet të marrë të dhënat e gjitha dhe t'i përpunojë ato sipas shprehjeve trigger — sipas kritereve të tij. Pas përpunimit, sistemi duhet gjithashtu ta ruajë shpejt këto të dhëna në DB, në mënyrë që të përdoren më vonë.
Ruajtja e historisë. Një sistem i mirë monitorimi duhet të ruajë historinë në DB dhe të ofrojë qasje të lehtë në metrika. Historia është e nevojshme për ta përdorur atë në raporte, grafikë, trigger-a, vlera prag dhe elementë të dhënash të llogaritur për njoftime.
Pastrimi i historisë. Ndonjëherë vjen një ditë kur nuk keni nevojë të mbani metrikat. Pse ju nevojiten të dhëna të mbledhura 5 vite më parë, një muaj apo dy: disa nyje janë fshirë, disa hoste apo metrika tashmë s’kanë nevojë, sepse janë vjetruar dhe kanë pushuar së u mbledhur. Një sistem monitorimi i mirë duhet të ruajë të dhëna historike dhe kohë pas kohe t'i fshijë ato, për të mos e mbingarkuar bazën e të dhënave.
Pastrimi i të dhënave të vjetruara është një çështje e ndjeshme, që ndikon shumë në performancën e bazës së të dhënave.
Keshimi në Zabbix
Në Zabbix, thirrjet e para dhe të dyta zgjidhen me anë të keshimit. Për mbledhjen dhe përpunimin e të dhënave përdoret memoria operative. Për ruajtje — historitë në triggera, grafika dhe elemente të dhënash të llogaritura. Në anën e Bazës së të Dhënave ka një keshim të caktuar për zgjedhjet kryesore, për shembull, grafikat.
Keshimi në anën e vetë serverit Zabbix është:
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Le të flasim për to në detaje.
ConfigurationCache
Ky është keshimi kryesor, ku ruhen metrikat, hostet, elementet e të dhënave, triggerat — gjithçka që nevojitet për Parapërpunimin dhe mbledhjen e të dhënave.
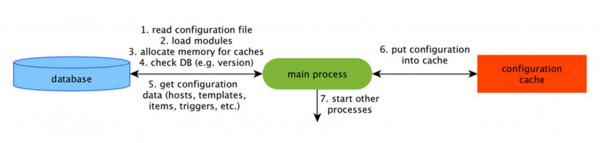
Të gjitha këto ruhen në ConfigurationCache, për të mos krijuar kërkesa të panevojshme në Bazën e të Dhënave. Pas nisjes së serverit, ne përditësojmë këtë kesh, krijojmë dhe përditësojmë periodikisht konfigurimet.
Grumbullimi i të dhënave
Schema është mjaft e madhe, por e rëndësishme është mbledhësit. Këta janë procese të ndryshme mbledhjeje. Ata janë përgjegjës për lloje të ndryshme mbledhjeje: mbledhin të dhëna nëpërmjet SNMP, IPMI dhe i dërgojnë ato në Parapërpunim.
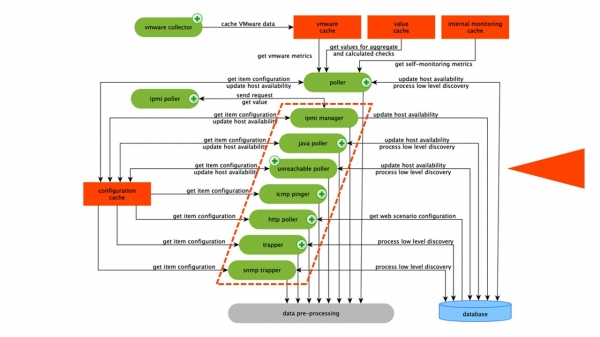 Mbledhësit janë të përshkuar me një vijë portokalli.
Në Zabbix ka elemente të dhënash të llogaritura agregat, që nevojiten për të agreguar kontrollet. Nëse i kemi, i marrim të dhënat për to drejtpërdrejt nga ValueCache.
PreProcessing HistoryCache
Të gjithë mbledhësit përdorin ConfigurationCache për të marrë detyra. Më pas, ata i dërgojnë ato në Parapërpunim.
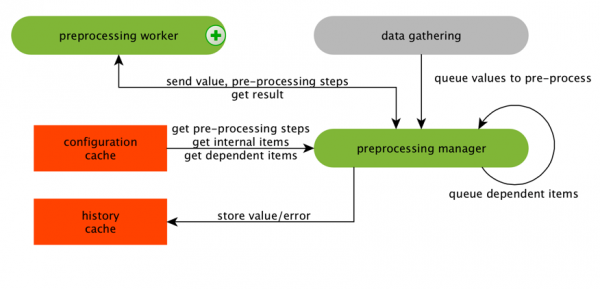
Parapërpunimi përdor ConfigurationCache për të marrë hapat e Parapërpunimit. Ai i përpunon këto të dhëna në mënyra të ndryshme.
Pas përpunimit të të dhënave me ndihmën e Parapërpunimit, i ruajmë ato në HistoryCache për t’i përpunuar. Këtu përfundon mbledhja e të dhënave dhe kalojmë në procesin kryesor në Zabbix — history syncer, pasi kjo është një arkitekturë monolite.
Shënim: Parapërpunimi është një operacion mjaft i rëndë. Me versionin 4.2 është nxjerrë në proxy. Nëse keni një Zabbix shumë të madh me shumë elemente të dhënash dhe frekuencë mbledhjeje, kjo shumë lehtëson punën.
ValueCache, cache për histori & tendenca
History syncer është procesi kryesor që përpunon çdo element të dhënash në mënyrë atomike, domethënë çdo vlerë.
History syncer merr vlerat nga HistoryCache dhe kontrollon në Configuration nëse ka shkaktarë për llogaritjet. Nëse ka, ai i llogarit.
History syncer krijon një ngjarje, një eskalim, për të krijuar njoftime, nëse kërkohet sipas konfigurimit, dhe e regjistron. Nëse ka shkaktarë për përpunim të mëtejshëm, ajo vlerë e ruan në ValueCache, në mënyrë që të mos shkonte në tabelën e historisë. Kështu ValueCache mbushet me të dhëna të nevojshme për llogaritjen e shkaktarëve dhe elementeve të llogaritura.
History syncer regjistron të gjitha të dhënat në DB, dhe ajo — në disk. Procesi i përpunimit përfundon këtu.
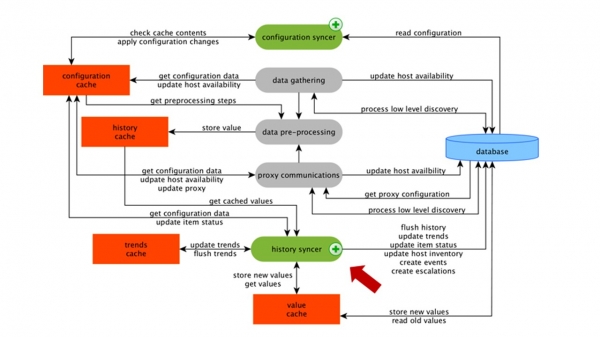
Keshimi në DB
Në anën e DB-së ka cache të ndryshme kur dëshiron të shikosh grafikat ose raportet mbi ngjarjet:
Innodb_buffer_poolnë anën e MySQL;shared_buffersnë anën e PostgreSQL;effective_cache_sizenë anën e Oracle;shared_poolnë anën e DB2.
Ka shumë caches të tjera, por këto janë kryesore për të gjitha DB-të. Ato lejojnë që të mbash të dhënat në memorie që shpesh nevojiten për kërkesa. Ato kanë teknologji të veta për këtë.
Performanca e DB-së është kritike
Zabbix serveri vazhdimisht mbledh të dhëna dhe i regjistron ato. Kur rivendoset, ai gjithashtu lexon nga historia për të mbushur ValueCache. Skriptet dhe raportet përdorin Zabbix API, i cili është ndërtuar mbi bazën e ndërfaqes Web. Zabbix API i qaset bazës së të dhënave dhe merr të dhënat e nevojshme për grafikët, raportet, listat e ngjarjeve dhe problemet më të fundit.
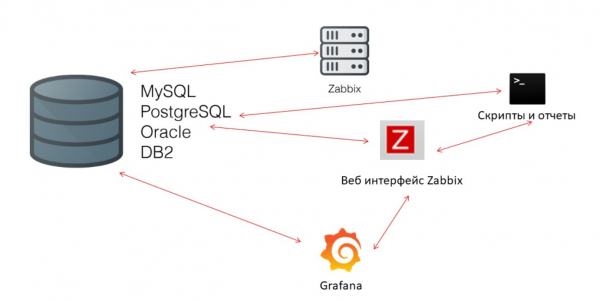
Për vizualizimin — Nëse tashmë e dini se çfarë është analiza e grupeve dhe se si ta bëni në SQL, kaloni menjëherë në seksionin e fundit.. Ndër përdoruesit tanë, ky është një zgjidhje popullore. Ai di të dërgojë direkt kërkesa përmes Zabbix API në DB dhe krijon një konkurrencë të caktuar për marrjen e të dhënave. Prandaj nevojitet një konfigurim më i hollësishëm dhe më i mirë i DB-së për t'iu përgjigjur shpejt rezultatëve dhe testimeve.
Housekeeper
Thirrja e tretë e performancës në Zabbix është pastrimi i historisë me anë të Housekeeper. Ai respekton të gjitha konfigurimet — në elementët e të dhënave është treguar se sa të ruhet dinamika e ndryshimeve (trendët) në ditë.
TrendsCache llogaritet në fluks. Kur vijnë të dhënat, ne i agregojmë ato për një orë dhe i regjistrojmë në tabelat për dinamiken e ndryshimeve të trendëve.
Housekeeper aktivizohet dhe fshin informacionin nga DB me "selects" të zakonshme. Kjo nuk është gjithmonë efektive, gjë që mund të kuptohet nga grafikët e performancës së proceseve të brendshme.
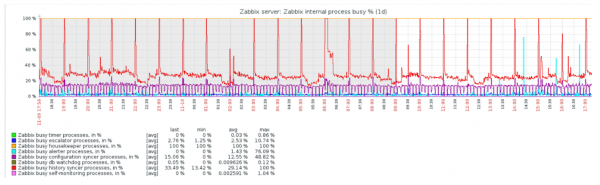
Grafiku i kuq tregon se History syncer është vazhdimisht i zënë. Grafiku portokalli lart është Housekeeper, i cili aktivizohet vazhdimisht. Ai pret që DB të fshijë të gjitha rreshtat që ai ka përcaktuar.
Kur duhet të çaktivizohet Housekeeper? Për shembull, nëse ka një «Item ID» dhe duhet të fshihen 5 mijë rreshta në një kohë të caktuar. Natyrisht, kjo ndodh përmes indekseve. Por zakonisht dataset është shumë i madh, dhe DB gjithsesi lexon nga disku dhe e ngre në cache. Kjo gjithmonë është një operacion shumë i shtrenjtë për DB dhe, në varësi të madhësive të bazës, mund të shkaktojë probleme në performancë.
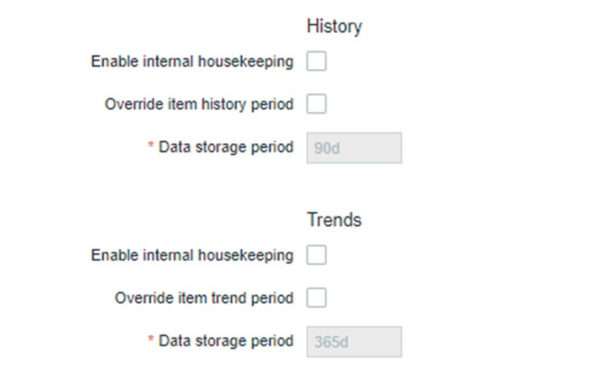
Housekeeper mund të çaktivizohet lehtësisht. Në ndërfaqen Web ka një cilësim në «Administration general» për Housekeeper. Ne e çaktivizojmë Housekeeping-un e brendshëm për historinë e brendshme të trendeve dhe ai nuk menaxhon më këtë.
Housekeeper u çaktivizua, grafiket u rregulluan - çfarë probleme të mundshme mund të ketë në këtë rast dhe çfarë mund të ndihmojë në zgjidhjen e thirrjes së tretë për performancën?
Partitioning - seksionimi ose parcellimi
Zakonisht, parcellimi konfigurimi bëhet në mënyra të ndryshme në çdo DB relacional, që kam përmendur. Çdo një ka teknologjinë e saj, por ato janë të ngjashme, në përgjithësi. Krijimi i një seksioni të ri shpesh shkakton probleme të caktuara.
Zakonisht, seksionet konfigurohen në varësi të «setup-it» - numrit të të dhënave që gjenerohen në një ditë. Zakonisht, Partitioning-u vendoset për një ditë, kjo është minimumi. Për trendet, seksione të reja - për 1 muaj.
Vlerat mund të ndryshojnë në rastin e një «setup» shumë të madh. Nëse «setup» i vogël është deri në 5,000 nvps (vlera të reja për sekondë), mesatarja - nga 5,000 deri në 25,000, atëherë e madhe - mbi 25,000 nvps. Këto janë instalime të mëdha dhe shumë të mëdha që kërkojnë konfigurim të kujdesshëm të bazës së të dhënave.
Në instalime shumë të mëdha, një segment në një ditë mund të mos jetë optimal. Kam parë në MySQL seksione mbi 40 GB dhe më shumë për ditë. Ky është një volum shumë i madh të dhënash, që mund të shkaktojë probleme dhe duhet të reduktohet.
Çfarë ofron Partitioning?
Seksionimi i tabelave. Zakonisht, këto janë skedarë të veçantë në disk. Plani i kërkesave zgjidh më optimal një seksion. Zakonisht, parcellimi përdoret sipas intervaleve - kjo është e vërtetë edhe për Zabbix. Ne përdorim atje «timestamp» - koha që nga fillimi i epokës. Këtu kemi numra të zakonshëm. Ju konfiguroni fillimin dhe fundin e ditës - kjo është një seksion.
Fshirje e shpejtë — FSHIZgjedhet një skedar/subtabela, e jo një grumbull rreshtash për t'u fshirë.
Duket se përshpejton marrjen e të dhënave. SELECT — përdor një ose më shumë pjesë, dhe jo tërë tabelën. Nëse i drejtoheni të dhënave të dy ditëve më parë, ato zgjidhen nga DB më shpejt, sepse duhet të ngarkohen në cache dhe të jepen vetëm një skedar, e jo një tabelë të madhe.
Shpesh shumë DB gjithashtu përmirëson. SHTO — inserimet në tabelën fëmijë.
TimescaleDB
Për v 4.2 ne u fokusuam në TimescaleDB. Ky është një zgjerim për PostgreSQL me një ndërfaqe natyrore. Zgjerimi punon efektivisht me të dhënat e serive kohore, pa humbur përfitimet e DB-ve rrelacionale. TimescaleDB gjithashtu partitizon automatikisht.
Në TimescaleDB ekziston koncepti i hipertabelës (hypertable), të cilën e krijoni. Ajo përmban skaje — pjesitë. Skajat janë fragmente të menaxhuara automatikisht të hipertabelës, të cilat nuk ndikojnë në fragmente të tjera. Për çdo skaj ka një gamë të veçantë kohore.
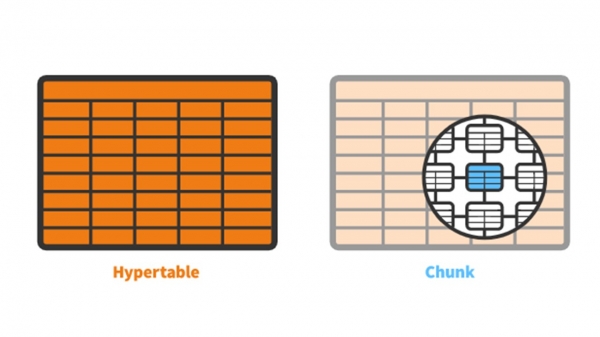
TimescaleDB vs PostgreSQL
TimescaleDB funksionon vërtet efektivisht. Prodhuesit e zgjerimit pretendojnë se ata përdorin një algoritëm më të saktë për trajtimin e kërkesave, veçanërisht të inserts. Kur dimensionet e të dhënave që futen rriten, algoritmi mbështet një performancë të vazhdueshme.
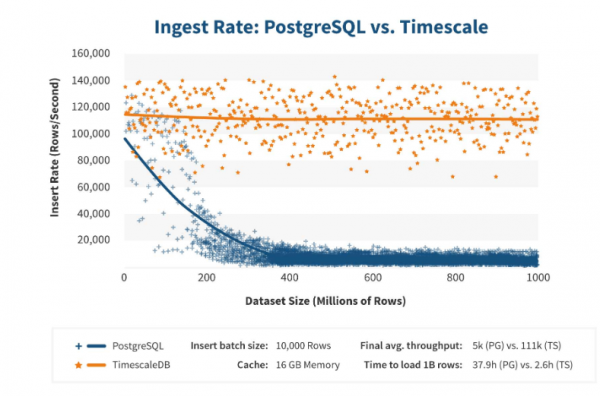
Pas 200 milion rreshtash, PostgreSQL zakonisht fillon të ngadalësohet ndjeshëm dhe humbet performancën deri në 0. TimescaleDB lejon efikasitetin në inserimet ‘inserts’ me çdo sasi të dhënash.
Instalimi
Të instalosh TimescaleDB është mjaft e lehtë për çdo paketë. Në është përshkruar në detaje — varet nga paketat zyrtare të PostgreSQL. TimescaleDB mund të ndërtohet dhe kompilohet gjithashtu manualisht.
Për DB Zabbix thjesht aktivizojmë zgjerimin:
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix Aktivizoni zgjerimin dhe krijoni atë për DB Zabbix. Hapi i fundit — krijimi i hipertabelës.
Migrimi i tabelave të historisë në TimescaleDB
Për këtë ka një funksion të veçantë create_hypertable:
SELECT create_hypertable(‘history’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable(‘history_unit’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable(‘history_log’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable(‘history_text’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable(‘history_str’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable(‘trends’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable(‘trends_unit’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
UPDATE config SET db_extension=’timescaledb’, hk_history_global=1, hk_trends_global=1
Funksioni ka tre parametra. I pari — tabela në DB, për të cilën duhet të krijohet hipertabela. Të dytin — fushën, sipas të cilit duhet të krijohet chunk_time_interval — intervali i grumbujve të particioneve që duhet të përdoren. Në rastin tim, intervalu është një ditë — 86 400.
Parametri i tretë — migroj të dhënat. Nëse vendoset true, të gjitha të dhënat aktuale transferohen në grumbujt e krijuar paraprakisht. Unë vetë kam përdorur migroj të dhënat. Kishte rreth 1 TB, që zuri më shumë se një orë. Edhe në disa raste, gjatë testimeve, kam fshirë të dhënat historike simetrike që nuk ishin të nevojshme për ruajtje, për t'i shmangur ato.
Hapi i fundit — UPDATE: në db_extension vendosim timescaledb, për t'i treguar DB-së se ka këtë zgjerim. Zabbix e aktivizon atë dhe e përdor këtë sintaksë e kërkesa për DB-në — ato veçori që janë të nevojshme për TimescaleDB.
Konfigurimi i harduerit
Kam përdorur dy serverë. I pari — VMware-makina. Ajo është mjaft e vogël: 20 procesorë Intel® Xeon® CPU E5-2630 v 4 @ 2.20GHz, 16 GB memorie RAM dhe një disk SSD prej 200 GB.
Kam instaluar aty PostgreSQL 10.8 me OS Debian 10.8-1.pgdg90+1 dhe sistemin e skedarëve xfs. Të gjitha janë minimalisht konfigurur për të përdorur saktësisht këtë bazë të dhënash, përveç asaj që do të përdorë vetë Zabbix.
Në këtë makinë ishte serveri Zabbix, PostgreSQL dhe agjentët e ngarkesës. Kam pasur 50 agjentë aktivë, të cilat përdornin LoadableModule, për të gjeneruar shumë shpejt rezultatet e ndryshme: numra, stringa. E mbusha bazën me shumë të dhëna.
Fillimisht, konfigurimi përmbante 5 000 elemente të dhënash për çdo host. Gati çdo element përmbante një trigger, që të ishte e ngjashme me instalimet reale. Në disa raste kishte më shumë se një trigger. Në një nyje të rrjetit kishim 3 000-7 000 triggera..
Intervali i azhurnimit të elementeve të dhënash — 4-7 sekondaUnë rregulloja ngarkesën duke përdorur jo vetëm 50 agjentë, por shtoja edhe më shumë. Po ashtu, me anë të elementeve të dhënash, rregulloja dinamikisht ngarkesën dhe ulja e intervalit të rifreskimit në 4 sekonda.
PostgreSQL. 35,000 nvps
Së pari, ndihesha në këtë harduer me PostgreSQL të pastër — 35,000 vlera në sekondë. Siç duket, futja e të dhënave merr fraksione sekonde — gjithçka është mirë dhe e shpejtë. E vetmja gjë është se disku SSD prej 200 GB mbushet shpejt.
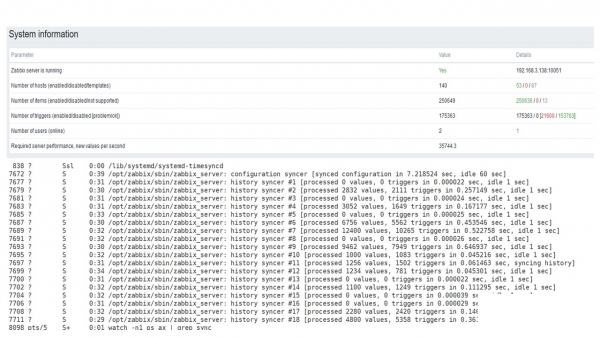
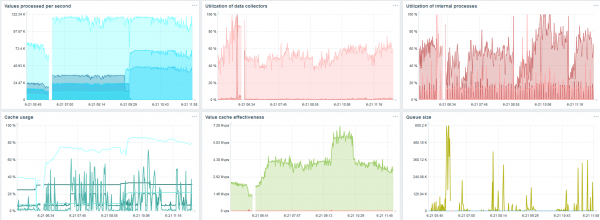
Ky është dashboard-i standard i performancës Zabbix — të serverit.
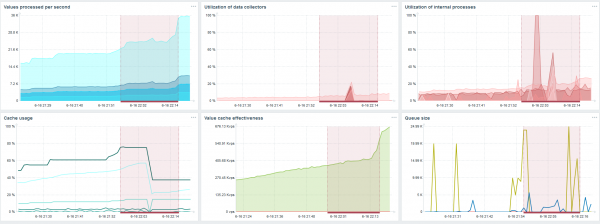
Grafiku i parë blu — numri i vlerave në sekondë. Grafiku i dytë në të djathtë — ngarkesa e proceseve të ndërtimit. Tretësori — ngarkesa e proceseve të brendshme të ndërtimit: history syncers dhe Housekeeper, i cili këtu u krye për një kohë të konsiderueshme.
Grafiku i katërt tregon përdorimin e HistoryCache. Ky është një tampon para futjes në DB. Grafiku i gjelbër i pestë tregon përdorimin e ValueCache, që do të thotë sa goditje ka pasur ValueCache për treguesit — kjo është disa mijëra vlera në sekondë.
PostgreSQL. 50,000 nvps
Në vazhdim, unë e rritja ngarkesën në 50,000 vlera në sekondë në këtë harduer të njëjtë.
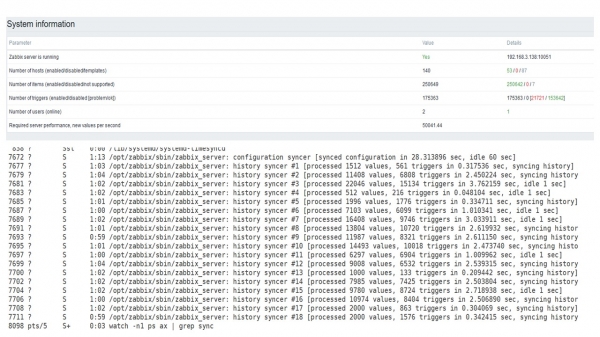
Gjatë ngarkesës me Housekeeper, futja e 10,000 vlerave u regjistrua për 2-3 sekonda.
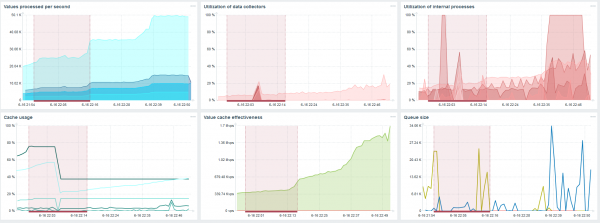
Housekeeper tashmë fillon të pengojë punën.
Nga grafiku i tretë duket se, në këtë moment, ngarkesa e trapper-ve dhe history syncers është ende në nivelin 60%. Në grafikun e katërt, HistoryCache gjatë punës së Housekeeper tashmë fillon të mbushet mjaft aktivisht. Ai është mbushur në 20% — rreth 0.5 GB.
PostgreSQL. 80,000 nvps
Më pas, unë e rritja ngarkesën në 80,000 vlera në sekondë. Kjo është rreth 400,000 elemente të dhënash dhe 280,000 tregues.
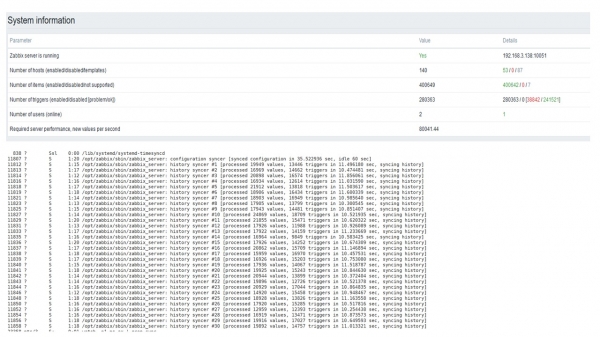
Futja me ngarkesën e tridhjetë history syncers është tashmë mjaft e lartë.
Po ashtu, unë e rritesha disa parametra: history syncers, memorie cache.
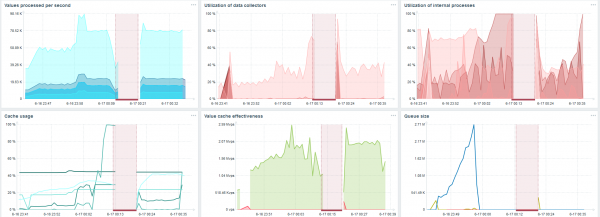
Në harduerin tim, ngarkesa e history syncers u rrit në maksimum. HistoryCache shpejt u mbush me të dhëna — në tampon u grumbulluan të dhëna për trajtim.
Të gjithë këtë kohë kam monitoruar se si përdoret procesori, memoria RAM dhe parametrat e tjerë të sistemit, dhe zbulova se shfrytëzimi i disqeve ishte maksimal.
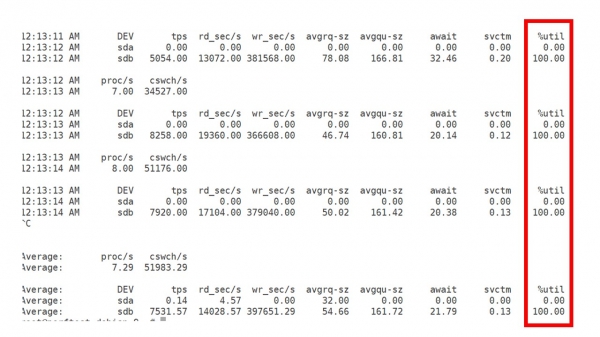
Arrita të përdor mundësitë maksimale të diskut në këtë harduer dhe në këtë makinë virtuale. Me një intensitet të tillë, PostgreSQL filloi të hidhte të dhëna mjaft aktivisht dhe disku tashmë nuk arrinte të punonte në regjistrimin dhe leximin.
Serveri i dytë
Kam mora një server tjetër që kishte tashmë 48 procesorë dhe 128 GB memorie RAM. E optimizova - instalova 60 history syncer dhe arrita një performancë të pranueshme.
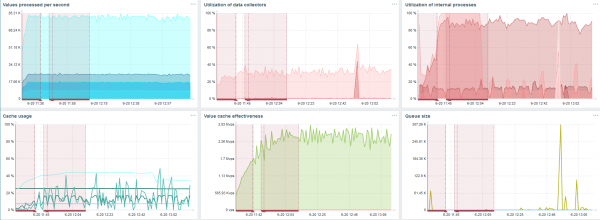
Fakti është që ky është kufiri i performancës ku duhet bërë diçka.
TimescaleDB. 80,000 nvps
Detyra ime kryesore është të provoj mundësitë e TimescaleDB nga ngarkesa e Zabbix. 80 mijë vlera në sekondë është shumë, frekuenca e mbledhjes së metricave (përveç Yandex-it, natyrisht) dhe një 'setup' mjaft i madh.
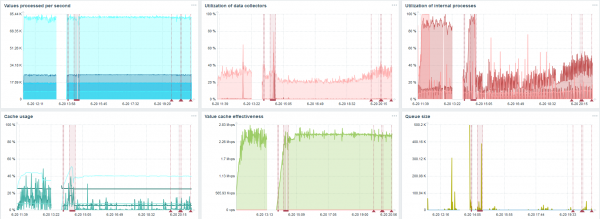
Në çdo grafik ka një rënie - kjo është pikërisht migrimi i të dhënave. Pas rënieve në serverin Zabbix, profili i ngarkesës së history syncer u ndryshua ndjeshëm - ra tri herë.
TimescaleDB lejon që të dhënat të futen praktikisht tri herë më shpejt dhe të përdorë më pak HistoryCache.
Për pasojë, ju do të merrni të dhëna në kohë.
TimescaleDB. 120,000 nvps
Më pas e rita numrin e elementeve të dhënash deri në 500 mijë. Detyra kryesore ishte të provoj mundësitë e TimescaleDB - kam marrë një vlerësim prej 125 mijë vlerash në sekondë.
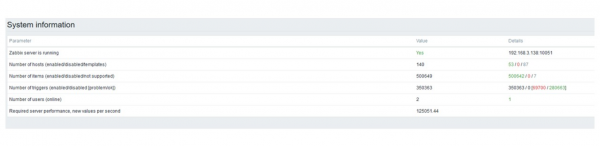
Ky është një 'setup' funksional, që mund të punojë për një kohë të gjatë. Por pasi disku im ishte vetëm 1.5 TB, e mbushëm brenda disa ditëve.
Më e rëndësishmja, në të njëjtën kohë po krijoheshin parti të reja në TimescaleDB.
Për performancën, kjo është krejtësisht e paqartë. Kur krijohen parti në MySQL, për shembull, gjithçka është ndryshe. Zakonisht ndodh gjatë natës, sepse bllokon insert-in e përgjithshëm, punën me tabelat dhe mund të shkaktojë degradimin e shërbimit. Në rastin e TimescaleDB, kjo nuk ndodh.
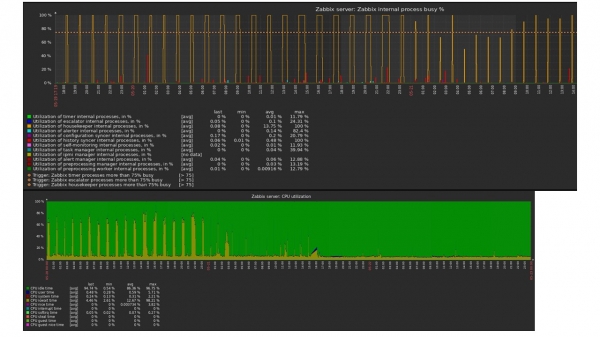
Për shembull, do të tregoj një grafik nga shumë në community. Në figurë është aktivizuar TimescaleDB, për këtë arsye ngarkesa në përdorimin e io.weight në procesor ka rënë. Përdorimi i elementeve të proceseve të brendshme gjithashtu ka rënë. Dhe kjo është një makinë virtuale normale me disqe të zakonshme, jo SSD.
Përfundimet
TimescaleDB është një zgjidhje e mirë për 'setup' të vogla, që përballen me performancën e diskut. Ajo do të lejojë që të vazhdojë të punojë deri në migrimin e DB-së në një harduer më të shpejtë.
TimescaleDB është e thjeshtë për t'u konfiguruar, jep një rritje të performancës, punon mirë me Zabbix dhe ka avantazhe krahasuar me PostgreSQL..
Nëse përdorni PostgreSQL dhe nuk planifikoni ta ndryshoni, atëherë rekomandoj të përdorni PostgreSQL me zgjerimin TimescaleDB në lidhje me Zabbix.Ky zgjidhje funksionon efikas në 'setup' mesatar.
Kur themi 'performancë e lartë' - nënkuptojmë . Pr ожида ш вы познаете teknologjive dhe praktikat që lejojnë shërbimeve t'i shërbejnë miliona përdoruesve, shumë shpejt. Lista për 7 dhe 8 nëntor e kemi përgatitur, por mund të propozohet akoma.
Abonohuni në dhe , ku zbulojmë tiparet e konferencës së ardhshme dhe mësoni si të nxirrni maksimumin e përfitimit.
Burimi: habr.com
