

VictoriaMetrics, TimescaleDB dhe InfluxDB u krahasuan në me një grup të dhënash me një miliard pikash të dhënash, që i takojnë 40K serive temporale unike.
Disa vite më parë, ishte epoka e Zabbix. Çdo server bare metal kishte jo më shumë se disa tregues – përdorimi i procesorit, përdorimi i memories, përdorimi i disku dhe përdorimi i rrjetit. Kështu, metrikat nga mijëra serverësh mund të përfshihen në 40 mijë seri temporale unike, dhe Zabbix mund të përdorë MySQL si backend për të dhënat e serive temporale 🙂
Aktualisht, një me konfigurimet e paracaktuara ofron më shumë se 500 metrika në një host mesatar. Ekzistojnë shumë për baza të ndryshme të të dhënave, servera web, sisteme harduerike etj. Të gjithë ata ofrojnë shumë tregues të dobishëm. Të gjitha fillojnë të ekspozojnë tregues të ndryshëm për veten e tyre. Ekziston Kubernetes me klastere dhe pod-e, që zbulojnë shumë metrika. Kjo bën që serverët të ekspozojnë mijëra metrika unike në një host. Kështu, një seri temporale unike 40K nuk është më një fuqi e madhe. Ai bëhet mainstream, që duhet të përpunohen lehtësisht nga çdo TSDB moderne në një server.
Çfarë është një numër i madh i serive temporale unike në këtë moment? Ndoshta 400K ose 4M? Ose 40M? Le të krahasojmë TSDB moderne me këto shifra.
Vendosja e një benchmarku
është një mjet i shkëlqyer për benchmarkimin e TSDB-ve. Ai lejon të gjenerohet një numër arbitrar metrikash, duke kaluar sasinë e nevojshme të serive temporale, të ndara në 10 – flamuri (ish -scale-var). 10 është numri i matjeve (metrikave) që gjenerohen në çdo host, server. Grupet e mëposhtme të të dhënave u krijuan duke përdorur TSBS për benchmarkun:
- 400K seri temporale unike, intervali 60 sekonda mes pikave të të dhënave, të dhënat mbulojnë 3 ditë të plota, ~1.7B numri total i pikave të të dhënave.
- 4M seri temporale unike, intervali 600 sekonda, të dhënat mbulojnë 3 ditë të plota, ~1.7B numri total i pikave të të dhënave.
- 40M seri temporale unike, intervali 1 orë, të dhënat mbulojnë 3 ditë të plota, ~2.8B numri total i pikave të të dhënave.
Klienti dhe serveri u ekzekutuan në instance të dedikuara në cloud-in Google. Këto instance kishin konfigurime të mëposhtme:
- vCPUs: 16
- RAM: 60 GB
- Storage: standard hard disk with a capacity of 1 TB. It provides a read/write throughput of 120 Mbps, 750 read operations per second, and 1.5K write operations per second.
TSDBs were extracted from official Docker images and launched in Docker with the following configurations:
VictoriaMetrics:
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsInfluxDB values (- e are required to support high performance. See details in ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (configuration was adopted from the file):
MEM=`free -m | grep "Mem" | awk ‘{print $7}’`
let "SHARED=$MEM/4"
let "CACHE=2*$MEM/3"
let "WORK=($MEM-$SHARED)/30"
let "MAINT=$MEM/16"
let "WAL=$MEM/16"
docker run -it --rm -p 5432:5432
--shm-size=${SHARED}MB
-v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data
timescale/timescaledb:latest-pg10 postgres
-cmax_wal_size=${WAL}MB
-clog_line_prefix="%m [%p]: [%x] %u@%d"
-clogging_collector=off
-csynchronous_commit=off
-cshared_buffers=${SHARED}MB
-ceffective_cache_size=${CACHE}MB
-cwork_mem=${WORK}MB
-cmaintenance_work_mem=${MAINT}MB
-cmax_files_per_process=100
The data loader was run with 16 parallel threads.
This article contains results only for insertion metrics. Sampling benchmark results will be published in a separate article.
400K unique time series
Let's start with simple elements — 400K. Benchmark results:
- VictoriaMetrics: 2.6M data points per second; memory usage: 3 GB; final data size on disk: 965 MB
- InfluxDB: 1.2M data points per second; memory usage: 8.5 GB; final data size on disk: 1.6 GB
- Timescale: 849K data points per second; memory usage: 2.5 GB; final data size on disk: 50 GB
As you can see from the results above, VictoriaMetrics excels in insertion performance and compression. Timescale excels in memory usage but consumes a lot of disk space — 29 bytes per data point.
Below are the CPU usage charts for each of the TSDBs during the benchmark:
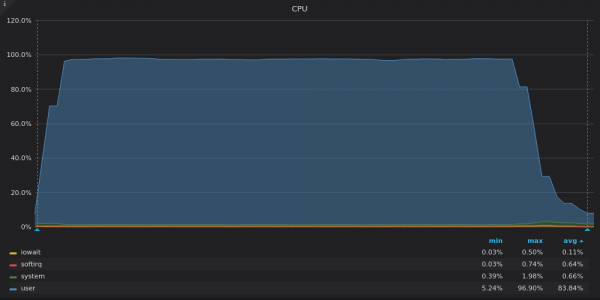
Above screenshot: VictoriaMetrics — CPU Load during the insertion test for unique metric 400K.
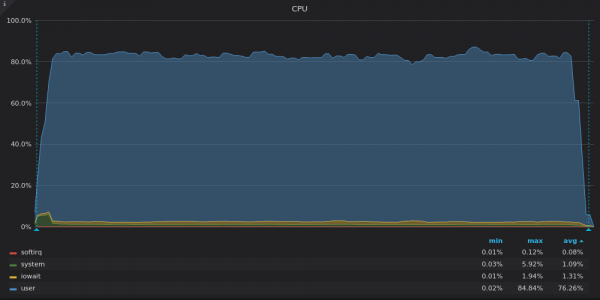
Above screenshot: InfluxDB — CPU Load during the insertion test for unique metric 400K.
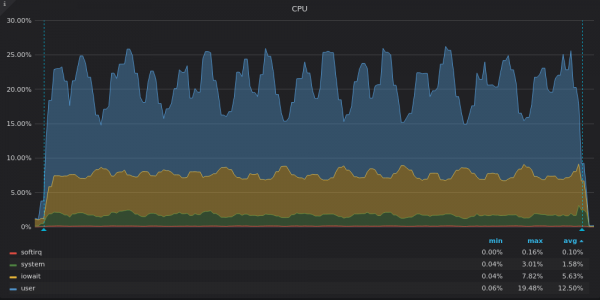
Above screenshot: TimescaleDB — CPU Load during the insertion test for unique metric 400K.
VictoriaMetrics përdor të gjithë vCPUs e disponueshme, ndërsa InfluxDB nuk e përdor siç duhet ~2 nga 16 vCPUs.
Timescale përdor vetëm 3-4 nga 16 vCPUs. Pjesët e larta të iowait dhe system në grafikët e TimescaleDB tregojnë një ngushticë në nënstrukturën e hyrjes dhe daljes (I/O). Le të shikojmë grafikët e përdorimit të kapacitetit të diskut:
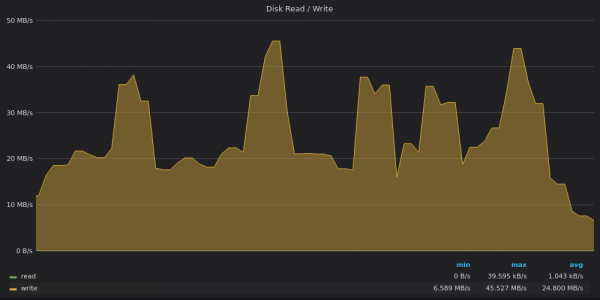
Screenshot i mësipërm: VictoriaMetrics - Përdorimi i kapacitetit të diskut gjatë testit të inserimit për 400K tregues unikë.
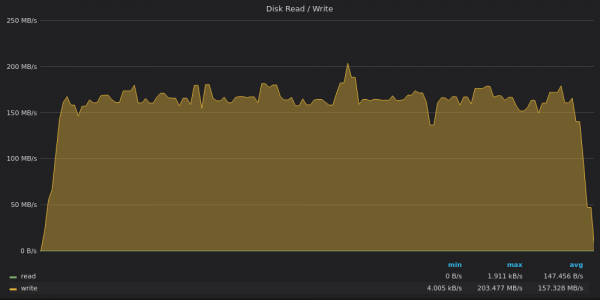
Screenshot i mësipërm: InfluxDB - Përdorimi i kapacitetit të diskut gjatë testit të inserimit për 400K tregues unikë.
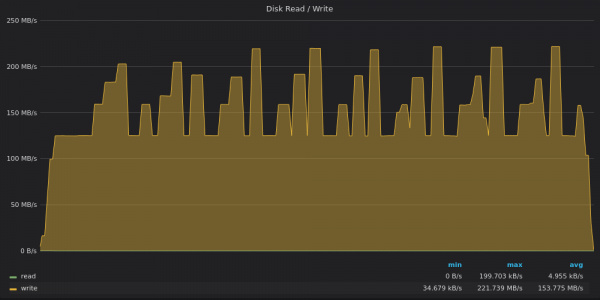
Screenshot i mësipërm: TimescaleDB - Përdorimi i kapacitetit të diskut gjatë testit të inserimit për 400K tregues unikë.
VictoriaMetrics regjistron të dhëna me një shpejtësi prej 20 Mbit/s me pika deri në 45 Mbit/s. Pikët përputhen me bashkime të mëdha të pjesshme në pemën .
InfluxDB regjistron të dhëna me një shpejtësi prej 160 MB/s, ndërsa 1 TB disku me kapacitetin e shkarkimit prej 120 MB/s.
TimescaleDB është e kufizuar me kapacitetin e shkarkimit prej 120 Mbit/s, por ndonjëherë e tejkalon këtë kufi dhe arrin në 220 Mbit/s në pika maksimale. Këto pika përputhen me dështime të ngarkesës së pamjaftueshme të procesorit në grafikët e mëparshëm.
Le të shikojmë grafikët e përdorimit të hyrjes dhe daljes (I/O):
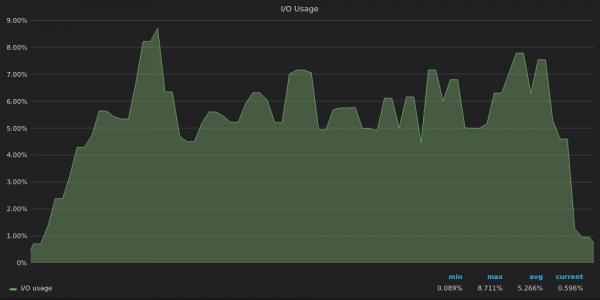
Screenshot i mësipërm: VictoriaMetrics - Përdorimi i hyrjes dhe daljes gjatë testit të inserimit për 400K tregues unikë.
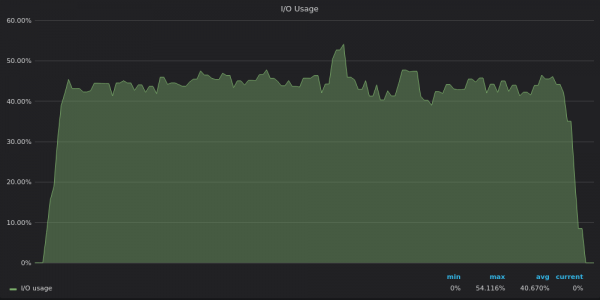
Screenshot i mësipërm: InfluxDB - Përdorimi i hyrjes dhe daljes gjatë testit të inserimit për 400K tregues unikë.
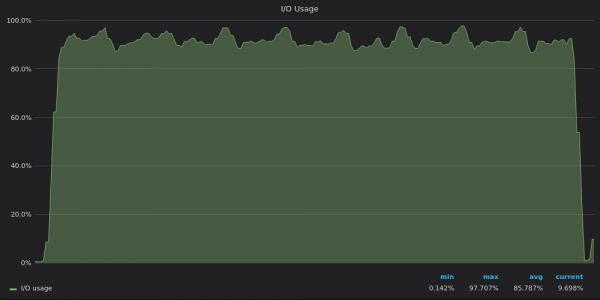
Screenshot i mësipërm: TimescaleDB - Përdorimi i hyrjes dhe daljes gjatë testit të inserimit për 400K tregues unikë.
Tani është e qartë se TimescaleDB arrin kufirin e hyrjes dhe daljes, prandaj nuk mund të përdorë 12 vCPUs të mbetura.
4M seritë e kohës unike
4M seritë e kohës duken pak sfiduese. Por konkurrentët tanë e kalojnë me sukses këtë provim. Rezultatet e benchmark-ut:
- VictoriaMetrics: 2.2M pikë të dhënash në sekondë; përdorimi i kujtesës: 6 GB; përmasat përfundimtare të të dhënave në disk: 3 GB.
- InfluxDB: 330K pikë të dhënash në sekondë; përdorimi i kujtesës: 20.5 GB; përmasat përfundimtare të të dhënave në disk: 18.4 GB.
- TimescaleDB: 480K pikë të dhënash në sekondë; përdorimi i kujtesës: 2.5 GB; përmasat përfundimtare të të dhënave në disk: 52 GB.
Performanca e InfluxDB rahet nga 1.2 milion pikë të dhënash në sekondë për 400K seritë e kohës deri në 330 mijë pikë të dhënash në sekondë për 4M seritë e kohës. Kjo është një humbje e konsiderueshme e performancës krahasuar me konkurrentët e tjerë. Le të shohim grafiket e përdorimit të CPU-së për të kuptuar shkakun kryesor të kësaj humbjeje:
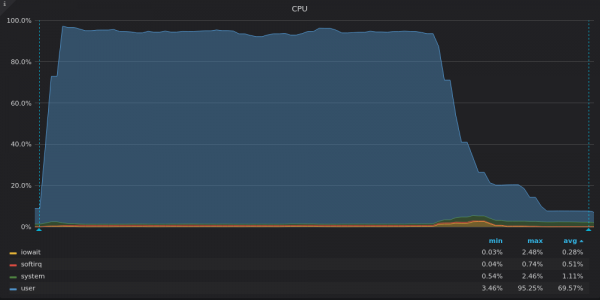
Eposhtme është skrinshoti: VictoriaMetrics — Përdorimi i CPU gjatë testit të futur për një seri unike kohe 4M.
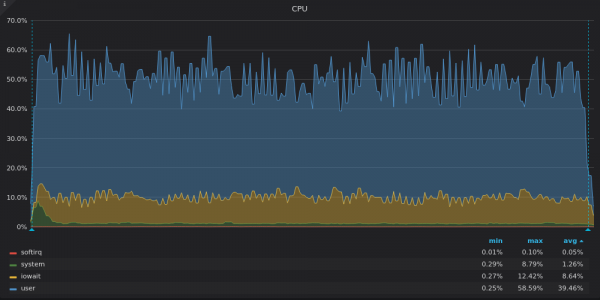
Eposhtme është skrinshoti: InfluxDB — Përdorimi i CPU gjatë testit të futur për një seri unike kohe 4M.
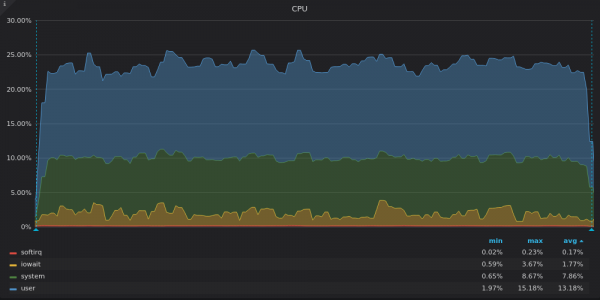
Eposhtme është skrinshoti: TimescaleDB — Përdorimi i CPU gjatë testit të futur për një seri unike kohe 4M.
VictoriaMetrics përdor pothuajse gjithë kapacitetin e CPU-së. Rënia në fund i korrespondon bashkimeve LSM pas futur të gjithë të dhënave.
InfluxDB përdor vetëm 8 nga 16 vCPUs, ndërsa TimescaleDB përdor 4 nga 16 vCPUs. Çfarë kanë të përbashkët grafiket e tyre? Një përqindje e lartë iowait, e cila gjithashtu tregon për një ngushtesë në hyrje-dalje.
TimescaleDB ka një përqindje të lartë sistem.. Besojmë se fuqia e lartë çoi në shumë thirrje sistemike ose në shumë .
Le të shohim grafiket e kapacitetit të diskut:
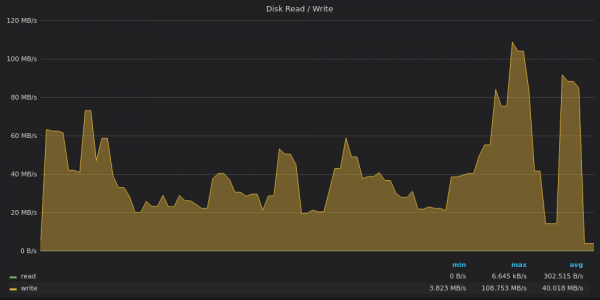
Eposhtme është skrinshoti: VictoriaMetrics — Përdorimi i bandës së kapacitetit të diskut për futur 4M metrika unike.
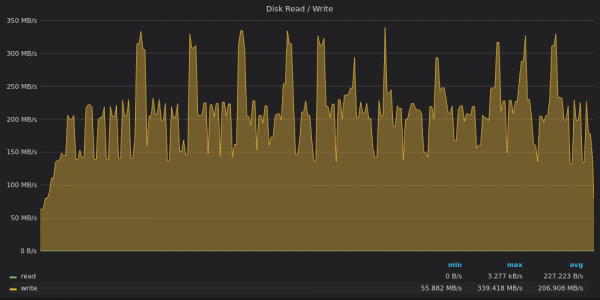
Eposhtme është skrinshoti: InfluxDB — Përdorimi i bandës së kapacitetit të diskut për futur 4M metrika unike.
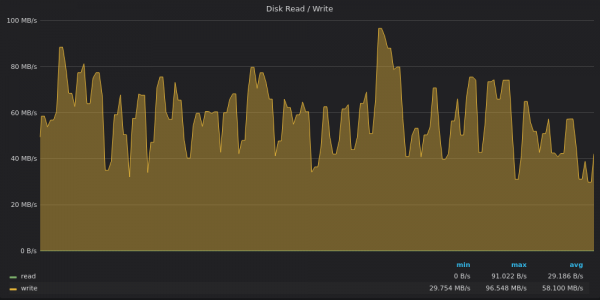
Eposhtme është skrinshoti: TimescaleDB — Përdorimi i bandës së kapacitetit të diskut për futur 4M metrika unike.
VictoriaMetrics arriti një kapacitet prej 120 MB/s në pik, ndërsa shpejtësia mesatare e shkarkimit ishte 40 MB/s. Probabilisht, gjatë pikut u realizuan disa bashkime të rënda LSM.
InfluxDB përsëri shfrytëzon një kapacitet mesatar të shkarkimit prej 200 MB/s me pika deri në 340 MB/s në një disk me një limit shkarkimi prej 120 MB/s 🙂
TimescaleDB nuk është më e kufizuar nga disku. Duket se është e kufizuar nga diçka tjetër që ka lidhje me përqindjen e lartë të ngarkesës sisteme të CPU-së.
Le të shohim grafiket e përdorimit të IO:
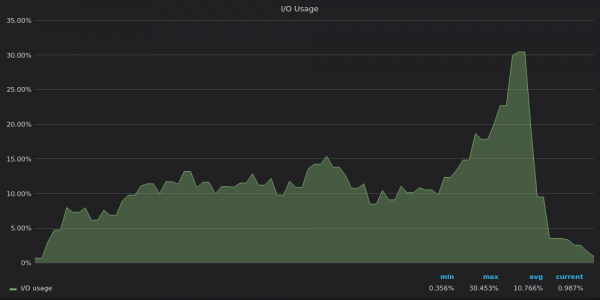
Eposhtme është skrinshoti: VictoriaMetrics — Përdorimi i hyrje-daljes gjatë testit të futur për një seri unike kohe 4M.
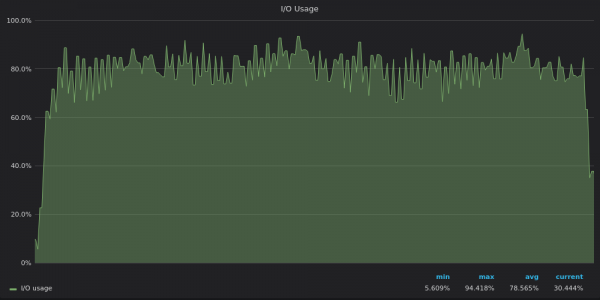
Eposhtme është skrinshoti: InfluxDB — Përdorimi i hyrje-daljes gjatë testit të futur për një seri unike kohe 4M.
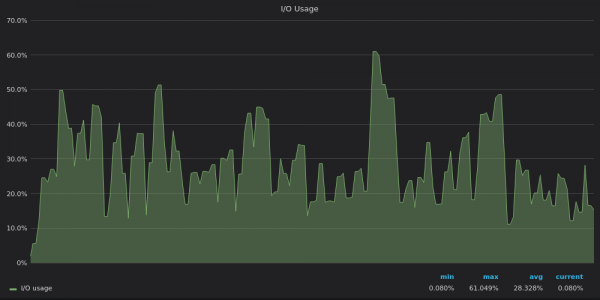
Eposhtme është skrinshoti: TimescaleDB — Përdorimi i hyrje-daljes gjatë testit të futur për një seri unike kohe 4M.
Grafikët e përdorimit të IO përsërisin grafikët e përdorimit të gjerësisë së brezit të diskut — InfluxDB është e kufizuar në IO, ndërsa VictoriaMetrics dhe TimescaleDB kanë burime të tepërta IO.
40M seri unike kohore
40M radhë unike kohore ishin shumë të mëdha për InfluxDB 🙁
Rezultatet e benchmarkut:
- VictoriaMetrics: 1.7M pika të dhënash në sekondë; përdorimi i memorizimit: 29 GB; përdorimi i hapësirës së diskut: 17 GB.
- InfluxDB: nuk përfundoi, sepse kërkonte më shumë se 60 GB memorie.
- TimescaleDB: 330K pika të dhënash në sekondë, përdorimi i memorizimit: 2.5 GB; përdorimi i hapësirës së diskut: 84GB.
TimescaleDB tregon një përdorim të jashtëzakonshëm të ulët dhe të qëndrueshëm të memorizimit – 2.5 GB — sa për metrika unike 4M dhe 400K.
VictoriaMetrics u rrit ngadalë me shpejtësinë 100 mijë pikash të dhënash në sekondë, derisa u përpunuan të gjitha 40M emra metrikë me etiketat. Pastaj arriti një shpejtësi të qëndrueshme të futur 1.5-2.0M pikash të dhënash në sekondë, kështu që rezultati përfundimtar ishte 1.7M pika të dhënash në sekondë.
Grafikët për 40M seri unike kohore janë të ngjashëm me grafikët për 4M seri unike kohore, kështu që le t'i skipojmë ato.
Përfundimet
- TSDB-të moderne janë në gjendje të procesojnë fushata për miliona seri unike kohore në një server. Në artikullin e ardhshëm, ne do të shqyrtojmë se sa mirë TSDB-të përfundojnë zgjedhjet për miliona seri unike kohore.
- Përdorimi i pamjaftueshëm i CPU zakonisht tregon për një ngushticë në input-output. Për më tepër, kjo mund të tregojë një bllokim të tepërt, kur vetëm disa inkurzioni mund të funksionojnë në të njëjtën kohë.
- Ngushtica e input-output vërtet egziston, veçanërisht në depozitë pa SSD, siç janë pajisjet e bllokimit të virtualizuara të ofruesve të cloud.
- VictoriaMetrics ofron optimizimin më të mirë për depozitat e ngadalta me input-output të ulët. Ai ofron shpejtësinë më të mirë dhe nivelin më të mirë të kompresimit.
Shkarko dhe provoje me të dhënat e tua. Skedari statik përkatës është i disponueshëm në .
Më shumë për VictoriaMetrics lexoni në këtë .
Përditësim: është publikuar me rezultate të riprodhueshme.
Përditësimi #2: Lexoni gjithashtu .
Përditësimi #3: !
Biseda në Telegram:
Burimi: habr.com
