

Përshëndetje, unë merrem me krijimin e aplikacioneve për sisteme të menaxhimit të të dhënave. — është një platformë e zhvilluar në grupin Mail.ru, që kombinon një sistem të menaxhimit të të dhënave me performancë të lartë dhe një server aplikacionesh në gjuhën Lua. Shpejtësia e lartë e zgjidhjeve të bazuara në Tarantool arrihet veçanërisht për shkak të mbështetjes për modalitetin in-memory të sistemit të menaxhimit të të dhënave dhe mundësisë së ekzekutimit të logjikës së biznesit të aplikacionit në të njëjtin hapësirë adresash me të dhënat. Ndërkohë, sigurohet persistenca e të dhënave duke përdorur transaksione ACID (në disk mbahen logs WAL). Tarantool ka mbështetje të integruar për replikimin dhe sharding. Duke filluar nga versioni 2.1, mbështeten pyetje në gjuhën SQL. Tarantool ka kod të hapur dhe shpërndahet nën licencën Simplified BSD. Gjithashtu ekziston një version Enterprise komercial.
Ndieni fuqinë! (…ose shijoni performancën)
E gjithë kjo e bën Tarantool një platformë atraktive për krijimin e aplikacioneve me ngarkesë të lartë që punojnë me baza të dhënash. Në këto aplikacione shpesh lind nevoja për replikimin e të dhënave.
Siç u përmend më lart, në Tarantool ka replikim të integruar të të dhënave. Parimi i funksionimit të saj është ekzekutimi i renditur në replikat të gjitha transaksioneve që ndodhen në log-un e maestros (WAL). Zakonisht, një replikim i tillë (që tani do ta quajmë të niveli të ulët) përdoret për të siguruar qëndrueshmërinë e aplikacionit dhe/ose për të ndarë ngarkesën e leximit midis nyjeve të grumbullit.
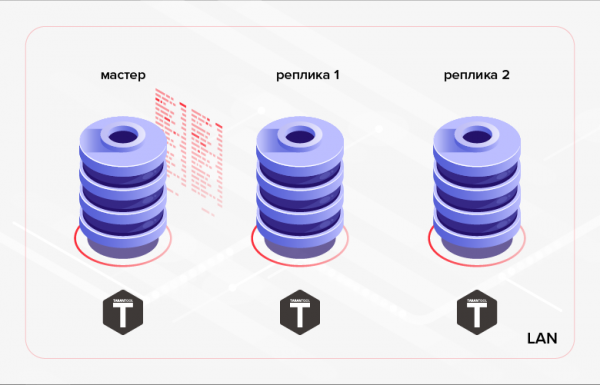
Fig. 1. Replikimi brenda grumbullit
Një shembull i një skenari alternativ mund të jetë transferimi i të dhënave të krijuara në një bazë të dhënash në një tjetër bazë për përpunim/monitorim. Në këtë rast, një zgjidhje më e përshtatshme mund të jetë përdorimi i të niveli të lartë replikimit — replikimi i të dhënave në nivelin e logjikës së biznesit të aplikacionit. Pra, ne nuk përdorim një zgjidhje të gatshme, të integruar në sistemin e menaxhimit të të dhënave, por realizojmë replikimin brenda aplikacionit që po zhvillojmë ne vetë. Ky qasje ka si avantazhe ashtu edhe disavantazhe. Le të rendisim përparësitë.
1. Kursimi i trafikut:
- mund të transferojmë jo të gjitha të dhënat, por vetëm një pjesë të tyre (për shembull, mund të transferojmë vetëm disa tabela, disa kolona të tyre ose regjistra që përkojnë me një kriter të caktuar);
- ndryshe nga replikimi i nivelit të ulët, i cili kryhet vazhdimisht në mënyrë asinkrone (i implementuar në versionin aktual Tarantool - 1.10) ose sinkrone (do të implementohet në versionet e ardhshme të Tarantool), replikimi i nivelit të lartë mund të kryhet në sesione (pra, aplikacioni fillimisht realizon sinkronizimin e të dhënave - një seancë shkëmbimi të dhënash, pastaj ka një pauzë në replikim, pas së cilës ndodh seanca e radhës e shkëmbimit etj.);
- nëse regjistrimi është ndryshuar disa herë, mund të transmetohet vetëm versioni i tij më i fundit (ndryshe nga replikimi i nivelit të ulët, ku në replikat do të ekzekutohen radhazi të gjitha ndryshimet e bëra në master).
2. Nuk ka vështirësi në realizimin e shkëmbimit përmes HTTP, çka lejon sinkronizimin e DB-ve të largëta.
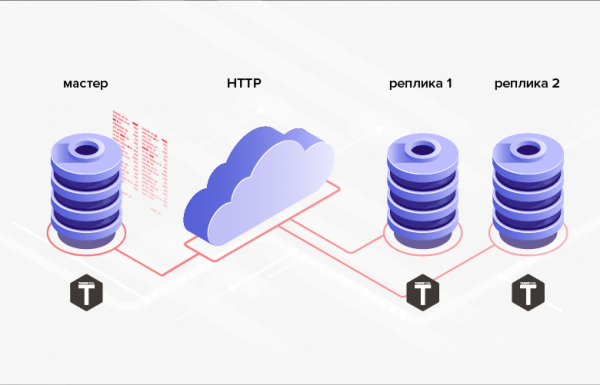
Fig. 2. Replikimi përmes HTTP
3. Struktura e DB-ve, midis të cilave transmetohen të dhënat, nuk është e detyruar të jetë e njëjtë (për më tepër, në përgjithësi është e mundur madje përdorimi i DB-ve të ndryshme, gjuhëve të programimit, platformave etj.).
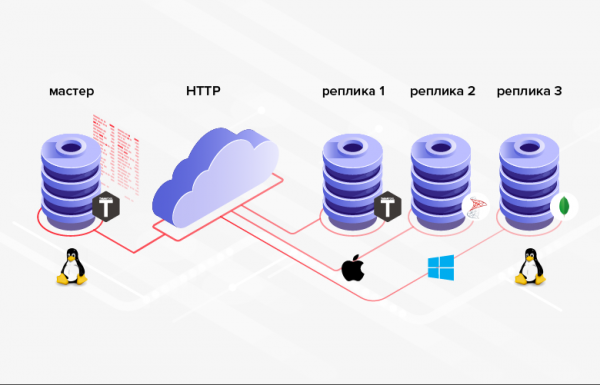
Fig. 3. Replikimi në sisteme heterogjene
Minnusi përfshin faktin se programimi në mesatare është më i komplikuar/kosto-shpenzues se sa konfigurimi, dhe në vend të konfigurimit të funksionalitetit të integruar, duhet të realizohet funksionaliteti i vet.
Nëse në situatën tuaj, përfitimet e përmendura kanë rëndësi vendimtare (ose janë një kusht i nevojshëm), atëherë ka kuptim të përdoret replikimi i nivelit të lartë. Le të shqyrtojmë disa mënyra për të realizuar replikimin e nivelit të lartë të të dhënave në DB-në Tarantool.
Minimizimi i trafikut
Pra, një nga përfitimet e replikimit të nivelit të lartë është kursimi i trafikut. Që kjo përfitim të paraqitet në mënyrë të plotë, është e nevojshme të minimizosh sasinë e të dhënave që transmetohen në çdo seancë shkëmbimi. Natyrisht, në këtë rast nuk duhet harruar se në fund të sesionit, marrësi i të dhënave duhet të jetë i sinkronizuar me burimin (të paktën në atë pjesë të të dhënave që bëjnë pjesë në replikim).
Si të minimizohet sasia e të dhënave që transmetohen gjatë replikimit të nivelit të lartë? Zgjidhja "në kokë" mund të jetë filtrimi i të dhënave sipas datës - orës. Për këtë mund të përdoret fusha e datës - orës që tashmë ekziston në tabelë (nëse ka). Për shembull, dokumenti "porosi" mund të ketë fushën "koha e kërkuar për përmbushjen e porosisë" - koha e dorëzimit. Problemi i këtij zgjidhje është se vlerat e këtij fushe nuk janë të detyruara të vendosen në një rend sekuence që përkon me krijimin e porosive. Kështu, ne nuk mundet të mbajmë mend vlerën maksimale të fushës koha e dorëzimit, e cila u transmetua gjatë seancës së mëparshme të shkëmbimit, dhe në seancën e ardhshme të shkëmbimit të seleksionojmë të gjitha regjistrimet me një vlerë më të lartë të fushës koha e dorëzimit. Në mes të seancave të shkëmbimit, mund të jenë shtuar regjistrime me një vlerë më të ulët të fushës koha e dorëzimit. Po ashtu, porosia mund të ketë përjetuar ndryshime, të cilat megjithatë nuk kanë ndikuar në fushën koha e dorëzimit. Në të dy rastet, ndryshimet nuk do të kalojnë nga burimi në marrës. Për të zgjidhur këto probleme, do të na nevojitet të transmetojmë të dhënat "në mbivendosje". Që do të thotë, në çdo seancë shkëmbimi do të transmetojmë të gjitha të dhënat me vlerën e fushës koha e dorëzimit, që kalon një pikë të caktuar në të kaluarën (p.sh. N orë nga momenti aktual). Megjithatë, është e qartë se për sistemet e mëdha, ky qasje është tejet e tepruar dhe mund ta anuloj kursimin e trafikut, të cilin ne synojmë. Për më tepër, në tabelën e kaluar nuk mund të ketë një fushë të lidhur me datën dhe kohën.
Një zgjidhje tjetër, më e komplikuar nga pikëpamja e realizimit, është konfirmimi i marrjes së të dhënave. Në këtë rast, në çdo seancë shkëmbimi transmetohen të gjitha të dhënat, marrja e të cilave nuk është e konfirmuar nga marrësi. Për realizimin e kësaj do të na nevojitet të shtojmë në tabelën burimore një kolonë boolene (p.sh., is_transferred). Nëse marrësi konfirmon marrjen e regjistrimit, fusha përkatëse merr vlerën true, pas së cilës regjistrimi nuk merr më pjesë në shkëmbime. Ky variant i realizimit ka këto disavantazhe. Së pari, për çdo regjistrim të transmetuar është e nevojshme të gjenerohet dhe dërgohet një konfirmim. Në terma të përgjithshëm, kjo mund të jetë e barabartë me dyfishimin e sasisë së të dhënave të transmetuara dhe të sjellë dyfishimin e numrit të rrugëve kthimin. Së dyti, nuk ka mundësi të dërgoni të njëjtin regjistrim në disa marrës (marrësi i parë që merr do të konfirmojë marrjen përvetë vet dhe për të tjerët).
Një mënyrë pa mangësi, e përmendur më sipër, përfshin shtimin e një kolone në tabelën e dërguar për të ndjekur ndryshimet e rreshtave të saj. Kjo kolone mund të ketë tipin datë-koha dhe duhet të caktohet/përditësohet nga aplikacioni në momentin aktual çdo herë që shtohen/përmirësohen regjistrimet (atomike me shtimin/përmirësimin). Si një shembull, do ta quajmë kolonën update_time. Duke ruajtur vlerën maksimale të fushës së kësaj kolone për regjistrimet e dërguara, ne do të jemi në gjendje të fillojmë seancën e ardhshme të shkëmbimit nga kjo vlerë (të selektojmë regjistrimet me vlerën e fushës update_time, që e kalon vlerën e ruajtur më parë). Problemi i lidhur me qasjen e fundit është se ndryshimet e të dhënave mund të ndodhin në mënyrë grupore. Si rezultat, vlerat e fushave në kolonën update_time mund të mos jenë unike. Prandaj, kjo kolone nuk mund të përdoret për tregimin pjesor (në faqe) të të dhënave. Për të bërë tregimin në faqe të të dhënave, do të duhej të shpiknim mekanizma të tjerë, të cilët me shumë mundësi do të kishin efikasitet shumë të ulët (për shembull, të nxirrnim nga DB të gjitha regjistrimet me vlerën update_time më të lartë se ajo e caktuar dhe të jepnim një numër të caktuar regjistrimesh, duke filluar nga një offset nga fillimi i seleksionimit).
Mund të rritet efikasiteti i transferimit të të dhënave duke përmirësuar pak qasjen e mëparshme. Për këtë, si vlera të fushave të kolonës për ndjekjen e ndryshimeve, do të përdorim tipin e numrit të plotë (numër i gjatë tërë). Do ta quajmë kolonën row_ver. Vlera e fushës së kësaj kolone duhet të caktohet/përditësohet çdo herë që krijohet/përmirësohet një regjistrim. Por në këtë rast, fushës do t'i caktohet jo data-koha aktuale, por një vlerë e një numëratori, e rritur me një. Si rezultat, kolonën row_ver do të ketë vlera unike dhe do të mund të përdoret jo vetëm për tregimin e «deltës» së të dhënave (të dhënave që janë shtuar/përmirësuar pas përfundimit të seancës së mëparshme të shkëmbimit), por edhe për ndarje të thjeshtë dhe efikase në faqe.
Mënyra e fundit e propozuar për minimizimin e sasisë së të dhënave të transferuara në kuadër të replikimit të nivelit të lartë, më duket më optimalja dhe më universale. Le të qëndrojmë në këtë në detaje.
Transferimi i të dhënave duke përdorur një numërues versionesh rreshti
Zbatimi i pjesës serveri/master
Në MS SQL Server, për realizimin e një qasjeje të tillë ekziston një tip i veçantë kolone — rowversion. Çdo DB ka një numërues, i cili rritet me një çdo herë që shtohet/përdoret një regjistrim në tabelën që ka një kolonë të tipit rowversion. Vlera e këtij numri automatizmi i jepet fushës së kësaj kolone në regjistrimin e shtuar/përdorur. DBMS Tarantool nuk ka një mekanizëm ndihmës të tillë të integruar. Megjithatë, në Tarantool, është e lehtë ta realizosh manualisht. Le të shohim se si bëhet kjo.
Fillimisht, pak terminologji: tabelat në Tarantool quhen hapësira (space) dhe regjistrimet — tuple. Në Tarantool, mund të krijosh sekuenca (sequence). Sekuencat janë thjesht krijues të emëruar të vlerave të renditura të numrave të tërë. Kjo është pikërisht ajo që na nevojitet për qëllimet tona. Më poshtë do të krijojmë një të tillë sekuencë.
Para se të bësh ndonjë operacion me bazën e të dhënave në Tarantool, duhet të ekzekutosh komandën e mëposhtme:
box.cfg{}Si rezultat, Tarantool do të fillojë të regjistrojë në katalogun aktual skedarët e BD (snapshot) dhe regjistrat e transaksioneve.
Le të krijojmë një sekuencë row_version:
box.schema.sequence.create('row_version',
    { if_not_exists = true })
Opcioni if_not_exists lejon ekzekutimin e skenarit të krijimit shumë herë: nëse objekti ekziston, Tarantool nuk do të përpiqet ta krijojë sërish. Kjo opsion do të përdoret në të gjitha komandat e tjera DDL.
Le të krijojmë një hapësirë për shembuj.
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        },
        {
            name = 'row_ver',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})
Këtu ne përcaktuam emrin e hapësirës (goods), emrat e fushave dhe llojet e tyre.
Fushat auto-increment në Tarantool krijohen gjithashtu me anë të sekuencave. Le të krijojmë një çelës primar auto-increment mbi fushën id:
box.schema.sequence.create('goods_id',
    { if_not_exists = true })
box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Tarantool mbështet disa lloje indeksesh. Më së shpeshti përdoren indekset e llojeve TREE dhe HASH, të cilat bazohen në struktura përkatëse. TREE është tipi më universale i indeksit. Ai lejon nxjerrjen e të dhënave në një rend të caktuar. Por për zgjedhje për barazim, HASH është më i përshtatshëm. Prandaj, për çelësin primar, është e arsyeshme të përdoret HASH (ashtu siç bëmë).
Për të përdorur kolonën row_ver për të transmetuar të dhënat e ndryshuara, është e nevojshme të lidhni vlerat e sekondës row_ver. Por ndryshe nga çelësi primar, vlera e fushës së kolonës row_ver duhet të rritet me njësi jo vetëm kur shtohen rekordet e reja, por gjithashtu kur ndryshohen ato ekzistuese. Për këtë, mund të përdoren triggera. Në Tarantool ka dy lloje triggerash për hapësira: before_replace dhe on_replace. Triggerat aktivizohen me çdo ndryshim të të dhënave në hapësirë (për çdo tuple të prekur nga ndryshimet, aktivizohet funksioni i triggerit). Ndryshe nga on_replace, before_replace-triggerat lejojnë modifikimin e të dhënave të tuple-it, për të cilin kryhet triggeri. Prandaj, na përshtatet tipi i fundit i triggerëve.
box.space.goods:before_replace(function(old, new)
    return box.tuple.new({new[1], new[2], new[3],
        box.sequence.row_version:next()})
end)
Triggeri i mësipërm zëvendëson vlerën e fushës row_ver në tuple-in e ruajtur me vlerën e ardhshme të sekondës row_version.
Për të shpërndarë të dhënat nga hapësira goods sipër kolonës row_ver, do të krijojmë një indeks:
box.space.goods:create_index('row_ver', {
    parts = { 'row_ver' },
    unique = true,
    type = 'TREE',
    if_not_exists = true
})
Tipi i indeksit është pemë (TREE), pasi na nevojitet të përfitojmë të dhënat në radhë në rritje të vlerave në kolonen row_ver.
Shtojmë disa të dhëna në hapësirë:
box.space.goods:insert{nil, 'pen', 123}
box.space.goods:insert{nil, 'pencil', 321}
box.space.goods:insert{nil, 'brush', 100}
box.space.goods:insert{nil, 'watercolour', 456}
box.space.goods:insert{nil, 'album', 101}
box.space.goods:insert{nil, 'notebook', 800}
box.space.goods:insert{nil, 'rubber', 531}
box.space.goods:insert{nil, 'ruler', 135}
Duke qenë se fusha e parë është një numërues automatik, kalojmë në vend të saj nil. Tarantool do të vendosë automatikisht vlerën e ardhshme. Në të njëjtën mënyrë, si vlera e fushave të kolonës row_ver mund të kaloni nil — ose të mos specifikoni vlerën fare, pasi kjo kolonë zë pozita e fundit në hapësirë.
Të kontrollojmë rezultatin e futjes:
tarantool> box.space.goods:select()
---
- - [1, 'stilus', 123, 1]
  - [2, 'pencil', 321, 2]
  - [3, 'brush', 100, 3]
  - [4, 'aquarelle', 456, 4]
  - [5, 'album', 101, 5]
  - [6, 'notebook', 800, 6]
  - [7, 'rubber', 531, 7]
  - [8, 'ruler', 135, 8]
...
Si e shohim, fusha e parë dhe e fundit u mbushën automatikisht. Tani do të jetë e lehtë të shkruajmë një funksion për shkarkimin e ndryshimeve me faqe. goods:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
Funksioni merr si parameter vlerën row_ver, nga e cila duhet të kryhet shkarkimi i ndryshimeve, dhe kthen një sasi të dhënash të ndryshuara.
Shkarkimi i të dhënave në Tarantool bëhet përmes indekseve. Funksioni get_goods përdor një iterator mbi indeksin row_ver për të marrë të dhënat e ndryshuara. Lloji i iteratorit është GT (Greater Than, më i madh se). Kjo do të thotë se iteratori do të bëjë një kalim të rregullt mbi vlerat e indeksit duke filluar nga çelësi i kaluar (vlera e fushës row_ver).
Iteratori kthen tuple. Për të pasur mundësi të dërgojmë më vonë të dhënat përmes HTTP, është e nevojshme të kryejmë konvertimin e tuple në një strukturë që është e përshtatshme për serializim të mëtejshëm. Në shembullin, për këtë përdoret funksioni standard tomap. Në vend që të përdorim tomap mund të shkruajmë një funksion tonin. Për shembull, ne mund të dëshirojmë të riformulojme fushën emri, të mos e dërgojmë fushën code dhe të shtojmë fushën comment:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'disa komente'
    obj.row_ver = tuple.row_ver
    return obj
end
Madhësia e faqes së të dhënave të dhëna (numri i regjistrimeve në një sasi) përcaktohet nga variabla page_size. Në shembull, vlera page_size njësoj 5. Në një program real, shkalla e faqes zakonisht ka më shumë rëndësi. Ajo varet nga madhësia mesatare e tuples i hapësirës. Madhësia optimale e faqes mund të përcaktohet në mënyrë eksperimentale duke matur kohën e transmetimit të të dhënave. Sa më e madhe të jetë madhësia e faqes, aq më pak runda ka ndërmjet palës dërguese dhe të pranueses. Kështu mund të reduktohet koha totale e shkarkimit të ndryshimeve. Megjithatë, me një madhësi shumë të madhe të faqes, do të kalojmë shumë kohë duke zënë serverin për serializimin e zgjedhjes. Si rezultat, mund të ndodhin vonesa në përpunimin e kërkesave të tjera që arrijnë në server. Parametri page_size mund të ngarkohet nga skedari i konfigurimit. Për çdo hapësirë të dërguar mund të caktohet një vlerë e vetme. Megjithatë, për shumicën e hapësirave mund të përshtatet vlera e paracaktuar (p.sh. 100).
Të ekzekutojmë funksionin get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: stilolaps
    id: 1
  - row_ver: 2
    code: 321
    name: laps
    id: 2
  - row_ver: 3
    code: 100
    name: brush
    id: 3
  - row_ver: 4
    code: 456
    name: akvarel
    id: 4
  - row_ver: 5
    code: 101
    name: album
    id: 5
...
Të marrim vlerën e fushës row_ver nga rreshti i fundit dhe të thërrasim përsëri funksionin:
tarantool> get_goods(5)

---
- - row_ver: 6
    code: 800
    name: blloknotë
    id: 6
  - row_ver: 7
    code: 531
    name: goma
    id: 7
  - row_ver: 8
    code: 135
    name: qull
    id: 8
...
Dhe një herë tjetër:
tarantool> get_goods(8)
---
- []
...
Siç shohim, me këtë përdorim, funksioni kthen të dhënat faqë-për-façë. goodsPas faqes së fundit, vjen një zgjedhje e zbrazët.
Të bëjmë ndryshime në hapësirë:
box.space.goods:update(4, {{'=', 6, 'libër'}})
box.space.goods:insert{nil, 'clips', 234}
box.space.goods:insert{nil, 'folder', 432}
Ne ndryshuam vlerën e fushës emri për një regjistrim dhe shtuam dy regjistrime të reja.
Të përsërisim thirrjen e fundit të funksionit:
tarantool> get_goods(8)
---


- - row_ver: 9
    code: 800
    name: libër
    id: 6
  - row_ver: 10
    code: 234
    name: clips
    id: 9
  - row_ver: 11
    code: 432
    name: folder
    id: 10
...
Funksioni ktheu regjistrimet e ndryshuara dhe ato të reja të shtuara. Në këtë mënyrë, funksioni get_goods lejon marrjen e të dhënave të ndryshuara që nga thirrja e fundit, e cila është baza e metodës së shqyrtuar të replikimit.
Do ta lëmë daljen e rezultateve përmes HTTP në formën e JSON jashtë këtij artikulli. Rreth kësaj mund të lexoni këtu:
Implementimi i pjesës klient/slave
Le të shohim se si duket implementimi i anës pritëse. Të krijojmë në anën pritëse një hapësirë për të ruajtur të dhënat e ngarkuara:
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Struktura e hapësirës i ngjan asaj të burimit. Por duke qenë se nuk kemi ndërmend të transferojmë të dhënat e marra diku tjetër, kolona row_ver në hapësirën e marrësit mungon. Në fushën id do të regjistrohen identifikuesit e burimit. Prandaj, nga ana e marrësit nuk ka nevojë ta bëjmë atë me auto-increment.
Përveç kësaj, na nevojitet një hapësirë për të ruajtur vlerat row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Për çdo hapësirë që po ngarkohet (fusha space_name) do të ruajmë këtu vlerën e fundit të ngarkuar row_ver (fusha vlera). Si çelësi primar shërben kolona space_name.
Do të krijojmë një funksion për të ngarkuar të dhënat e hapësirës goods përmes HTTP. Për këtë na nevojitet një bibliotekë që implementon klientin HTTP. Rreshti i mëposhtëm ngarkon bibliotekën dhe krijon një instancë të klientit HTTP:
local http_client = require('http.client').new()Na nevojitet gjithashtu një bibliotekë për deserializimin e json:
local json = require('json')Kjo është e mjaftueshme për të krijuar funksionin e ngarkimit të të dhënave:
local function load_data(url, row_ver)
    local url = ('%s?rowVer=%s'):format(url,
        tostring(row_ver))
    local body = nil
    local data = http_client:request('GET', url, body, {
        keepalive_idle =  1,
        keepalive_interval = 1
    })
    return json.decode(data.body)
end
Funksioni kryen një kërkesë HTTP në adresën url, kalon në të row_ver si parametër dhe kthen rezultatin e deserializuar të kërkesës.
Funksioni për ruajtjen e të dhënave të marra duket si më poshtë:
local function save_goods(goods)
    local n = #goods
    box.atomic(function()
        for i = 1, n do
            local obj = goods[i]
            box.space.goods:put(
                obj.id, obj.name, obj.code)
        end
    end)
end
Cikli i ruajtjes së të dhënave në hapësirë goods është vendosur në një transaksion (për këtë përdoret funksioni box.atomic) për të reduktuar numrin e operacioneve me diskun.
Finalmente, funksioni për sinkronizimin e hapësirës lokale goods me burimin mund të realizohet kështu:
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
Së pari, lexojmë vlerën e ruajtur më parë row_ver për hapësirën goods. Nëse ajo mungon (seanca e parë e shkëmbimit), ndalim si row_ver zero. Then in the loop, we perform page-wise loading of modified data from the source via the specified url. On each iteration, we save the retrieved data in the corresponding local space and update the value row_ver (in the space row_ver and in the variable row_ver) — we take the value row_ver from the last line of the retrieved data.
To protect against accidental looping (in case of an error in the program), the loop while can be replaced with për:
for _ = 1, max_req do ... As a result of executing the function sync_goods space goods in the receiver will contain the latest versions of all records from the space goods in the source.
It is obvious that this method cannot be used to transmit data deletion. If such a need exists, a deletion mark can be used. We add to the space goods a boolean field is_deleted and instead of physically deleting a record, we use logical deletion — we set the field value is_deleted në vlerën true. Sometimes, instead of a boolean field is_deleted it is more convenient to use a field deletedthat stores the date-time of logical deletion of the record. After performing logical deletion, the marked record will be transmitted from the source to the receiver (according to the logic discussed above).
The sequence row_ver can be used to transfer data from other spaces: there is no need to create a separate sequence for each space being transmitted.
We have reviewed an efficient method of high-level data replication in applications using the Tarantool DBMS.
Përfundimet
- The Tarantool DBMS is an attractive, promising product for creating high-load applications.
- High-level data replication has several advantages over low-level replication.
- The method discussed in the article of high-level replication allows minimizing the amount of transmitted data by transmitting only those records that have changed since the last exchange session.
Burimi: habr.com
