

Një nga skenarët tipikë në të gjitha aplikacionet që njohim është kërkimi i të dhënave sipas kritereve të caktuara dhe paraqitja e tyre në një format të lehtë për t'u lexuar. Këtu mund të ketë mundësi shtesë për renditje, grupim dhe shfaqje të faqeve. Detyra, në parim, është triviale, por gjatë zgjidhjes së saj shumë zhvillues bëjnë një sërë gabimesh, për shkak të të cilave vuajnë më pas performancën. Le të shqyrtojmë variantet e ndryshme të zgjidhjes së kësaj detyre dhe të formulojmë rekomandime për zgjedhjen e implementimit më efikas.
Varianti i faqeve #1
Varianti më i thjeshtë që vjen në mendje është shfaqja e rezultateve të kërkimit në mënyrën e saj më klasike.
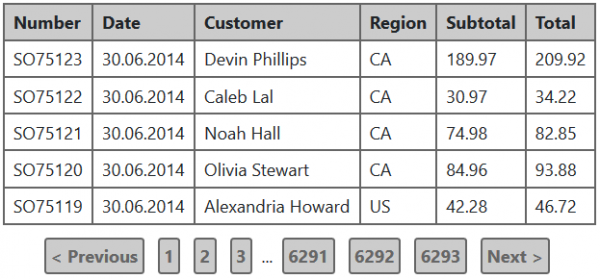
Supozoni se aplikacioni përdor një databazë relacionale. Në këtë rast, për të shfaqur informacionin në një format të tillë, do të nevojitet të kryhen dy kërkesa SQL:
- Merrni rreshtat për faqen aktuale.
- Numëroni numrin total të rreshtave që përputhen me kriteret e kërkimit — ky informacion është i nevojshëm për të treguar faqet.
Le të shqyrtojmë kërkesën e parë në shembullin e databazës testuese MS SQL për serverin 2016. Për këtë qëllim do të përdorim tabelën Sales.SalesOrderHeader:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Kërkesa e mësipërme do të nxjerrë 50 porositë e para nga lista, të renditura sipas datës së shtimit, me fjalë të tjera — 50 porositë e fundit.
Ajo ekzekutohet shpejt në databazën testuese, por le të shohim planin e ekzekutimit dhe statistikat e input-it dhe output-it:
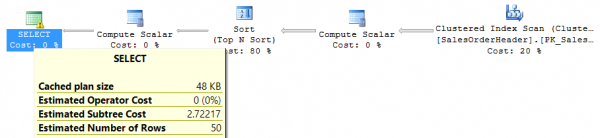
Tabela 'SalesOrderHeader'. Numri i skanimeve 1, lexime logjike 698, lexime fizike 0, lexime paraprakisht të lexuara 0, lexime logjike të lobit 0, lexime fizike të lobit 0, lexime paraprakisht të lobit 0.Statistikat e input-it/output-it për çdo kërkesë mund të merren duke ekzekutuar në ambientin e ekzekutimit të kërkesave komandën SET STATISTICS IO ON.
Siç shihet nga plani i ekzekutimit, më e konsumueshme për burime është renditja e të gjitha rreshtave të tabelës fillestare sipas datës së shtimit. Dhe problemi është që sa më shumë të shtohen rreshta në tabelë, aq 'më e rëndë' do të bëhet renditja. Në praktikë, situata të tilla duhet shmangur, prandaj do të shtojmë një indeks në datën e shtimit dhe të shohim nëse është ndryshuar konsumi i burimeve:
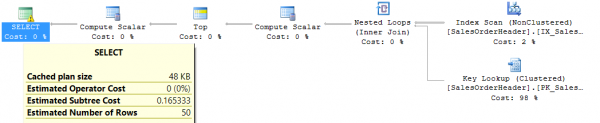
Tabela 'SalesOrderHeader'. Numri i skanimeve 1, lexime logjike 165, lexime fizike 0, lexime paraprakisht të lexuara 5, lexime logjike të lobit 0, lexime fizike të lobit 0, lexime paraprakisht të lobit 0.
Në mënyrë të qartë, gjërat janë përmirësuar shumë. Por janë zgjidhur të gjitha problemet? Të ndryshojmë kërkesën për të gjetur porosi, ku vlera totale e mallrave kalon 100 dollarë:
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
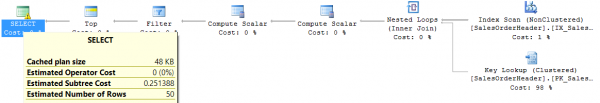
Tabela 'SalesOrderHeader'. Numri i skanimeve 1, lexime logjike 1081, lexime fizike 0, lexime përpara 0, lexime logjike lob 0, lexime fizike lob 0, lexime përpara lob 0.Kemi një situatë interesante: plani i kërkesës nuk është shumë më i keq se ai paraprak, por numri i vërtetë i leximeve logjike është gati dy herë më i lartë se kur skanohet tabela në tërësi. Ka një zgjidhje — nëse nga indeksi ekzistues krijojmë një indeks të përbërë dhe shtojmë si fushë të dytë vlerën totale të mallrave, atëherë përsëri do të arrijmë 165 lexime logjike:
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Kjo seri shembujsh mund të vazhdojë për një kohë të gjatë, por dy mendimet kryesore që dëshiroj të shpreh këtu janë:
- Shtimi i çdo kriteri të ri ose renditjes në kërkesën e kërkimit mund të ndikojë ndjeshëm në shpejtësinë e ekzekutimit të saj.
- Por nëse na nevojitet të lexojmë vetëm një pjesë të të dhënave dhe jo të gjitha rezultatet që plotësojnë kushtet e kërkimit — ka shumë mënyra për të optimizuar një kërkesë të tillë.
Tani, le të kalojmë te kërkesa e dytë, e përmendur në fillim — ajo që numëron numrin e regjistrimeve që plotësojnë kriterin e kërkimit. Të marrim të njëjtin shembull — kërkesa për porosi që janë më të shtrenjta se 100 dollarë:
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
Në prani të indeksit të përbërë, të përmendur më lart, marrim:
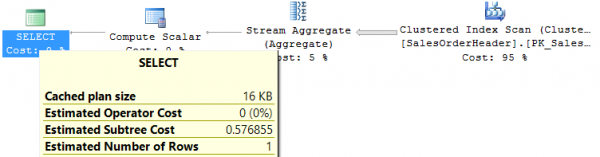
Tabela 'SalesOrderHeader'. Numri i skanimeve 1, lexime logjike 698, lexime fizike 0, lexime paraprakisht të lexuara 0, lexime logjike të lobit 0, lexime fizike të lobit 0, lexime paraprakisht të lobit 0.Ajo që kërkesa kalon krejt indeksin nuk është befasi, pasi fusha SubTotal nuk është në pozitat e para, prandaj kërkesa nuk mund ta përdorë atë. Problemi zgjidhet duke shtuar një tjetër indeks në fushën SubTotal, dhe rezultati është tashmë 48 lexime logjike.
Mund të japim edhe disa shembuj të tjerë të kërkesave për numërim, por thelbi do të mbetet i njëjtë: marrja e një pjese të të dhënave dhe numërimi i shumës totale — janë dy kërkesa thelbësisht të ndryshme, dhe secila kërkon masat e veta për optimizim. Në përgjithësi nuk do të mund të gjejmë një kombinim indeksesh që funksionon njësoj mirë për të dyja kërkesat.
Prandaj, një nga kërkesat e rëndësishme që duhet të sqarojmë gjatë zhvillimit të këtij zgjidhje kërkimi është nëse për biznesin është e rëndësishme të shohë numrin e përgjithshëm të objekteve të gjetura. Muitas herë ndodh që nuk është. Dhe navigimi përmes numrave specifikë të faqes, në mendimin tim, është një zgjidhje me një gamë përdorimi shumë të ngushtë, pasi shumica e skenarëve me paging duket si "kaloni në faqen e ardhshme".
Një variant i paging-ut #2
Supozoni se për përdoruesit nuk është e rëndësishme të dinë numrin e përgjithshëm të objekteve të gjetura. Le të përpiqemi ta thjeshtojmë faqen e kërkimit:
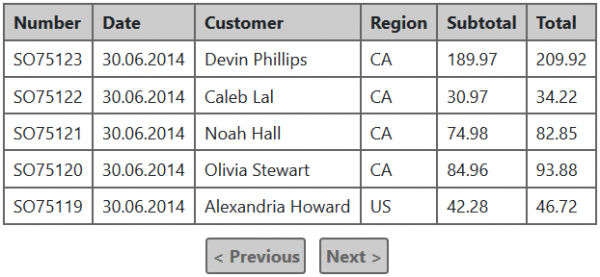
Në fakt, ndryshimi i vetëm është se nuk ka mundësi për të kaluar në numra specifikë të faqeve, dhe tani kjo tabelë për të treguar nuk ka nevojë të dijë se sa ka gjithsej. Por lind pyetja - si do ta dijë tabela nëse ka të dhëna për faqen e ardhshme (për të shfaqur saktësisht lidhjen "Të ardhshme")?
Përgjigja është shumë e thjeshtë: mund të lexojmë nga baza më një rekord më shumë se sa nevojitet për shfaqje, dhe ekzistenca e këtij "rekordi shtesë" do të tregojë nëse ka një sasi tjetër. Kështu, për të marrë një faqe të dhënash, do të nevojitet të kryhet vetëm një kërkesë, që ndjeshëm përmirëson performancën dhe lehtëson mbështetje të tillë funksionaliteti. Kam pasur një rast në praktikë kur heqja e numërimit të përgjithshëm të regjistrimeve përshpejtoi ofrimin e rezultateve 4-5 herë.
Për këtë qasje ekzistojnë disa variante të ndërfaqes së përdoruesit: komandat "prapa" dhe "përpara", si në shembullin më sipër, butoni "ngarko më shumë", i cili thjesht shton një grup të ri në rezultatet e shfaqura, "rrotullim i pafund", i cili funksionon sipas parimit "ngarko më shumë", por sinjali për të marrë sasinë tjetër është rrotullimi nga përdoruesi të gjithë rezultateve të shfaqura deri në fund. Cila do qoftë zgjidhja vizuale, parimi i marrjes së të dhënave mbetet i njëjtë.
Detajet e realizimit të paging-ut
Në të gjitha shembujt e kërkesave të paraqitura më sipër, përdoret qasja "shkalla + sasi", kur në vetë kërkesën tregohen nga cilat rreshta të rezultatit dhe sa rreshta duhet të kthehen. Fillimisht, le të shohim si është më mirë të organizojmë kalimin e parametrave në këtë rast. Në praktikë kam takuar disa mënyra:
- Numri rendor i faqes se kerkuar (pageIndex), madhesia e faqes (pageSize).
- Numri rendor i shenjestruese se pare (startIndex), numri maksimal i shenjestrimeve ne rezultat (count).
- Numri rendor i shenjestruese se pare (startIndex), numri rendor i shenjestruese se fundit (endIndex).
Në shikim të parë, mund të duket se kjo është aq elementare sa nuk ka ndonjë ndryshim. Por nuk është kështu — opsioni më i përshtatshëm dhe universale është i dyti (startIndex, count). Ka disa arsye për këtë:
- Për qasjen me leximin +1 shenjestrues, e përmendur më lart, opsioni i parë me pageIndex dhe pageSize është tepër i paarsyeshëm. Për shembull, duam të shfaqim 50 shenjestra në faqe. Sipas algoritmit të përmendur më parë, duhet të lexojmë një shenjestër më shumë se sa duam. Nëse ky "+1" nuk është caktuar në server, rezulton se për faqen e parë duhet të kërkojmë shenjestra nga 1 në 51, për të dytën — nga 51 në 101 dhe kështu me radhë. Nëse caktojmë madhësinë e faqes 51 dhe rrisim pageIndex, atëherë faqa e dytë do të kthejë nga 52 në 102 dhe kështu me radhë. Prandaj, në opsionin e parë, mënyra e vetme për të realizuar normalisht butonin për të kaluar në faqen tjetër është të caktosh në server leximin e "shenjës" së tepërt, që do të ishte një detaj shumë i paqartë.
- Opsioni i tretë nuk ka kuptim në tërësi, sepse për të kryer kërkesa në shumicën e bazave të të dhënave gjithmonë do të duhet të japësh numrin, jo indeksin e shenjestrës së fundit. Le të thjeshtësojmë se heqja e startIndex nga endIndex është një operacion i thjeshtë aritmetik, por këtu është e panevojshme.
Tani duhet të përshkruajmë disavantazhet e implementimit të paging-ut përmes "offset + numri":
- Marrja e çdo faqeje tjetër do të jetë më e shtrenjtë dhe më e ngadaltë se ajo paraprake, sepse baza e të dhënave gjithsesi do të duhet të kalojë përmes të gjitha shenjestrave "nga fillimi" sipas kritereve të kërkimit dhe renditjes, e më pas të ndalet në fragmentin e duhur.
- Jo të gjitha SGBD-të mund të mbështesin këtë qasje.
Ka alternativa, por ato gjithashtu nuk janë perfekte. Qasja e parë e tillë quhet "keyset paging" ose "metoda e kërkimit" dhe përfshin: pas marrjes së një sasie mund të ruani vlerat e fushave në shenjen e fundit të faqes, dhe më pas t'i përdorni ato për të marrë sasitë e tjera. Për shembull, ne kemi kryer një kërkesë të tillë:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Dhe në regjistrimin e fundit, morëm vlerën e datës së porosisë '2014-06-29'. Atëherë për të marrë faqen tjetër, mund të përpiqemi të kryejmë diçka të tillë:
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Problemi është se OrderDate është një fushë jo unike dhe kushte e cila është cituar më sipër, ka mundësi të madhe të kalojë shumë rreshta të nevojshëm. Për të sjellë qartësi në këtë kërkesë, është e nevojshme të shtohet në kushtin një fushë unike (të supozojmë se 75074 është vlera e fundit e çelësit kryesor nga porcja e parë):
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Ky variant do të funksionojë saktë, por në përgjithësi do të jetë e vështirë ta optimizosh, pasi kushti përmban operatorin OR. Nëse me rritjen e OrderDate, rritet edhe vlera e çelësit kryesor, atëherë kushti mund të thjeshtohet, duke lënë vetëm filtrin e SalesOrderID. Por nëse midis vlerave të çelësit kryesor dhe fushës sipas së cilës është renditur rezultati, nuk ka një korelacion të qartë — në shumicën e DBM-ve do të jetë e pamundur të shmangesh këtë OR. Një përjashtim i njohur për mua është PostgreSQL, ku mbështetet plotësisht krahasimi i tuple-ave, dhe kushte e cituar më sipër mund të shkruhet si "WHERE (OrderDate, SalesOrderID) < ('2014-06-29', 75074)". Nëse ekziston një çelës i përbërë me këto dy fusha, një kërkesë e tillë duhet të jetë mjaft e lehtë.
Një qasje alternative e dytë mund të gjendet, për shembull, në ose — kur kërkesa, përveç të dhënave, kthen një identifikues të veçantë, me anë të së cilit mund të marrësh porcionin tjetër të të dhënave. Nëse ky identifikues ka një afat të pakufizuar (si në Comsos DB), atëherë ky është një mënyrë e shkëlqyer për të realizuar faqosjen me kalimin e vazhdueshëm mes faqeve (varianti #2 i përmendur më sipër). Disavantazhet e tij të mundshme: mbështetet shumë pak në të gjitha DBM-të; identifikuesi i marrë për porcionin tjetër mund të ketë një afat të kufizuar, që në përgjithësi nuk i përshtatet realizimit të ndërveprimit me përdoruesin (si, për shembull, ElasticSearch scroll API).
Filtrimi i komplikuar
Po ecur me sfidimin. Supozoni se ka pasur një kërkesë për të realizuar atë që quhet kërkim i faceted, i njohur mirë nga dyqanet online. Shembujt e mësipërm të bazuar në tabelën e porosive nuk janë shumë tregues në këtë rast, kështu që do të kalojmë në tabelën Product nga baza AdventureWorks:
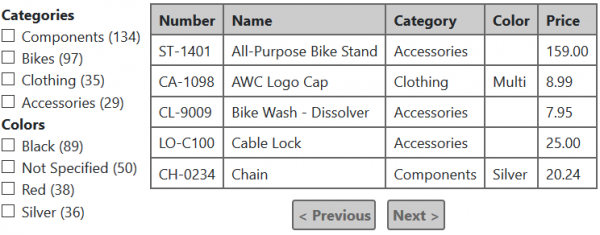
Cila është ideja e kërkimit faceted? Ajo është që për çdo element filtri të tregojë numrin e regjistrimeve që përputhen me këtë kriter. duke marrë parasysh filtrat e zgjedhur në të gjitha kategoritë e tjera..
Për shembull, nëse ne zgjedhim në këtë shembull kategorinë Bikes dhe ngjyrën Black, tabela do të tregojë vetëm biçikleta me ngjyrë të zezë, por për këtë:
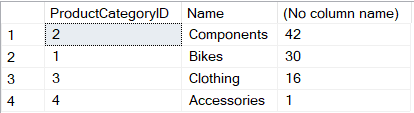
- Për çdo kriter të grupit «Categories» do të tregohet numri i produkteve nga kjo kategori me ngjyrë të zezë.
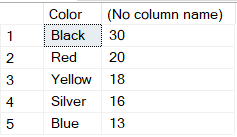
- Për çdo kriter të grupit «Colors» do të tregohet numri i biçikletave në këtë ngjyrë.
Ja një shembull i rezultatit të daljes për këto kushte:
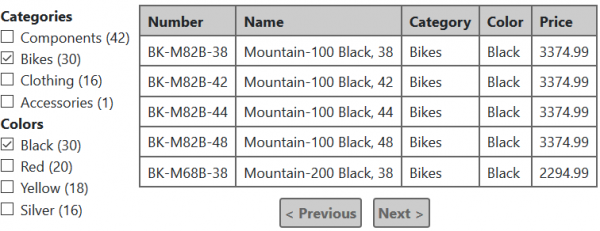
Nëse për më tepër shënojmë kategorinë «Clothing», tabela do të tregojë gjithashtu dhe veshjet me ngjyrë të zezë që janë në dispozicion. Numri i produkteve me ngjyrë të zezë në seksionin «Color» gjithashtu do të ri-kalkulohet sipas kushteve të reja, vetëm në seksionin «Categories» nuk do të ndryshojë asgjë... Shpresoj se këto shembuj janë të mjaftueshëm për të kuptuar algoritmin e zakonshëm të funksionimit të kërkimit faceted.
Tani le të imagjinojmë se si mund të realizohet kjo në një bazë të dhënash relacional. Çdo grup kriteresh, si Kategoria dhe Ngjyra, do të kërkojë një kërkesë të veçantë:
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bikes
GROUP BY Color
ORDER BY COUNT(1) DESC
Cili është problemi me këtë zgjidhje? Shumë thjesht - ajo nuk është e shkallëzueshme. Çdo seksion filtri kërkon një kërkesë të veçantë për llogaritjen e numërave dhe këto kërkesa nuk janë të lehta. Në dyqanet online, në disa kategori mund të ketë edhe disa dhjetëra seksione filtrore, që mund të përbëjë një problem të rëndësishëm për performancën.
Zakonisht pas këtyre pohimeve, më ofrojnë disa zgjidhje, dmth:
- Bashkoni të gjitha numërimet në një kërkesë. Në mënyrë teknike, kjo është e mundur me përdorimin e fjalës kyçe UNION, por kjo nuk ndihmon shumë në përformancë — ende do të duhet që baza e të dhënave të ekzekutojë "nga e para" secilin nga fragmentet.
- Keshoni numërimet. Kjo më sugjerohet pothuajse çdo herë kur përshkruaj problemin. Problemi është se në përgjithësi kjo është e pamundur. Supozoni se kemi 10 "facetë", secila me 5 vlera. Kjo është një situatë shumë "skromë" krahasuar me atë që mund të shohim në të njëjtat dyqane online. Zgjedhja e një elementi të facetës ndikon në numrat në 9-të të tjera, në other words, për secilën kombinim kriteresh, numrat mund të jenë të ndryshëm. Në total, në shembullin tonë ka 50 kritere që përdoruesi mund të zgjedhë, prandaj kombinimet e mundshme do të jenë 250. Koha dhe memorie nuk do të mjaftojnë për të mbushur një masiv të tillë të dhënash. Këtu dikush mund të kundërshtojë dhe të thotë se jo të gjitha kombinimet janë reale dhe përdoruesi rrallë zgjedh më shumë se 5-10 kritere. Po, është e mundur të bëhet një ngarkesë e përmbysur dhe të kesh numërimin vetëm për atë që është zgjedhur ndonjëherë, por sa më shumë të jenë opsionet e zgjedhjes, aq më pak efektiv do të jetë ky kesh dhe aq më të dukshme do të jenë probleme me kohën e përgjigjes (sidomos nëse grumbulli i të dhënave ndryshon rregullisht).
Fatmirësisht, një detyrë e tillë tashmë ka zgjidhje të mjaftueshme efektive, që punojnë parashikueshëm me sasi të mëdha të dhënash. Për secilin prej këtyre opsioneve ka kuptim të ndahet ri-caktoja e facetëve dhe marrja e faqes së rezultateve në dy kërkesa paralele në server dhe të organizohet ndërfaqja e përdoruesit në mënyrë që ngarkimi i të dhënave për facetët "të mos pengojë" paraqitjen e rezultateve të kërkimit.
- Thirrni rikapitulimin e "faceteve" sa më rrallë të jetë e mundur. Për shembull, mos e rikapitulloni gjithçka për çdo ndryshim kriteri kërkese, por në vend të kësaj gjeni numrin total të rezultateve që përgjigjen kushteve aktuale dhe ofroni përdoruesit të tregoni ato — "1425 regjistrime të gjetura, të tregoni?" Përdoruesi mund të vazhdojë të ndryshojë kushtet e kërkesës ose të klikojë butonin "tregoni". Vetëm në këtë rast do të kryhen të gjitha kërkesat për marrjen e rezultateve dhe rikapitullimin e numrave në të gjitha "facetet". Në këtë kontekst, është e qartë se do të duhet të merret me kërkesën për marrjen e numrit total të rezultateve dhe optimizimin e saj. Ky mënyrë mund të haset në shumë dyqane të vogla online. Është e qartë se kjo nuk është një ilaç për këtë problem, por në raste të thjeshta mund të jetë një kompromis i mirë.
- Përdorni motorë kërkimi për të gjetur rezultate dhe numëruar facetet, si Solr, ElasticSearch, Sphinx dhe të tjerë. Të gjitha ato janë të dizajnuara për ndërtimin e "faceteve" dhe e bëjnë këtë mjaft efektivisht përmes indekseve të inversuara. Si funksionojnë sistemet e kërkimit, pse ato janë më efikase në këto raste se bazat e të dhënave me qëllim të përgjithshëm, çfarë janë praktikat dhe pengesat — kjo është një temë për një artikull të veçantë. Këtu dua të theksoj se motorët e kërkimit nuk mund të zëvendësojnë depozitat primare të të dhënave, por përdoren si një shtesë: çdo ndryshim në bazën e të dhënave kryesore, që ka rëndësi për kërkimin, sinkronizohet në indeksin e kërkimit; mekanizmi i kërkimit ndërvepron zakonisht vetëm me motorin e kërkimit dhe nuk i drejtohet bazës kryesore. Një nga piketat më të rëndësishme këtu është se si ta organizoni këtë sinkronizim në mënyrë të besueshme. Të gjitha varen nga kërkesat për "kohën e reagimit". Nëse koha midis ndryshimit në bazën kryesore dhe "nderhyrjes" së tij në kërkim nuk është kritike, mund të krijoni një shërbim që çdo disa minuta kërkon regjistrimet e ndryshuara së fundmi dhe i indekson ato. Nëse kërkohet koha minimale e mundshme e reagimit, mund të realizoni diçka si për të dërguar përditësimet në shërbimin e kërkimit.
Përfundimet
- Realizimi i paginimit në anën e serverit është një komplikim serioz, dhe ka kuptim ta aplikohet vetëm për grupe të dhënash që rriten shpejt ose thjesht janë të mëdha. Si të vlerësojmë "të madhe" ose "shpejt rritëse" — nuk ka një recetë absolutisht të saktë, por unë do të ndjekja këtë qasje:
- Nëse marrja e koleksionit të plotë të të dhënave duke marrë parasysh kohën në server dhe transmetimin në rrjet është brenda kërkesave të performancës — nuk ka kuptim të implementohet paginimi në anën e serverit.
- Mund të ndodhë që në periudhën afatshkurtër nuk parashikohet ndonjë problem me performancën, sepse të dhënat janë të pakta, por koleksioni i të dhënave po rritet vazhdimisht. Nëse ndonjë grup të dhënash në perspektivë mund të nuk përmbushë pikën e mëparshme — është më mirë të parashikohet paginimi menjëherë.
- Nëse nuk ka një kërkesë strikte nga biznesi për të treguar numrin total të rezultateve ose për të shfaqur numrat e faqeve, dhe po ashtu në sistemin tuaj nuk ka një motor kërkimi — është më mirë që këto çështje të mos realizohen dhe të shqyrtohet varianti #2.
- Nëse ka një kërkesë të qartë për kërkimin me fasetat, ju keni dy mundësi për të mos sakrifikuar performancën:
- Mos e ribljeni të gjitha numrat në çdo ndryshim të kritereve të kërkimit.
- Përdorni motorë kërkimi si Solr, ElasticSearch, Sphinx dhe të tjerë. Por duhet kuptuar se ai nuk mund të jetë zëvendësues i bazës kryesore të të dhënave, dhe duhet të përdoret si një shtesë për magazinën kryesore për të trajtuar problemet e kërkimit.
- Po ashtu, në rastin e kërkimit me fasetat, ka kuptim të ndahen marrja e faqes së rezultateve të kërkimit dhe numërimi i sasisë në dy kërkesa paralele. Numërimi i sasisë mund të marrë më shumë kohë sesa marrja e rezultateve, ndërsa rezultatet janë më të rëndësishme për përdoruesin.
- Nëse përdorni një bazë të dhënash SQL për kërkimin, çdo ndryshim në kod që lidhet me këtë pjesë duhet të testohet mirë në lidhje me performancën në volumet përkatëse të të dhënave (që tejkalojnë volumin në bazën "live"). Gjithashtu, është e dëshirueshme të përdoret monitorimi i kohës së ekzekutimit të kërkesave në të gjitha instancat e bazës, sidomos — në "live". Edhe nëse në fazën e zhvillimit planet e kërkesave ishin në rregull, me rritjen e volumit të të dhënave, situata mund të ndryshojë ndjeshëm.
Burimi: habr.com
