

Ju lutem, njihuni me përmbledhjen e referatit të fillimit të vitit 2020 nga Georgy Rylov "WAL-G: mundësi të reja dhe zgjerimi i komunitetit"
Maintainerët e open-source përballen me shumë probleme ndërsa rriten. Si të shkruajmë më shumë funksione të kërkuara, të zgjidhim më shumë issues dhe të përballim më shumë pull requestë? Në shembullin e WAL-G (mjeti i backup-it për PostgreSQL), do t'ju tregoj si i zgjidhëm këto probleme duke filluar një kurs për zhvillimin Open-source në universitet, çfarë arritëm dhe ku do shkojmë më pas.
Përsëri përshëndetje të gjithëve! Unë jam zhvillues në Yandex nga Ekaterinburg. Dhe sot do t'u flas për WAL-G.
Në titullin e referatit nuk u tha se është diçka në lidhje me backup-et. A ka ndonjë që nuk e di çfarë është WAL-G? Apo të gjithë e dinë? Ngriheni dorën nëse nuk e dini. Wow, erdhët në referat dhe nuk e dini për çfarë është.
Le të flas për atë që do të ndodhë sot. Rasti është i tillë që ekipi ynë është angazhuar prej shumë kohësh në backup-ing. Dhe ky është një tjetër referat në serinë ku ne flasim për mënyrat se si ruajmë të dhënat në një mënyrë të sigurt, të besueshme, të lehtë dhe efektive.
Në seritë e mëparshme ka pasur shumë referate nga Andrey Borodin, Vladimir Leskov. Ne ishim shumë. Dhe të gjithë kemi folur për WAL-G për shumë vite.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Ky referat do të distingojë pak nga të tjerët, sepse atje kishte për më shumë pjesën teknike, ndërsa këtu do të tregoj për problemet që përballëm lidhur me rritjen e komunitetit. Dhe si u mendua një ide e vogël që na ndihmon të përballojmë këtë.
Disa vite më parë, WAL-G ishte një projekt mjaft i vogël, që na erdhi nga Citus Data. Dhe ne e morëm atë. Dhe dikush e zhvillonte vetëm.
Dhe vetëm në WAL-G mungonte:
- Backup-i nga replika.
- Nuk kishte backup-e inkrementale.
- Nuk kishte backup-e WAL-Delta.
- Dhe kishte shumë më tepër që mungonte.
Në këto disa vite, WAL-G është rritur shumë.
Dhe deri në vitin 2020, gjithçka e përmendur më sipër kishte dalë. Dhe për këtë është shtuar se tani kemi:
- Më shumë se 1,000 yje në GitHub.
- 150 fork-e.
- Rreth 15 PR të hapur.
- Dhe shumë kontribues të tjerë.
- Dhe issues të hapura vazhdimisht. Dhe kjo ndodh kur ne përditë bazojmë, bëjmë diçka me këtë.
Dhe ne erdhëm në përfundimin se ky projekt kërkon më shumë vëmendjen tonë, madje edhe kur ne vetë nuk na nevojitet të realizojmë diçka për shërbimin tonë Managed Databases në Yandex.
Dhe diku në vjeshtën e vitit 2018, na erdhi një ide. Zakonisht, ekipi ka disa mënyra për të zhvilluar disa veçori, për të riparuar gabimet, nëse nuk keni mjaft njerëz. Për shembull, mund të punësoni një zhvillues të ri dhe t'i paguani atij para. Ose mund të merrni një praktikant për një periudhë kohe dhe gjithashtu t'i paguani atij një pagë. Por ka gjithashtu një grup të madh njerëzish, disa prej të cilëve tashmë dinë të shkruajnë kod. Thjesht nuk e dini gjithmonë se çfarë cilësie ka ky kod.
Ne menduam dhe vendosëm të përpiqemi të tërheqim studentë. Por studentët nuk do të marrin pjesë në gjithçka. Ata do të bëjnë vetëm një pjesë të punës. Dhe, për shembull, do të shkruajnë teste, do të riparojnë gabimet, do të realizojnë veçori që nuk prekin funksionalitetin kryesor. Funkcionaliteti kryesor është krijimi i kopjeve rezervë dhe rikthimi i kopjeve rezervë. Nëse lejohet një gabim në krijimin e një kopje rezervë, do të kemi humbje të të dhënave. Dhe askush nuk do të dëshironte që kjo të ndodhte. Të gjithë duan që gjithçka të jetë shumë e besueshme. Prandaj, ne sigurisht që nuk dëshirojmë të lejojmë kodin që i besojmë më pak se tonin tonë të hyjë atje. Pra, çdo kod jo kritik – është ajo që do të dëshironim të merrnim nga duar të tjera të punës.
Nën cilat kushte pranohet PR i studentëve
- Ata janë të detyruar të mbulojnë kodin e tyre me teste. Gjithçka duhet të kalojë në CI.
- Dhe gjithashtu kalojmë 2 rishikime. Një nga Andrei Borodin dhe një nga unë.
- Dhe përveç kësaj, për të kontrolluar se kjo nuk do të prishë asgjë në shërbimin tonë, unë ngarkoj veçmas një ndërtim me këtë angazhim. Dhe ne kontrollojmë në testet end-to-end, që asgjë nuk dështonte.
Kurs i veçantë për Open Source
Pak për atë se përse është e nevojshme dhe pse kjo, më duket, është një ide e shkëlqyer.
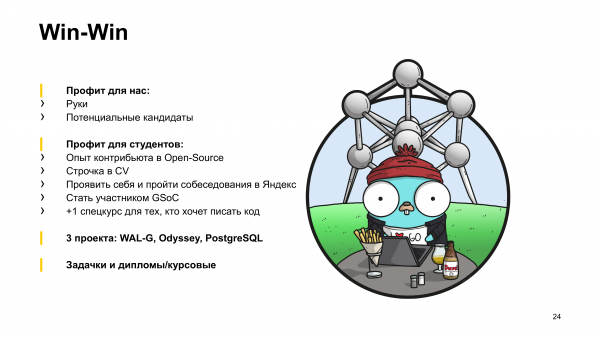
Për ne, përfitimi është i qartë:
- Ne marrim duar të tjera.
- Dhe kërkojmë kandidatë për ekip nga studentë të zellshëm që shkruajnë kod të zellshëm.
Cili është përfitimi për studentët?
Ata mund të jenë më pak të dukshëm, sepse studentët, të paktën, nuk marrin para për kodin që shkruajnë, por vetëm nota në regjistrin e tyre.
I pyeta rreth kësaj. Dhe sipas fjalëve të tyre:
- Përvoja e kontribuesit në Open Source.
- Të marrin një rresht në CV.
- Të shpërthejnë veten dhe të kalojnë një intervistë në Yandex.
- Të bëhen pjesëmarrës të GSoC.
- +1 kurs i veçantë për ata që duan të shkruajnë kod.
Nuk do të flas për mënyrën se si ishte organizuar kursi. Sidoqoftë, do të them se WAL-G ishte projekti kryesor. Po ashtu, në këtë kurs përfshimë projekte si Odyssey, PostgreSQL dhe ClickHouse.
Dhe ne kemi dhënë detyra jo vetëm në këtë kurs, por kemi ndarë edhe diploma dhe punë më projekte.
Dhe çfarë përfitimi ka për përdoruesit?
Tani le të kalojmë në pjesën që me siguri ju intereson. Çfarë përfitoni ju nga kjo? Përfitimi është se studentët kanë rregulluar shumë bugs. Dhe kanë bërë kërkesa për veçori që i kishit kërkuar.
Dhe le të flas për gjëra që ju i keni dëshiruar prej një kohe të gjatë dhe që janë realizuar.
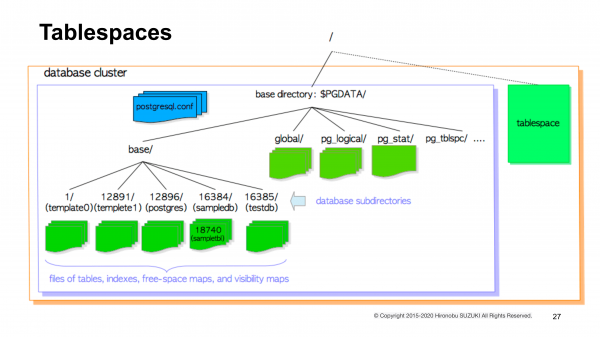
Mbështetje për tablespaces. Mbështetja për tablespaces në WAL-G ka pritur ndoshta që nga momenti i lëshimit të WAL-G, sepse WAL-G është pasuesi i një instrumenti tjetër backup, WAL-E, ku ishin mbështetur kopjet rezervë të bazave të të dhënave me tablespaces.
Lehtësisht t'ju kujtoj se çfarë është dhe pse është e nevojshme. Në rregull, të gjitha të dhënat e Postgres zakonisht zënë një katalog të vetëm në sistemin e skedarëve, që quhet katalogu bazë. Ky katalog tashmë përmban të gjitha skedarët dhe nënkatalogët e nevojshëm për Postgres.
Tablespaces janë katalogë ku ndodhen të dhënat e Postgres, por ato nuk ndodhen jashtë katalogut bazë. Në slajd duket se tablespacet janë përtej katalogut bazë.
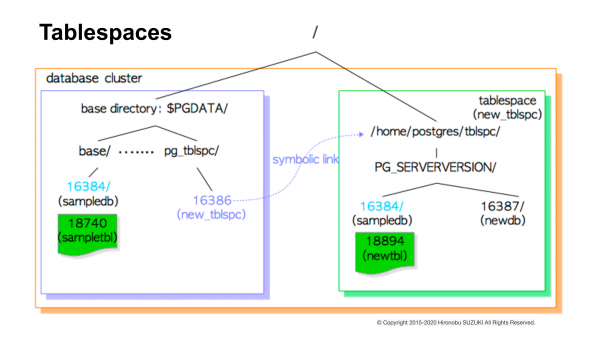
Si duket kjo për Postgres-in vetë? Në katalogun bazë ka një nënkatalog të veçantë pg_tblspc. Në të ndodhen lidhjet simbolike për katalogët ku realisht ndodhen të dhënat e Postgres jashtë katalogut bazë.
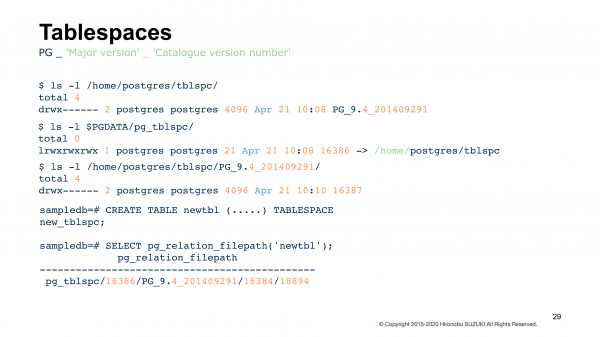
Kur e përdorni të gjithë këtë, komandat mund të duken kështu për ju. Kështu, krijoni një tabelë në ndonjë tablespace të specifikuar dhe shikoni se ku ndodhet tani. Këto dy rreshta të fundit, dy komandat e fundit të thirrura. Dhe aty duket se ka një rrugë. Por në të vërtetë, kjo nuk është një rrugë e vërtetë. Kjo është një rrugë me prefiks nga katalogu bazë te tablespace. Dhe nga aty ajo është lidhur me një lidhje simbolike, që çon te të dhënat tuaja reale.
Të gjitha këto nuk përdoren në ekipin tonë, por ato janë përdorur nga shumë përdorues të tjerë të WAL-E, që na kanë shkruar se donin të migronin në WAL-G, por kjo i ka penguar. Tani mbështetet.
Një veçori tjetër që na solli kursi ynë special është catchup. Njohin catchup ata që ndoshta kanë punuar më shumë me Oracle sesa me Postgres.
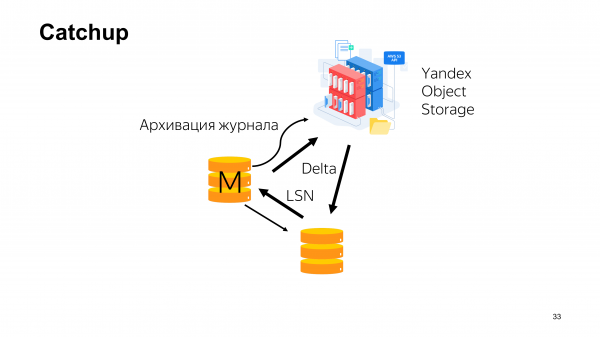
Në përmbledhje, çfarë është kjo. Një topologji e zakonshme e një klasteri në shërbimin tonë mund të duket kështu. Ne kemi një master. Ka një replikë që transmeton nga ai log-un përpara shkrimit. Dhe reprika i thotë masterit se në cilin LSN është aktualisht. Dhe ndonjëherë, paralelisht me këtë, mund të arkivohet journal. Përveç arkivimit të journal-it, ndodhen dhe backup-et në cloud. Po ashtu dërgohen dhe delta-backup-et.
Cila mund të jetë problemi? Kur keni një bazë të madhe, mund të ndodhë që replikës t’i mungojë shumë pas masterit. Dhe ajo vonohet aq shumë, saqë kurrë nuk mund ta arrijë. Këtë problem shpeshherë duhet ta zgjidhni siç duhet.
Dhe mënyra më e thjeshtë – është të hiqni replikën dhe ta rivendosni atë nga e para, sepse ajo kurrë nuk do ta arrijë, ndersa me problemin duhet të merremi. Por kjo është shumë e gjatë, sepse rikthimi i një backup të plotë të një baze prej 10 TB merr shumë, shumë kohë. Dhe na pëlqen ta bëjmë këtë sa më shpejt të jetë e mundur, nëse ndodhin këto probleme. Dhe për këtë është e destinuar catchup.
Catchup lejon përdorimin e delta-backup-eve, që ruajnë në cloud në këtë mënyrë. Ju thoni se në cilin LSN ndodhet tani replikat e prapambetur dhe e tregoni atë në komandën catchup për të krijuar një delta-backup midis atij LSN dhe LSN ku ndodhet aktualisht klasteri juaj. Dhe pas kësaj, e riktheni këtë backup në replikën që ishte prapambetur.
Baza të tjera
Njëkohësisht, studentët na sollën shumë karakteristika. Së bashku me të, ne në Yandex rregullojmë jo vetëm Postgres, por gjithashtu kemi MySQL, MongoDB, Redis, ClickHouse, kështu që në një moment na nevojitej që të mund të bënim backup me rikthim në kohë për MySQL, dhe që të kishte mundësi për t’i ngarkuar ato në cloud.
Dhe doja të bëja këtë në një mënyrë të ngjashme me atë që bën WAL-G. Dhe vendosëm të eksperimentojmë dhe të shohim se si do të dukej gjithçka.
Në fillim, pa e ndarë logjikën, shkruam kodin në një fork. E pamë se kishim një model funksional dhe kjo mund të avancojë. Më pas menduam se bashkësia jonë kryesore është PostgreSQL-istët, ata përdorin WAL-G. Prandaj duhet ndarë disa pjesë. Pra, kur përmirësojmë kodin për Postgres, nuk dëmtojmë MySQL-në, kur përmirësojmë MySQL-në, nuk dëmtojmë Postgres-in.
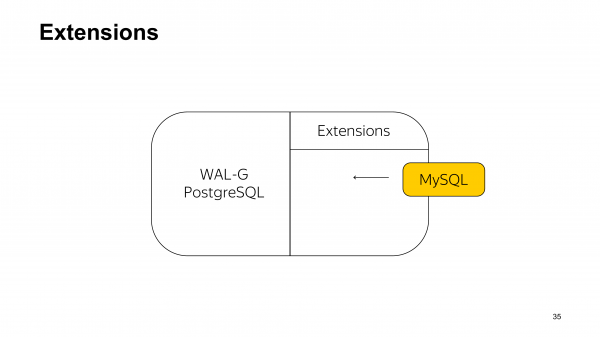
Ideja e parë për të ndarë këtë ishte të përdorej i njëjti qasje siç përdoret në zgjerimet PostgreSQL. Në thelb, për të bërë një backup MySQL, ju duhej të instalonit një bibliotekë dinamike.
Por këtu menjëherë duket asimetri e këtij qasjeje. Kur bëni backup për Postgres, ju vendosni një backup tool normal për Postgres dhe gjithçka shkon mirë. Por për MySQL, rezulton se vendosni një backup tool për Postgres dhe pastaj për të vendosni një bibliotekë dinamike për MySQL. Duket disi e çuditshme. Ne gjithashtu menduam kështu dhe vendosëm se kjo nuk ishte zgjidhja që na nevojitej.
Ndryshme ndërtimet për Postgres, MySQL, MongoDB, Redis
Por kjo na lejoi, siç duket, të arrijmë në një zgjidhje të saktë – të veçojmë ndërtimet e ndryshme për baza të ndryshme. Kjo lejonte izolimin e logjikës së lidhur me backup-et e bazave të ndryshme të të dhënave, të cilat do të qasen në një API të përbashkët që realizon WAL-G.
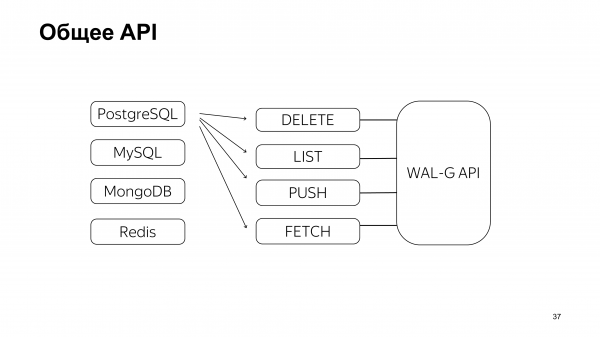
Kjo është ajo pjesë që e shkruam vetë – përpara se t'u jepnim studentëve detyra. Pra, kjo është pikërisht ajo pjesë ku ata mund të bënin ndonjë gjë jo të drejtë, prandaj vendosëm që është më mirë ta bëjmë ne diçka kështu që gjithçka do të ishte në rregull.
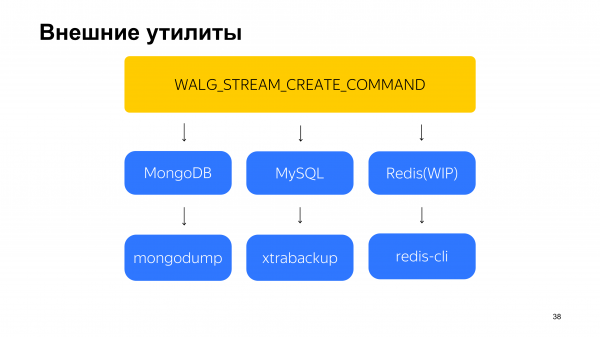
Pas kësaj u dhamë detyra. Menjëherë u morën ato. Nga studentët kërkohej të mbështesin tre baza.
Kjo është MySQL, të cilën e bëjmë backup me WAL-G në këtë mënyrë për më shumë se një vit.
Dhe tashmë MongoDB po i afrohet prodhimit, aty po e rafinojnë me dorë. Në thelb, ne shkruam skeletin për të gjithë këtë. Më pas studentët shkruan disa gjëra funksionale. Dhe pastaj ne i çojmë ato në një gjendje të tillë që mund t'i pranojmë në prodhimin tonë.
Këto detyra nuk dukeshin si të nevojitej për studentët të shkruanin mjete të plota backup për secilën prej këtyre bazave. Ne nuk kishim një problem të tillë. Problemi ynë ishte se donim rikuperim pikë në kohë dhe donim të bënim backup në cloud. Dhe iu kërkuam studentëve të shkruanin ndonjë kod që do ta zgjidhte këtë. Studentët përdorën mjete ekzistuese backup, të cilat në një farë mënyre marrin backup-e, dhe pastaj e lidhën gjithçka me WAL-G, e cila e dërgonte gjithçka në cloud. Po ashtu, e shtuan rikuperimin pikë në kohë.
Çfarë tjetër sollën studentët? Ata sollën në WAL-G mbështetje për enkriptimin Libsodium.
Po ashtu, ne kemi krijuar politika për ruajtjen e backup-eve. Tani backup-et mund të shënjohen si përhershëm. Dhe ndoshta është më e lehtë për shërbimin tuaj të automatizoni procesin e ruajtjes së tyre.
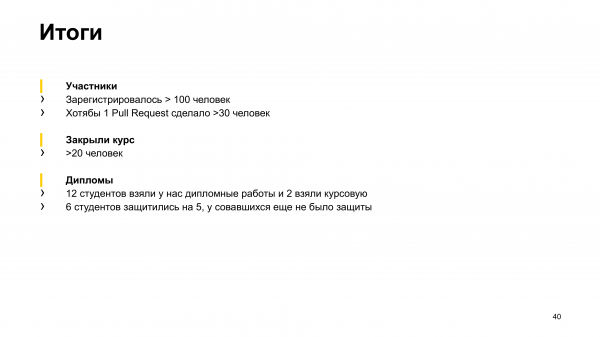
Çfarë arriti ky eksperiment në fund të fundit?
Fillimisht, mbi 100 njerëz u regjistruan në kurs. Në fillim nuk e thashë që universiteti në Ekaterinburg është Universiteti Federal i Urals. Aty e shpallëm gjithçka. 100 njerëz u regjistruan. Në të vërtetë, shumë më pak filluan të bëjnë diçka, rreth 30 njerëz.
Kursin e mbyllën edhe më pak njerëz, sepse atje duhej të shkruhen teste për kodet që ishin tashmë në dispozicion. Dhe gjithashtu të rregullohej ndonjë bug ose të bëhej një funksionalitet. Disa studentë e mbyllën gjithsesi kursin.
Aktualisht, për këtë kurs studentët kanë rregulluar rreth 14 issues, kanë krijuar 10 funksionalitete të ndryshme. Dhe, sipas mendimit tim, kjo është një zëvendësim i plotë për një ose dy zhvillues.
Përveç gjithçkaje, ne lëshuam diploma dhe punë kursi. 12 prej tyre morën diplomat. 6 prej tyre u mbrojtën me nota ‘5’. Për të tjerët, mbrojtjet ende nuk janë bërë, por mendoj se gjithashtu do t'u shkojë mirë.
Planet për të ardhmen
Cilat janë planet tona për të ardhmen?
Të paktën, ato kërkesa për funksionalitete që tashmë kemi dëgjuar nga përdoruesit dhe duam t'i realizojmë. Këto janë:
- Monitorimi i saktësisë së gjurmimit të linearit në arkiv të kopjeve rezervë të klasterit HA. Me ndihmën e WAL-G, kjo mund të bëhet. Dhe, mendoj se do të gjejmë studentë që do ta marrin atë punë.
- Për transferimin e kopjeve rezervë dhe WAL-it midis reve, ne tashmë kemi një person përgjegjës.
- Dhe së fundmi, ne publikuan idenë se mund ta përshpejtojmë akoma më shumë WAL-G-në përmes shfletimit të kopjeve rezervë inkrementale pa rinovimin e faqeve dhe optimizimin e arkivave që i dërgojmë atje.
Mund të ndani ato këtu
Për çfarë ishte ky raport? Për faktin se tani, përveç nesh 4 individëve që mbështesin këtë projekt, kemi duar shtesë, të cilat janë mjaft të shumta. Sidomos nëse u shkruani në mesazh privat. Dhe nëse ju po e back-up-oni të dhënat tuaja dhe po e bëni këtë me ndihmën e WAL-G ose do të donit të kaloni në WAL-G, dëshirat tuaja ne mund t’i marrim mjaft lehtë parasysh.
Ky është një kod qr dhe një lidhje. Mund të kaloni përmes tyre dhe të shkruani të gjitha dëshirat tuaja. Për shembull, ndoshta ne nuk e rregullojmë një bug. Ose ndonjë funksionalitet që e doni shumë, por për ndonjë arsye nuk është ende në asnjë nga kopjet rezervë, përfshirë tonën. Sigurohuni ta bëni të ditur këtë.
Pyetje
Përshëndetje! Faleminderit për raportin! Kam një pyetje për WAL-G, por jo për Postgres. WAL-G bëni backup MySQL dhe thërret backup ekstra. Në qoftë se merrni instalime moderne në CentOS dhe nëse bëni yum install MySQL, do të instalohet MariaDB. Që nga versione 10.3, backup ekstra nuk mbështetet, por mbështetet backup-i i MariaDB. Si e keni këtë gjë?
Në këtë moment nuk kemi provuar të bëjmë backup për MariaDB. Kishim kërkesa për mbështetje për FoundationDB, por në përgjithësi, nëse ka një kërkesë të tillë, mund të gjejmë njerëz që do ta bëjnë. Nuk është shumë e gjatë dhe aq e komplikuar sa mendoj.
Mirëdita! Faleminderit për raportin! Kam një pyetje për potencialisht karakteristika të reja. A jeni të gatshëm ta bëni WAL-G të funksionojë me banda, që të mund të bëni backup në banda?
Duket se po flisni për backup në ruajtjen me banda?
Po.
Atje është Andrei Borodin, i cili mund të përgjigjet më mirë se unë për këtë pyetje.
(Andrei) Po, faleminderit për pyetjen! Kemi pasur një kërkesë për transferimin e backup-it në bandë nga ruajtja në re. Dhe për këtë transferimi midis reve. Sepse transferimi midis reve është një version i përgjithësuar i transferimit në bandë. Për më tepër, kemi një arkitekturë të zgjerueshme në pjesën e Storages. Nga ana tjetër, shumë nga storaget janë shkruar nga studentët. Dhe nëse shkruani një Storage për banda, ai sigurisht do të mbështetet. Jemi të gatshëm të shqyrtojmë pull request. Aty duhet të regjistrohet një skedar, të lexohet një skedar. Nëse këto gjëra bëhen në Go, zakonisht rezulton në 50 rreshta kodi. Dhe atëherë në WAL-G do të mbështetet banda.
Faleminderit për raportin! Procesi i zhvillimit është interesant. Backup është një pjesë serioze e funksionalitetit që duhet të mbulohet mirë me teste. Kur ju e realizuat funksionalitetin për baza të reja, a të gjitha testet u shkruan gjithashtu nga studentët apo ju i shkruat testet dhe pastaj ua dhatë studentëve implementimin?
Testet i shkruan gjithashtu studentët. Por studentët shkruan më shumë për karakteristika të tilla si bazat e reja. Ata shkruan teste integruese. Dhe ata shkruan teste unit. Nëse testet integruese kalojnë, dmth për momentin – është një skenar që ju e ejecutoni me duar ose e bën cron, për shembull. DMTH, atje skenari është shumë i kuptueshëm.
Studentët nuk kanë shumë eksperiencë. Sa kohë shpenzohet për rishikimin?
Po, rreth rishikimeve po kalon shumë kohë. Z. e. zakonisht, kur vijnë disa kontribuues menjëherë dhe thonë që kam bërë këtë, kam bërë atë, duhet të mendoj dhe të rezervoj diku gjysmë ditë për t'u marrë me atë që ata kanë shkruar. Sepse kodi duhet lexuar me kujdes. Ata nuk kanë kaluar intervistën. Ne nuk i njohim shumë mirë, prandaj kjo merr një kohë të konsiderueshme.
Faleminderit për raportin! Më parë, Andrei Borodin shpalli se archive_command në WAL-G duhet të thirret drejtpërdrejt. Por në rast të një klasteri patron, na nevojitet logjikë shtesë për të përcaktuar nodin nga e cila të dërgojmë vallet. Si e zgjidhni ju këtë problem?
Cila është problemit tuaj këtu? Le të themi, a keni një replikë sinkrone nga e cila merrni backup? Apo çfarë?
(Andrei) Problemi është se vërtet WAL-G supozon përdorimin pa lidhur me skriptet e shell. Nëse diçka mungon, atëherë le t'i shtojmë logjikën që duhet të jetë brenda WAL-G. Në lidhje me atë nga e cila duhet të bëhet arkivimi, ne mendojmë se arkivimi duhet të bëhet nga mjeshtri aktual në klaster. Arkivimi nga replika është një ide e keqe. Janë të mundshme skenarë të ndryshëm me probleme. Në veçanti, problemet me arkivimin e kronologjive dhe informacionit të tjera të shtesë. Faleminderit për pyetjen!
(Sqarim: Jemi liruar nga lidhja me skriptet e shell) )
Mirëmbrëma! Faleminderit për raportin! Më interesoi karakteristika catchup, për të cilën keni folur. Takoheshit me një situatë ku replika vonohej dhe nuk mund të kapte dot. Dhe në WAL-G nuk gjeta përshkrimin e kësaj karakteristike në dokumentacion.
Catchup u shfaq në të vërtetë në mesin e 20: ditëve të janarit 2020. Me dokumentacionin, ndoshta duhet të punoni më mirë. Ne vetë e shkruajmë dhe nuk jemi duke e bërë atë për të qenë super-shkëlqyeshëm. Dhe ndoshta, duhet filluar të kërkojmë nga studentët që ta shkruajnë.
A është ajo tashmë në lëshim?
Pull request-in e kam shqyrtuar tani, pra e kam kontrolluar. E kam provuar atë në klasterin testues. Deri tani nuk kemi pasur ndonjë situatë kur mund ta verifikonim këtë në një shembull në produksion.
Kur të pritet?
Nuk e di. Prisni një muaj, do ta verifikojmë me siguri.
Burimi: habr.com
