

Logot janë një pjesë e rëndësishme e sistemit, duke lejuar që të kuptohet nëse ai funksionon (ose jo) siç pritet. Në kushtet e arkitekturës mikroshërbimesh, puna me logot bëhet një disiplinë e veçantë. Duhet të zgjidhen menjëherë shumë pyetje:
- si të shkruhen logot nga aplikacioni;
- ku të shkruhen logot;
- si të dërgohen logot për ruajtje dhe përpunim;
- si të përpunohen dhe ruhen logot.
Përdorimi i teknologjive të njohura të konteinerizimit shton më shumë vështirësi për zgjidhjen e problemit.
Pikërisht për këtë flitet në raportin e Yuri Bushmelev, "Hartë e pengesave në fushën e mbledhjes dhe dërgimit të logove"
Kush është i interesuar, ju lutem, shihni më poshtë.
Më quaj Yuri Bushmelev. Punoj në Lazada. Sot do flas për mënyrën se si e kemi ndërtuar logun tonë, si i mbledhim dhe çfarë shkruajmë brenda tij.
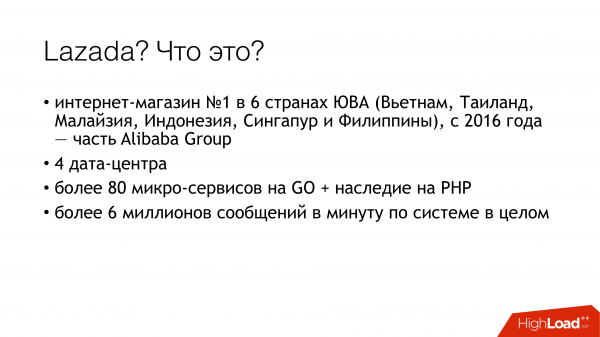
Nga jemi? Kush jemi ne? Lazada është marketi numër 1 në gjashtë vende të Azisë Juglindore. Të gjitha këto vende janë të shpërndara në qendrat tona të të dhënave. Aktualisht kemi 4 qendra të dhënash. Pse është e rëndësishme? Sepse disa zgjidhje ishin të përcaktuara nga fakti se midis qendrave ka një lidhje shumë të dobët. Ne kemi një arkitekturë mikroshërbimesh. U befasova kur zbulova se tashmë kemi 80 mikroshërbime. Kur kam filluar projektin me logot, ka pasur vetëm 20. Po ashtu, ka një sasi të konsiderueshme të PHP legacy, me të cilin duhet të jetojmë dhe të pajtohemi. Të gjitha këto gjenerojnë për momentin më shumë se 6 milion mesazhe në minutë në sistemin në tërësi. Më tutje do të tregoj se si përpiqemi të jetojmë me këtë dhe pse është kështu.
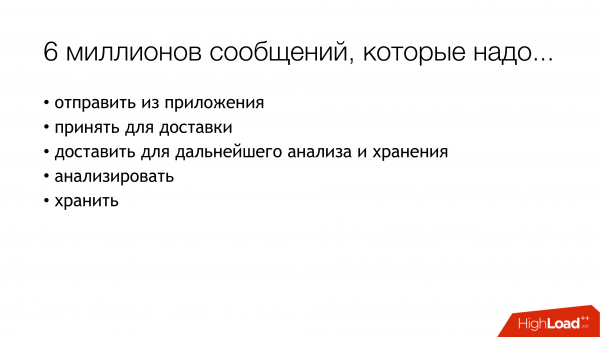
Me këto 6 milion mesazhe, duhet të jetojmë në një farë mënyre. Çfarë duhet të bëjmë me to? 6 milion mesazhe që duhet:
- dërguar nga aplikacioni
- pranuar për dërgim
- dërguar për analizë dhe ruajtje.
- të analizoni
- dhe ndonjëherë duhet të ruhen.
Kur u shfaqën tre milion mesazhe, unë kisha një pamje të ngjashme. Sepse ne filluam me ndonjë qindarkë. Është e qartë se aty shkruhen log-ët e aplikacioneve. Për shembull, nuk arrita të lidhem me bazën e të dhënave, arrita të lidhem me bazën e të dhënave, por nuk arrita të lexoj diçka. Por përveç kësaj, çdo mikroshërbim ynë shkruan gjithashtu një log të aksesit. Çdo kërkesë që vjen në mikroshërbim bie në log. Pse e bëjmë këtë? Zhvilluesit duan të kenë mundësi gjurmi. Në çdo log të aksesit, ndodhet fusha traceid, me të cilin më pas një ndërfaqe speciale shtrijon të gjithë zinxhirin dhe e tregon bukur gjurmimin. Gjurmi tregon se si kaloi kërkesa dhe kjo i ndihmon zhvilluesit tanë të përballen më shpejt me çdo gjë të panjohur.
Si të jetojmë me këtë? Tani do të flas shkurt për disa mundësi — si zgjidhet gjithsesi ky problem. Si të zgjidhet problemi i grumbullimit, transferimit dhe ruajtjes së log-ëve.
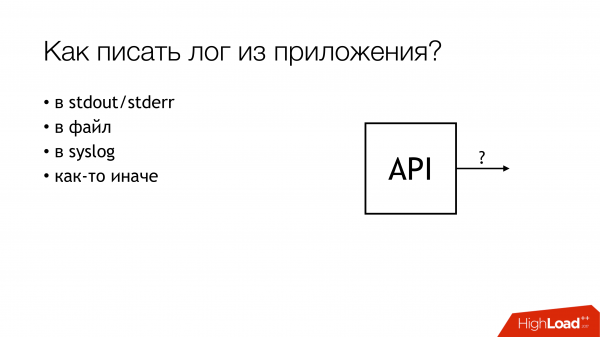
Si të shkruajmë nga aplikacioni? E qartë është se ka mënyra të ndryshme. Në veçanti, ka praktika më të mira, si na tregojnë shokët modernë. Ka stilin e vjetër në dy forma, si na treguan të parët. Ka edhe mënyra të tjera.
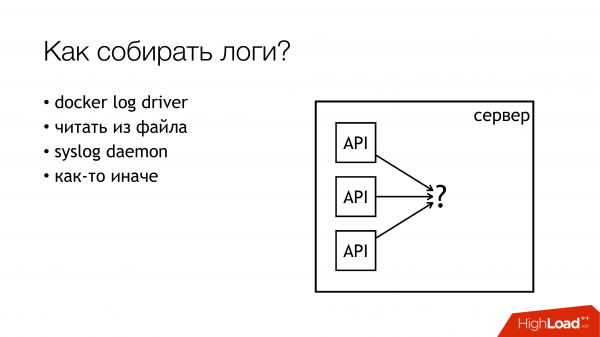
Situata me grumbullimin e log-ëve është për afërsisht të njëjtën gjë. Mundësitë për zgjidhjen e kësaj pjesë të veçantë nuk janë shumë. Tani janë më shumë, por akoma jo shumë.
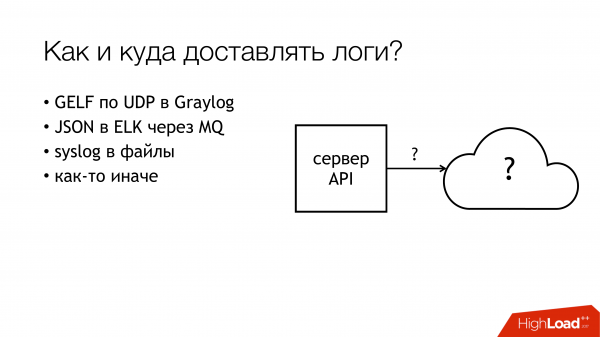
Megjithatë, lidhur me shpërndarjen dhe analizën e mëvonshme — numri i variacioneve fillon të shpërthejë. Nuk do të përshkruaj çdo variant tani. Mendoj se variantet kryesore janë të njohura për të gjithë ata që janë interesuar për temën.
Do të tregoj si ne bëmë këtë në Lazada, dhe si fillimisht nisi e gjithë kjo.
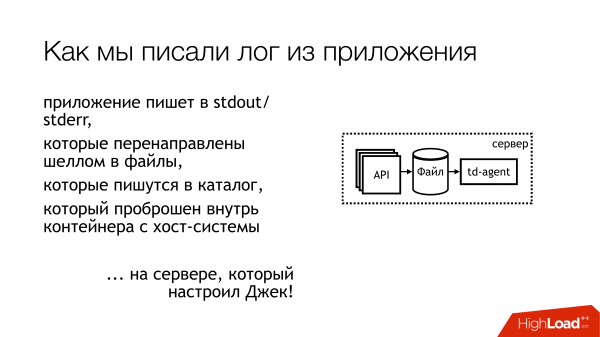
Një vit më parë, unë erdha në Lazada dhe më dërguan në projektin për log-et. Aty ishte diçka e tillë. Log-u nga aplikacioni shkruhej në stdout dhe stderr. Të gjithë e bënë sipas modës. Por më pas zhvilluesit e hodhën atë nga rrjedhat standarde, dhe më pas spesialistët e infrastrukturës do të merreshin me të. Ndërmjet specialistëve të infrastrukturës dhe zhvilluesve ka edhe lëshues, të cilët thanë: «eh… mirë, le të paketojmë thjesht në një skedar me shell-in, dhe mbaroi». Dhe që të gjitha ishin në një kontejner, kështu që i paketuan direkt brenda kontejnerit, e mapuan brenda një directoriesh dhe e vendosën aty. Mendoj se është e qartë për të gjithë se çfarë doli nga kjo.
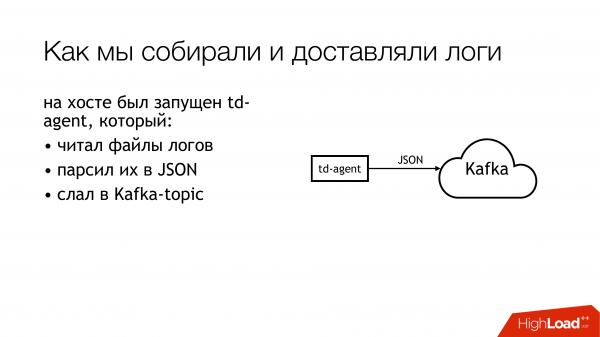
Të shikojmë disi më thellë. Si i shpërndanim këto log-e. Disa kanë zgjedhur td-agent, i cili në të vërtetë është fluentd, por jo krejtësisht fluentd. Nuk e kuptova kurrë marrëdhënien midis këtyre dy projekteve, por duket se për të njëjtën gjë është fjala. Dhe ky fluentd, i shkruar në Ruby, lexonte skedarët e log-eve, i parse me JSON përmes ndonjë regexi. Pastaj i dërgonte në Kafka. Për më tepër, në Kafka për çdo API kishim 4 tema të veçanta. Pse 4? Sepse kemi live, kemi staging dhe sepse kemi stdout dhe stderr. Zhvilluesit i krijojnë ato, ndërsa inxhinierët e infrastrukturës duhet t'i krijojnë në Kafka. Për më tepër, Kafka kontrollohej nga një departament tjetër. Prandaj, duhej të krijonim një biletë që ata të krijonin 4 tema për çdo API. Të gjithë këtë e harronin. Pra, ishte një kaos total.
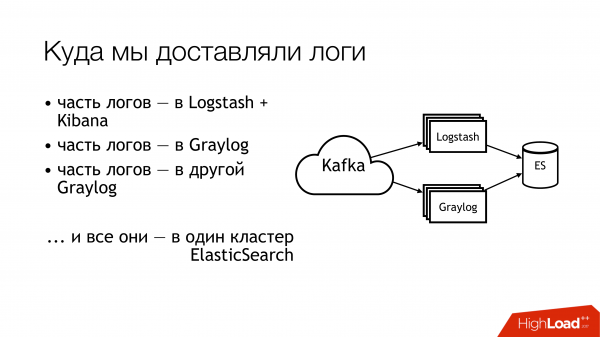
Çfarë bëmë më pas me këtë? Ne e dërguam atë në Kafka. Më pas, nga Kafka, gjysma e log-eve fluturonte në Logstash. Gjysma tjetër e log-eve ndahej. Një pjesë fluturonte në një Graylog, një pjesë – në një Graylog tjetër. Në përfundim, gjithçka përfundonte në një klaster Elasticsearch. Pra, e gjithë kjo kaos në fund përfundonte aty. Nuk duhet bërë kështu!
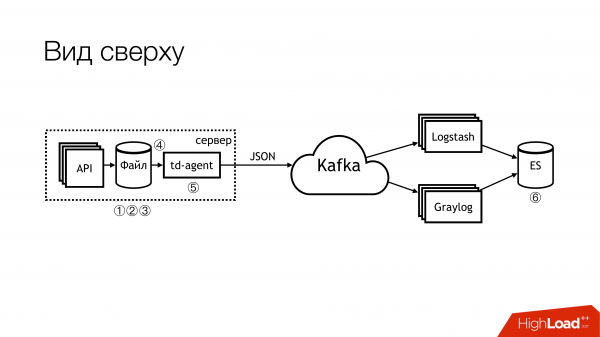
Ja si duket, nëse e shikojmë nga lart. Nuk duhet bërë kështu! Këtu janë të shënuara menjëherë me numra pikat e problemit. Në të vërtetë, ka më shumë se kaq, por 6 janë vërtet problemet kryesore me të cilat duhet të bëjmë diçka. Për to do të flas veçmas tani.
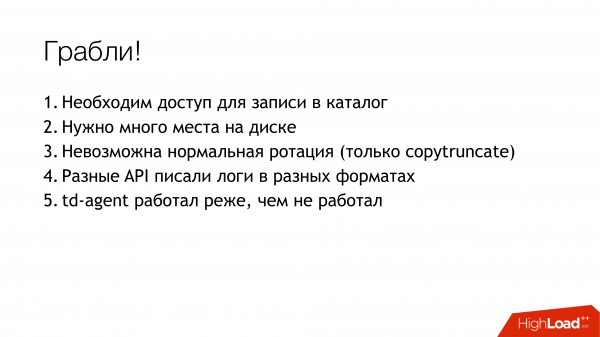
Këtu (1, 2, 3) shkruhen skedarët dhe, për pasojë, menjëherë këtu kemi tre pengesa.
E para (1) — është se duhet t'i shkruajmë diku. Nuk do të dëshironim gjithmonë t'i jepnim API mundësinë të shkruajë direkt në skedar. Preferohet që API të jetë e izoluar në një kontejner, dhe akoma më mirë – që ajo të jetë read-only. Unë jam sistemadministrator, kështu që kam një këndvështrim paksa alternativ për këto çështje.
Momenti i dytë (2,3) — kemi shumë kërkesa që vijnë në API. API-ja shkruan shumë të dhëna në skedar. Skedarët rriten. Na nevojitet t'i rotatojmë. Sepse, përndryshe, nuk mund të sigurojmë hapësirë në disqet e papara. Rotimi është i vështirë, sepse ata janë të krijuar me një kthim përmes shell në katalog. Nuk mund t'i rotatojmë dot. Nuk mund të kërkojmë nga aplikacioni që të rihapë deskriptorët e tij. Sepse zhvilluesit do të na shikojnë si të çmendur: "Cilat deskriptorë? Ne në të vërtetë shkruajmë në stdout". Infrastrukturuesit e bënë copytruncate në logrotate, i cili thjesht bën një kopje të skedarit dhe truncaton origjinalin. Si rezultat, midis këtyre proceseve të kopjimit zakonisht përfundon hapësira në disk.
(4) Ne kishim formate të ndryshme në API të ndryshme. Ato disi i ndaheshin njëra-tjetrës, por duhej të shkruanim regexp të ndryshëm. Duke qenë se gjithçka kjo drejtohej nga Puppet, kishte një grup të madh klasash me „merimanga“ të veta. Plus, ndonjëherë td-agent konsumonte shumë memorie, e ngadalësonte, mund të bënte sikur punonte dhe të mos bënte asgjë. Nga jashtë ishte e pamundur të kuptohej se ai nuk bëntë asgjë. Në rastin më të mirë, ai do të rrëzohej dhe dikush do ta ngrinte më pas. Sakësisht, do të vinte një alarm dhe dikush do të shkonte e do ta ngrinte me duar.
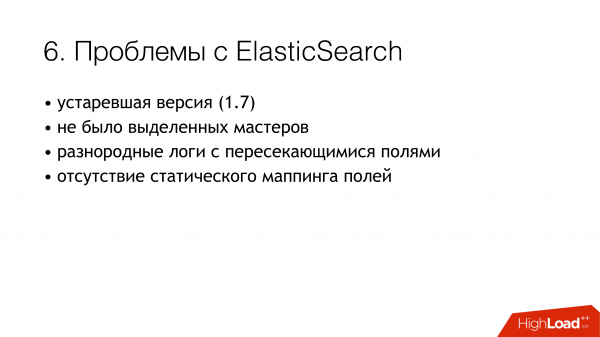
(6) Dhe më e keqja — ishte elasticsearch. Sepse ishte një version i vjetër. Sepse, atëherë, nuk kishim master të dedikuar. Kishim loge të larmishme, ku fushat mund të përputheshin. Loge të ndryshme të aplikacioneve të ndryshme mund të shkruheshin me emra të njëjtë fushe, por brenda mund të kishin të dhëna të ndryshme. Domethënë, një log vjen me Integer në fushën, për shembull, level. Një log tjetër vjen me String në fushën level. Në mungesë të një hartimi statik, rezulton një gjë e mrekullueshme. Nëse pas rotacionit të indeksit në elasticsearch, mesazhi i parë që vjen është me varg, atëherë ne e kalojmë normalisht. Por nëse i pari që vjen është me Integer, të gjitha mesazhet e ardhshme që vijnë me String thjesht përjashtohen. Sepse tipi i fushës nuk përputhet.
Filluam të bëjmë këto pyetje. Vendosëm të mos kërkojmë fajtorët.
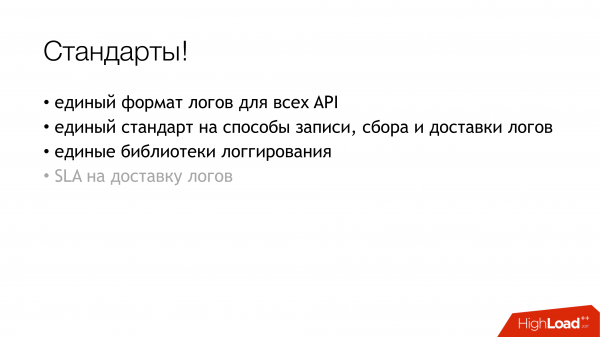
Por një kohë e gjatë, ishte e qartë se duhej të vendosnim standarde. Disa standarde kishim already. Të tjerë i vendosëm pak më vonë. Për fat, formati i njëjtë i regjistrimeve për të gjitha API-të ishte miratuar në atë kohë. Ai është përshkruar drejtpërdrejt në standartet e bashkëpunimit të shërbimeve. Pra, ata që duan të marrin regjistrimet duhet t'i shkruajnë ato në këtë format. Nëse dikush nuk i shkruan regjistrimet në këtë format, do të thotë se ne nuk garantojmë asgjë.
Më pas, do të dëshiroja të vendosnim një standard të vetëm për mënyrat e regjistrimit, dërgimin dhe mbledhjen e regjistrimeve. Në thelb, ku t'i shkruajmë ato dhe me çfarë t'i dërgojmë. Situata ideale do të ishte të përdorej e njëjta bibliotekë në projekte. Kemi një bibliotekë të veçantë për regjistrimin në Go, dhe një tjetër për PHP. Të gjithë ata që i kemi - të gjithë duhet t'i përdorin ato. Aktualisht do të thosha se rreth 80% e kësaj po funksionon. Por disa vazhdojnë të hanë kaktusë.
Dhe aty (në slajd) fillon ngadalë të shfaqet "SLA për dërgimin e regjistrimeve". Aktualisht nuk e kemi, por jemi duke punuar për të. Sepse është shumë praktike kur infrastruktura thotë se nëse shkruani në një format të tillë në një vend të tillë dhe jo më shumë se N mesazhe në sekondë, atëherë ne do t'ia dërgojmë atje me një probabilitet të caktuar. Kjo heq shumë nga dhimbjet e kokës. Nëse SLA ekziston, atëherë është thjesht e shkëlqyer!
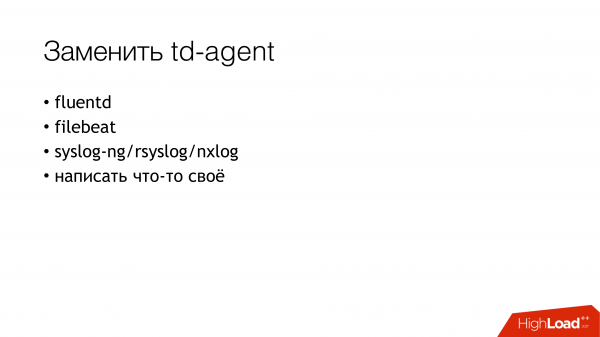
Si filluam të zgjidhim problemin? Problemi kryesor ishte me td-agent. Nuk ishte e qartë se ku shkonte regjistri. A dërgoheshin ata? A mblidheshin ata? Ku ishin ata në të vërtetë? Prandaj, pika e parë ishte të zëvendësonim td-agent. Kam shkruar shkurtimisht disa opsione për atë që mund ta zëvendësojmë.
Fluentd. Së pari, kam pasur përvojë me të në punën time të mëparshme, dhe ai gjithashtu herë pas here ishte duke rënë. Së dyti, është pikërisht e njëjta gjë, por për profesionistët.
Filebeat. Çfarë e bënte atë të përshtatshëm për ne? Sepse është në Go, dhe ne kemi një ekspertizë të madhe në Go. Prandaj, nëse ndodhte diçka, mund të bënim disa ndryshime vetë. Prandaj nuk e morëm. Që të mos kishte asnjë tundim për të filluar ta rishkruanim për vete.
Një zgjidhje e qartë për sistem-adminin mbetet çdo lloj sistemi regjistrimi, si syslog-ng / rsyslog / nxlog.
Ose të shkruajmë diçka tonën, por ne këtë e gruntuam, ashtu si dhe filebeat. Nëse do të shkruanim diçka, do të ishte më mirë të shkruanim diçka të dobishme për biznesin. Për dërgimin e regjistrimeve, do të ishte më mirë të merrnim diçka të gatshme.
Prandaj, zgjedhja përfundoi duke u përqendruar në syslog-ng dhe rsyslog. U prirëm drejt rsyslog, thjesht sepse kishim klasa për rsyslog në Puppet, dhe nuk gjetëm ndonjë diferencë të dukshme mes tyre. Çfarë ka aty syslog, ka dhe këtu syslog. Po, ndokush ka dokumentacion më të keq, ndokush më të mirë. Ai di kështu, ai ndryshe.
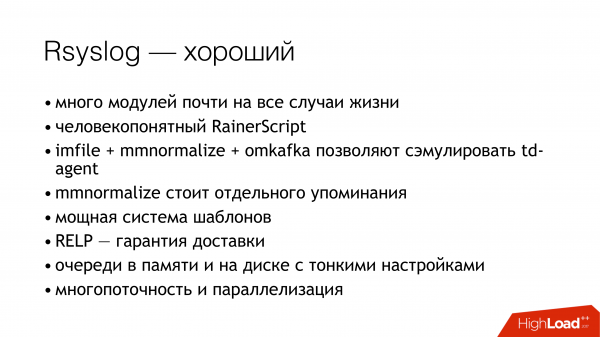
Dhe pak për rsyslog. Së pari, ai është i shkëlqyer, sepse ka shumë module. Ka RainerScript, një gjuhë moderne konfigurimi e kuptueshme për njerëzit. Një bonus fantastik është se mundëm ta simulonim sjelljen e td-agent me mjete standarde, dhe për aplikacionet nuk ndryshoi asgjë. Pra, ne e ndryshojmë td-agent me rsyslog, dhe gjithçka tjetër mbetet e pandryshuar. Dhe menjëherë e marrim dërgesën duke funksionuar. Më pas, mmnormalize është një gjë fantastike në rsyslog. Ai lejon të analizosh log-et, por jo me Grok dhe regexp. Ai bën një pemë të sintaksës abstrakte. Ai analizon log-et përafërsisht si një kompilator analizon burimin. Kjo lejon të punosh shumë shpejt dhe të konsumosh pak CPU, dhe, më të vërtetë, është një gjë shumë e shkëlqyer. Ka shumë bonuse të tjera. Nuk do të ndalem tek ato.
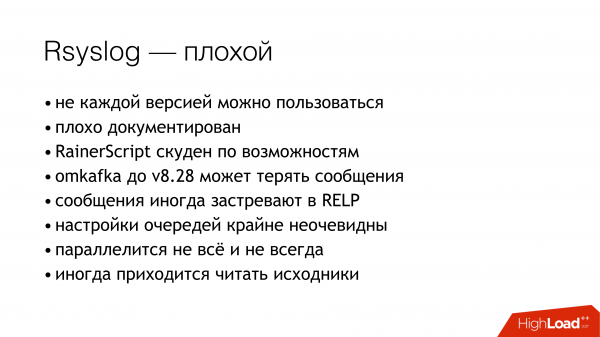
Rsyslog ka shumë disavantazhe të tjera. Ato janë përafërsisht të njëjta me bonuset. Problemet kryesore janë se duhet të dish si ta përgatisësh dhe duhet të zgjidhësh versionin.
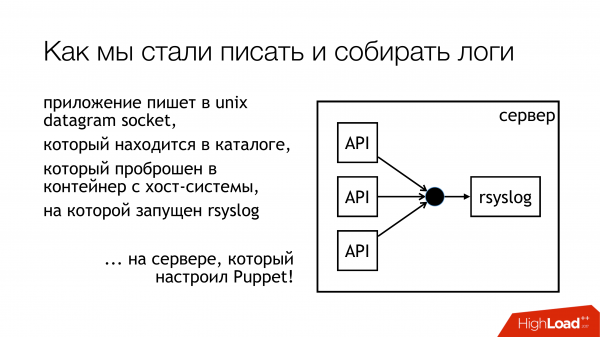
Ne vendosëm që do të shkruajmë log-et në unix socket. Dhe jo në /dev/log, sepse atje kemi një kaos nga log-et sistemore, atje journald është në këtë pipeline. Prandaj, le të shkruajmë në një socket të personalizuar. Do ta lidhim me një ruleset të veçantë. Nuk do të përzihen asgjë. Do të jetë gjithçka e qartë dhe në transparencë. Kështu e bëmë. Katalogu me këto socket janë standardizuar dhe kalojnë në të gjitha kontejnerët. Kontejnerët mund të shohin socket-in e nevojshëm, ta hapin dhe të shkruajnë në të.
Pse jo një skedar? Sepse të gjithë kishin lexuar , e cila përpiqej të kalonte një skedar në docker, dhe duke zbuluar se pas rinisjes rsyslog ndryshon descriptor-in e skedarit, dhe docker e humb atë skedar. Ai mban të hapur diçka tjetër, por jo më atë socket ku shkruajnë. Ne vendosëm se do ta shmangim këtë problem dhe, për njëkohësisht, do ta shmangim edhe problemin e bllokimit.
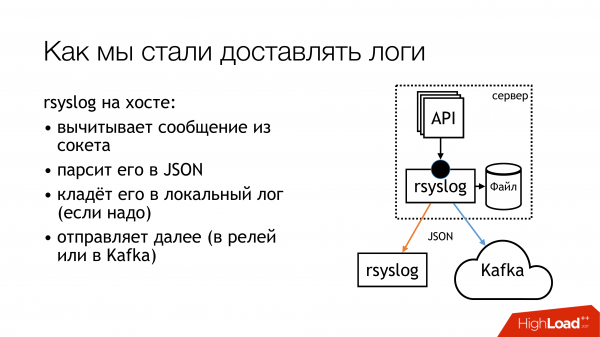
Rsyslog bën veprimet e caktuara në diapozitiv dhe dërgon log-et ose në relays, ose në Kafka. Kafka i përshtatet mënyrës së vjetër. Relay — është se përpiqesha të përdor vetëm rsyslog për dërgimin e log-eve. Pa Message Queue, me mjete standarde rsyslog. Në thelb, kjo funksionon.
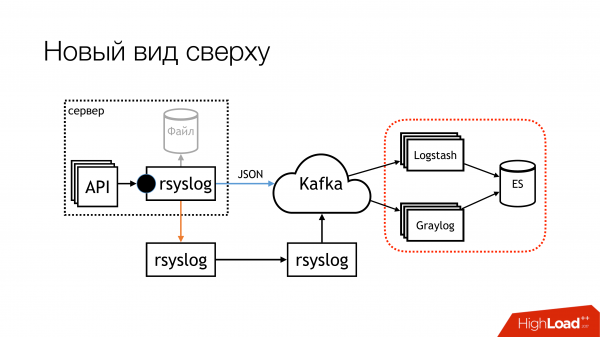
Por shkak të disa veçorive për mënyrën si mund të i futim ato në këtë pjesë (Logstash/Graylog/ES). Kjo pjesë (rsyslog-rsyslog) përdoret midis qendrave të të dhënave. Këtu është një lidhje të dhënash të kompresuar, që lejon ruajtjen e bandës dhe, si rezultat, rrit gjasat që të marrim disa log-e nga një qendër tjetër të të dhënave kur kanali është i ngarkuar. Sepse kemi Indonezinë, ku situata është e vështirë. Atje, kjo është një problem konstant.
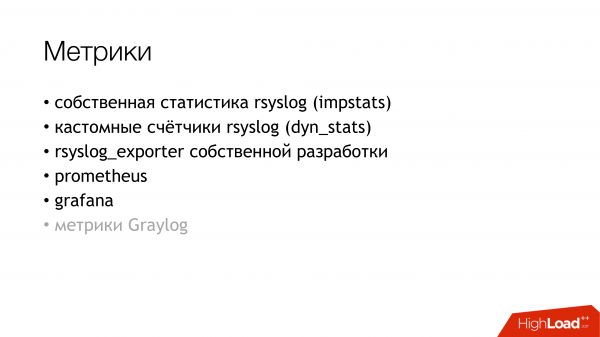
Ne po mendojmë se si të monitorojmë, me çfarë probabiliteti log-et që regjistrojmë nga aplikacioni arrijnë në atë skaj? Ne vendosëm të krijojmë metrika. Rsyslog ka modul të vet mbi grumbullimin e statistikave, ku ka disa numërues. Për shembull, ai mund të ju tregojë madhësinë e radhës, ose sa mesazhe kanë ardhur në një veprim të caktuar. Nga këto mund të nxjerrim diçka. Për më tepër, ka numërues personalizues që mund të konfigurojmë, dhe ai do t'ju tregojë, për shembull, numrin e mesazheve që regjistroi një API i caktuar. Më pas, unë shkrova rsyslog_exporter në Python dhe të gjithë këtë e dërguam në Prometheus dhe ndërtuam grafika. Do të donim shumë metrika nga Graylog, por ende nuk kemi arritur t'i konfigurojmë ato.
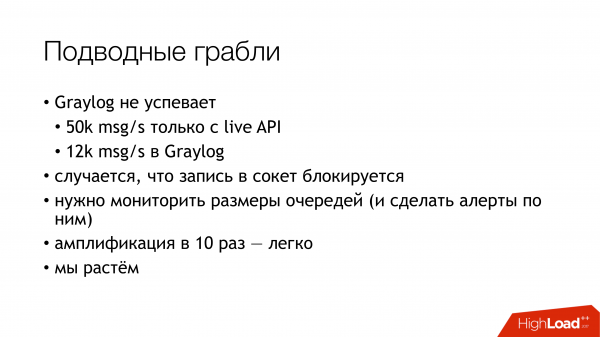
Cilat probleme kemi hasur? Problemet kanë lindur kur kemi zbuluar (papritur!) se Live API-t tanë dërgojnë 50,000 mesazhe në sekondë. Këto janë vetëm Live API pa staging. Dhe Graylog na tregon vetëm 12,000 mesazhe në sekondë. Ndërsa lind pyetja e arsyeshme, ku janë të tjerët? Nga kjo, ne arritëm në përfundimin se Graylog nuk po përballonte. Kërkuam dhe, në fakt, Graylog me Elasticsearch nuk po përballonte këtë ngarkesë.
Më tej, zbulime të tjera që kemi bërë gjatë procesit.
Shkrimi në socket është bllokuar. Si ndodhi kjo? Kur përdorja rsyslog për dorëzim, një moment u prish lidhja midis qendrave të të dhënave. Dorëzimi u ndal në një vend, ndërsa dorëzimi në një tjetër. Të gjitha këto arritën në makinën me API-t, të cilat shkruajnë në socket rsyslog. Aty u mbush radhë. Më pas, u mbush radhë për shkrim në unix socket, që sipas parazgjedhjes është 128 paketa. Dhe shkrimi i ardhshëm në aplikacion bllokohet. Kur shikuan në bibliotekën që përdorim në aplikacionet në Go, aty shkruhej se shkrimi në socket ndodhte në modin jo-bllokues. Ne ishim të sigurt që asgjë nuk po bllokohej. Sepse kishim lexuar. , e cila ka e shkruajti për këtë. Por ka një moment. Rreth këtij thirrje kishte edhe një cikël të pafund, në të cilin bëhej vazhdimisht një përpjekje për ta futur mesazhin në soket. Këtë nuk e vëmë re. Kemi qenë të detyruar ta rreshim librarinë. Që atëherë ajo është ndërruar disa herë, por tani ne e kemi eliminuar bllokimin në të gjitha nën sistemet. Prandaj, mund të ndalojmë rsyslog-un, dhe asgjë nuk do të bie.
Duhet të monitorojmë madhësinë e radhëve, që ndihmon që të mos bien në këto gracka. Në radhë të parë, mund të monitorojmë kur fillojmë të humbasim mesazhe. Në radhë të dytë, mund të monitorojmë problemet që kemi në tërësi me dorëzimin.
Dhe një moment tjetër i pakëndshëm — amplifikimi 10-fish në arkitekturën e mikrosërvitorëve — është shumë e lehtë. Nuk kemi shumë kërkesa hyrëse, por për shkak të grafit në të cilin qarkullojnë këto mesazhe më tej, për shkak të log-eve të aksesit, ne realisht rrisim ngarkesën për log-et rreth dhjetë herë. Fatkeqësisht, nuk kam arritur të llogaris numrat e saktë, por mikroservisat — ato janë të tilla. Duhet ta kemi parasysh këtë. Pra, në këtë moment nën sistemi që mbledh log-et është më i ngarkuari në Lazada.
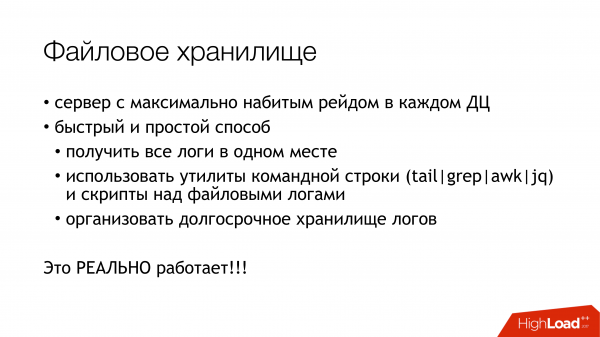
Si ta zgjidhim problemin me elasticsearch? Nëse duhet të marrim shpejt log-et në një vend, për të mos ecur nëpër të gjitha makinat, dhe për t'i mbledhur atje, përdorni një ruajtje skedari. Kjo funksionon garantuar. Kjo krijohet nga çdo server. Duhet vetëm t’i shtoni disa disqe atje dhe të vendosni syslog. Pas kësaj do të keni garantuar të gjitha log-et në një vend. Më pas mund të filloni të konfiguroni elasticsearch, graylog, diçka tjetër nga ngadalë. Por do t'i keni të gjitha log-et, dhe për më tepër, mund t'i ruani, sa mjaftojnë masat e disqeve.
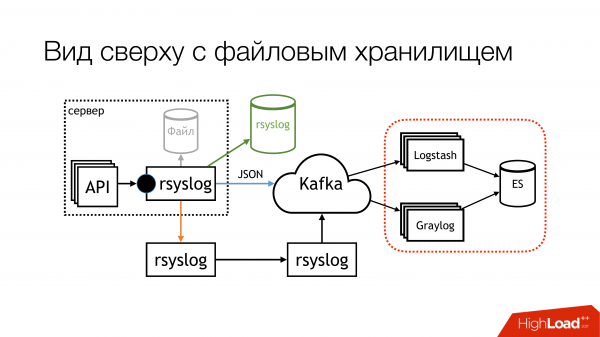
Në momentin e prezantimit tim, skema dukej kështu. Praktikisht kemi ndaluar të shkruajmë në skedarë. Tani, me të gjitha gjasat, do të çaktivizojmë mbetjet. Në makinat lokale, në të cilat janë aktivizuar API-të, do të ndalojmë të shkruajmë në skedarë. Së pari, ekziston një ruajtje skedari që funksionon shumë mirë. Së dyti, në këto makina vendoset hapësira vazhdimisht, është e nevojshme ta monitorojmë atë vazhdimisht.
Kjo pjesë me Logstash dhe Graylog, vërtet e ngarkon. Prandaj duhet të heqim dorë prej saj. Duhet të zgjedhim një nga ato.
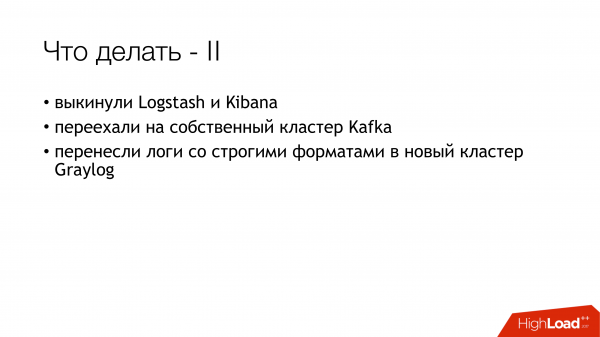
Ne vendosëm të heqim Logstash dhe Kibana. Sepse kemi një departament të sigurisë. Cila është lidhja? Lidhja është se Kibana pa X-Pack dhe pa Shield nuk lejon ndarjen e të drejtave të aksesit në loge. Prandaj morëm Graylog. Pavarësisht se nuk më pëlqen, ai funksionon. Kemi blerë pajisje të reja, vendosëm aty një Graylog të ri dhe transferuam të gjitha loget me formate të rrepta në një Graylog të veçantë. Ne zgjidhëm problemin me lloje të ndryshme të fushave të njëjta në mënyrë organizative.
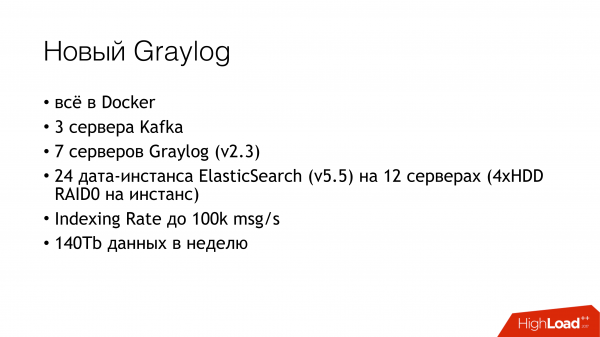
Çfarë përfshihet në Graylog të ri? Ne thjesht e regjistruam gjithçka në Docker. Morëm një sërë serverësh, shpërndamë tre instanca Kafka, 7 serverë Graylog versioni 2.3 (sepse dëshironim Elasticsearch version 5). Të gjitha këto i ngritëm mbi RAID nga HDD. Vëmë re një normë indeksimi deri në 100 mijë mesazhe në sekondë. Vëmë re numrin se 140 terabajt të dhënash në javë.
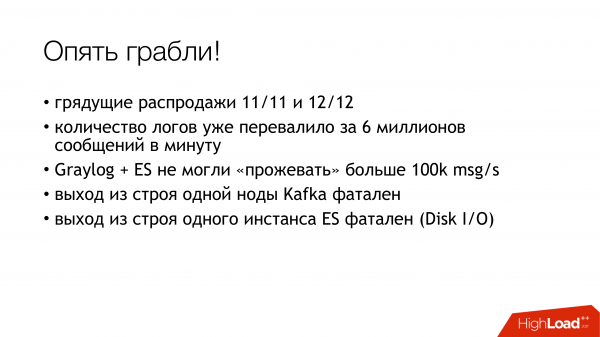
Dhe sërish, pengesa! Po na presin dy shitje të mëdha. Ne kaluam për 6 milion mesazhe. Graylog nuk po arrin të përpunojë. Duhet të mbijetojmë sërish.
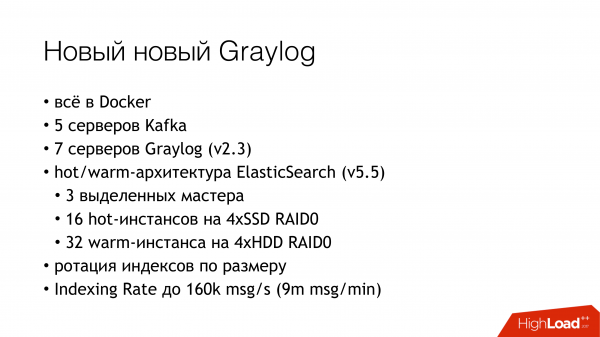
Kështu mbijetuam. Shtova pak serverë dhe SSD. Aktualisht po jetojmë me këtë mënyrë. Tani po përpunojmë tashmë 160k mesazhe në sekondë. Ende nuk kemi arritur në limit, prandaj për momentin është e paqartë se sa realisht mund të nxjerrim nga kjo.
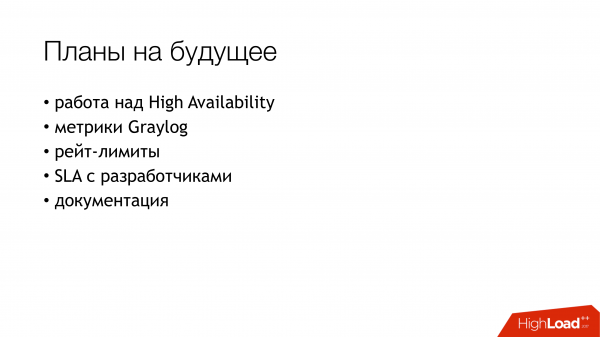
Ja si janë planet tona për të ardhmen. Nga këto, ndoshta, më e rëndësishmja është high availability. Për momentin nuk e kemi. Disa makineri janë të konfiguruara njësoj, por të gjitha kalojnë përmes një makinerie. Duhet të shpenzojmë kohë për të konfiguruar një failover mes tyre.
Të mbledhim metrika nga Graylog.
Të bëjmë një limit të normës që një API e rënë nga dora të mos na shkatërrojë bandwidth dhe gjithçka tjetër.
Dhe përfundimisht, të nënshkruajmë një SLA me zhvilluesit, se ne mund të ofrojmë kaq shumë. Nëse shkruani më shumë, nga na vjen keq.
Dhe të shkruajmë dokumentacion.
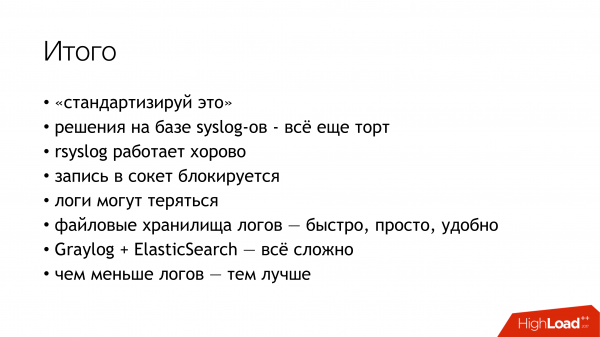
Shkurtimisht, përmbledhja e të gjitha atyre që kaluam. Së pari, standartet. Së dyti, syslog — tortë. Së treti, rsyslog funksionon pikërisht siç është shkruar në slajd. Dhe le të kalojmë te pyetjet.
Pyetje.
Pyetje: Pse vendosët të mos marrë...
Përgjigje: Duhet të shkruhet në skedarin. Ishte shumë e pakëndshme. Kur API-ja juaj shkruan mijëra mesazhe në sekondë, edhe nëse rrotulloheni një herë në orë, kjo nuk është një mundësi. Mund të shkruhet në pipe. Ndaj zhvilluesit më pyetën: "Çfarë do ndodhte nëse procesi në të cilin shkruajmë bie"? Unë thjesht nuk e gjeta dot një përgjigje, dhe thashë: "E drejtë, le të mos e bëjmë ashtu."
Pyetje: Pse nuk i shkruani thjesht loget në HDFS?
Përgjigje: Ky është hapi tjetër. Kemi menduar për të në fillim, por, për shkak se aktualisht nuk kemi burime për të punuar mbi këtë, ai mbetet si një zgjidhje afatgjatë.
Pyetje: Formati kolumnar do të ishte më i përshtatshëm.
Përgjigje: E kuptoj. Ne jemi 'për' me të dyja duar.
Pyetje: Ju shkruani në rsyslog. Aty mund të përdorni si TCP, ashtu edhe UDP. Por nëse përdorni UDP, si garantoni dorëzimin?
Përgjigje: Ka dy çështje. Së pari, unë i tregoj të gjithëve se nuk garantojmë dorëzimin e logeve. Sepse, kur zhvilluesit vijnë dhe thonë: 'Le të fillojmë të shkruajmë të dhëna financiare aty, dhe ju do t'i ruani diku për rast se ndodh ndonjë gjë', ne u përgjigjemi 'E shkëlqyer! Le të fillojmë të bllokojmë shënimin në socket dhe ta bëjmë këtë në transaksione, për të garantuar që ne e kemi vendosur në socket dhe të sigurohemi se ne e kemi marrë atë nga ana tjetër.' Në këtë moment, të gjithëve fillon të mos u nevojitet. Dhe pasi nuk kanë nevojë, çfarë pyetje na kanë ne? Nëse nuk doni të garantoni shënimin në socket, përse duhet të garantojmë dorëzimin? Ne bëjmë përpjekjet më të mira. Ne vërtet përpiqemi të dorëzojmë sa më shumë dhe sa më mirë, por nuk japim 100% garanci. Prandaj, nuk duhet të shkruani atje të dhëna financiare. Për këtë ka databaza me transaksione.
Pyetje: Kur API gjeneron një mesazh në log dhe transferon kontrollin te mikroshërbimet, a keni hasur ndonjëherë në problemin se mesazhet nga mikroshërbime të ndryshme vijnë në rend të gabuar? Kjo shkakton konfuzion.
Përgjigje: Është normale që ato të vijnë në rend të ndryshëm. Duhet të jeni gati për këtë. Sepse çdo dërgesë rrjetërore nuk ju garanton rendin, ose duhet të shpenzoni burime posaçërisht për këtë. Nëse marim depozitat e skedarëve, çdo API ruan loget në skedarin e vet. Në të vërtetë, rsyslog i vendos ato në kataloge. Çdo API ka loget e veta, ku mund të shkoni dhe të shikoni, dhe më pas sipas timestamp në këtë log mund t'i korrespondoni. Nëse ata shkojnë të shikojnë në Graylog, atje do të sortohen sipas timestamp. Aty do të jetë gjithçka në rregull.
Pyetje: Timestamp mund të ndryshojë me milisekonda.
Përgjigje: Timestamp gjenerohet nga vetë API. Kjo është, në thelb, e gjithë ideja. Ne kemi NTP. API gjeneron timestamp edhe në mesazhin vetë. Nuk është rsyslog që e shton atë.
Pyetje: Nuk është shumë e qartë si ndodhi ndërveprimi midis qendravë të të dhënave. Brenda qendrës së të dhënave është e qartë se si u mbledhën dhe u përpunuan logjet. Si ndodh ndërveprimi midis qendrave të të dhënave? Apo secila qendër të dhënash jeton jetën e saj?
Përgjigje: Pjesërisht. Çdo vend ndodhet në një qendër të dhënash të caktuar. Aktualisht nuk kemi shtrirje, që një vend të jetë i vendosur në qendra të dhënash të ndryshme. Prandaj, nuk është e nevojshme t'i bashkojmë ato. Brenda çdo qendre ka Log Relay. Kjo është një server Rsyslog. Në të vërtetë, ka dy makina menaxhimi. Ato janë të konfiguruara njësoj. Por për momentin, thjesht trafiku kalon përmes një prej tyre. Ajo agregon të gjithë logjet. Ka një radhë disku për çdo rast. Ajo kompreson logjet dhe i dërgon në qendrën e dhënave qendrore (në Singapor), nga ku më pas ato dërgohen në Graylog. Në çdo qendër të të dhënave ka edhe një storage të tij. Në rast se na mungon lidhja, ne kemi të gjitha logjet atje. Ato do të mbesin atje. Ato do të ruhen atje.
Pyetje: Në situata jashtëzakonshme, a e merrni logun nga atje?
Përgjigje: Mund të shkoni aty (në storage) dhe të shikoni.
Pyetje: Si i monitoroni që të mos i humbni logjet?
Përgjigje: Në të vërtetë, i humbim logjet dhe ne e monitorojmë këtë. Monitorimi filloi para një muaji. Në bibliotekën që përdor Go API, ka metrika. Ajo di të numërojë se sa herë nuk ka mundur të shkruajë në socket. Atje aktualisht ka një heuristik të zgjuar. Ka një buffer. Ai përpiqet të shkruajë mesazhin nga ai në socket. Nëse bufferi mbushet, ai fillon t’i heqë. Dhe llogarit se sa i ka hequr. Nëse fillojnë të mbushen numrat, ne merremi vesh për këtë. Tani ato dërgohen gjithashtu në Prometheus, dhe në Grafana mund të shihni grafikët. Mund të konfiguroni njoftimet. Por për momentin nuk është e qartë se kujt t'ia dërgojmë.
Pyetje: Në elasticsearch, ju ruani logjet me rezervim. Sa replika keni?
Përgjigje: Një replikë.
Pyetje: A është vetëm një replikë?
Përgjigje: Kjo është një master dhe një replikë. Të dhënat ruhen në dy kopje.
Pyetje: A e keni modifikuar ndonjëherë madhësinë e buffer-it të rsyslog?
Përgjigje: Ne shkruajmë datagramet në një socket unix të personalizuar. Kjo na vë menjëherë një kufizim prej 128 kilobajt. Nuk mund të shkruajmë më shumë në të. Këtë e kemi specifikuar në standard. Ata që duan të kalojnë në storagë, shkruajnë 128 kilobajt. Bibliotekat, për më tepër, e presin atë dhe vendosin një flag që mesazhi është prishur. Në standardin e vet të mesazhit kemi një fushë të veçantë që tregon nëse është prishur gjatë shkrimit apo jo. Prandaj kemi mundësinë të ndjekim edhe këtë moment.
Pyetje: A shkruani JSON të prishur?
Përgjigje: JSON i prishur do të hidhet ose gjatë relay, për shkak të paketës supe të madhe. Ose do të hidhet nga Graylog, sepse nuk do të jetë në gjendje ta analizojë JSON-in. Por ka disa nuanca që duhen rregulluar, dhe ato kryesisht lidhen me rsyslog. Kam përfunduar aty disa çështje, mbi të cilat duhet ende të punojmë.
Pyetje: Pse Kafka? A keni provuar RabbitMQ? A po has problemi me Graylog nën këto ngarkesa?
Përgjigje: Nuk po funksionojmë me Graylog. Por me Graylog jemi duke funksionuar. Është tejet problematik. Ai është një gjë origjinale. Dhe, në të vërtetë, nuk është i nevojshëm. Do të preferoja të shkruaja nga rsyslog direkt në elasticsearch dhe pastaj të shihja Kibana. Por duhet të zgjidhim çështjen me sigurimin. Ky është një variant i mundshëm i zhvillimit tonë, kur do të heqim Graylog dhe do të përdorim Kibana. Nuk do të ketë kuptim të përdorim Logstash. Sepse, mund të bëj të njëjtën gjë me rsyslog. Dhe ai ka një modul për të shkruar në elasticsearch. Me Graylog po përpiqemi të jetojmë ndonjëherë. Madje e kemi bërë pak tuning. Por ka ende hapësirë për përmirësime.
Rreth Kafka-s. Kështu ka ndodhur historikisht. Kur erdha, ajo tashmë ekzistonte, dhe ishim duke shkruar skedarët e log-ut në të. Ne thjesht ngritëm klasterin tonë dhe kaluam log-et në të. Ne e menaxhojmë, dhe e dimë si ndihen. Rreth RabbitMQ... nuk shkon mirë me RabbitMQ. Por me RabbitMQ shkojmë. E kemi në prodhim, dhe kishim disa probleme me të. Tani, para shitjeve, e kemi rregulluar dhe tani punon normalisht. Por deri atëherë nuk isha i gatshëm ta nxirrja në prodhim. Ka një moment tjetër. Graylog mund të lexojë versionin AMQP 0.9, ndërsa rsyslog mund të shkruajë versionin AMQP 1.0. Nuk ka asnjë zgjidhje që mund të bëjë të dyja. Ka vetëm njëri ose tjetri. Prandaj, për momentin vetëm Kafka. Por gjithashtu ka nuanca të veta. Sepse omkafka në atë versionin e rsyslog-it që po përdorim, mund të humbasë tërë tamponin e mesazheve që ka marrë nga rsyslog. Deri tani po pajtohemi me këtë.
Pyetje: A e përdorni Kafka-n sepse ajo tashmë ishte atje? Nuk përdoret për ndonjë qëllim tjetër?
Përgjigje: Kafka, e cila ishte atje, përdoret nga ekipi i Data Sсience. Ky është një projekt krejt ndryshe, për të cilin, fatkeqësisht, nuk mund të them asgjë. Nuk jam në dijeni. Ajo ka qenë nën menaxhimin e ekipit të Data Sсience. Kur hodhën log-et, vendosën ta përdorin atë, për të mos u detyruar të instalonin edhe të vetën. Tani e kemi përditësuar Graylog-un dhe humbëm kompatibilitetin, sepse atje është një version i vjetër i Kafka-s. Na duhej të krijonim të tonën. Njëkohësisht u shpëtuam nga ato katër tema për çdo API. Bëmë një temë të gjerë për të gjitha live-t, një temë të gjerë për të gjitha staging-t dhe thjesht i dërgojmë të gjitha aty. Graylog-i i ekzekuton këto paralelisht.
Pyetje: Pse është e nevojshme kjo magji me soketët? A keni provuar të përdorni log-drajverin syslog për kontejnerët?
Përgjigje: Në atë moment kur u angazhuam me këtë çështje, marrëdhëniet tona me Docker-in ishin tensionuese. Ishte Docker 1.0 ose 0.9. Docker vetë ishte i çuditshëm. Së dyti, nëse duhet të fusësh log-et në të... Kam një dyshim të pasigurt se ai i kalon të gjitha log-et përmes vetes, përmes demonit të Docker-it. Nëse një API ynë është duke u çmendur, atëherë API-të e tjera hasin vështirësi në dërgimin e stdout dhe stderr. Nuk e di çfarë do të ndodhë nga kjo. Kam një ndjenjë intuitive se nuk duhet të përdorim drejtuesin syslog të Docker-it në këtë vend. Departamenti ynë për testimin funksional ka një kluster të vetin Graylog me log-et. Ata përdorin drejtues log-esh të Docker-it dhe duket se gjithçka shkon mirë. Por ata e shkruajnë GELF direkt në Graylog. Kur filluam këtë, duhej të funksiononte thjesht. Ndoshta më vonë, kur dikush të thotë se gjithçka funksionon mirë për një kohë të gjatë, do ta provojmë.
Pyetje: Po e bëni dërgesën mes qendrave të të dhënave me rsyslog. Pse jo me Kafka?
Përgjigje: Ne e bëjmë edhe kështu, edhe ashtu në të vërtetë. Për dy arsye. Nëse kanali është plotësisht i prishur, të gjithë log-et tanë, përfshirë ato të kompresuar, nuk kalojnë përmes tij. Ndërsa Kafka lejon që ato thjesht të humbasin gjatë procesit. Me këtë metodë ne shmangim ngjeshjen e këtyre log-eve. Thjesht përdorim Kafka në këtë rast direkt. Nëse kanali ynë është i mirë dhe duam ta lëmë atë të lirë, atëherë përdorim rsyslog-in. Por në të vërtetë, mund ta konfiguroni në mënyrë që ai vetë të hedh atë që nuk kalon. Në këtë moment ne thjesht përdorim dërgimin rsyslog direkt në disa vende, dhe Kafka në të tjerët.
Burimi: habr.com
