

Pavel Selivanov, arkitekt zgjidhjesh në Southbridge dhe lektor i Slurm, mbajti një referat në DevOpsConf 2019. Ky referat është pjesë e një prej temave të kursit të avancuar për Kubernetes “Slurm Mega”.
mbahet në Moskë më 18-20 nëntor.
— Moskë, 22-24 nëntor.
është i disponueshëm gjithmonë.
Më poshtë është transkriptimi i referatit.
Mirëdita, kolegë dhe të gjithë ata që merren me këtë fushë. Sot do të flas për sigurinë.
Shoh që sot në sallë ka shumë specialistë të sigurisë. Ju kërkoj ndjesë paraprakisht nëse disa terma nga bota e sigurisë nuk do t’i përdor tamam ashtu siç jeni mësuar ju.
Rreth gjashtë muaj më parë, më ra në dorë një klaster publik Kubernetes. Publik do të thotë që aty kishte një numër të caktuar namespacesh, në këto namespace kishte users, të izoluar secili brenda namespace-it të vet. Të gjithë këta përdorues i përkisnin kompanive të ndryshme. Ideja ishte që ky klaster të përdorej si CDN. Pra, ju japin klasterin, ju japin një përdorues, ju hyni në namespace-in tuaj dhe deployoni frontend-et tuaja.
Këtë shërbim u përpoqën t’ia shisnin kompanisë sime të mëparshme. Mua më kërkuan ta testoja klasterin për të kuptuar nëse një zgjidhje e tillë ishte e përshtatshme apo jo.
Hyra në atë klaster. Më dhanë të drejta të kufizuara dhe një namespace të kufizuar. Ata e kuptonin çfarë është siguria. Kishin lexuar për Role-based access control (RBAC) në Kubernetes dhe e kishin shtrënguar aq shumë, sa nuk mund të nisja pods veçmas nga deployments. Nuk e mbaj mend më çfarë detyre po përpiqesha të zgjidhja duke nisur një pod pa deployment, por doja shumë të nisja thjesht një pod. Vendosa, sa për provë, të shihja çfarë të drejtash kisha në klaster, çfarë mund të bëja e çfarë jo, dhe çfarë kishin konfiguruar aty. Po ashtu do t’ju tregoj edhe çfarë kishin të konfiguruar gabim në RBAC.
Dhe kështu ndodhi që pas dy minutash mora të drejta administratori në klasterin e tyre, pashë të gjitha namespaces fqinje dhe aty gjeta frontend-e production të kompanive që e kishin blerë tashmë shërbimin dhe ishin deployuar. Mezi e përmbajta veten që të mos hyja te frontend-i i dikujt dhe të mos vendosja ndonjë fjalë banale në faqen kryesore.
Do t’ju tregoj me shembuj si e bëra këtë dhe si duhet të mbroheni prej saj.
Por së pari, po prezantohem. Quhem Pavel Selivanov. Jam arkitekt në Southbridge. Merrem me Kubernetes, DevOps dhe gjithë ato gjëra moderne. Bashkë me inxhinierët e Southbridge i ndërtojmë të gjitha këto, ndërsa unë merrem me konsulencë.
Përveç aktivitetit tonë kryesor, së fundmi kemi nisur edhe projekte që quhen Slurm. Po përpiqemi ta sjellim përvojën tonë me Kubernetes më pranë audiencës së gjerë, që t’u mësojmë edhe të tjerëve si të punojnë me K8s.
Për çfarë do të flas sot. Tema e prezantimit është e qartë — siguria e një klasteri Kubernetes. Por dua ta them menjëherë se kjo është një temë shumë e gjerë, ndaj po e sqaroj që tani se për çfarë nuk do të flas. Nuk do të ndalem te termat e konsumuar, që në internet janë përtypur tashmë qindra herë. Si RBAC dhe certifikatat.
Do të flas për atë që më shqetëson mua dhe kolegët e mi te siguria në një klaster Kubernetes. Këto probleme i shohim si te ofruesit që ofrojnë klasterë Kubernetes, ashtu edhe te klientët që vijnë tek ne. Madje edhe te klientët që na vijnë nga kompani të tjera konsulence dhe administrimi. Pra, në fakt përmasat e problemit janë shumë të mëdha.
Vetëm tre pika për të cilat do të flas sot:
- Të drejtat e përdoruesve kundrejt të drejtave të pod-eve. Të drejtat e përdoruesve dhe të drejtat e pod-eve nuk janë e njëjta gjë.
- Mbledhja e informacionit për klasterin. Do të tregoj se si nga klasteri mund të merret i gjithë informacioni i nevojshëm, edhe pa pasur privilegje të veçanta në të.
- Sulm DoS ndaj klasterit. Edhe nëse nuk arrijmë të mbledhim informacion, prapëseprapë mund ta rrëzojmë klasterin. Do të flas për sulmet DoS ndaj elementeve të kontrollit të klasterit.
Edhe një gjë e përgjithshme që do ta përmend është se ku i kam testuar të gjitha këto, pra mbi çfarë baze mund të them me siguri se e gjithë kjo funksionon.
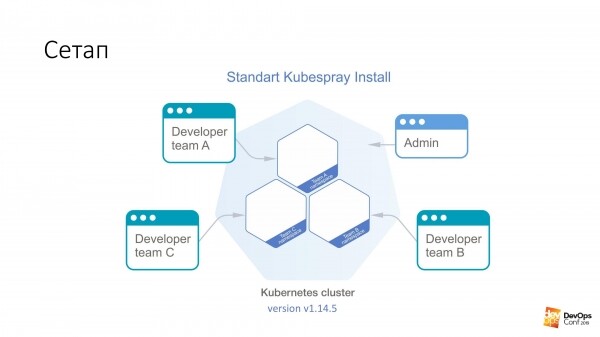
Si bazë marrim instalimin e një klasteri Kubernetes me ndihmën e Kubespray. Nëse dikush nuk e di, në thelb është një grup rolesh për Ansible. Ne e përdorim vazhdimisht në punën tonë. E mira e tij është se mund të vendoset kudo: si në serverë fizikë, ashtu edhe në cloud. Një mënyrë instalimi është praktikisht e përshtatshme për gjithçka.
Në këtë klaster do të kem Kubernetes v1.14.5. I gjithë klasteri Kubernetes që do të shqyrtojmë është i ndarë në namespace, dhe secili namespace i përket një ekipi të veçantë; në çdo namespace kanë qasje vetëm anëtarët e atij ekipi. Ata nuk mund të hyjnë në namespace të tjera, vetëm në të vetin. Por ekziston një llogari administratori që ka të drejta në të gjithë klasterin.
Premtova që hapi i parë do të ishte marrja e të drejtave të administratorit në klaster. Na duhet një pod i përgatitur posaçërisht, që do të komprometojë klasterin Kubernetes. Gjithçka që duhet të bëjmë është ta aplikojmë atë në klasterin Kubernetes.
kubectl apply -f pod.yamlKy pod do të vendoset në një nga masterët e klasterit Kubernetes. Pas kësaj, klasteri do të na kthejë me kënaqësi një skedar që quhet admin.conf. Në Kubernetes, në këtë skedar ruhen të gjitha certifikatat e administratorit, si edhe konfigurimi i API-së së klasterit. Kaq thjesht mund të merret qasje administratori, mendoj, në rreth 98% të klasterëve Kubernetes.
Po e përsëris: këtë pod e krijoi një zhvillues në klasterin tuaj, i cili ka të drejtë të deployojë aplikacionet e veta në një namespace të vogël, plotësisht të kufizuar nga RBAC. Nuk kishte fare privilegje. Megjithatë, certifikata u kthye.
Tani për pod-in e përgatitur posaçërisht. E nisim mbi çfarëdo image. Për shembull, le të marrim debian:jessie.
Kemi diçka të tillë:
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
Çfarë është toleration? Masterët në një klaster Kubernetes zakonisht shënohen me diçka që quhet taint. Thelbi i këtij taint është që ai tregon se në nyjet master nuk lejohen të caktohen pod-e. Por asgjë nuk e pengon që në çdo pod të specifikohet se ai e toleron këtë taint. Seksioni Toleration pikërisht këtë thotë: nëse në një nyje është vendosur NoSchedule, atëherë pod-i ynë e toleron atë taint dhe nuk ka asnjë problem.
Më tej, themi se pod-i ynë jo vetëm që e toleron këtë, por dëshiron të shkojë në mënyrë të qëllimshme te masterët. Sepse pikërisht te masterët ndodhet ajo që na duhet më shumë: të gjitha certifikatat. Prandaj përdorim nodeSelector, dhe në masterë kemi një label standard që na lejon të zgjedhim nga të gjitha nyjet e klasterit pikërisht ato që janë master.
Me këto dy seksione, pod-i do të vendoset patjetër në master. Dhe do të lejohet të qëndrojë atje.
Por vetëm vendosja në master nuk mjafton. Kjo nuk na jep asgjë. Prandaj më tej kemi edhe këto dy gjëra:
hostNetwork: true
hostPID: true
Ne po përcaktojmë që pod-i ynë, të cilin e nisim, do të ekzistojë në namespace-in e kernelit, në namespace-in e rrjetit dhe në namespace-in PID. Sapo pod-i të niset në master, ai do të mund të shohë të gjitha ndërfaqet reale e aktive të kësaj node, të dëgjojë të gjithë trafikun dhe të shohë PID-të e të gjitha proceseve.
Më pas gjithçka është e thjeshtë. Merrni etcd dhe lexoni çfarë të doni.
Më interesantja është se kjo është një veçori e Kubernetes që ekziston aty si parazgjedhje.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
Dhe thelbi është që në pod-in që nisim, edhe pa pasur të drejta në këtë klaster, mund të deklarojmë se duam të krijojmë një volume të tipit hostPath. Kjo do të thotë të marrim një shteg nga host-i ku do të nisim pod-in dhe ta përdorim si volume. Më pas i japim emrin name: host. Të gjithë këtë hostPath e montojmë brenda pod-it. Në këtë shembull, në direktorinë /host.
Po e përsëris edhe një herë. I thamë pod-it të shkonte në master, të merrte aty hostNetwork dhe hostPID, dhe të montonte të gjithë root-in e master-it brenda këtij pod-i.
Ju e kuptoni që në Debian kemi të nisur bash, dhe ky bash ekzekutohet si root. Pra, sapo morëm root në master, pa pasur ndonjë lloj të drejte në klasterin Kubernetes.
Më pas e gjithë detyra është të hyni në pod, në direktorininë /host /etc/kubernetes/pki, nëse nuk gaboj, të merrni prej andej të gjitha certifikatat e master-it të klasterit dhe, rrjedhimisht, të bëheni administrator i klasterit.
Nëse e shohim kështu, këto janë disa nga të drejtat më të rrezikshme në pod-e, pavarësisht se çfarë të drejtash ka përdoruesi:
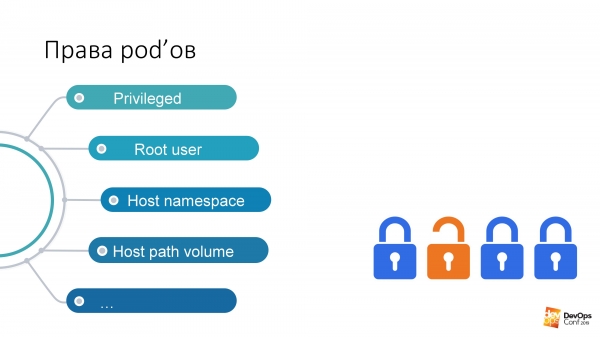
Nëse kam të drejtë të nis një pod në një namespace të caktuar të klasterit, atëherë ky pod i ka këto të drejta si parazgjedhje. Unë mund të nis pod-e të privilegjuar, dhe kjo do të thotë praktikisht të gjitha të drejtat, pothuajse root në node.
E preferuara ime është Root user. Ndërsa Kubernetes ka një opsion të tillë si Run As Non-Root. Është një lloj mbrojtjeje kundër hakerit. E dini çfarë është “virusi moldav”? Nëse rastësisht je haker dhe ke hyrë në klasterin tim Kubernetes, ne administratorët e shkretë të lutemi: “Të lutem, specifiko në pod-et me të cilat do të sulmosh klasterin tim që të përdoret run as non-root. Përndryshe, mund të ndodhë që ta nisesh procesin në pod-in tënd si root dhe do ta kesh shumë të lehtë të më sulmosh. Të lutem, mbrohu nga vetja vetë”.
Host path volume — sipas meje, është mënyra më e shpejtë për të arritur rezultatin e dëshiruar nga një klaster Kubernetes.
Por çfarë duhet bërë me gjithë këtë?
Mendimet që duhet t’i vijnë çdo administratori normal kur përballet me Kubernetes: «Ja pra, e thashë unë, Kubernetes nuk funksionon. Ka vrima. Dhe i gjithë Kubi është kot». Në fakt, ekziston një gjë e quajtur dokumentacion dhe, nëse e hapni, aty ka një seksion .
Ky është një objekt yaml që mund ta krijojmë në një klaster Kubernetes dhe që kontrollon aspektet e sigurisë pikërisht në përshkrimin e pod-eve. Pra, në praktikë ai kontrollon të drejtat për përdorimin e gjërave si hostNetwork, hostPID, lloje të caktuara të volume-ve, të cilat pod-et i kanë gjatë nisjes. Me Pod Security Policy e gjithë kjo mund të përshkruhet.
Gjëja më interesante te Pod Security Policy është se në klasterin Kubernetes, te të gjithë instaluesit, PSP jo vetëm që nuk është i përshkruar fare, por është thjesht i çaktivizuar si parazgjedhje. Pod Security Policy aktivizohet me ndihmën e admission plugin.
Në rregull, le të deploy-ojmë Pod Security Policy në klaster dhe të përcaktojmë se kemi disa pod-e shërbimi në një namespace ku kanë akses vetëm administratorët. Ndërsa për të gjithë të tjerët, pod-et do të kenë të drejta të kufizuara. Sepse ka shumë të ngjarë që zhvilluesve të mos u duhet të ekzekutojnë pod-e të privilegjuar në klasterin tuaj.
Dhe duket sikur gjithçka është në rregull. Dhe klasteri ynë Kubernetes nuk mund të komprometohet për dy minuta.
Ka një problem. Ka shumë të ngjarë që, nëse keni një klaster Kubernetes, atëherë në klasterin tuaj është instaluar monitorim. Madje guxoj të parashikoj se, nëse në klasterin tuaj ka monitorim, ai quhet Prometheus.
Ajo që do të tregoj tani do të jetë e vlefshme si për Prometheus Operator, ashtu edhe për Prometheus të instaluar në formën e tij të pastër. Çështja është se, nëse nuk mund të marr kaq shpejt akses administratori në klaster, kjo do të thotë se më duhet të kërkoj më shumë. Dhe mund ta bëj këtë kërkim me ndihmën e monitorimit tuaj.
Me shumë gjasë, të gjithë kanë lexuar të njëjtat artikuj në Habr dhe monitorimi ndodhet në namespace monitoring. Helm chart quhet pothuajse njësoj te të gjithë. Supozoj se, nëse bëni helm install stable/prometheus, do të merrni afërsisht të njëjtat emra. Dhe madje ka shumë mundësi që të mos më duhet as të hamendësoj emrin DNS në klasterin tuaj. Sepse ai është standard.
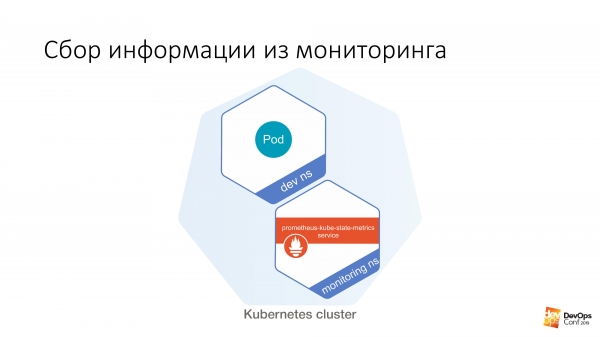
Më pas kemi një dev ns, ku mund të niset një pod. Dhe pastaj nga ky pod është shumë e lehtë të bëhet kështu:
$ curl http://prometheus-kube-state-metrics.monitoring prometheus-kube-state-metrics është një nga eksportuesit e Prometheus që mbledh metrika nga vetë API i Kubernetes. Aty ka shumë të dhëna për atë që po ekzekutohet në cluster-in tuaj, çfarë është dhe çfarë problemesh keni me të.
Si shembull i thjeshtë:
kube_pod_container_info{namespace=«kube-system»,pod=»kube-apiserver-k8s- 1″,container=»kube-apiserver»,image=
«gcr.io/google-containers/kube-apiserver:v1.14.5»
,image_id=»docker-pullable://gcr.io/google-containers/kube- apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a96 38ee634989″,container_id=»docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2 853397d7daf08e72c22d3cf8b»} 1
Duke bërë një kërkesë të thjeshtë curl nga një pod jo i privilegjuar, mund të merrni pikërisht një informacion të tillë. Nëse nuk e dini se në cilin version të Kubernetes po punoni, ai do t’jua tregojë fare lehtë.
Dhe më interesantja është se, përveçse i drejtoheni kube-state-metrics, po aq lehtë mund t’i drejtoheni edhe vetë Prometheus drejtpërdrejt. Mund të mblidhni metrika prej tij. Madje mund të ndërtoni edhe metrika prej andej. Teorikisht, mund të ndërtoni nga cluster-i edhe një kërkesë të tillë drejt Prometheus që thjesht ta rrëzojë atë. Dhe monitorimi juaj do të ndalojë së funksionuari fare për cluster-in.
Dhe këtu lind tashmë pyetja nëse monitorimi juaj monitorohet nga ndonjë sistem i jashtëm monitorimi. Sapo mora mundësinë të veproj në cluster-in Kubernetes pa asnjë pasojë për veten time. Madje as nuk do ta kuptoni që po veproj aty, sepse monitorimi nuk ekziston më.
Ashtu si me PSP, krijohet përshtypja sikur problemi qëndron te fakti se të gjitha këto teknologji moderne — Kubernetes, Prometheus — thjesht nuk funksionojnë dhe janë plot me vrima. Në fakt, jo.
Ekziston një gjë e tillë — .
Nëse jeni një administrator normal, me shumë gjasë për Network Policy dini vetëm se është edhe një YAML tjetër, nga ata që në cluster ka tashmë plot e përplot. Dhe se Network Policies nuk duhen fare. Edhe nëse e keni lexuar se çfarë është Network Policy, që është një firewall YAML i Kubernetes, i cili ju lejon të kufizoni të drejtat e aksesit midis namespace-ve dhe midis pod-eve, me siguri keni vendosur se një firewall në format YAML në Kubernetes, mbi një shtresë tjetër abstraksioni... Jo, jo. Kjo me siguri nuk duhet.
Edhe nëse specialistët tuaj të sigurisë nuk ju kanë thënë se me Kubernetes-in tuaj mund të ndërtoni shumë lehtë një firewall, madje shumë të detajuar. Nëse ende nuk e dinë këtë dhe nuk ju ngacmojnë me: «Hajde, na jepni…», gjithsesi ju duhen Network Policy që të kufizoni aksesin te disa pika shërbimi, të cilat mund të arrihen nga klasteri juaj pa pasur asnjë autorizim.
Si në shembullin që përmenda, kube state metrics mund të arrihet nga çdo namespace në klasterin Kubernetes pa pasur asnjë të drejtë për këtë. Network policies e mbyllën aksesin nga të gjithë namespace-et e tjera drejt namespace-it të monitorimit dhe kaq: s’ka akses, s’ka problem. Në të gjitha chart-et që ekzistojnë, si te Prometheus standard ashtu edhe te ai që vjen në operator, në Helm values ka thjesht një opsion për t’i aktivizuar network policies për to. Mjafton ta aktivizoni dhe ato do të funksionojnë.
Megjithatë, këtu ka një problem. Si një admin klasik me përvojë, me shumë gjasë keni vendosur se network policies nuk ju duhen. Dhe pasi keni lexuar artikuj të ndryshëm në burime si Habr, keni vendosur se flannel, sidomos në regjimin host-gateway, është zgjedhja më e mirë që mund të bëni.
Çfarë të bëjmë?
Mund të provoni ta rideploy-oni zgjidhjen e rrjetit që keni në klasterin tuaj Kubernetes, pra ta zëvendësoni me diçka më funksionale. Për shembull, me Calico. Por dua ta them menjëherë: detyra për të ndryshuar zgjidhjen e rrjetit në një klaster Kubernetes në prodhim nuk është aspak e thjeshtë. Unë e kam zgjidhur dy herë këtë çështje (edhe pse të dyja herët teorikisht), madje edhe në Slurm kemi treguar si bëhet. Për pjesëmarrësit tanë në trajnim kemi demonstruar si të ndryshohet zgjidhja e rrjetit në një klaster Kubernetes. Në parim, mund të përpiqeni ta bëni pa downtime në klasterin e prodhimit. Por me shumë gjasë nuk do t’ia dilni.
Dhe në fakt problemi zgjidhet shumë thjesht. Në klaster ka certifikata dhe ju e dini që ato do të skadojnë pas një viti. Zakonisht zgjidhja tipike për certifikatat në klaster është: pse të lodhemi, ngremë një klaster të ri pranë tij, të vjetri le të skadojë dhe i rideploy-ojmë të gjitha. E vërteta është se, kur të skadojnë, për një ditë gjithçka do të qëndrojë jashtë funksionit, por ama do të kemi një klaster të ri.
Kur të ngrini klasterin e ri, vendosni njëkohësisht Calico në vend të flannel.
Çfarë të bëni nëse certifikatat tuaja janë lëshuar për njëqind vjet dhe nuk keni ndërmend ta rideploy-oni klasterin? Ekziston një mjet i quajtur Kube-RBAC-Proxy. Është një zgjidhje shumë e mirë që mund të integrohet si sidecar container me çdo pod në klasterin Kubernetes. Në praktikë, ajo i shton atij pod-i autorizimin përmes RBAC të vetë Kubernetes.
Ka vetëm një problem. Më parë, në Prometheus Operator, kjo zgjidhje Kube-RBAC-Proxy ishte e integruar. Por më pas u hoq. Tani versionet moderne mbështeten te fakti që ju keni network policy dhe e kufizoni aksesin përmes tyre. Prandaj do të duhet të rishkruani pak chart-in. Në fakt, nëse hyni te , aty ka shembuj se si të përdoret si sidecar, dhe chart-et do të duhet të ndryshohen shumë pak.
Ka edhe një problem tjetër të vogël. Jo vetëm Prometheus i ekspozon metrikat e veta kujtdo. Edhe të gjithë komponentët e klasterit Kubernetes dinë t’i ekspozojnë metrikat e tyre.
Por siç e thashë edhe më parë, nëse nuk mund të marrësh akses në klaster dhe të mbledhësh informacion, të paktën mund të bësh dëm.
Prandaj do t’ju tregoj shpejt dy mënyra se si mund t’ia prishni shëndetin një klasteri Kubernetes.
Do të qeshni kur t’jua tregoj këtë, sepse janë dy raste nga jeta reale.
Mënyra e parë. Shterimi i burimeve.
Nisim edhe një pod të posaçëm. Ai do të ketë një seksion të tillë.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Siç e dini, requests është sasia e CPU dhe memories që rezervohet në host për pod-et përkatëse. Nëse kemi një host me katër bërthama në klasterin Kubernetes dhe aty vendoset një pod me requests prej katër CPU, atëherë asnjë pod tjetër me requests nuk do të mund të vendoset më në atë host.
Nëse nis një pod të tillë dhe pastaj ekzekutoj komandën:
$ kubectl scale special-pod --replicas=...Atëherë askush tjetër nuk do të mund të deploy-ojë më në klasterin Kubernetes. Sepse në të gjitha nyjet do të mbarojnë requests. Dhe në këtë mënyrë unë do ta ndal klasterin tuaj Kubernetes. Nëse e bëj këtë në mbrëmje, mund t’i bllokoj deploy-et për një kohë goxha të gjatë.
Nëse i hedhim edhe një herë një sy dokumentacionit të Kubernetes, do të shohim një mekanizëm që quhet Limit Range. Ai përcakton kufijtë e burimeve për objektet e klasterit. Mund të krijoni një objekt Limit Range në YAML, ta aplikoni në namespace të caktuara dhe më pas, brenda atij namespace-i, të përcaktoni vlera të parazgjedhura, maksimale dhe minimale të burimeve për pod-et.
Me këtë mekanizëm mund t’i kufizojmë përdoruesit në namespace-et konkrete të produkteve ose ekipeve, që të mos vendosin çfarëdo parametrash të papërshtatshëm te pod-et e tyre. Por, për fat të keq, edhe nëse i thoni përdoruesit se nuk lejohet të nisë pod-e me requests mbi një CPU, ekziston komanda scale, ose mund ta bëjnë scaling edhe përmes dashboard-it.
Dhe prej këtej vjen mënyra numër dy: të nisim 11 111 111 111 111 pod-e. Janë njëmbëdhjetë miliardë. Jo sepse e shpika unë këtë numër, por sepse e kam parë vetë.
Histori e vërtetë. Një mbrëmje vonë po bëhesha gati të largohesha nga zyra. Shoh që në një cep rrinte një grup zhvilluesish dhe po bënin diçka me nxitim në laptopët e tyre. Afrohem te djemtë dhe i pyes: «Çfarë ka ndodhur?»
Pak më herët, rreth orës nëntë të mbrëmjes, një nga zhvilluesit po bëhej gati të shkonte në shtëpi. Dhe vendosi: «Tani do ta bëj scale aplikacionin tim në një». Shtypi njëshen, por interneti u ngadalësua pak. E shtypi edhe një herë njëshen, e mbajti të shtypur, klikoi Enter. Preku gjithçka që mundi. Pastaj interneti u rikthye — dhe gjithçka filloi të bënte scale drejt atij numri.
Në të vërtetë, kjo histori nuk ndodhi në Kubernetes; në atë kohë ishte Nomad. Përfundoi kështu: pas një ore përpjekjesh tona për ta ndaluar Nomad-in nga përpjekjet këmbëngulëse për të bërë scale, Nomad u përgjigj se nuk do të ndalonte së bëri scale dhe nuk do të merrej me asgjë tjetër. «U lodha, po iki». Dhe u mbyll.
Natyrisht, provova të bëja të njëjtën gjë edhe në Kubernetes. Njëmbëdhjetë miliardë pod-e nuk e gëzuan Kubernetes-in; ai tha: «Nuk mundem. Tejkalon kufijtë e brendshëm». Por 1 000 000 000 pod-e i përballoi.
Si përgjigje ndaj një miliardi, Kube nuk u bllokua në vetvete. Në fakt, ai filloi të shkallëzohej. Sa më tej shkonte procesi, aq më shumë kohë i duhej për të krijuar pod-e të reja. Megjithatë, procesi vazhdonte. Problemi i vetëm është se, nëse në namespace-in tim mund të nis pa kufi pod-e, atëherë edhe pa requests dhe limits mund të lëshoj aq shumë pod-e me disa detyra, saqë për shkak të tyre nodet do të fillojnë të mbingarkohen nga memoria dhe CPU. Kur nisim kaq shumë pod-e, informacioni prej tyre duhet të shkojë në storage, domethënë në etcd. Dhe kur aty mbërrin tepër shumë informacion, storage fillon të përgjigjet shumë ngadalë — dhe Kubernetes fillon të ngadalësohet ndjeshëm.
Dhe ka edhe një problem tjetër… Siç e dini, komponentët e menaxhimit të Kubernetes nuk janë një mekanizëm i vetëm qendror, por disa komponentë të veçantë. Aty janë, në veçanti, controller manager, scheduler e të tjerë. Të gjithë këta do të fillojnë njëkohësisht të kryejnë punë të panevojshme dhe joefektive, e cila me kalimin e kohës do të marrë gjithnjë e më shumë kohë. Controller manager do të krijojë pod-e të reja. Scheduler do të përpiqet t’u gjejë një node të re. Nodet e reja në cluster-in tuaj, me shumë gjasë, do të mbarojnë shpejt. Cluster-i Kubernetes do të fillojë të punojë gjithnjë e më ngadalë.
Por vendosa të shkoj edhe më tej. Siç e dini, në Kubernetes ekziston një mekanizëm që quhet service. Dhe, si parazgjedhje, në cluster-et tuaja, me shumë gjasë, service funksionon përmes IP tables.
Nëse nisen, për shembull, një miliard pod-e dhe më pas me ndihmën e një skripti detyrohet Kubernetes të krijojë service të reja:
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
Në të gjitha nodet e cluster-it, pothuajse njëkohësisht, do të gjenerohen gjithnjë e më shumë rregulla të reja iptables. Madje, për çdo service do të gjenerohet nga një miliard rregullash iptables.
E kam testuar gjithë këtë në disa mijëra, deri në rreth dhjetë mijë. Problemi është se tashmë në këtë nivel bëhet mjaft e vështirë të lidheni me node-n përmes SSH. Sepse paketat, duke kaluar nëpër kaq shumë zinxhirë, fillojnë të mos funksionojnë edhe aq mirë.
Edhe kjo zgjidhet me Kubernetes. Ekziston një objekt i tillë si Resource quota. Ai përcakton sasinë e burimeve dhe objekteve të disponueshme për namespace-in në cluster. Ne mund të krijojmë një objekt yaml në çdo namespace të cluster-it Kubernetes. Me ndihmën e këtij objekti mund të përcaktojmë që për këtë namespace janë caktuar një sasi e caktuar requests, limits, dhe më pas mund të themi që në këtë namespace mund të krijohen 10 service dhe 10 pod. Dhe zhvilluesi mund të provojë sa të dojë ta rrisë me nga një. Kubernetes do t’i thotë: «Nuk mund t’i shkallëzoni pod-et tuaja në një numër të tillë, sepse tejkalohet resource quota». Kaq, problemi u zgjidh. .
Megjithatë, këtu lind një moment problematik. E kuptoni sa e ndërlikuar bëhet krijimi i një namespace në Kubernetes. Për ta krijuar, duhet të marrim parasysh shumë gjëra.
Resource quota + Limit Range + RBAC
• Krijojmë namespace
• Krijojmë brenda LimitRange
• Krijojmë brenda ResourceQuota
• Krijojmë serviceaccount për CI
• Krijojmë rolebinding për CI dhe përdoruesit
• Opsionalisht nisim pod-et e nevojshme të shërbimit
Prandaj, meqë ra fjala, dua të ndaj me ju zgjidhjet e mia. Ekziston një mjet që quhet operator SDK. Kjo është një mënyrë për të shkruar operatorë për Kubernetes brenda cluster-it. Operatorët mund t’i shkruani me Ansible.
Në fillim e kishim shkruar me Ansible, por më pas pashë që ekziston operator SDK dhe e rishkrova rolin Ansible si operator. Ky operator lejon krijimin në cluster-in Kubernetes të një objekti që quhet ekip. Brenda ekipit ai lejon të përshkruhet në yaml mjedisi për këtë ekip. Dhe brenda mjedisit të ekipit mund të përshkruhet se sa burime ndajmë.
Një mjet i vogël .
Dhe në përfundim. Çfarë të bëjmë me gjithë këtë?
Së pari. Pod Security Policy është gjë e mirë. Dhe pavarësisht se deri më sot asnjë nga instaluesit e Kubernetes nuk i përdor, gjithsesi ju duhet t’i përdorni në cluster-at tuaj.
Network Policy nuk është ndonjë veçori tjetër e panevojshme. Është diçka që i duhet realisht cluster-it.
LimitRange/ResourceQuota — ka ardhur koha t’i përdorni. Ne kemi kohë që i përdorim dhe për një kohë të gjatë kam qenë i bindur se i përdorin të gjithë. Doli që kjo është e rrallë.
Përveç asaj që përmenda gjatë prezantimit, ka veçori të padokumentuara që mundësojnë sulmin ndaj klasterit. Së fundi doli .
Disa gjëra janë aq të trishta dhe zhgënjyese. Për shembull, në disa kushte kubelet-et në një klaster Kubernetes mund të japin përmbajtjen e direktorisë warlocks, madje edhe një përdoruesi të paautorizuar.
ndodhen udhëzimet se si të riprodhoni gjithçka për të cilën fola. Aty gjenden skedarë me shembuj production se si duken ResourceQuota dhe Pod Security Policy. Dhe të gjitha këto mund t’i provoni vetë.
Faleminderit të gjithëve.
Burimi: habr.com
