

Pohoj si nga përvoja ime personale se ku dhe kur më ka nevojitur. Një përmbledhje dhe pika kyçe, në mënyrë që të kuptoni se çfarë dhe ku mund të thelloheni më tej — por këtu kam përvojën time tërësisht subjektive, ndoshta për ju është krejtësisht ndryshe.
Pse është e rëndësishme të dini dhe të dini si të trajtoni gjuhët e kërkesave? Në thelb, në Data Science ka disa faza thelbësore të punës dhe faza e parë dhe më e rëndësishme (pa të, asgjë absolutisht nuk do të funksionojë!) — është marrja ose nxjerrja e të dhënave. Më së shpeshti, të dhënat ndodhen diku në një formë dhe duhet t’i nxjerrim.
Gjuha e kërkesave pikërisht lejon të nxjerrim këto të dhëna! Dhe sot do të flas për ato gjuhë kërkese që më kanë ndihmuar dhe do të tregoj se ku dhe si pikërisht — përse është e nevojshme për studim.
Do të ketë tri blloqe kryesore të tipeve të kërkesave për të dhëna që do t’i shqyrtojmë në këtë artikull:
- Gjuha e kërkesave "standard" — ajo që zakonisht kuptojmë kur flasim për gjuhën e kërkessave, siç është algebra relacional ose SQL.
- Gjuha e skripteve të kërkesave: për shembull, gjëra python si pandas, numpy ose shell scripting.
- Gjuha e kërkesave për grafët e njohurive dhe bazat e të dhënave grafike.
E gjithë ajo që është shkruar këtu — është thjesht përvoja personale, se çfarë më ka ndihmuar, me përshkrimin e situatave dhe "pse ka qenë e nevojshme" — çdo njeri mund të provojë se sa situata të tilla mund t’i hasë dhe të përgatitet për to paraprakisht, duke filluar me këto gjuhë deri sa të detyrohet t'i përdorë në (me ngut) projektin ose në përgjithësi të shkojë në një projekt ku janë të nevojshme.
Gjuha e kërkesave "standard"
Gjuha e kërkesave standard është në atë kuptim, që zakonisht ne saktësisht ndaj tyre mendojmë kur flasim për kërkesat.
Algebra relacional
Pse është e nevojshme sot algebra relacional? Për të pasur një përfaqësim të mirë, pse gjuhët e kërkesave janë formuar në këtë mënyrë dhe për t’i përdorur me ndërgjegje, është e nevojshme të kuptohet thelbi i saj.
Çfarë është algebra relacional?
Përkufizimi formal është: algebra relacional — një sistem i mbyllur operacionesh mbi marrëdhëniet në modelin e të dhënave relacional. Nëse flasim më njerëzish, është një sistem operacionesh mbi tabela, të tilla që rezultati gjithmonë është gjithashtu një tabelë.
Shiko të gjitha operacionet relacional në artikullin nga Habra - këtu ne përshkruajmë se pse është e rëndësishme të dihet dhe ku përdoret.
Përse?
Fillon të kuptosh se si formohen gjuhët e kërkimeve dhe cilat operacione janë pas shprehjeve të caktuara të gjuhëve të kërkimeve - shpesh ofron një kuptim më të thellë të asaj që funksionon dhe si funksionon në gjuhët e kërkimeve.
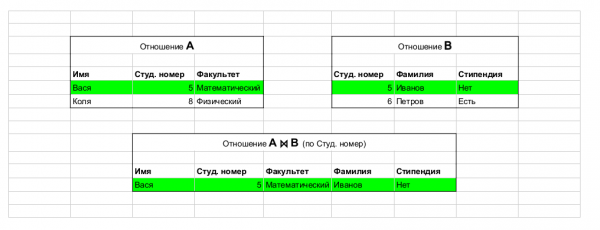
Marrë nga artikuj. Një shembuj operativ: bashkimi, i cili bashkon tabela.
Materialet për studim:
. Në përgjithësi, ka shumë materiale për algjebrën relacionale dhe teorinë - Coursera, Udacity. Ka gjithashtu një numër të madh materialesh online, përfshirë disa të mira . Këshilla ime personale: duhet të kuptohet shumë mirë algebra relacionale - kjo është baza e bazave.
SQL
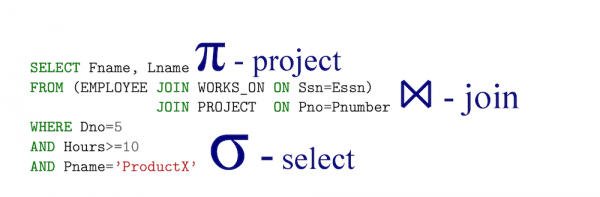
Marrë nga artikuj.
SQL është, në thelb, një implementim i algjebrës relacionale - me një rezervim të rëndësishëm, SQL është deklarativ! Kështu që duke shkruar një kërkesë në gjuhën e algjebrës relacionale, në thelb po thoni se si duhet të llogaritet - ndërsa me SQL vendosni se çfarë dëshiron të nxirrni, dhe më pas DBMS tashmë gjeneron (efektiv) shprehje në gjuhën e algjebrës relacionale (ekvivalentësia e saj e njohur për ne nën ).
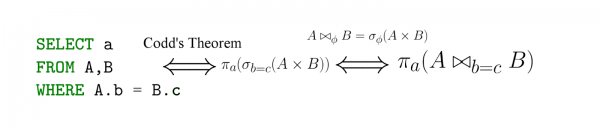
Marrë nga artikuj.
Përse?
DBMS-të relacionale: Oracle, Postgres, SQL Server, etj - ende janë faktikisht kudo dhe ka një shans të madhe që do të duhet të bashkëpunoni me to, dhe kjo do të thotë se do të duhet të lexoni SQL (gjithashtu shumë të mundshme) ose të shkruani në të (po ashtu jo shumë e pamundur).
Çfarë të lexoni dhe studioni
Në të njëjtat lidhje më lart (për algjebrën relacionale), ka një numër të jashtëzakonshëm materialesh, për shembull, .
Për raste, çfarë është NoSQL?
"Duhet të theksohet përsëri se termi 'NoSQL' ka një origjinë krejt të rastësishme dhe nuk ka një përkufizim të pranuar universal ose një institucion shkencor pas tij." Përkatësisht në Habr.
Në thelb, njerëzit kuptuan se modeli i plotë relacionale nuk është i nevojshëm për zgjidhjen e shumë problemeve, veçanërisht për ato ku, për shembull, performanca është thelbësore dhe dominosin disa kërkesa të thjeshta me agregim - është kritike të llogariten shpejt metrikat dhe t'i shkruani ato në bazën e të dhënave, dhe shumica e karakteristikave relacionale rezultuan të mos ishin vetëm të panevojshme, por edhe të dëmshme - përse të normalizohet diçka nëse ajo do të dëmtonte më të rëndësishmen për ne (për një detyrë të caktuar) - performancën?
Po shpesh nevojiten skema fleksibël në vend të skemave matematikore fikse të modelit klasik të relacionit — dhe kjo e thjeshton jashtëzakonisht zhvillimin e aplikacioneve, kur është thelbësore të implementohet sistemi dhe të fillohet puna shpejt, duke përpunuar rezultatet — ose skema dhe llojet e të dhënave të ruajtura nuk janë aq të rëndësishme.
Për shembull, ne krijojmë një sistem ekspert dhe duam të ruajmë informacionin për një domen të caktuar së bashku me disa metainformata — ne mund edhe të mos dimë të gjitha fushat dhe thjesht të ruajmë JSON për çdo regjistrim — kjo na jep një mjedis shumë fleksibël për të zgjeruar modelin e të dhënave dhe për iteracione të shpejta — prandaj, në këtë rast NoSQL do të ishte madje preferueshëm dhe më i lexueshëm. Një shembull regjistrimi (nga një projekti im, ku NoSQL ishte pikërisht atje ku nevojitej).
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Джонни Кэш","ru"],
"en_wiki_pagecount":2338861}
Mund të lexoni më shumë për NoSQL.
Çfarë të studiojmë?
Këtu më tepër duhet të analizoni mirë detyrën tuaj, cilat janë tiparet e saj dhe se cilat janë sistemet NoSQL që i përshtaten kësaj përshkrimi — dhe tashmë të angazhoheni në studimin e këtij sistemi.
Gjuha të skriptimit të kërkesave
Fillimisht, duket se çfarë ka të bëjë Python — ky është një gjuhë programimi, dhe aspak për kërkesa.
- Pandas është një thikë shumëfunksionale në Data Science, shumë transformime të të dhënave, agregime etj. ndodhin në të.
- Numpy — përllogaritje vektorësh, matrica dhe algjebër linjare atje.
- Scipy — shumë matematikë në këtë paketë, veçanërisht statistika.
- Jupyter lab — shumë analiza eksploruese të të dhënave i përshtaten mirë në notebook — e dobishme të dish.
- Requests — puna me rrjetin.
- Pyspark — shumë popullor mes inxhinierëve të të dhënave, për shumë të sigurt do t'ju duhet të ndërveproni me këtë ose me Spark, thjesht për shkak të popullaritetit të tyre.
- *Selenium — shumë e dobishme për mbledhjen e të dhënave nga faqat dhe resurse, ndonjëherë thjesht nuk mund të merrni të dhëna ndryshe.
Këshilli im kryesor: mësoni Python!
Pandas
Le të marrim si shembull kodin e mëposhtëm:
import pandas as pd
df = pd.read_csv("data/dataset.csv")
# Llogarit dhe riemërton agregimet
all_together = (df[df['trip_type'] == "return"]
    .groupby(['start_station_name','end_station_name'])
                    .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
                           .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': min_duration_seconds,
           'amax': 'max_duration_seconds'}))
The essence is that the code fits into the classic SQL pattern.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, …..
FROM dataset
WHERE trip_type = ‘return’
GROUP BY start_station_name, end_station_name
But the important part is that this code is part of a script and a pipeline; essentially, we are embedding queries into a Python pipeline. In this situation, the query language comes to us from libraries like Pandas or pySpark.
Overall, in pySpark we see a similar type of data transformation through the query language in the spirit of:
df.filter(df.trip_type = “return”)
  .groupby(“day”)
  .agg({duration: 'mean'})
  .sort()
Where and what to read
About Python in general to find materials for study. There are a huge number of tutorials on , and courses on (as well as on Python itself ). In general, materials are excellently searchable here and if I had to choose one package to focus on, it would definitely be pandas. There are also .
Shell as a query language
Many projects for data processing and analysis I’ve worked on are essentially shell scripts that call code in Python, Java, and the shell commands themselves. Therefore, overall, pipelines in bash/zsh/etc., can be considered as a kind of high-level query (you can, of course, stuff loops into it, but that’s atypical for DS code in shell languages). Here's a simple example — I needed to create a mapping of QID in Wikidata and the full links to the Russian and English Wikipedia, for that I wrote a simple command request in bash and then wrote a simple script in Python for output, which I assembled together like this:
pv “data/latest-all.json.gz” |
unpigz -c  |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py "output.csv"
ku
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2]=="enwiki" or .[0][2] =="ruwiki") and .[0][3] =="title") or .[0][1] == "id")' This was essentially the whole pipeline that created the necessary mapping; as we can see, everything worked in stream mode:
- pv filepath — provides a progress bar based on file size and forwards its contents
- unpigz -c read part of the archive and passed it to jq
- jq with the stream key immediately issued the result and passed it to the post-processor (just like the very first example) in Python
- inside the post-processor — it's a simple state machine that formatted the output
Në përmbledhje, një pipeline i komplikuar që operon në modalitetin e rrjedhës për të dhëna të mëdha (0.5TB), pa burime të konsiderueshme dhe i ndërtuar nga një pipeline të thjeshtë dhe disa mjete.
Një këshillë tjetër e rëndësishme: mësoni të punoni mirë dhe me efikasitet në terminal dhe të shkruani në bash/zsh/etc.
Ku do të përdoret? Po në çdo vend — materialet për të studiuar sërish janë shumë të shumta në rrjet. Në veçanti, ja artikulli im i mëparshëm.
Programimi në R
Përsëri, lexuesi mund të thotë — mirë, kjo është një gjuhë e plotë programimi! Dhe sigurisht, do të ketë të drejtë. Megjithatë, zakonisht kam hasur në R gjithmonë në një kontekst të tillë, saqë në thelb, ka qenë shumë e ngjashme me një gjuhë kërkesash.
R është një mjedis për llogaritje statistike dhe një gjuhë për llogaritje dhe vizualizim statistikash (sipas ).
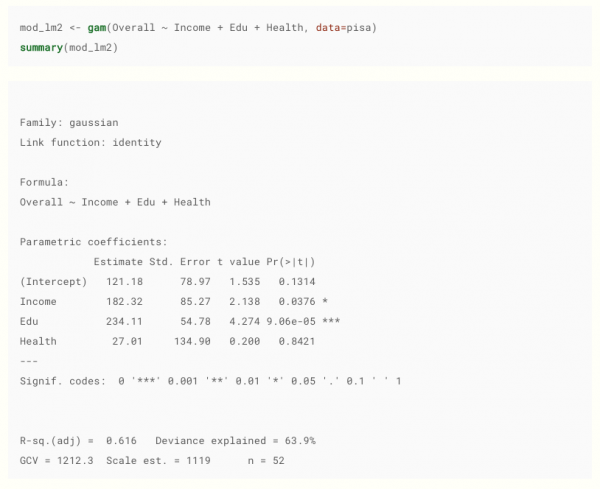
Marrë nga . Duke e përmendur, rekomandoj, një material i mirë.
Pse duhet ta dijë R një data scientist? Së paku, sepse ka një numër të madh njerëzish jashtë IT-së që merrem me analizën e të dhënave në R. Kam hasur në të në vendet e mëposhtme:
- Sektori farmaceutik.
- Biologët.
- Sektori financiar.
- Njerëzit me arsim të pastër matematikor, që merrem me statistika.
- Modelet statistikore të specializuara dhe modelet e mësimit të automatik (të cilat shpesh mund të gjenden vetëm në versionin autorit si paketë R).
Pse në thelb është kjo një gjuhë kërkesash? Në formën në të cilën shpesh takohet — kjo në thelb është një kërkesë për krijimin e një modeli, duke përfshirë leximin e të dhënave dhe përcaktimin e parametrave të kërkesës (modelit), si dhe vizualizimin e të dhënave në paketa si ggplot2 — kjo është gjithashtu një formë e shkruajtjes së kërkesave.
Shembuj kërkesash për vizualizimin
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
Në përgjithësi, shumë ide nga R janë integruar në paketa python, si pandas, numpy ose scipy, si dataframes dhe vektorizimi i të dhënave — prandaj, në përgjithësi, shumë gjëra në R do t'ju duken familjare dhe praktike.
Ka shumë burime për të studiuar, për shembull, .
Grafet e njohurive (Knowledge graph)
Këtu kam një përvojë paksa të pazakontë, sepse shpesh më duhet të punoj me grafet e njohurive dhe gjuhët e kërkesave për grafet. Prandaj, do të kalojmë shkurtimisht mbi bazat, kështu që ky seksion është pak më ekzotik.
Në bazat e të dhënave relacionalë klasikë ne kemi një skemë të fiksuar — këtu skema është fleksibile, çdo predikat është në thelb një "kolonë" dhe madje edhe më shumë.
Imagjinoni se do të modelonit një njeri dhe do të dëshironit të përshkruanit gjërat kyçe, për shembull, të marrim si bazë këtë përshkrim të Douglas Adams.
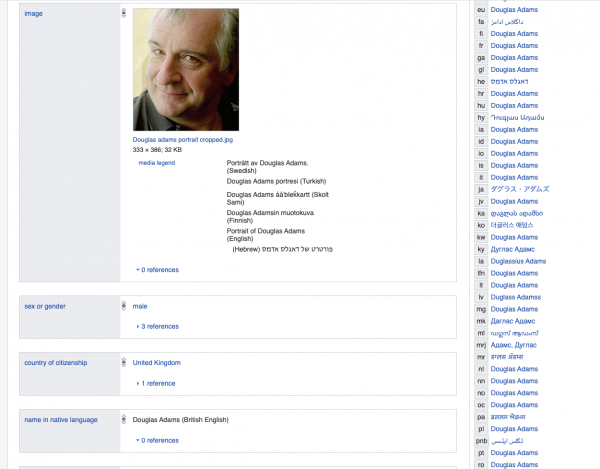
Nëse do të përdornim një bazë të dhënash relacionale, do të na duhej të krijonim një tabelë të madhe ose tabela me shumë kolona, shumica e të cilave do të ishin NULL ose të mbushura me një vlerë të defoltë False, për shembull, me siguri pak prej nesh kanë një regjistrim në bibliotekën kombëtare koreane — sigurisht, mund të ishim ndarë ato në tabela të veçanta, por në fund të fundit do të ishte një përpjekje për të modeluar një skemë logjike fleksibile me predikate duke përdorur një rregull relacionale.
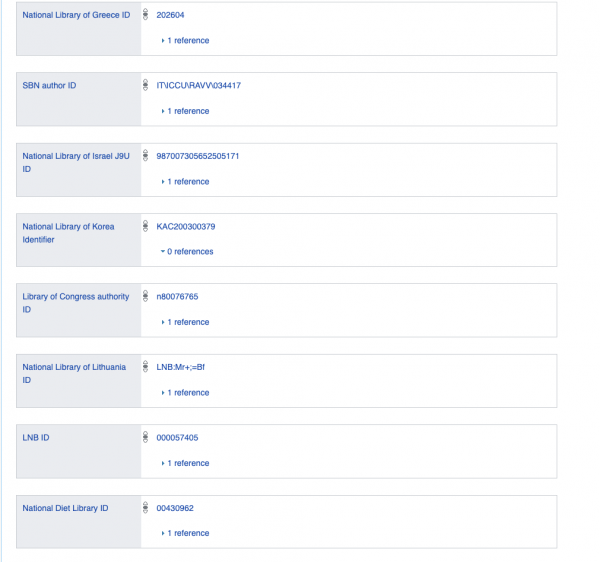
Prandaj, imagjinoni se të gjitha të dhënat ruhen në formën e një grafe ose në formën e shprehjeve logjike binare dhe unare.
Ku mund të përballeni me këtë? Së pari, duke punuar me , madje edhe me çdo bazë të dhënash grafike ose të dhëna të lidhura.
Pasojnë gjuhët kryesore të kërkimeve që më kanë ndodhur të aplikoj dhe me të cilat kam punuar.
SPARQL
Wiki:
SPARQL ( nga SPARQL Protocol and RDF Query Language) — , të paraqitura sipas modelit , si dhe për transferimin e këtyre kërkesave dhe përgjigjeve të tyre. SPARQL është një rekomandim dhe një nga teknologjitë .
Në të vërtetë, kjo është një gjuhë e kërkimeve për predikate logjike unare dhe binare. Thjesht përcaktohet se çka është fikse në shprehjen logjike dhe çka jo (shumë thjesht).
Baza vetë RDF (Resource Description Framework), mbi të cilën ekzekutohen kërkesat SPARQL — është një tripletë object, predicate, subject — dhe kërkesa përzgjedh tripletën e nevojshme sipas kufizimeve të caktuara në frymën: gjej një X, të tillë që p_55(X, q_33) është e vërtetë — ku, sigurisht, p_55 është një marrëdhënie me ID 55, ndërsa q_33 është objekti me ID 33 (kjo është e gjithë historia, duke lënë mënjanë detajet e ndryshme).
Shembujt e prezantimit të të dhënave:
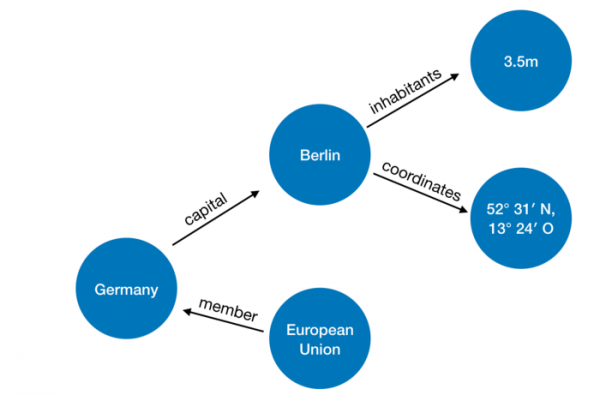
Imazhe dhe shembuj me vende këtu .
Shembulli i kërkesës bazë
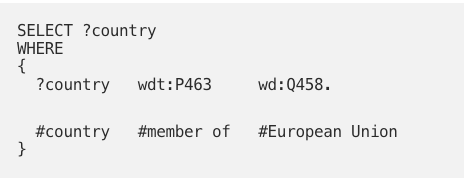
Në thelb, duam të gjejmë vlerën e variablit ?country, të tillë që për predikatin
member_of, është e vërtetë që member_of(?country,q458), ndërsa q458 është ID e Bashkimit Evropian.
Shembulli i një kërkese reale SPARQL brenda motorit python:
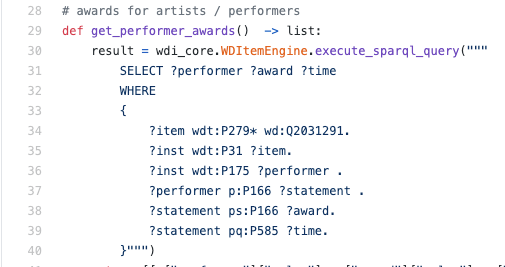
Në përgjithësi, më është dashur të lexoj SPARQL, dhe jo ta shkruaj - në një situatë të tillë, shpeshherë do të jetë një aftësi e dobishme të kuptosh gjuhën edhe në një nivel bazik, për të kuptuar se si pikërisht nxirren të dhënat.
Ka shumë materiale online për të mësuar: për shembull, ja dhe . Unë zakonisht kërkoj në Google konstruktime specifike dhe shembuj dhe deri tani është mjaft.
Gjuhët logjike të kërkimeve
Mund të lexoni më shumë mbi temën në artikullin tim . Këtu, ne do të shpjegojmë shkurtimisht pse gjuhët logjike janë të mira për të shkruar kërkesa. Në thelb, RDF është thjesht një grup i tipave të pohimeve logjike të formës p(X) dhe h(X,Y), dhe kërkesa logjike ka këtë formë:
output(X) :- country(X), member_of(X,"EU").
Këtu ne flasim për krijimin e një predikati të ri output/1 ( /1 - do të thotë unar), me kusht që për X të jetë e vërtetë se country(X) - që do të thotë, X është një shtet dhe gjithashtu member_of(X,"EU").
Pra, ne kemi si të dhënat ashtu edhe rregullat në këtë rast të paraqitura njëlloj, që lejon modelimin e detyrave shumë lehtë dhe mirë.
Këtu janë hasur në industri: një projekt tërësor me një kompani që shkruan kërkesa në këtë gjuhë, si dhe në projektin aktual në bazën e sistemit - duket si një gjë mjaft ekzotike, megjithatë ndonjëherë ndodh.
Shembulli i një fragmenti kodi në një gjuhë logjike që përpunon wikidata:
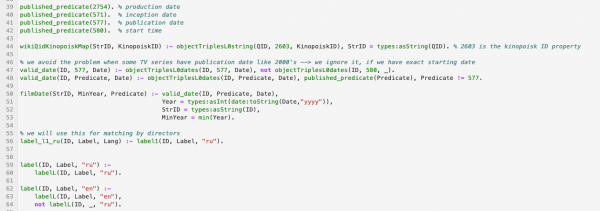
Materialet: do të sjell këtu disa lidhje në një gjuhë programimi logjike moderne, Answer Set Programming - rekomandoj të studiohet pikërisht ai:
Burimi: habr.com
