

Të dashur lexues, ditë të mirë. Sot do të flasim pak për Apache Spark dhe perspektivat e tij të zhvillimit.
Në botën moderne të Big Data, Apache Spark është standardi de facto për zhvillimin e zgjidhjeve të përpunimit në grup. Përveç kësaj, ai përdoret gjithashtu për të krijuar aplikacione për transmetim në konceptin e mikro-grumbullit, duke përpunuar dhe dërguar të dhëna në sasi të vogla (Spark Structured Streaming). Tradicionalisht, ai ka qenë pjesë e stakut të përgjithshëm Hadoop, duke përdorur YARN si menaxher të burimeve (ose, në disa raste, Apache Mesos). Deri në vitin 2020, përdorimi i tij në formën tradicionale për shumicën e kompanive ishte nën pyetje të madhe për shkak të mungesës së distribucioneve të mira Hadoop - zhvillimi i HDP dhe CDH është ndalur, CDH është mjaft i papërfunduar dhe ka një kosto të lartë, ndërsa ofruesit e tjerë të Hadoop ose kanë ndaluar së ekzistuari ose kanë një të ardhme të paqartë. Prandaj, interesi në rritje i komunitetit dhe kompanive të mëdha po tërhiqet nga запуск Apache Spark nëpërmjet Kubernetes - duke u bërë standard në orkestrimin e kontenierëve dhe menaxhimin e burimeve në re private dhe publike, ai zgjidh problemin me planifikimin e vështirë të burimeve të detyrave të Spark në YARN dhe ofron një platformë që po zhvillohet qëndruar, me shumë distribucione komerciale dhe të hapura për kompani të të gjitha madhësive dhe llojeve. Për më tepër, në valën e popullaritetit, shumica e tyre tashmë kanë arritur të krijojnë disa instalime dhe të rrisin ekspertizën në përdorimin e tij, duke e bërë migrimin më të lehtë.
Duke filluar nga versioni 2.3.0, Apache Spark ka fituar mbështetje zyrtare për running tasks në klusterin Kubernetes dhe sot do të flasim për pjekurinë aktuale të këtij qasjeje, variacionet e ndryshme të përdorimit të saj dhe pengesat me të cilat do të përballeni gjatë implementimit.
Së pari, le të shqyrtojmë procesin e zhvillimit të detyrave dhe aplikacioneve bazuar në Apache Spark dhe të identifikojmë raste tipike në të cilat është e nevojshme të ekzekutoni një detyrë në klasterin Kubernetes. Përgatitja e këtij postimi përdor OpenShift si distribuicion dhe do të paraqiten komandat relevante për utilitarin e tij të linjës së komandës (oc). Për distribuionet e tjera të Kubernetes, mund të përdoren komandat përkatëse të utilitarit standard të linjës së komandës Kubernetes (kubectl) ose homologët e tyre (për shembull, për oc adm policy).
Përdorimi i parë është spark-submit
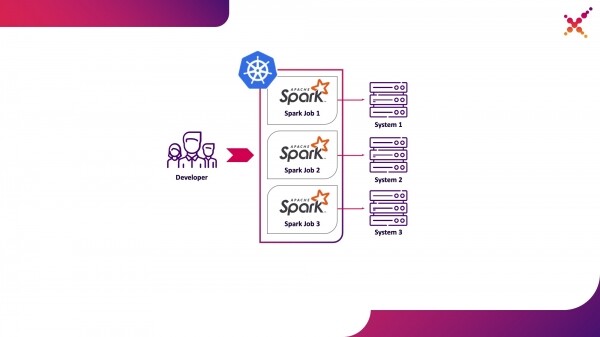
Gjatë zhvillimit të detyrave dhe aplikacioneve, zhvilluesi ka nevojë të ekzekutojë detyrat për të debug-uar transformimin e të dhënave. Teoretikisht, për këto qëllime mund të përdoren 'stubs', por zhvillimi me pjesëmarrje të instanceve reale (edhe nëse teste) të sistemeve përfundimtare, ka treguar se është më i shpejtë dhe më cilësor në këtë klasë problemashe. Në rastin kur kryejmë debugging në instance reale të sistemeve përfundimtare, mund të kemi dy skenarë të punës:
- zhvilluesi ekzekuton detyrën Spark lokal në modalitetin standalone;

- zhvilluesi ekzekuton detyrën Spark në një klasër Kubernetes në kontur testimi.
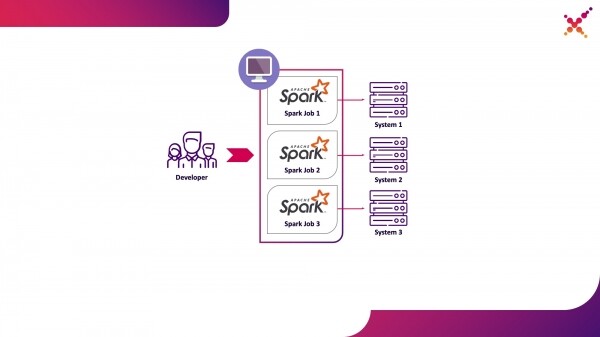
Varianti i parë ka të drejtë ekzistimi, por sjell një sërë disavantazhesh:
- çdo zhvillues ka nevojë të sigurojë akses nga vendi i punës deri te të gjitha instance të nevojshme të sistemeve përfundimtare;
- në makinën e punës nevojiten resurse të mjaftueshme për të ekzekutuar detyrën që po zhvillohet.
Varianti i dytë është pa këto disavantazhe, pasi përdorimi i klasër Kubernetes lejon alokimin e pool-it të nevojshëm të burimeve për ekzekutimin e detyrave dhe siguron qasje të nevojshme te instance të sistemeve përfundimtare, duke ofruar qasje fleksibël përmes modelit të rolit Kubernetes për të gjithë anëtarët e ekipit të zhvillimit. Ta tregojmë atë si variantin e parë të përdorimit — ekzekutimi i detyrave Spark nga makina lokale e zhvilluesit në klasën Kubernetes në konturin testues.
Le të flasim më shumë rreth procesit të konfigurimit të Spark për ekzekutimin lokal. Për të filluar përdorimin e Spark, është e nevojshme ta instaloni:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Kemi nevojë për të mbledhur paketat e nevojshme për punën me Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Ndërtesa e plotë merr shumë kohë, dhe për krijimin e imazheve Docker dhe ekzekutimin e tyre në klasën Kubernetes në realitet nevojiten vetëm skedarët jar nga direktoria 'assembly/', prandaj është e mundur të mbledhim vetëm këtë nënprojekt:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Për të ekzekutuar detyrat Spark në Kubernetes, është e nevojshme të krijoni një imazh Docker, i cili do të përdoret si bazë. Këtu mund të ketë 2 qasje:
- Imazhi Docker i krijuar përfshin kodin ekzekutues të detyrës Spark;
- Imazhi i krijuar përmban vetëm Spark dhe varësitë e nevojshme, kodi ekzekutiv vendoset në distancë (p.sh., në HDFS).
Fillimisht, le të krijojmë imazhin Docker, i cili përmban një shembull testimi të detyrës Spark. Për të krijuar imazhe Docker, Spark ka një utilitar përkatës të quajtur "docker-image-tool". Le të shohim ndihmën për këtë:
.\/bin\/docker-image-tool.sh --help
Me ndihmën e saj mund të krijoni imazhe Docker dhe t'i ngarkoni ato në regjistrat e largët, por për shkaqe të natyrshme ajo ka disa disavantazhe:
- detyrimisht krijon menjëherë 3 imazhe Docker — për Spark, PySpark dhe R;
- nuk lejon caktimin e emrit të imazhit.
Prandaj, ne do të përdorim një version të modifikuar të këtij utilitari, të dhënë më poshtë:
vi bin\/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Me ndihmën e saj, ne krijojmë imazhin bazë të Spark, i cili përmban një detyrë testuese për llogaritjen e numrit Pi me ndihmën e Spark (këtu {docker-registry-url} — URL e regjistrit tuaj të imazheve Docker, {repo} — emri i depozitës brenda regjistrit që përputhet me projektin në OpenShift, {image-name} — emri i imazhit (nëse përdoret ndarja me tri nivele të imazheve, p.sh., si në regjistrin e integruar të imazheve Red Hat OpenShift), {tag} — etiketa e kësaj versioni të imazhit):
.\/bin\/docker-image-tool-upd.sh -f resource-managers\/kubernetes\/docker\/src\/main\/dockerfiles\/spark\/Dockerfile -r {docker-registry-url}\/ {repo} -i {image-name} -t {tag} build
Autentikohemi në klasterin OKD me ndihmën e utilitarit të konsolës (këtu {OKD-API-URL} — URL e API-së së klasterit OKD):
oc login {OKD-API-URL}
Marrim tokenin e përdoruesit aktual për autentifikim në Docker Registry:
oc whoami -t
Autentikohemi në Docker Registry të brendshëm të klasterit OKD (si fjalëkalim përdorim tokenin e marrë me komandën e mëparshme):
docker login {docker-registry-url}
Ngarkojmë imazhin e ndërtuar Docker në Docker Registry OKD:
.\/bin\/docker-image-tool-upd.sh -r {docker-registry-url}\/ {repo} -i {image-name} -t {tag} push
Kontrollojmë që imazhi i ndërtuar është i disponueshëm në OKD. Për këtë, hapim në shfletues URL-në me listën e imazheve të projektit përkatës (këtu {project} — emri i projektit brenda klasterit OpenShift, {OKD-WEBUI-URL} — URL e konsolës Web të OpenShift) — https:\/{OKD-WEBUI-URL}\/console\/project\/ {project}\/browse\/images\/ {image-name}.
Për të filluar detyrat, duhet të krijohet një llogari shërbimi me privilegje për të nisur pod-et nën root (do ta diskutojmë më vonë):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Do të ekzekutojmë komandën spark-submit për të publikuar detyrën Spark në klasterin OKD, duke caktuar llogarinë e shërbimit të krijuar dhe imazhin Docker:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Këtu:
—name — emri i detyrës, e cila do të kontribuojë në formimin e emrit të pod-eve Kubernetes;
—klasë — klasa e skedarit ekzekutues që thirret gjatë fillimit të detyrës;
—konf — parametrat e konfigurimit të Spark;
spark.executor.instances — numri i ekzekutorëve të Spark që do të ekzekutohen;
spark.kubernetes.authenticate.driver.serviceAccountName — emri i llogarisë shërbyese Kubernetes që përdoret gjatë fillimit të pod-ëve (për të përcaktuar kontekstin e sigurisë dhe mundësitë gjatë ndërveprimit me API-në e Kubernetes);
spark.kubernetes.namespace — hapësira emërore e Kubernetes, në të cilën do të ekzekutohen pod-ët e drejtuesit dhe ekzekutorëve;
spark.submit.deployMode — mënyra e ekzekutimit të Spark (për spark-submit standard përdoret «cluster», për Spark Operator dhe versionet më të vonshme të Spark «client»);
spark.kubernetes.container.image — imazhi Docker që përdoret për të ekzekutuar pod-ët;
spark.master — URL-ja e API-së së Kubernetes (cila tregohet për përdorim nga makina lokale);
local:// — rruga për skedarin ekzekutues të Spark brenda imazhit Docker.
Shkoni te projekti përkatës OKD dhe shqyrtoni pod-ët e krijuar — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
Për të thjeshtuar procesin e zhvillimit mund të përdoret një variant tjetër, në të cilin krijohet një imazh themelor i përbashkët Spark që përdoret nga të gjitha detyrat gjatë ekzekutimit, ndërsa snapshot-et e skedarëve ekzekutues publikohen në një ruajtje të jashtme (për shembull, Hadoop) dhe caktohen gjatë thirrjes së spark-submit si lidhje. Në këtë rast mund të ekzekutoni versione të ndryshme të detyrave Spark pa rikonstruar imazhet Docker, duke përdorur për publikimin e imazheve, për shembull, WebHDFS. Dërgoni një kërkesë për krijimin e skedarit (këtu {host} — host-i i shërbimit WebHDFS, {port} — porta e shërbimit WebHDFS, {path-to-file-on-hdfs} — rruga e dëshiruar për skedarin në HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
Në këtë rast do të merrni një përgjigje të këtij lloji (këtu {location} — është URL-ja që duhet të përdoret për ngarkimin e skedarit):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Ngarkoni skedarin ekzekutues të Spark në HDFS (këtu {path-to-local-file} — rruga për skedarin ekzekutues të Spark në hostin aktual):
curl -i -X PUT -T {path-to-local-file} "{location}"
Pas kësaj mund të bëni spark-submit duke përdorur skedarin e Spark, i ngarkuar në HDFS (këtu {class-name} — emri i klasës që kërkohet të ekzekutohet për realizimin e detyrës):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Në këtë rast duhet të theksohet se për qasje në HDFS dhe për të siguruar funksionimin e detyrës, mund të jetë e nevojshme të ndryshoni Dockerfile-n dhe skriptin entrypoint.sh — të shtoni në Dockerfile direktivën për kopjimin e bibliotekave të varura në drejtorinë /opt/spark/jars dhe të përfshini skedarin e konfigurimit HDFS në SPARK_CLASSPATH në entrypoint.sh.
Varianti i dytë i përdorimit — Apache Livy
Më pas, kur detyra është zhvilluar dhe është e nevojshme të testoni rezultatin e marra, lind pyetja e ekzekutimit të saj brenda procesit CI/CD dhe ndjekjes së statusit të ekzekutimit të saj. Sigurisht, mund ta ekzekutoni atë edhe me thirrje lokale spark-submit, por kjo e komplikon infrastrukturën CI/CD pasi kërkon instalimin dhe konfigurimin e Spark në agjentët/rundbukret e serverit CI dhe përgatitjen e aksesit në API-në Kubernetes. Për këtë rast, aplikimi i dëshiruar është zgjedhja e përdorimit të Apache Livy si REST API për të ekzekutuar detyrat Spark, të vendosur brenda klasterit Kubernetes. Me ndihmën e tij mund të ekzekutoni detyrat Spark në klasterin Kubernetes duke përdorur thirrje të zakonshme cURL, që lehtë realizohet mbi ndonjë zgjidhje CI, dhe vendosja e tij brenda klasterit Kubernetes zgjidh çështjen e autentifikimit gjatë bashkëveprimit me API-në Kubernetes.
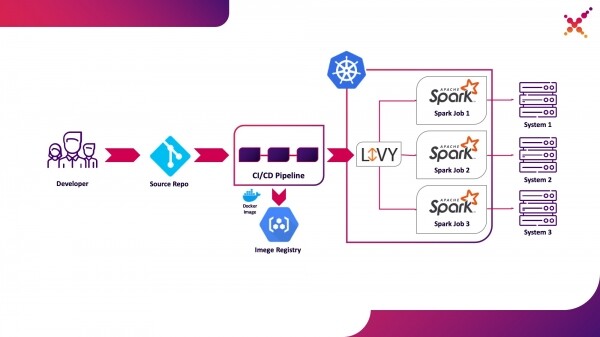
Të veçojmë atë si variantin e dytë të përdorimit — ekzekutimi i detyrave Spark brenda procesit CI/CD në klasterin Kubernetes në kontestin testues.
Pak fjalë mbi Apache Livy — ai funksionon si server HTTP, duke ofruar një ndërfaqe Web dhe RESTful API, që lejon të ekzekutoni spark-submit në distancë, duke kaluar parametrat e nevojshëm. Tradicionalisht ai ofrohej si pjesë e distribuimit HDP, por gjithashtu mund të implementohet në OKD ose ndonjë instalim tjetër Kubernetes me ndihmën e manifestit dhe setit të imazheve Docker përkatës, për shembull, ky — . Për rastin tonë, një imazh Docker i ngjashëm u ndërtua, që përfshin Spark versionin 2.4.5 nga Dockerfile i mëposhtëm:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
Imazhi i krijuar mund të bëhet i disponueshëm dhe të ngarkohet në regjistrin tuaj Docker, siç është regjistri i brendshëm OKD. Për ta vendosur përdoret manifesti si në vijim ({registry-url} — URL e regjistrit të imazheve Docker, {image-name} — emri i imazhit Docker, {tag} — etiketa e imazhit Docker, {livy-url} — URL e dëshiruar ku do të jetë në dispozicion serveri Livy; manifesti "Route" aplikohet në rast se ndërrimi i Kubernetes përdor Red Hat OpenShift, ndryshe aplikohet manifesti përkatës Ingress ose Servici i tipit NodePort):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Pas aplikimit të tij dhe nisjes me sukses të pod-it, ndërfaqja grafike e Livy është e aksesueshme përmes lidhjes: http://{livy-url}/ui. Me Livy, ne mund të publikojmë detyrën tonë Spark duke përdorur një kërkesë REST, për shembull, nga Postman. Një shembull koleksioni me kërkesa është paraqitur më poshtë (në array-in "args" mund të kalohen argumente konfigurimi me variablat që janë të nevojshme për funksionimin e detyrës që do të nisi):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Submit job with jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Submit job without jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Kryejmë kërkesën e parë nga koleksioni, kalojmë në ndërfaqen OKD dhe verifikojmë që detyra është nisur me sukses — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. Në këtë rast, në ndërfaqen Livy (http://{livy-url}/ui) do të shfaqet një sesion, brenda të cilit me ndihmën e API Livy ose ndërfaqes grafike mund të ndjekim avancimin e detyrës dhe të studiojmë log-et e sesionit.
Tani će tregojmë mekanizmin e funksionimit të Livy. Për këtë, do të shqyrtojmë regjistrat e kontejnerit Livy brenda pod-it me serverin Livy — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Prej tyre është e qartë se, kur thirret REST API Livy, në kontejnerin e emërtuar «livy» ekzekutohet spark-submit, i ngjashëm me atë që përdorëm më sipër (këtu {livy-pod-name} është emri i pod-it të krijuar me serverin Livy). Në koleksion është paraqitur gjithashtu një kërkesë e dytë, e cila lejon ekzekutimin e detyrave me vendosjen e skedave Spark në distancë përmes serverit Livy.
Varianti i tretë i përdorimit — Spark Operator
Tani që detyra është testuar, ngrihet pyetja e ekzekutimit të saj të rregullt. Mënyra natyrore për ekzekutimin e rregullt të detyrave në klasterin Kubernetes është entiteti CronJob dhe mund ta përdorim atë, por në këtë moment, po fiton popullaritet përdorimi i operatorëve për menaxhimin e aplikacioneve në Kubernetes dhe për Spark ekziston një operator mjaft i pjekur, i cili përdoret gjithashtu në zgjidhjet e nivelit Enterprise (p.sh., Lightbend FastData Platform). Ne rekomandojmë ta përdorni atë — versioni aktual stabil i Spark (2.4.5) ka mundësi mjaft të kufizuara për konfigurimin e ekzekutimit të detyrave Spark në Kubernetes, përveç që në versionin e ardhshëm kryesor (3.0.0) është shpallur mbështetje e plotë për Kubernetes, por data e daljes së saj mbetet e panjohur. Spark Operator kompenson këtë dobësi, duke shtuar parametra të rëndësishëm konfigurimi (p.sh., montimin e ConfigMap me konfigurimin e aksesit në Hadoop në pod-et Spark) dhe mundësinë e ekzekutimit të detyrave sipas një orari.
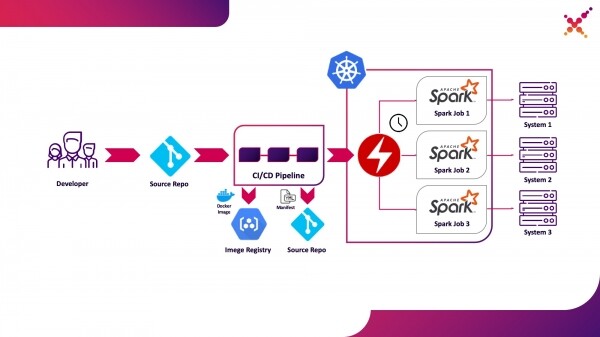
Ta nxjerrim atë si një variant të tretë përdorimi — ekzekutimi i rregullt i detyrave Spark në klasterin Kubernetes në një mjedis prodhimi.
Spark Operator ka kod të hapur dhe zhvillohet brenda Google Cloud Platform — . Instalimi i tij mund të kryhet në 3 mënyra:
- Si pjesë e instalimit të Lightbend FastData Platform/Cloudflow;
- Me ndihmën e Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Duke përdorimi i manifestëve nga depoja zyrtare (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Duhet të theksohet se Cloudflow përfshin operatorin me versionin e API-t v1beta1. Nëse ky tip instalimi përdoret, përshkrimet e manifestëve të aplikacioneve Spark duhet të ndërtohen mbi bazën e shembujve nga etiketat në Git me versionin përkatës të API-t, për shembull, "v1beta1-0.9.0-2.4.0". Versioni i operatorit mund të përftohet në përshkrimin e CRD-së që përfshihet në operator në fjalorin "versions":
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Nëse operatori është instaluar saktë, në projektin përkatës do të shfaqet një pod aktiv me operatorin Spark (për shembull, cloudflow-fdp-sparkoperator në hapësirën Cloudflow për instalimin e Cloudflow) dhe do të shfaqet lloji përkatës i burimeve Kubernetes me emrin "sparkapplications". Aplikacionet e disponueshme Spark mund të studiohen me komandën e mëposhtme:
oc get sparkapplications -n {project}
Për të ekzekutuar detyra duke përdorur Spark Operator, duhet të bëhen 3 gjëra:
- të krijoni një imazh Docker që përfshin të gjitha bibliotekat e nevojshme, si dhe skedarët konfigurues dhe ekzekutivë. Në pamjen e përfundimtare, ky është imazhi i krijuar gjatë etapës CI/CD dhe i testuar në klasterin e testimit;
- të publikoni imazhin Docker në një regjistër që është i disponueshëm nga klasteri Kubernetes;
- të formoni një manifest me llojin "SparkApplication" dhe përshkrimin e detyrës që do të ekzekutohet. Shembujt e manifestëve janë të disponueshëm në depozitat zyrtare (për shembull, ). Duhet të theksohen disa pika të rëndësishme në lidhje me manifestin:
- në fjalorin "apiVersion" duhet të përmendet versioni i API-t përkatës me versionin e operatorit;
- në fjalorin "metadata.namespace" duhet të shënohet hapësira emërore ku do të ekzekutohet aplikacioni;
- në fjalorin "spec.image" duhet të jepet adresa e imazhit të krijuar Docker në regjistrin e disponueshëm;
- në fjalorin "spec.mainClass" duhet të jepet klasa e detyrës Spark që kërkohet të ekzekutohet gjatë fillimit të procesit;
- në fjalorin "spec.mainApplicationFile" duhet të jepet rruga drejt skedarit ekzekutiv jar;
- në fjalorin "spec.sparkVersion" duhet të shënohet versioni i Spark-it që përdoret;
- në fjalorin "spec.driver.serviceAccount" duhet të jepet llogaria e shërbimit brenda hapësirës emërore përkatëse të Kubernetes-it, që do të përdoret për të ekzekutuar aplikacionin;
- në fjalorin "spec.executor" duhet të jepen burimet e dedikuara aplikacionit;
- Në fjalorin «spec.volumeMounts» duhet të specifikohet një direktori lokale, në të cilën do të krijohen skedarët lokalë të detyrës Spark.
Shembulli i formimit të manifestit (këtu {spark-service-account} është llogaria e shërbimit brenda klasterit Kubernetes për të ekzekutuar detyrat Spark):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "tmp"
Në këtë manifest është e specifikuar llogaria e shërbimit, për të cilën kërkohet që para publikimit të manifestit të krijohen lidhet e nevojshme të rolit, që ofrojnë të drejtat e nevojshme për ndërveprimin e aplikacionit Spark me API-në Kubernetes (nëse është e nevojshme). Në rastin tonë, aplikacionit i duhen të drejtat për të krijuar Pod’ë. Le të krijojmë lidhjen e nevojshme të rolit:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Gjithashtu, vlen të theksohet se në specifikimin e këtij manifesti mund të jetë specifikuar parametri «hadoopConfigMap», i cili lejon të specifikohet ConfigMap me konfigurimin Hadoop pa pasur nevojë për ta vendosur paraprakisht skedarin përkatës në imazhin Docker. Ai gjithashtu është i përshtatshëm për ekzekutimin e rregullt të detyrave — me anë të parametrin «schedule» mund të specifikohet një orar për ekzekutimin e kësaj detyre.
Pas kësaj, e ruajmë manifestin tonë në skedarin spark-pi.yaml dhe e aplikojmë atë në klasterin tonë Kubernetes:
oc apply -f spark-pi.yaml
Në këtë rast, do të krijohet një objekt i tipit «sparkapplications»:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Në këtë rast, do të krijohet një pod me aplikacionin, statusi i të cilit do të shfaqet në «sparkapplications» të krijuar. Mund të shihet me komandën e mëposhtme:
oc get sparkapplications spark-pi -o yaml -n {project}
Pasi të përfundojë detyra, POD-i do të kalojë në statusin «Completed», i cili gjithashtu do të përditësohet në «sparkapplications». Log-et e aplikacionit mund të shihen në shfletues ose me komandën e mëposhtme (këtu {sparkapplications-pod-name} është emri i podit të detyrës së ekzekutuar):
oc logs {sparkapplications-pod-name} -n {project}
Menaxhimi i detyrave të Spark mund të kryhet edhe përmes një utilitari të specializuar, sparkctl. Për ta instaluar, klonojmë depozitat me kodin e tij burimor, instalojmë Go dhe e ndërtomë këtë utilitar:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Le të shqyrtojmë listën e detyrave të ekzekutuara të Spark:
sparkctl list -n {project}
Le të krijojmë një përshkrim për detyrën e Spark:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Le të ekzekutojmë detyrën e përshkruar përmes sparkctl:
sparkctl create spark-app.yaml -n {project}
Le të shqyrtojmë listën e detyrave të ekzekutuara të Spark:
sparkctl list -n {project}
Le të shqyrtojmë listën e ngjarjeve të detyrës së ekzekutuar të Spark:
sparkctl event spark-pi -n {project} -f
Le të shqyrtojmë statusin e detyrës së ekzekutuar të Spark:
sparkctl status spark-pi -n {project}
Më në fund, dëshiroj të shqyrtoj faktorët negativë të përdorimit të versionit aktual të stabilizuar të Spark (2.4.5) në Kubernetes:
- Minusi i parë, dhe ndoshta kryesor, është mungesa e Loksalitetit të Dhënave. Pavarësisht nga të gjitha disavantazhet, YARN kishte dhe avantazhe në përdorimin e tij, për shembull, principi i dërgimit të kodit tek të dhënat (e jo të dhënat tek kodi). Falë këtij principi, detyrat Spark kryheshin në nyjat ku ndodheshin të dhënat që merrnin pjesë në llogaritje, duke e reduktuar ndjeshëm kohën e dërgimit të të dhënave përmes rrjetit. Kur përdorim Kubernetes, përballëjme me nevojën për të lëvizur të dhënat nëpër rrjet që janë të angazhuara në punën e detyrës. Nëse ato janë mjaft të mëdha, koha e ekzekutimit të detyrës mund të rritet ndjeshëm, si dhe do të kërkohet një hapësirë e konsiderueshme disku e caktuar për instancat e detyrës Spark për ruajtjen e përkohshme. Ky disavantazh mund të reduktohet duke përdorur mjete softuerike të specializuara që sigurojnë loksalitetin e të dhënave në Kubernetes (për shembull, Alluxio), por kjo në thelb do të thotë se është e nevojshme të ruhet njëkopje e plotë e të dhënave në nyjat e klustrit Kubernetes.
- Disavantazhi i dytë i rëndësishëm është siguria. Nga e drejta, funksionet që kanë të bëjnë me sigurimin e sigurisë lidhur me ekzekutimin e detyrave Spark janë të çactivizuara, dhe opsioni i përdorimit të Kerberos në dokumentacionin zyrtar nuk është mbuluar (ndonëse parametrat përkatës u shfaqën në versionin 3.0.0, që do të kërkojë punë shtesë), dhe në dokumentacionin për sigurimin e sigurisë gjatë përdorimit të Spark (https://spark.apache.org/docs/2.4.5/security.html) si depozitues çelësash përmenden vetëm YARN, Mesos dhe Klienti Standalone. Gjithashtu, përdoruesi, nën të cilin ekzekutohen detyrat Spark, nuk mund të përcaktohet drejtpërdrejt — ne vetëm caktuam një llogari shërbimi, nën të cilën do të punojë pod-i, ndërsa përdoruesi zgjidhet sipas politikave të vendosura për sigurinë. Në këtë mënyrë, ose përdoret përdoruesi root, që nuk është i sigurt në një mjedis prodhimi, ose një përdorues me UID rastësor, që është i paqartë kur vjen puna për shpërndarjen e të drejtave të aksesit në të dhëna (që zgjidhet përmes krijimit të PodSecurityPolicies dhe lidhjes së tyre me llogaritë përkatëse shërbyese). Aktualisht, kjo zgjidhet ose duke vendosur të gjitha skedarët e nevojshëm drejtpërdrejt në imazhin Docker, ose duke modifikuar skriptin e ekzekutimit të Spark për të përdorur mekanizmin e ruajtjes dhe marrjes së sekretëve, të pranuar në organizatën tuaj.
- Nisja e detyrave Spark me Kubernetes është ende në një gjendje eksperimentale dhe në të ardhmen ka shumë mundësi që të ndodhin ndryshime të rëndësishme në artefaktet e përdorura (skedarët e konfigurimit, imazhet bazë të Docker-it dhe skenarët e nisjes). Në të vërtetë — gjatë përgatitjes së materialit u testuan versionet 2.3.0 dhe 2.4.5, dhe sjellja ishte ndjeshëm e ndryshme.
Do të presim azhurnimet — pak kohë më parë doli versioni i ri i Spark (3.0.0), i cili solli ndryshime të dukshme në funksionimin e Spark në Kubernetes, por mbajti statusin eksperimental të mbështetjes për këtë menaxher burimesh. Ndoshta, azhurnimet e ardhshme do të lejojnë me të vërtetë të rekomandohet braktisja e YARN dhe të nisen detyrat Spark në Kubernetes, pa u shqetësuar për sigurinë e sistemit tuaj dhe pa pasur nevojë për përmirësimin e komponentëve funksionalë nga ana juaj.
Fin.
Burimi: habr.com
