

Përshëndetje, Habr! Po ju prezantoj një përkthim të artikullit
.
Kur vjen puna te bazat e të dhënave relacionale, nuk mund të mos mendoj se diçka mungon. Ato përdoren kudo. Ekzistojnë shumë lloje të ndryshme të bazave të dhënash: nga SQLite e vogël dhe e dobishme deri te Teradata e fuqishme. Por ka vetëm disa artikuj që shpjegojnë se si funksionon një bazë e dhënash. Mund të kërkoni vetë me kërkesën "howdoesarelationaldatabasework" ("si funksionojnë bazat e të dhënave relacionale") për të parë se sa pak rezultate ka. Më tepër, këta artikuj janë të shkurtër. Nëse kërkoni teknologjitë e fundit moderne (BigData, NoSQL ose JavaScript), do të gjeni më shumë artikuj të thelluar që shpjegojnë se si funksionojnë ato.
A janë bazat e të dhënave relacionale shumë të vjetra dhe shumë të mërzitshme për t'i shpjeguar jashtë kurseve universitare, punimeve hulumtuese dhe librave?
Si zhvillues, unë e urrej të përdor atë që nuk e kuptoj. Dhe nëse bazat e të dhënave janë përdorur për më shumë se 40 vjet, duhet të ketë një arsye. Gjatë këtyre viteve, kam shpenzuar qindra orë për të kuptuar vërtet këto kutitë e zeza të çuditshme që përdor çdo ditë. Bazat e të dhënave relacionale janë shumë interesante, sepse ato janë të bazuara në koncepte të dobishme dhe të përdorura më shumë se një herë. Nëse jeni të interesuar për të kuptuar një bazë të dhënash, por keni pasur ndonjëherë kohë ose dëshirë për të studiuar këtë temë të gjerë, këtë artikull duhet ta pëlqeni.
Megjithëse titulli i këtij artikulli është e qartë, qëllimi i këtij artikulli nuk është të kuptohet se si përdoret një bazë e dhënash.Prandaj, ju tashmë duhet të dini si të shkruani një pyetje të thjeshtë lidhje dhe pyetjet themelore CRUD; ndryshe mund të mos e kuptoni këtë artikull. Kjo është e vetmja gjë që duhet të dini, do ta shpjegoj gjithçka tjetër.
Do të filloj me disa bazë të shkencave kompjuterike, siç është kompleksiteti temporal i algoritmeve (BigO). E di që disa prej jush e urrejnë këtë koncept, por pa të nuk do të mund të kuptoni nuancat brenda një baze të dhënash. Duke qënë se kjo është një temë e madhe, unë do të përqendrohem në atë që e konsideroj të rëndësishme: si një bazë e dhënash përpunon SQL kërkesën. Do të prezantoj vetëm konceptet themelore të bazës së të dhënave, në mënyrë që në fund të artikullit të keni një ide se çfarë ndodh nën kapak.
Duke qenë se ky është një artikull i gjatë dhe teknik, që përfshin shumë algoritmo dhe struktura të dhënash, mos u nxehni për ta lexuar atë. Disa koncepte mund të jenë të vështira për t'u kuptuar; ju mund të kaloni përmbajtjen dhe përsëri të merrni një ide të përgjithshme.
Për ata që janë më të informuar, ky artikull është i ndarë në 3 pjesë:
- Përmbledhje e komponentëve të bazës së të dhënave me nivel të ulët dhe të lartë
- Përmbledhje e procesit të optimizimit të pyetjeve
- Përmbledhje e menaxhimit të transaksioneve dhe rezervuarëve
Kthehemi te baza
Shumë vite më parë (në një galaksi të largët…), zhvilluesit duheshin të dinin saktësisht numrin e operacioneve që po kodonin. Ata e dinin përmendësh algoritmin dhe strukturat e të dhënave të tyre, sepse nuk mund të lejonin veten që të shpenzonin CPU dhe memorie të kompjuterëve të tyre të ngadaltë.
Në këtë pjesë, do t'ju rikujtoj disa nga këto koncepte, pasi ato janë të nevojshme për të kuptuar bazën e të dhënave. Gjithashtu do të prezantoj konceptin e indeksit të bazës së të dhënave.
O(1) vs O(n2)
Aktualisht shumë zhvillues nuk shqetësohen për kompleksitetin kohor të algoritmo... dhe ata kanë të drejtë!
Por kur keni të bëni me një sasi të madhe të dhënash (nuk po flas për mijëra) ose nëse po luftoni për milisekonda, bëhet thelbësore të kuptoni këtë koncept. Dhe siç e kuptoni, bazat e të dhënave duhet të përballen me të dyja situatat! Nuk do t'ju bëj të kaloni më shumë kohë se sa duhet për të kapur thelbin. Kjo do na ndihmojë më vonë të kuptojmë konceptin e optimizimit të bazuar në kosto (cost based optimization).
Koncepci
Kompleksiteti kohor i algoritmo përdoret për të parë sa kohë do të marrë ekzekutimi i algoritmit për një sasi të caktuar të dhënash. Për të përshkruar këtë kompleksitet, përdoren nota matematikore të mëdha O. Kjo notacion përdoret me funksionin që përshkruan sa shumë operacione iu duhen algoritmit për një sasi të caktuar të dhënash hyrëse.
Për shembull, kur them "ky algoritëm ka kompleksitet O (some_function() )", kjo do të thotë se për të përpunuar një sasi të caktuar të dhënash, algoritmi i kërkon some_function(a_certain_amount_of_data) operacione.
Dhe është e rëndësishme jo sasia e të dhënave**, por ajo, ** si rritet numri i operacioneve kur rritet sasia e të dhënave. Kompleksiteti kohor nuk jep një numër të saktë operacionesh, por është një mënyrë e mirë për të vlerësuar kohën e ekzekutimit.
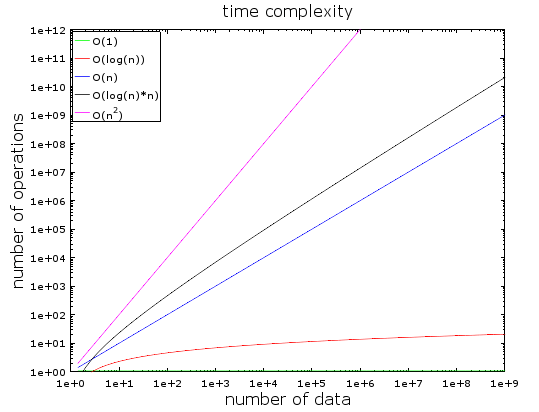
Në këtë grafik mund të shihni varësinë e numrit të operacioneve nga volumi i të dhënave të hyrjes për lloje të ndryshme të kompleksiteteve të algoritmeve. Kam përdorur një shkallë logarithmike për ta paraqitur atë. Në fjalë të tjera, sasia e të dhënave rritet shpejt nga 1 në 1 miliard. Mund të shohim se:
- O(1) ose kompleksiteti konstant mbetet i pandryshuar (përndryshe nuk do të quhej kompleksitet konstant).
- O(log(n)) mbetet i ulët edhe me miliarda të dhëna.
- Kompleksiteti më i keq është— O(n2), ku numri i operacioneve rritet shpejt.
- Dy kompleksitete të tjera gjithashtu rriten me shpejtësi të madhe.
Shembuj
Me një numër të vogël të dhënash, diferenca midis O(1) dhe O(n2) është e papërfillshme. Për shembull, le ta supozojmë se keni një algoritëm që duhet të procesojë 2000 elemente.
- Algoritmi O(1) do t'ju kushtojë 1 operacion
- Algoritmi O(log(n)) do t'ju kushtojë 7 operacione
- Algoritmi O(n) do t'ju kushtojë 2 000 operacione
- Algoritmi O(n * log(n)) do t'ju kushtojë 14 000 operacione
- Algoritmi O(n2) do t'ju kushtojë 4 000 000 operacione
Diferenca midis O(1) dhe O(n2) duket e madhe (4 milion operacione) por do të humbni maksimum 2 ms, sa një kohë për të mbyllur sytë. Në të vërtetë, procesorët modern mund të përpunojnë . Kjo është arsyeja pse performanca dhe optimizimi nuk janë probleme në shumë projekte IT.
Siç e thashë, është ende e rëndësishme të kuptohet kjo koncept kur punoni me një sasi të madhe të dhënash. Nëse këtë herë algoritmi duhet të procesojë 1 000 000 elemente (ndonjëherë kjo nuk është shumë për një bazë të dhënash):
- Algoritmi O(1) do t'ju kushtojë 1 operacion
- Algoritmi O(log(n)) do t'ju kushtojë 14 operacione
- Algoritmi O(n) do t'ju kushtojë 1 000 000 operacione
- Algoritmi O(n * log(n)) do t'ju kushtojë 14 000 000 operacione
- Algoritmi O(n2) do t'ju kushtojë 1 000 000 000 000 operacione
Nuk kam bërë llogaritjet, por do të thoja se me algoritmin O(n2) keni kohë për të pirë një kafe (madje dy!). Nëse shtoni edhe 0 në sasinë e të dhënave, do të keni kohë për të bësh një gjumë të vogël.
Le të shkojmë më thellë
Për reference:
- Kërkimi në një tabelë të mirë të heshëve gjen elementin në O(1).
- Kërkimi në një pemë të mirë të balancuar jep rezultatin në O(log(n)).
- Kërkimi në një varg jep rezultatin në O(n).
- Algoritmet më të mira të renditjes kanë kompleksitet O(n * log(n)).
- Një algoritëm i keq i renditjes ka kompleksitet O(n2).
Shënim: në pjesët në vazhdim do të shohim këto algoritme dhe struktura të dhënash.
Ka janë disa lloje të kompleksitetit temporal të algoritmit:
- skenari i rastit mesatar
- mënyra më e mirë e zhvillimit
- dhe skenari më i keq
Kompleksiteti temporal zakonisht është skenari më i keq.
Kam folur vetëm për kompleksitetin temporal të algoritmit, por kompleksiteti gjithashtu aplikohet për:
- konsumimin e memories nga algoritmi
- konsumimin e input/output në disk nga algoritmi
Sigurisht, ka komplekse më të këqija se n2, për shembull:
- n4: kjo është e tmerrshme! Disa nga algoritmet e përmendura kanë një kompleksitet të tillë.
- 3n: kjo është akoma më e keqe! Një nga algoritmet që do të shohim në mes të këtij artikulli ka këtë kompleksitet (dhe në të vërtetë përdoret në shumë baza të të dhënash).
- faktorial n: nuk do të merrni kurrë rezultatet tuaja edhe me një sasi të vogël të dhënash.
- nn: nëse përballeni me këtë kompleksitet, duhet të pyesni veten, a është vërtet kjo fusha juaj …
Shënim: ju kam dhënë një ide, jo një definicion të vërtetë të shenjës "O e madhe". Mund të lexoni këtë artikull në për një definicion të vërtetë (asimptotik).
MergeSort (Sortimi me bashkim)
Çfarë bëni kur ju nevojitet të renditni një koleksion? Çfarë? Thërrisni funksionin sort()… Ok, përgjigje e mirë… Por për një bazë të dhënash, duhet ta kuptoni se si funksionon ky funksion sort().
Ekzistojnë disa algoritme të mira për renditjen, prandaj unë do të ndalem te më i rëndësishmi: renditja me bashkim. Ndoshta tani nuk po e kuptoni pse renditja e të dhënave është e dobishme, por do të duhet të kuptoni pas pjesës që i dedikohet optimizimit të pyetjeve. Më shumë, kuptimi i renditjes me bashkim do të na ndihmojë më vonë të kuptojmë operacionin e përgjithshëm të bashkimit të bazave të të dhënave, të quajtur merge bashkohu (bashkimi me bashkim).
Bashko (bashkimi)
Si shumë algoritme të dobishme, renditja me bashkim bazohet në një hile: bashkimi i dy masivave të renditur të madhësisë N/2 në një masiv të renditur me N elemente kërkon vetëm N operacione. Ky operacion quhet bashkim.
Le të shohim se çfarë do të thotë kjo në një shembull të thjeshtë:
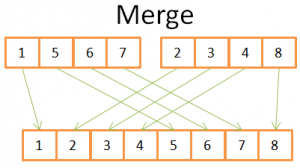
Në këtë skicë, është e qartë se për të ndërtuar masivin përfundimtar të renditur nga 8 elemente duhet të bëni vetëm një iterim për dy masiva të renditur me 4 elemente. Duke qenë se të dy masivat me 4 elemente janë të renditur tashmë:
- 1) ju krahasoni të dy elementët aktualë në dy masivat (në fillim aktuali = i pari)
- 2) pastaj merrni më të voglin për ta vendosur atë në një array me 8 elemente
- 3) dhe kaloni në elementin tjetër në array, ku morët elementin më të vogël
- dhe përsëritni 1, 2, 3 derisa të arrini te elementi i fundit të njërit nga array-t.
- Pastaj merrni elementët e tjerë të array-t tjetër për t'i vendosur në array me 8 elemente.
Kjo funksionon, sepse të dy array-t me 4 elemente janë të renditura, dhe për këtë arsye nuk keni nevojë të "ktheheni" në këto array.
Tani që e kuptuam këtë mashtrim, ja pseudokodi im për bashkimin:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //kthimet rekurzive
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //bashkimi i 2 array-ve të vogla të renditura në një të madhe
   array result := merge(new_left_array,new_right_array);
   return result;
Sorting me bashkim e ndan detyrën në detyra më të vogla dhe pastaj gjen rezultatet e detyrave më të vogla për të marrë rezultatin e detyrës origjinale (shënim: ky lloj algoritmi quhet ndaje dhe sundo). Nëse nuk e kuptoni këtë algoritem, mos u shqetësoni; unë nuk e kuptova këtë herën e parë që e pashë. Nëse kjo mund t'ju ndihmojë, unë e shoh këtë algoritëm si një algoritëm me dy faza:
- Faza e ndarjes, ku array-i ndahet në array të vogla
- Faza e renditjes, ku array të vogla bashkohen (duke përdorur bashkimin) për të krijuar një array më të madh.
Faza e ndarjes
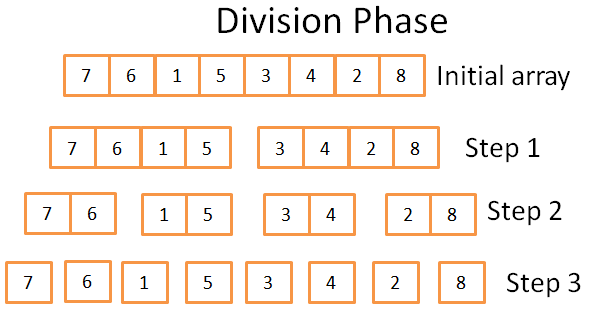
Në fazën e ndarjes, array ndahen në array të njësi përmes 3 hapash. Numri formal i hapave është log(N) (për shkak se N=8, log(N) = 3).
Si e di unë këtë?
Unë jam një gjenial! Në një fjalë — matematika. Ideja është se çdo hap nda madhësinë e array-original në 2. Numri i hapave është numri i herëve që mund t'i ndani array-n origjinal në dy. Kjo është përkufizimi i saktë i logaritmit (me bazë 2).
Faza e renditjes
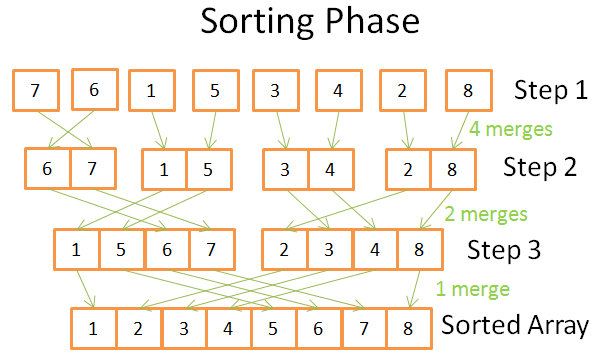
Në fazën e renditjes, filloni me array të njësi (me një element). Në secilën fazë, aplikoni disa operacione bashkimi, dhe kostoja totale është N = 8 operacione:
- Në hapin e parë, keni 4 bashkime, të cilat kushtojnë 2 operacione secila
- Në hapin e dytë, keni 2 bashkime, që kushtojnë 4 operacione secila
- Në hapin e tretë, keni 1 bashkim, që kushton 8 operacione
Për shkak se ka log(N) hapa, kostoja totale N * log(N) operacione.
Avantazhet e renditjes me bashkim
Pse është ky algoritëm kaq i fuqishëm?
Sepse:
- Mund ta ndryshoni atë për të reduktuar sasinë e memories, në mënyrë që të mos krijoni masa të reja, por të ndryshoni direkt masën hyrëse.
Shënim: ky lloj algoritmesh quhet (renditje pa kujtesë shtesë).
- Mund ta ndryshoni atë për të përdorur hapësirën ndihmëse dhe një sasi të vogël memorjeje pa kosto të konsiderueshme në hyrje/ dalje nga disku. Ideja është që të ngarkohet në memorje vetëm ato pjesë që janë duke u trajtuar aktualisht. Kjo është e rëndësishme kur ju nevojitet të renditni një tabelë me disa gigabajtë me një tampon memorjeje prej 100 megabajtësh.
Shënim: ky lloj algoritmesh quhet .
- Mund ta ndryshoni atë për të funksionuar në disa procese/rrjedha/servertime.
Për shembull, renditja e shpërndarë me bashkim është një nga komponentët kyç (i cili është një strukturë në të dhënat e mëdha).
- Ky algoritëm mund të kthejë plumbin në ar (e vërtetë!).
Ky algoritëm renditjeje përdoret në shumicën (nëse jo në të gjitha) bazat e të dhënave, por nuk është i vetmi. Nëse dëshironi të dini më shumë, mund të lexoni këtë , i cili diskuton avantazhet dhe disavantazhet e algoritmeve të zakonshme të renditjes në bazat e të dhënave.
Masa, Pema dhe Tabela e Hashit
Tani që e kuptojmë idenë e kompleksitetit temporal dhe renditjes, duhet t'ju flas për 3 strukturat e dhënave. Kjo është e rëndësishme sepse ato janë baza e bazave të të dhënave moderne. Do të prezantoj gjithashtu konceptin indeksit të bazës së të dhënave.
Array
Masa dy dimensionale është struktura më e thjeshtë e dhënave. Tabela mund të mendohet si një masë. Për shembull:
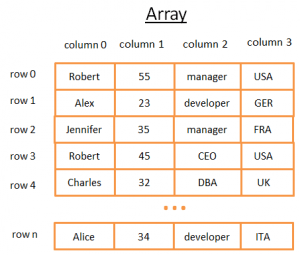
Ky masë 2-dimensionale përfaqëson një tabelë me rreshta dhe kolona:
- Çdo rresht përfaqëson një entitet
- Kolonat ruajnë pronat që përshkruajnë entitetin.
- Çdo kolonë ruan të dhëna të një lloji të caktuar (integer, string, date …).
Është kaq e përshtatshme për të ruajtur dhe vizualizuar të dhëna, megjithatë, kur ju nevojitet të gjeni një vlerë të caktuar, kjo nuk funksionon.
Për shembull, nëse dëshironi të gjeni të gjithë djemtë që punojnë në Mbretërinë e Bashkuar, do t'ju duhet të shqyrtoni çdo rresht për të pëdetermuar nëse ky rresht i përket Mbretërisë së Bashkuar. Kjo do t'ju kushtojë N operacioneindex N — numri i rreshtave, që nuk është keq, por a ka një mënyrë më të shpejtë? Tani është koha të njihemi me pemët.
Shënim: shumica e bazave të të dhënave moderne ofrojnë grupe të zgjeruara për ruajtjen efikase të tabelave: heap-organized tables dhe index-organized tables. Por kjo nuk ndryshon problemin e kërkimit të shpejtë për një kusht të caktuar në një grup kolonash.
Pema dhe indeksi i bazës së të dhënave
Pema binare e kërkimit është një pemë binare me një pronë të veçantë, çelësi në çdo nyje duhet të jetë:
- më i madh se të gjithë çelësat që janë ruajtur në nënpemën e majtë
- më i vogël se të gjithë çelësat që janë ruajtur në nënpemën e djathtë
Le ta shohim se çfarë do të thotë kjo vizualisht
Ideja
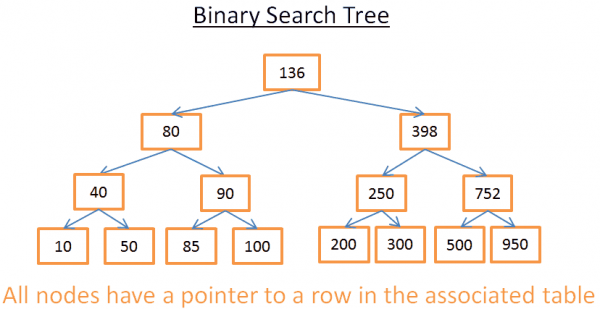
Kjo pemë ka N = 15 elemente. Le të themi se po kërkoj 208:
- Filloj nga rrënja, çelësi i së cilës është 136. Pasi 136<208, shoh në nënpemën e djathtë të nyjes 136.
- 398>208, prandaj, shoh në nënpemën e majtë të nyjes 398
- 250>208, prandaj, shoh në nënpemën e majtë të nyjes 250
- 200<208, prandaj, shoh në nënpemën e djathtë të nyjes 200. Por 200 nuk ka nënpemë të djathtë, vlera nuk ekziston (sepse, nëse do të ekzistonte, do të ishte në nënpemën e djathtë të 200).
Tani, le të themi se po kërkoj 40
- Fillo nga rrënja, çelësi i së cilës është 136. Pasi 136 > 40, shoh në nënpemën e majtë të nyjes 136.
- 80 > 40, prandaj, shoh në nënpemën e majtë të nyjes 80
- 40= 40, nyja ekziston. Nxjerr identifikuesin e rreshtit brenda nyjës (kjo nuk është në ilustrim) dhe shoh në tabelë për identifikuesin e dhënë të rreshtit.
- Dija për identifikuesin e rreshtit, më lejon të di saktësisht ku ndodhen të dhënat në tabelë, dhe për këtë arsye mund t'i marr ato menjëherë.
Në fund, të dy kërkime do të më kushtojnë numrin e niveleve brenda pemës. Nëse lexoni me kujdes pjesën mbi renditjen e bashkimit, duhet të shihni se këtu ka log(N) nivele. Pra, kostoja e kërkimit është log(N), nuk është keq!
Kthehemi në problemin tonë
Por kjo është shumë abstrakte, prandaj le të kthehemi në problemin tonë. Në vend të një integeri të thjeshtë, imagjinoni një varg që përfaqëson vendin e dikujt në tabelën e mëparshme. Supozoni se keni një pemë që përmban fushën "country" (kolona 3) të tabelës:
- Nëse dëshironi të dini, kush punon në Mbretërinë e Bashkuar
- shihni pemën për të marrë nyjën që përfaqëson Mbretërinë e Bashkuar
- brenda "UKnode" do të gjeni lokacionin e regjistrimeve të punëtorëve në Mbretërinë e Bashkuar.
Kërkimi i kësaj do t'i kushtojë log(N) operacione në vend të N operacioneve nëse e përdorni drejtpërdrejt matricën. Ajo që sapo paraqitët është indeksi i bazës së të dhënave.
Mund të ndërtoni një pemë indeksi për çdo grup fushash (string, numër, 2 strings, numër dhe string, datë…) sa kohë që keni një funksion për të krahasuar çelësat (dmth. grupet e fushave) në mënyrë që të mund të vendosni renditjen mes çelësave (çka ndodh për çdo tip të thjeshtë në bazën e të dhënave).
B+TreeIndex
Megjithëse kjo pemë funksionon mirë për të marrë një vlerë të caktuar, ekziston një PROBLEM TË MADH kur ju nevojitet të merrni disa elemente midis dy vlerave. Kjo do t'i kushtojë O(N) sepse do t'ju duhet të shihni çdo nyje në pemë dhe të kontrolloni nëse ndodhet midis këtyre dy vlerave (për shembull, me një kalim të renditur të pemës). Për më tepër, kjo operacion nuk është e përshtatshme për hyrjen dhe daljen në disk, pasi do t'ju duhet të lexoni të gjithë pemën. Na nevojitet një mënyrë për të kryer kërkesën e intervalit. Për të zgjidhur këtë problem, bazat e të dhënave moderne përdorin një version të modifikuar të pemës së mëparshme të quajtur B+Tree. Në pemën B+Tree:
- vetëm nyjet më të ulëta (gjethet) ruajnë informacionin (lokacionin e rreshtave në tabelën e lidhur)
- nyjet e tjera janë këtu për t'u drejtuar në nyjen e duhur gjatë kërkimit.
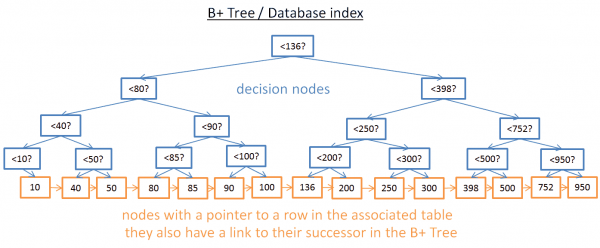
Siç mund ta shihni, këtu ka më shumë nyje (dyfish). Në të vërtetë, keni nyje shtesë, "nyje vendimmarrëse", që do t'ju ndihmojnë të gjeni nyjen e duhur (e cila ruan lokacionin e rreshtave në tabelën e lidhur). Por kompleksiteti i kërkimit mbetet përsëri O(log(N)) (ka vetëm një nivel tjetër). Diferenca e madhe është se nyjet në nivelin më të ulët janë të lidhura me pasardhësit e tyre.
Me këtë B+Tree, nëse kërkoni vlerat nga 40 në 100:
- Thjesht duhet të kërkoni 40 (ose vlerën më të afërt pas 40, nëse 40 nuk ekziston), ashtu siç bëtë me pemën e mëparshme.
- Pastaj mbledhni pasardhësit e 40, duke përdorur lidhje direkte me pasardhësit, derisa të arrini 100.
Të supozoni se keni gjetur M pasardhës, dhe pemë ka N nyje. Kërkimi në një nyje të caktuar kushton log(N) si me pemën e mëparshme. Por, duke marrë këtë nyje, do të merrni M pasardhës në M operacione me lidhjet ndaj pasardhësve të tyre. Ky kërkim kushton vetëm M+log(N) në krahasim me N operacione të pemës së mëparshme. Më shumë, nuk ju nevojitet të lexoni të gjithë pemën (vetëm M + log (N) nodules), që do të thotë përdorim më të ulët të ndarjes. Nëse M është e vogël (p.sh. 200 rreshta) dhe N është e madhe (1 000 000 rreshta), kjo do të jetë një DALLIM I MADH.
Por këtu ka probleme të reja (prapë!). Nëse shtoni ose hiqni një rresht në bazën e të dhënave (dhe, për rrjedhojë, në indekset e lidhura B+Tree):
- duhet të mbani rendin midis nodulave brenda pemës B+Tree, përndryshe nuk do të jeni në gjendje të gjeni nodet brenda pemës së pa renditur.
- duhet të ruani numrin minimal të niveleve në B+Tree, përndryshe kompleksiteti temporal në O (log (N)) do të bëhet O (N).
Me fjalë të tjera, B+Tree duhet të jetë vetë-renditur dhe i balancuar. Fatmirësisht, kjo është e mundur me operacione të mençura të fshirjes dhe shtimit. Por kjo do të kushtojë shtrenjtë: shtimi dhe fshirja në pemën B+ kushtojnë O (log (N)). Kjo është arsyeja pse disa prej jush kanë dëgjuar se përdorimi i shumë indekseve nuk është një ide e mirë. Në të vërtetë, ju ngadalësoni shtimin e shpejtë / përditësimin / fshirjen e një rreshti në tabelë, pasi baza e të dhënave duhet të përditësojë indiket e tabelës me një operacion të kushtueshëm O (log (N)) për çdo indeks. Më shumë, shtimi i indekseve do të thotë një ngarkesë më të madhe për menaxherin e transaksioneve (do të përshkruhet në fund të artikullit).
Për më shumë informacion, mund të shihni artikullin në Wikipedia rreth . Nëse dëshironi një shembuj implementimi të B+Tree në bazën e të dhënave, shihni dhe nga zhvilluesi kryesor i MySQL. Të dy përqendrohen në mënyrën se si InnoDB (motor MySQL) trajton indiket.
Shënim: lexuesi më tha se, për shkak të optimizimeve të nivelit të ulët, pema B+ duhet të jetë plotësisht e balancuar.
Hashtable (Tabela e Heshit)
Struktura jonë e fundit e rëndësishme të dhënash është tabela e heshit. Kjo është shumë e dobishme kur dëshironi të kërkoni shpejt vlera. Më shumë, kuptimi i tabelës së heshit do të na ndihmojë më vonë të kuptojmë operacionin e përgjithshëm të bashkimit me bazën e të dhënave, të quajtur bashkimi hesh ( bashkim hesh). Kjo strukturë të dhënash përdoret gjithashtu nga baza e të dhënave për ruajtjen e disa gjërave të brendshme (p.sh., tabela e bllokimit ose pula e memorjes, do t'i shohim të dy këto koncepte më vonë).
Tabela e heshit është një strukturë të dhënash që gjen shpejt një element sipas çelësit të tij. Për të ndërtuar një tabelë hesh, duhet të përcaktoni:
- çelësin për elementet tuaja
- funksionin e heshit për çelësat. Heshët e llogaritur të çelësave japin vendndodhjen e elementeve (të quajtur segmente ).
- funksion për krahasimin e çelësave. Sapo të keni gjetur segmentin e duhur, duhet të gjeni elementin që kërkoni brenda segmentit, duke përdorur këtë krahasim.
Një shembull i thjeshtë
Le të marrim një shembull ilustruar:
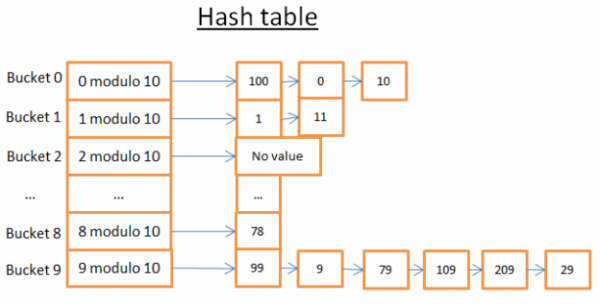
Kjo tabelë hesh ka 10 segmente. Për shkak se jam lenë, kam ilustruar vetëm 5 segmente, por e di që ju jeni të zgjuar, prandaj do t'ju lejoj të imagjinoni 5 të tjerat vetë. Kam përdorur funksionin e heshit mod 10 të çelësit. Në fjalë të tjera, ruaj vetëm numrin e fundit të çelësit të elementit për të gjetur segmentin e tij:
- nëse numri i fundit është 0, elementi hyn në segmentin 0,
- nëse numri i fundit është 1, elementi hyn në segmentin 1,
- nëse numri i fundit është 2, elementi hyn në segmentin 2,
- …
Funksioni i krahasimit që kam përdorur, është thjesht barazia midis dy numrave të plotë.
Supozoni se dëshironi të merrni elementin 78:
- Tabela e heshit llogarit kodin hesh për 78, që është 8.
- Tabela e heshit shikon në segmentin 8, dhe elementi i parë që gjen është 78.
- Ajo ju kthen elementin 78
- Kërkimi kushton vetëm 2 operacione (një për llogaritjen e vlerës së funksionit të heshit, dhe tjetra për gjetjen e elementit brenda segmentit).
Tani, supozoni se dëshironi të merrni elementin 59:
- Tabela e heshit llogarit kodin hesh për 59, që është 9.
- Tabela e heshit kërkon në segmentin 9, elementi i parë i gjetur është 99. Pasi 99 != 59, elementi 99 nuk është elementi i saktë.
- Duke përdorur logjikën e njëjtë, merret elementi i dytë (9), i treti (79), …, i fundit (29).
- Elementi nuk u gjet.
- Kërkimi kishte kushtuar 7 operacione.
Një funksion i mirë hesh
Siç shihni, në varësi të vlerës që po kërkoni, kostoja nuk është e njëjtë!
Nëse tani ndryshoj funksionin e heshit në mod 1 000 000 të çelësit (dmth, duke marrë 6 numrat e fundit), kërkimi i dytë do të kushtojë vetëm 1 operacion, sepse në segmentin 000059 nuk ka elemente. Detyra reale është të gjendet një funksion i mirë hesh, i cili do të krijojë segmente që përmbajnë një numër shumë të vogël elementesh..
Në shembullin tim, është e lehtë të gjesh një funksion hash të mirë. Por ky është një shembull i thjeshtë, të gjesh një funksion hash të mirë është më e vështirë kur çelësi:
- string (p.sh. mbiemri)
- 2 strings (p.sh. mbiemri dhe emri)
- 2 strings dhe një datë (p.sh. mbiemri, emri dhe data e lindjes)
- …
Me një funksion hash të mirë, kërkimi në tabelën hash bëhet në O(1).
Merrja e array-ve vs tabelës hash
Pse të mos përdorim array?
Hmm, pyetje e mirë.
- Tabela hash mund të jetë pjesërisht e ngarkuar në memorie, ndërsa segmentet e tjera mund të qëndrojnë në disk.
- Me array duhet të përdorësh hapësirë të pandërprerë në memorie. Nëse ngarkon një tabelë të madhe shumë e vështirë të gjejë mjaft hapësirë të pandërprerë.
- Për tabelën hash, mund të zgjidhni çelësin që dëshironi (p.sh. vendi dhe mbiemri i personit).
Për informacion të mëtejshëm, mund të lexoni artikullin mbi , e cila është një realizim efikas i tabelës hash; nuk keni nevojë të kuptoni Java për të kuptuar konceptet e paraqitura në këtë artikull.
Burimi: habr.com
