

Përshëndetje, Habr!
Pas festave të Vitit të Ri, rifilluam cloud-in e qëndrueshëm ndaj katastrofave në dy lokacione. Sot do të flasim për mënyrën si është ndërtuar dhe do të tregojmë se çfarë ndodh me makinat virtuale të klientëve në rastin e dështimit të elementeve të veçanta të klasës dhe rënies së një lokacioni të tërë (spoiler – gjithçka është në rregull me to).
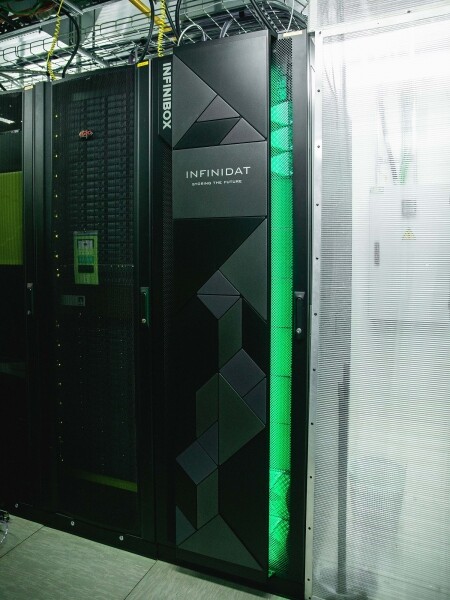
Sistemi i ruajtjes së të dhënave të cloud-it të qëndrueshëm ndaj katastrofave në lokacionin OST.
Çfarë ka brenda
Nën kapuçin e klasës janë serverët Cisco UCS me hipervizorin VMware ESXi, dy Sisteme të Ruajtjes INFINIDAT InfiniBox F2240, pajisjet rrjetore Cisco Nexus, si dhe switch-et SAN Brocade. Klasa është e shpërndarë në dy lokacione – OST dhe NORD, që do të thotë se në çdo qendër të të dhënave ka një grup identik pajisjesh. Kjo në vetvete e bën atë të qëndrueshëm ndaj katastrofave.
Brenda një lokacioni, elementët kryesorë gjithashtu janë të kopjuar (host-ët, switch-et SAN, rrjeti).
Dy lokacione janë të lidhura me linja të dedikuara optike, të rezervuara gjithashtu.
Pak fjalë për sistemin e ruajtjes. Variantin e parë të cloud-it të qëndrueshëm ndaj katastrofave e ndërtuam mbi NetApp. Këtu zgjodhëm INFINIDAT, dhe ja pse:
- Opsioni i replikimit Active-Active. Ai lejon që makina virtuale të vazhdojë të funksionojë edhe në rastin e dështimit të plotë të njërit nga sistemet e ruajtjes. Do flas më në detaje për replikimin më vonë.
- Tre kontrolerët e disqeve për të rritur qëndrueshmërinë e sistemit. Zakonisht janë dy.
- Zgjidhje e gatshme. Na erdhi një raft i gatuar tashmë, i cili duhet vetëm të lidhet me rrjetin dhe të konfigurohet.
- Mbështetje teknike e kujdesshme. Inxhinierët e INFINIDAT vazhdimisht analizojnë log-et dhe ngjarjet e sistemit të ruajtjes, instalojnë versionet e reja të firmware-it, ndihmojnë me konfigurimin.
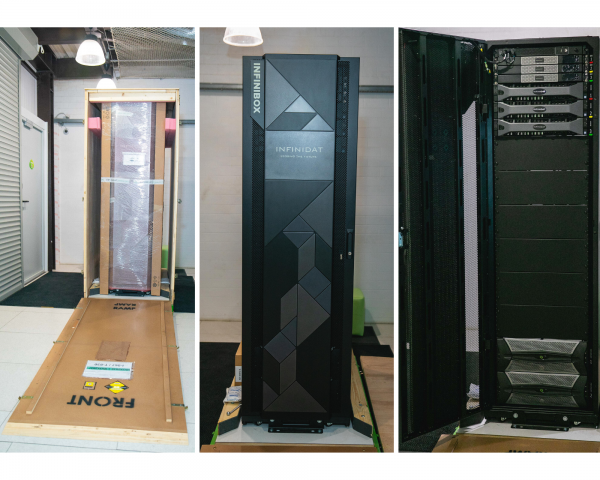
Ja pak foto nga unpacking:
Si funksionon
Cloud-i tashmë është i qëndrueshëm ndaj dështimeve. Ai mbron klientin nga defekte të vetme harduerike dhe programore. Qëndrueshmëria ndaj katastrofave do të ndihmojë për të mbrojtur nga dështimet masive brenda një lokacioni: për shembull, dështimi i sistemit të ruajtjes (ose i klasës SDS, që ndodh shpesh 🙂), gabime masive në rrjetin e ruajtjes dhe më shumë. Dhe më e rëndësishmja: një cloud i tillë shpëton kur një lokacion i tërë bëhet i paqëndrishëm për shkak të një zjarri, një black-out, një pushtimi, ose një sulmi nga alienët.
Në të gjitha këto raste, makinave virtuale të klientëve vazhdojnë të punojnë, dhe ja pse.
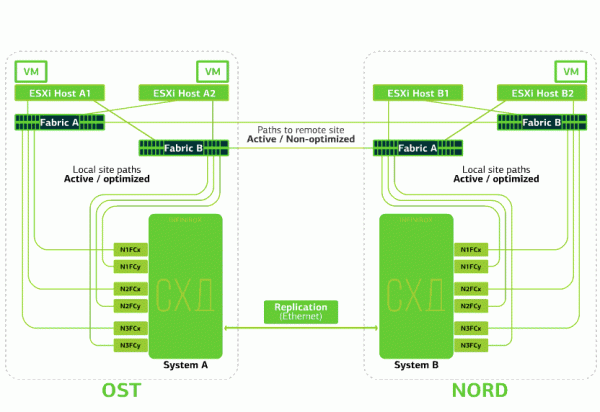
Skema e klasterit është e dizajnuar në një mënyrë që çdo host ESXi me makinat virtuale të klientëve mund të qaset në cilindo nga dy SHT. Nëse SHT në lokacionin OST del jashtë funksionit, atëherë makinat virtuale do të vazhdojnë të funksionojnë: hostet, në të cilat ato punojnë, do të kërkojnë të dhëna nga SHT në NORD.
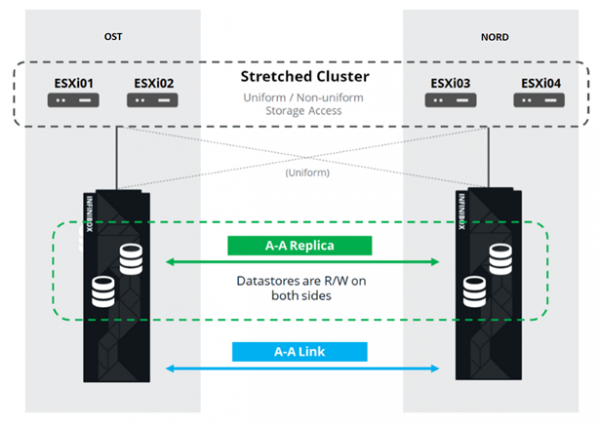
Kështu duket skema e lidhjes në klaster.
Kjo është e mundur falë faktit se midis fabrikave SAN të dy lokacioneve është konfiguruar Inter-Switch Link: ndërlidhësi SAN Fabric A OST është i lidhur me ndërlidhësin SAN Fabric A NORD, ashtu si edhe për ndërlidhësit SAN Fabric B.
Dhe për të siguruar që të gjitha këto shkëmbime të fabrikave SAN kanë kuptim, midis dy SHT është konfiguruar replikimi Active-Active: informacioni regjistrohet praktikisht njëkohësisht në SHT lokale dhe në SHT të largët, RPO=0. Kështu, një SHT përmban origjinalin e të dhënave, ndërsa tjetra ka replikën e tyre. Të dhënat replikohen në nivelin e volumit të SHT-së, dhe tashmë mbi to ruhen të dhënat e VM (diskët e saj, skedari i konfigurimit, skedari swap etj.).
Hosti ESXi e shqetëson volumet primar dhe replikën e tij si një pajisje diskësh (Storage Device). Nga hosti ESXi në çdo pajisje diskësh shkojnë 24 rrugë:
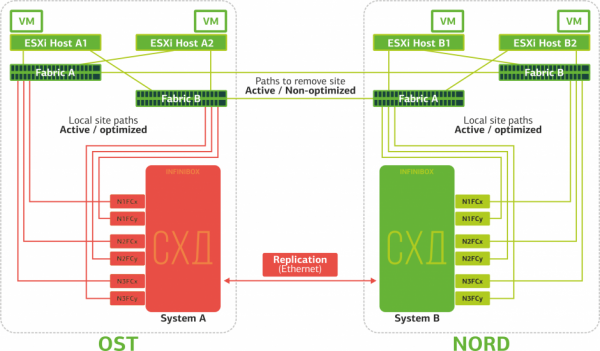
12 rrugë lidhin atë me SHT-në lokale (rrugët optimale), ndërsa 12 të tjera me atë të largët (rrugët jo optimale). Në situatën standarde, ESXi qaset në të dhënat në SHT-në lokale duke përdorur rrugët 'optime'. Kur kjo SHT dështon, ESXi humbet rrugët optimale dhe kalon në 'rrugët jo optimale'. Kështu duket në skemë.
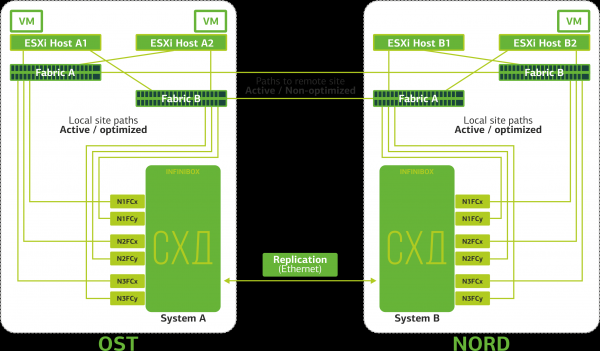
Skema e klasterit të qëndrueshëm ndaj katastrofave.
Të gjitha rrjetet e klientëve janë të lidhura në të dy lokacionet përmes një fabrike të përbashkët të rrjetit. Në çdo lokacion operon Provider Edge (PE), ku edhe përfundojnë rrjetet e klientëve. PE-të janë të bashkuar në një klaster të përbashkët. Në rast se PE në një lokacion dështon, gjithë trafiku redirektohet në lokacionin e dytë. Falë këtij mekanizmi, makinat virtuale nga lokacioni që ka humbur PE, mbeten të aksesueshme për rrjetin nga klientët.
Tani le të shohim se çfarë do të ndodhte me makinat virtuale të klientit në rastin e disa dështimeve. Të fillojmë me variantet më të lehta dhe të përfundojmë me të rëndin - dështimin e gjithë lokacionit. Në shembujt, lokacioni kryesor do të jetë OST, ndërsa ai rezervë, me replikat e të dhënave, - NORD.
Çfarë ndodh me makinën virtuale të klientit nëse…
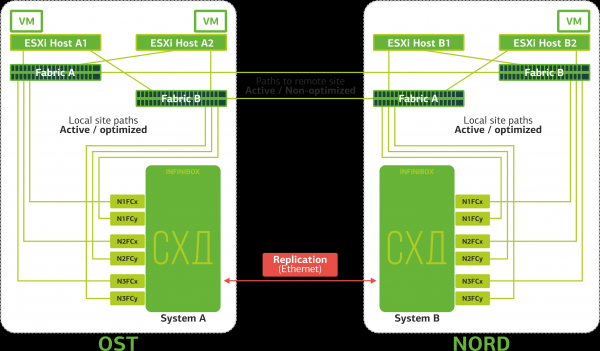
Dëshmon Linku i Replikimit. Replikimi midis SHT-së të dy lokacioneve ndalon.
ESXi do të funksionojë vetëm me pajisje disk lokales (në rrugët optimale).
Makinat virtuale vazhdojnë të funksionojnë.
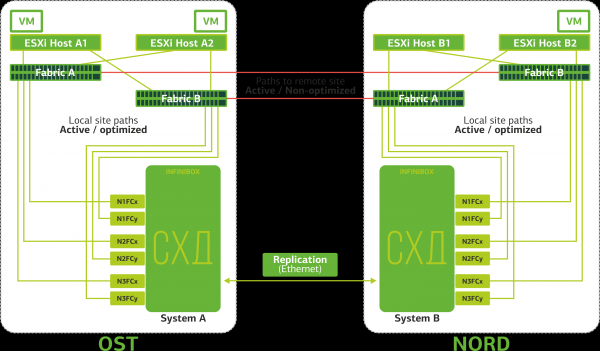
Po ndodh një ndërprerje ISL (Inter-Switch Link). Rasti është tepër i pamundur. Ndoshta ndonjë ekskavator i çmendur do të gërmojë disa kabllo optike, të cilat kalojnë rrugë të pavarura dhe janë të lidhura në platforma përmes lidhjeve të ndryshme. Por megjithatë, në këtë rast, hostet ESXi do të humbasin gjysmën e rrugëve dhe do të kenë akses vetëm në ruajtësit e tyre lokalë. Replikat do të mblidhen, por hostet nuk do të mund t'i aksesojnë ato.
Makinat virtuale funksionojnë normalisht.
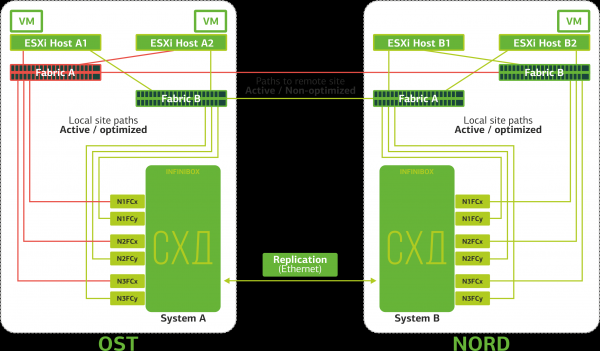
Një switch SAN dështoi në një nga platforma. Hostet ESXi humbasin një pjesë të rrugëve drejt ruajtësve. Në këtë rast, hostet në platformën ku dështoi switch do të funksionojnë vetëm përmes një HBA të vetë.
Makinat virtuale do të vazhdojnë të funksionojnë normalisht.
Të gjitha switch-in SAN dështojnë në një nga platforma. Supozoni se një ngjarje e tillë ndodhi në platformën OST. Në këtë rast, hostet ESXi në këtë platformë do të humbin të gjitha rrugët drejt pajisjeve të tyre disk. Mekanizmi standard VMware vSphere HA do të angazhohet: do të rindizet të gjitha makinat virtuale në platformën OST në NORD brenda një maksimumi prej 140 sekondash.
Makinat virtuale që punojnë në hostet e platformës NORD funksionojnë normalisht.
Një host ESXi dështon në një platformë. Këtu përsëri aktivohet mekanizmi vSphere HA: makinat virtuale nga hosti i dështuar do të rindizen në hoste të tjerë - në të njëjtën ose në një platformë të largët. Koha e rindizjes së makinës virtuale është deri në 1 minutë.
Nëse të gjithë hostet ESXi të platformës OST dështojnë, në këtë rast nuk ka variante: VM-të do të rindizen në një tjetër. Koha e rindizjes është e njëjta.
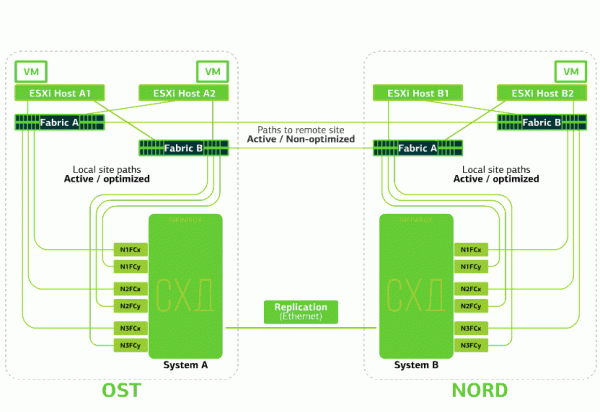
Një ruajtës dështon në një platformë. Supozoni se një ruajtës dështoi në platformën OST. Atëherë hostet ESXi të platformës OST kalojnë në punë me replikat e ruajtësve në NORD. Pas rikthimit të ruajtësit të dështuar në punë, do të ndodhë një replikim i detyruar, dhe hostet ESXi OST do të fillojnë përsëri të kenë akses në ruajtësin lokal.
Makinat virtuale gjatë gjithë kësaj kohe funksionojnë normalisht.
Një nga platforma dështoi. Në këtë rast, të gjitha makinat virtuale do të rinisen në platformën rezervë përmes mekanizmit vSphere HA. Koha e rinisjes së VM-së është 140 sekonda. Gjatë kësaj, të gjitha cilësimet rrjetore të makinës virtuale do të ruhen, dhe ajo mbetet e aksesueshme për klientin përmes rrjetit.
Për të siguruar një rinisje të suksesshme të makinave në platformën rezervë, çdo platformë është e mbushur vetëm gjysmë. Gjysma tjetër është rezervë në rast të zhvendosjes së të gjitha makinave virtuale nga platforma e dytë, e cila ka pësuar dëme.
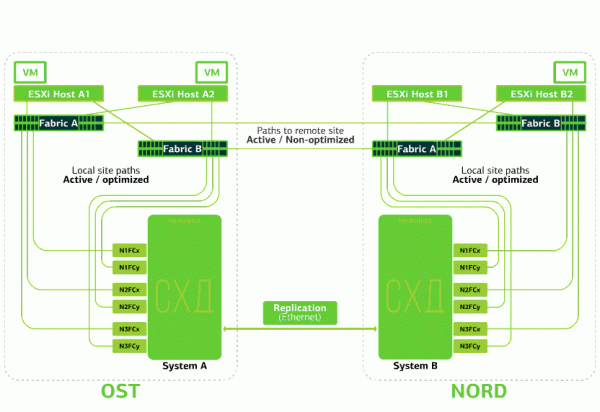
Ky është mbrojtja që ofron një cloud të qëndrueshëm ndaj katastrofave që bazohet në dy qendrat e të dhënave.
Kjo është një kënaqësi e shtrenjtë, sepse, përveç burimeve kryesore, nevojitet një rezervë në platformën e dytë. Prandaj, shërbimet kritikë për biznesin vendosen në një cloud të tillë, të cilat kanë ndalesa të gjata që sjellin humbje të mëdha financiare dhe reputacioni, ose nëse sistemit informativ i kërkohen kërkesa për qëndrueshmërinë ndaj katastrofave nga rregullatorët ose rregulloret e brendshme të kompanisë.
Burimet:
Burimi: habr.com
