

Ky këtij artikulli shkruhet për të ndihmuar në zgjedhjen e zgjidhjes së përshtatshme dhe për të kuptuar dallimet midis SDS si Gluster, Ceph dhe Vstorage (Virtuozzo).
Në tekst përdoren lidhje në artikuj me një shpjegim më të detajuar të problemeve të caktuara, prandaj përshkrimet do të jenë sa më të shkurtra, duke përdorur pika kyçe pa informacione të panevojshme dhe hyrëse, të cilat mund t’i kërkoni vetë në internet.
Në fakt, temat e prekur kërkojnë një ton specifik të tekstit, por në botën moderne gjithnjë e më shumë njerëz nuk pëlqejnë të lexojnë shumë))), prandaj mund të lexoni shpejt dhe të bëni zgjedhjen tuaj, dhe nëse ka diçka që nuk kuptoni, mund të kaloni në lidhjet ose të hidhni një sy në fjalët e panjohura))), dhe ky artikull funksionon si një mbështjellës transparent për këto tema të thella, duke treguar përmbajtjen – pikat kryesore të çdo zgjidhjeje.
Gluster
Të fillojmë me Gluster, i cili përdoret gjerësisht nga prodhuesit e platformave hiper-konverguese me SDS të bazuar në open source për mjedise virtuale dhe mund të gjendet në faqen e RedHat në seksionin storage, ku ofrohet zgjedhja midis dy opsioneve SDS: Gluster ose Ceph.
Gluster përbëhet nga një grup shërbimesh – shërbime që kryejnë të gjitha punët e shpërndarjes së skedarëve dhe të tjera. Brick – shërbimi që shërben një disk, Volume – vëllimi (puli) që bashkon këto brick. Më tej shërbimi i shpërndarjes së skedarëve në grupe përmes funksionit DHT (distributed hash table). Shërbimi i Sharding nuk do të përfshihet në përshkrim, pasi në lidhjet e mëposhtme do të ketë përshkrime të problemeve të lidhura me të.
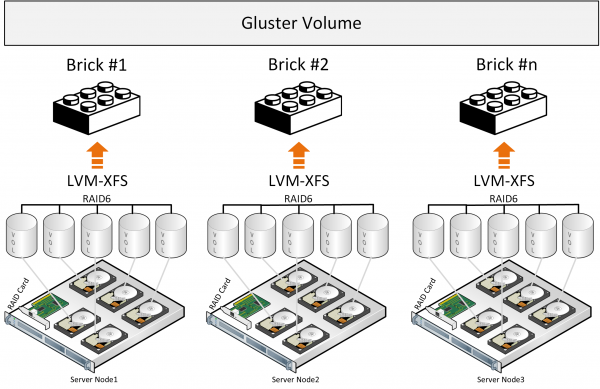
Kur shkruhet, skedari i plotë vendoset në brick dhe kopja e tij shkruhet paralelisht në brick në serverin e dytë. Më pas, skedari i dytë do të regjistrohet në grupin e dytë të dy briсk (ose më shumë) në serverë të ndryshëm.
Nëse skedarët janë afërsisht të një madhësie dhe vëllimi do të përbëhet vetëm nga një grup, gjithçka është në rregull, por në kushtet e tjera do të lindin problemet e mëposhtme nga përshkrimet:
- hapësira në grupe përdoret në mënyrë të pabarabartë, kjo varet nga madhësitë e skedarëve dhe nëse grupi nuk ka mjaft hapësirë për të regjistruar skedarin – ju do të merrni një gabim, skedari nuk do të regjistrohet dhe nuk do të shpërndahet në një grup tjetër;
- kur shkruhet një skedar, IO ndodhet vetëm në një grup, grupet e tjera nuk punojnë;
- nuk është e mundur të arrihet IO i tërë vëllimit kur shkruhet një skedar;
- dhe koncepti i përgjithshëm duket se është më pak efektiv për shkak të mungesës së shpërndarjes së të dhënave në blloqe, ku është më e lehtë të realizohet balancimi dhe të zgjidhet problemi i shpërndarjes së barabartë, sesa siç është tani kur fakti vendoset si një bllok i tërë.
Nga përshkrimi zyrtar duhet të kuptohet se gluster funksionon si një depo e skedarëve mbi RAID-in klasik. Ka pasur përpjekje për të zhvilluar ndarjen (Sharding) e skedarëve në blloqe, por këto janë plotësime që imponojnë humbje në performancë për qasjen arkitektonike ekzistuese, plus përdorimin e komponentëve të tillë të lira me kufizime në performancë si Fuse. Nuk ka shërbime metadatan, që kufizojnë mundësitë e performancës dhe qëndrueshmërisë së depozitës në shpërndarjen e skedarëve në blloqe. Të dhëna më të mira të performancës mund të vërehen në konfigurimin “Distributed Replicated” dhe numri i nodëve duhet të jetë të paktën 6 për organizimin e një replike të sigurt me 3 me shpërndarjen optimale të ngarkesës.
Këto konkluzione gjithashtu lidhen me përshkrimin e përvojës së përdorimit dhe në krahasim me , si dhe ka një përshkrim të përvojës për të arritur këtë konfigurim më të qëndrueshëm dhe më të besueshëm
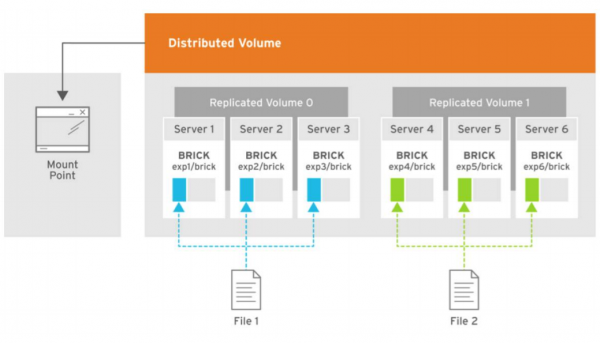
Në figurë shikohet shpërndarja e ngarkesës gjatë shkrimit të dy skedarëve, ku kopjet e skedarit të parë ndahen në tre serverët e parë, të cilët janë të bashkuar në grupin volume 0 dhe tre kopjet e skedarit të dytë vendosen në grupin e dytë volume1 nga tre serverë. Çdo server ka një disk.
Konkluzioni i përgjithshëm është se Gluster mund të përdoret, por me kuptimin se do të ketë kufizime në performancë dhe qëndrueshmëri, që krijojnë vështirësi në disa kushte të zgjidhjes hiper-konverguese, ku burimet janë gjithashtu të nevojshme për ngarkesat llogaritëse të mjeteve virtuale.
Ka disa pasqyra gjithashtu të performancës së Gluster, të cilat mund të arrihen në kushte të caktuara duke u kufizuar në
Ceph
Tani le të shqyrtojmë Ceph nga përshkrimet e arkitekturës që kam arritur Ka gjithashtu një krahasim midis , ku mund të kuptohet menjëherë se Ceph preferohet të implementohet në servera të veçantë, pasi shërbimet e tij kërkojnë të gjitha burimet e harduerit nën ngarkesë.
Arkitektura më shpesh më e komplikuar se Gluster dhe ka shërbime si shërbimet e metadatat, por e gjithë stina e komponentëve është mjaft e komplikuar dhe jo shumë fleksibël për ta përdorur në një zgjidhje virtualizimi. Të dhënat organizohen në blloqe, që duket se është më e efektshme, por ka humbje dhe latency në hierarkinë e të gjitha shërbimeve (komponentëve) nën disa ngarkesa dhe kushte emergjente, siç është shembulli i mëposhtëm.
Nga përshkrimi i arkitekturës, në qendër është CRUSH, i cili përcakton vendin e ruajtjes së të dhënave. Më pas vjen PG - kjo është abstraksioni më i komplikuar (grupi logic) për t'u kuptuar. PG janë të nevojshme për të bërë CRUSH më efikas. Qëllimi kryesor i PG është grupimi i objekteve për të ulur konsumimin e burimeve, për të përmirësuar performancën dhe shkallëzueshmërinë. Adresimi i objekteve në mënyrë të drejtpërdrejtë, veçmas, pa i bashkuar ato në PG do të ishte shumë i shtrenjtë. OSD - është shërbimi për çdo disk të veçantë.
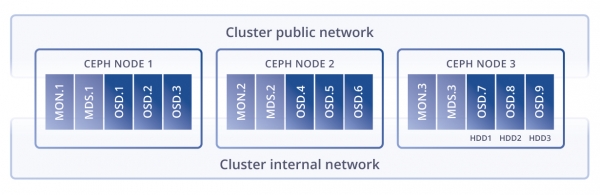
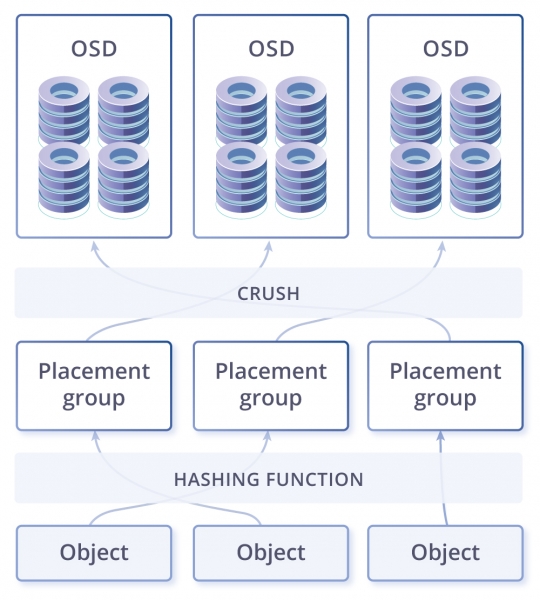
Klusteri mund të ketë një ose shumë rezervarë të dhënash me qëllime të ndryshme dhe me konfigurime të ndryshme. Reservarët ndahen në grupe vendosjeje. Në grupet e vendosjes ruhen objekte, të cilat kërkohen nga klientët. Në këtë nivel logjik përfundon, dhe fillon ai fizik, sepse secilës grup vendosjeje i është caktuar një disk kryesor dhe disa disqe-replika (sesa shumë varet nga faktori i replikimit të rezervarit). Me fjalë të tjera, në nivelin logjik, objekti ruhet në një grup konkret vendosjeje, ndërsa në nivelin fizik - në disqet që janë caktuar për të. Megjithatë, disqet fizikisht mund të jenë në nodo të ndryshme ose madje në qendra të ndryshme të të dhënave.
Në këtë skemë, grupet e vendosjes duken si një nivel i nevojshëm për fleksibilitetin e tërë zgjidhjes, por njëkohësisht edhe si një lidhje e tepërt në këtë zinxhir, që pa dashje ngjall mendime për humbjen e performancës. Për shembull, gjatë regjistrimit të të dhënave, sistemi duhet t'i ndajë ato në këto grupe dhe më pas në nivelin fizik në diskun kryesor dhe në diskët për replika. Pra, funksioni i hash-it punon gjatë kërkimit dhe vendosjes së objektit, por ka një efekt anësor – këto janë shpenzime të mëdha dhe kufizime në rinovimin e hash-it (kur shtohet ose hiqet një disk). Një tjetër problem me hash-in është vendosja e fiksuar e të dhënave, të cilat nuk mund të ndryshohen. Pra, nëse ndonjë disk përjeton një ngarkesë të rritur, sistemi nuk ka mundësi të mos shkruajë në të (duke zgjedhur një disk tjetër), funksioni i hash-it e detyron vendosjen e të dhënave sipas një rregulli, pa marrë parasysh se sa keq ndjehet disku, prandaj Ceph konsumon shumë memorie gjatë rinovimit të PG-së në rastin e vetë-riparimit ose rritjes së magazinës. Përfundimi është se Ceph punon mirë (edhe pse ngadalë), por vetëm kur nuk ka zgjerim, situata emergjente ose azhurnim.
Natyrisht, ka mundësi për rritjen e performancës përmes keshtimi dhe keshtirjes, por për këtë nevojitet hardware i mirë dhe gjithsesi do të ketë humbje. Por në përgjithësi Ceph duket më tërheqës se Gluster për produktivitet. Gjithashtu, gjatë përdorimit të këtyre produkteve duhet të merret parasysh një faktor i rëndësishëm - niveli i lartë i kompetencave, përvojës dhe profesionalizmit me një theks të madh në linux, pasi është shumë e rëndësishme të gjitha të vendosen, konfigurohen dhe mbahen siç duhet, gjë që krijon më shumë përgjegjësi dhe ngarkesë ndaj administratorit.
Vstorage
Arkitektura duket edhe më interesante te , e cila mund të përdoret së bashku me hipervizorin në të njëjtat nyje, në të njëjtin , por është shumë e rëndësishme ta konfigurosh gjithçka siç duhet për të arritur një performancë të mirë. Pra, duke vendosur një produkt të tillë nga kutia në një konfigurim të rastësishëm pa marrë parasysh rekomandimet në përputhje me arkitekturën do të jetë shumë e lehtë, por jo produktive.
Çfarë mund të bashkëjetojë për ruajtje pranë shërbimeve të hipervizorit kvm-qemu, dhe kjo janë vetëm disa shërbime, ku është gjetur një hierarki kompakt optimale komponentesh: shërbimi i klientit i montuar përmes FUSE (i modifikuar, jo open source), shërbimi i metadatanë MDS (Shërbimi i Metadatanave), shërbimi i bllokut të të dhënave Chunk service, i cili në nivelin fizik është i barabartë me një disk dhe ajo është e gjitha. Sigurisht, për shpejtësi është optimale të përdoret një skemë e qëndrueshme me dy kopje, por nëse aktivizohet caching dhe regjistrat në disqet SSD, atëherë kodimi i qëndrueshëm (erase coding ose raid6) mund të përshpejtohet ndjeshëm në një skemë hibride ose madje edhe më mirë në all flash. Me EC (erase coding) ka disa disavantazhe: kur modifikohet një bllok i të dhënave, është e nevojshme të llogaritet përsëri somat e paritetit. Për të shmangur humbjet në këtë operacion Ceph shkruan në EC si të vonuar dhe problemi me performancën mund të ndodhi në një kërkesë të caktuar, kur për shembull nevojitet të llogariten të gjitha blloqet, ndërsa në rastin e Virtuozzo Storage, regjistrimi i blloqeve të modifikuara bëhet duke përdorur qasjen “log-structured file system”, që minimizon shpenzimet mbi llogaritjen e paritetit. Për të paramenduar përafërsisht opsionet për përshpejtimin e punës me EC dhe pa, ka – numrat mund të jenë përafërsisht të varur nga koeficienti i saktësisë së prodhuesit të pajisjeve, por rezultati i llogaritjeve ndihmon shumë për të planifikuar konfigurimin.
Një skemë e thjeshtë e komponentëve të ruajtjes nuk do të thotë se këta komponentë nuk konsumojnë por nëse llogariten të gjitha shpenzimet paraprakisht, atëherë mund të pritet një bashkëpunim pranë hipervizorit.
Ka një skemë krahasimi të konsumit të burimeve harduerike nga shërbimet Ceph dhe Virtuozzo storage.
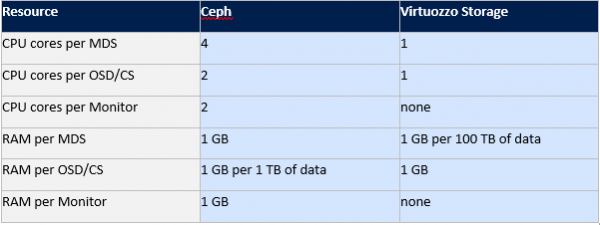
Nëse më parë, krahasimi i Gluster dhe Ceph mund të bëhej sipas artikujve të vjetër, duke përdorur rreshtat më të rëndësishëm prej tyre, tani me Virtuozzo është më e komplikuar. Artikujt për këtë produkt nuk janë aq të shumtë dhe informacioni mund të merret vetëm nga dokumentacioni në ose në rusisht nëse merret parasysh Vstorage si një ruajtje e përdorur në disa zgjidhje hiper të konverguara në kompani si dhe Acronis.
Do ta provoj ndihmoj me përshkrimin e kësaj arkitekture, prandaj teksti do të jetë pak më i gjatë, por për të kuptuar dokumentacionin vetë, kërkohet shumë kohë, dhe dokumentacioni ekzistues mund të përdoret vetëm si referencë duke rishikuar përmbajtjen ose duke kërkuar me fjalë kyçe.
Le të shqyrtojmë procesin e regjistrimit në një konfigurim hibrid të harduerit me komponentët e përshkruar më sipër: regjistrimi fillon në atë nyje nga e cila e iniciatoi klienti (shërbimi i pikës së montimit FUSE), por komponenti kryesor i shërbimit të metadata (MDS) natyrisht do ta drejtojë klientin direkt te shërbimi i çankut që i nevojitet (shërbimi i ruajtjes së blloqeve CS), dmth MDS nuk merr pjesë në procesin e regjistrimit, ai vetëm e drejton atë te shërbimi i nevojshëm të çankut. Në thelb, mund të sjellim një analogji të regjistrimit me derdhjen e ujit në fuçi. Çdo fuçi është një bllok të dhënash prej 256MB.
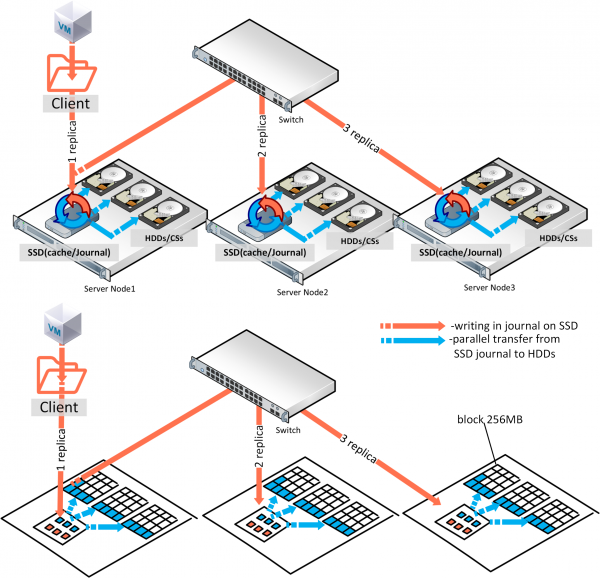
Pra, një disk është një sasi e caktuar e tillë fuçish, dmth vëllimi i diskut është i ndarë në 256MB. Çdo kopje derdhet në një nyje, e dyta pothuajse paralelisht në një nyje tjetër, etj... Nëse kemi tre replika dhe disk SSD për kujtesën (për lexim dhe revista regjistrimi), atëherë konfirmimi i regjistrimit do të ndodhë pas regjistrimit të revistës në SSD, dhe shënimi paralel nga SSD do të vazhdojë në HDD, siç do të ishte në një mënyrë sfond. Në rastin e tre replikave, komiti i regjistrimit do të ndodhë pas konfirmimit nga SSD i nyjës së tretë. Mund të duket se shpejtësia e regjistrimit të tre SSD mund të ndahet në tre dhe do të marrim shpejtësinë e regjistrimit të një replike, por regjistrimi i kopjave ndodh në paralel dhe latency e rrjetit zakonisht është më e lartë se ajo e SSD, dhe në thelb, performanca e regjistrimit do të varet nga rrjeti. Për këtë arsye, për të parë IOPS reale, është e nevojshme të ngarkoni në mënyrë të duhur të gjithë Vstorage sipas , dmth të testoni ngarkesën reale, jo kujtesën dhe кешin, ku duhet të merren parasysh madhësia e saktë e bllokut të të dhënave, numri i rrjedhave etj.
Revista de logare menționată mai sus pe SSD funcționează astfel încât, imediat ce datele ajung în ea, sunt citite de serviciu și scrise pe HDD. Există mai multe servicii de metadate (MDS) pe cluster, iar numărul lor este determinat de cvorumul care funcționează pe baza algoritmului Paxos. Din perspectiva clientului, punctul de montare FUSE este un folder de stocare a clusterului, care este vizibil tuturor nodurilor clusterului, fiecare nod având un client montat conform acestui principiu, astfel încât fiecare nod are acces la acest stocaj.
Pentru performanța oricăruia dintre abordările menționate mai sus, este foarte important, în faza de planificare și desfășurare, să se configureze corect rețeaua în care va avea loc echilibrarea prin agregare și să se selecteze corect lățimea de bandă a canalului de rețea. În agregare, este esențial să se selecteze corect modul de hash și dimensiunile cadrelor. Există, de asemenea, o diferență semnificativă față de SDS-urile menționate mai sus, și anume FUSE cu tehnologia fast path în Virtuozzo Storage. Aceasta, pe lângă FUSE-ul modernizat, în contrast cu celelalte soluții open source, crește semnificativ IOPS-urile și permite scalarea atât orizontală, cât și verticală. În general, comparativ cu arhitecturile menționate anterior, aceasta pare mai puternică, dar pentru acest privilegiu, cu siguranță, este necesar să se achiziționeze licențe, spre deosebire de Ceph și Gluster.
În concluzie, se poate evidenția topul format din trei: primul loc în ceea ce privește performanța și fiabilitatea arhitecturii este ocupat de Virtuozzo Storage, al doilea loc este pentru Ceph, iar al treilea pentru Gluster.
Criteriile pentru care a fost ales Virtuozzo Storage sunt: un set optim de componente ale arhitecturii, FUSE-ul modernizat pentru această abordare cu fast path, un set flexibil de configurație hardware, un consum mai mic de resurse și posibilitatea de a fi utilizat împreună cu compute (calculare/virtualizare), ceea ce îl face complet potrivit pentru o soluție hiperconvergentă, în cadrul căreia este inclus. Al doilea loc este ocupat de Ceph, deoarece este o arhitectură mai performantă comparativ cu Gluster, datorită operării cu blocuri, precum și scenariilor mai flexibile și capacității de a lucra în clustere de dimensiuni mai mari.
Në planet tona është dëshira të shkruajmë një krahasim ndërmjet vSAN, Space Direct Storage, Vstorage dhe Nutanix Storage, për të testuar Vstorage në pajisje HPE, Huawei, si dhe skenarët e integrimit të Vstorage me pajisje të jashtme të SHTM-ve, prandaj nëse ky artikull ju ka pëlqyer, do të ishte mirë të merrnim nga ju komente që mund të forcojnë motivimin për artikuj të rinj, duke pasur parasysh vërejtjet dhe dëshirat tuaja.
Burimi: habr.com
