

Data Science për fillestarët
1. Analiza e Ndjenjave (Analiza e ndjenjave përmes tekstit)
Shikoni implementimin e plotë të projektit Data Science duke përdorur kodin burimor — .
Analiza e Ndjenjave është analiza e fjalëve për të përcaktuar ndjenjat dhe opinioni, të cilat mund të jenë pozitive ose negative. Ky është një tip klasifikimi, ku klasat mund të jenë binare (pozitive dhe negative) ose shumësi (të lumtur, të zemëruar, të trishtuar, të padëshiruar…). Ne do ta realizojmë këtë projekt Data Science në gjuhën R dhe do të përdorim një set të dhënash nga paketa «janeaustenR». Ne do të përdorim fjalorë të përgjithshëm, si AFINN, bing dhe loughran, do të kryejmë bashkimin e brendshëm, dhe në fund do të krijojmë një re fjalësh për të shfaqur rezultatin.
Gjuha: R
Seti i të dhënave/Paketa: janeaustenR
Artikulli është përkthyer me mbështetje nga kompania EDISON Software, e cila , si dhe .
2. Zbulimi i Lajmeve të Rreme (Detektimi i lajmeve të rreme)
Ngjitni aftësitë tuaja në një nivel të ri duke punuar në një projekt Data Science për fillestarët — .
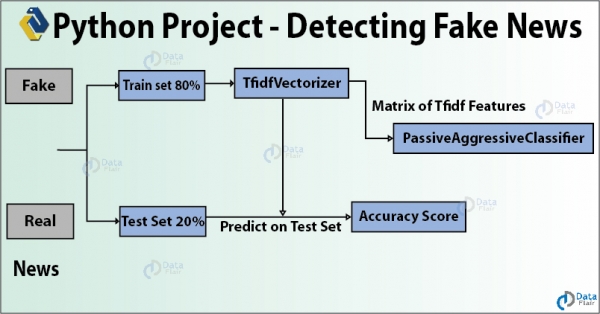
Lajmet e rreme janë informacion i rremë që shpërndahet përmes mediave sociale dhe burimeve të tjera të njohura për përfitime politike. Në këtë ide projekti për Data Science, ne do të përdorim Python për të ndërtuar një model që mund të klasifikojë saktësisht nëse një lajm është i vërtetë ose i rremë. Ne do të krijojmë TfidfVectorizer dhe do të përdorim PassiveAggressiveClassifier për të klasifikuar lajmet në «të vërteta» dhe «të rreme». Ne do të përdorim një set të dhënash me formë 7796 × 4 dhe do të realizojmë gjithçka në Jupyter Lab.
Gjuha: Python
Seti i të dhënave/Paketa: news.csv
3. Zbulimi i Sëmundjes së Parkinsonit (Detektimi i sëmundjes së Parkinsonit)
Përparoni duke punuar në idenë e projektit për Data Science — .
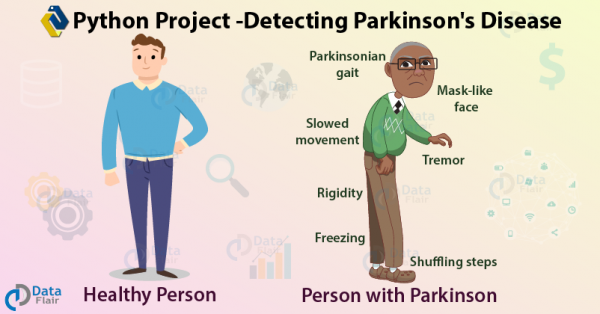
Ne filluam të përdorim Data Science për të përmirësuar shëndetin dhe shërbimet — nëse mund të parashikojmë sëmundjen në fazën fillestare, atëherë do të kemi shumë përfitime. Pra, në këtë ide projekti për Data Science, ne do të mësojmë si të zbulojmë sëmundjen e Parkinsonit me Python. Kjo është një sëmundje neurodegjenerative dhe progresive e sistemit nervor qendror që ndikon në lëvizjen dhe shkakton dridhje dhe ngurtësi. Ajo ndikon në neuronet që prodhojnë dopaminë në trurin, dhe çdo vit, prek më shumë se 1 milion njerëz në Indi.
Gjuha: Python
Seti i të dhënave/Paketa: UCI ML Parkinsons dataset
Projekte të shkencave të të dhënave me kompleksitet të mesëm
4. Njohja e Emoceve nga Zëri (Speech Emotion Recognition)
Shihni implementimin e plotë të projektit të shkencave të të dhënave — .
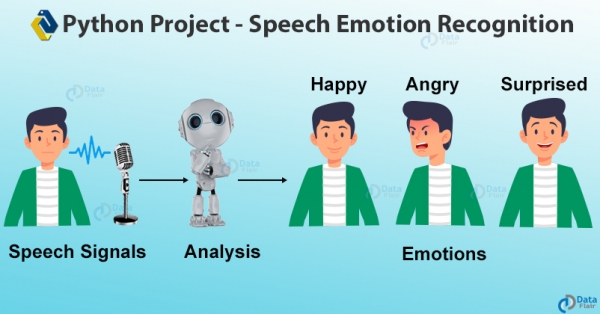
Tani le të mësojmë si të përdorim biblioteka të ndryshme. Ky projekt në shkencat e të dhënave përdor librosa për njohjen e zërit. SER është procesi i përcaktimit të emocioneve dhe gjendjeve afektive të njeriut përmes zërit. Pasiqë ne përdorim tonin dhe lartësinë e tonit për të shprehur emocione me zë, SER është i rëndësishëm. Por pasi që emocionet janë subjektive, annotimi i zërit është një detyrë e komplikuar. Ne do të përdorim funksionet mfcc, chroma dhe mel dhe do të përdorim setin e të dhënave RAVDESS për njohjen e emocioneve. Ne do të krijojmë një klasifikues MLPC për këtë model.
Gjuha: Python
Seti i të dhënave/Paketa: Seti i të dhënave RAVDESS
5. Zbulimi i Gjenit dhe Moshës (Gender and Age Detection)
Impononi punëdhënësit me projektin më të ri në shkencat e të dhënave — .
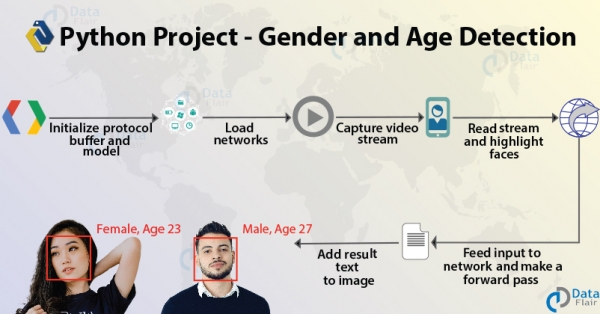
Ky është një projekt interesante në shkencat e të dhënave me Python. Duke përdorur vetëm një imazh, do të mësoni të parashikoni gjenin dhe moshën e një personi. Në këtë projekt, do t'ju njohim me vizionin kompjuterik (Computer Vision) dhe parimet e tij. Ne do të ndërtojmë dhe do të përdorim modelet e trenuara nga Tal Hassner dhe Gil Levi për setin e të dhënave Adience. Gjatë kësaj rruge, do të përdorim disa skedarë .pb, .pbtxt, .prototxt dhe .caffemodel.
Gjuha: Python
Seti i të dhënave/Paketa: Adience
6. Analiza e të Dhënave të Uber (Uber Data Analysis)
Shihni implementimin e plotë të projektit të shkencave të të dhënave me kod burimor — .
Ky projekt është një vizualizim të dhënash me ggplot2, ku ne do të përdorim R dhe bibliotekat e tij për të analizuar parametra të ndryshëm. Ne do të përdorim setin e të dhënave Uber Pickups në New York dhe do të krijojmë vizualizime për kuadro të ndryshme të vitit. Kjo na tregon se si koha ndikon në udhëtimet e klientëve.
Gjuha: R
Seti i të dhënave/Paketa: Seti i të dhënave Uber Pickups në New York City
7. Zbulimi i Gjumit te Shoferëve (Driver Drowsiness Detection)
Përmirësoni aftësitë tuaja duke punuar në projektin kryesor të shkencave të të dhënave — .
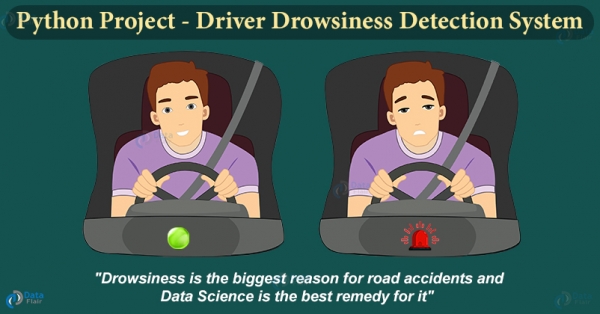
Gjumia gjatë drejtimit është jashtëzakonisht e rrezikshme, dhe çdo vit ndodhin rreth një mijë aksidente për shkak se shoferët bien në gjumë gjatë drejtimit. Në këtë projekt me Python, ne do të krijojmë një sistem që do të jetë në gjendje të zbulojë shoferët e gjumitur dhe t'i njoftojë ata me një sinjal zëri.
Ky ky projekt është realizuar duke përdorur Keras dhe OpenCV. Ne do të përdorim OpenCV për të identifikuar fytyrën dhe sytë, dhe me Keras do të klasifikojmë gjendjen e syrit (Të Hapura ose Të Mbyllura) duke përdorur metoda të rrjeteve neuronale të thella.
8. Chatbot
Krijoni një chatbot me Python dhe bëni një hap përpara në karrierën tuaj — .
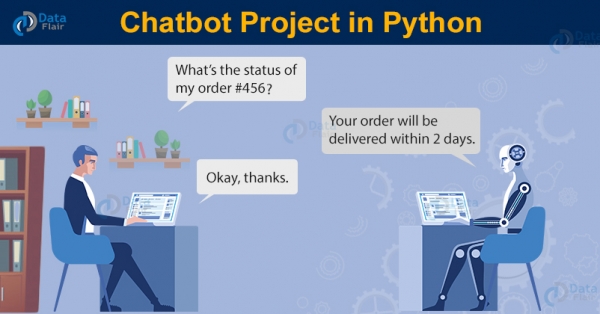
Chatbotët janë një pjesë e pamundur e biznesit. Shumë biznese duhet të ofrojnë shërbime për klientët e tyre, dhe për të mbështetur këtë kërkohet shumë forcë pune, kohë dhe përpjekje. Chatbotët mund të automatizojnë një pjesë të madhe të ndërveprimit me klientët, duke u përgjigjur disa pyetjeve të shpeshta që bëjnë klientët. Në thelb ka dy lloje chatbot-ësh: Domain-specific dhe Open-domain. Chatbotët Domain-specific përdoren shpesh për të zgjidhur një problem specifik. Prandaj, ju duhet ta konfiguroni atë për të punuar në mënyrë efektive në fushën tuaj. Chatbotët Open-domain mund t’u bëjnë çdo lloj pyetje, prandaj për trajnimin e tyre kërkohet një sasi e madhe të dhënash.
Grupi i të dhënave: Skedari intents json
Gjuha: Python
Projekte të avancuara të Shkencës së të Dhënave
9. Gjeneratori i përshkrimeve të imazheve
Kontrolloni realizimin e plotë të projektit me kodin burimor — .
Përshkrimi i asaj që ndodhet në një imazh është një detyrë e lehtë për njerëzit, por për kompjuterët, imazhi është thjesht një grup numrash që përfaqësojnë vlerën e ngjyrës për secilin piksel. Kjo është një detyrë e vështirë për kompjuterët. Të kuptosh se çfarë ndodhet në një imazh dhe më pas të krijosh një përshkrim në një gjuhë natyrore (për shembull, në anglisht) është një tjetër detyrë e vështirë. Ky projekt përdor metoda të mësimit të thellë, ku ne zbatojmë një Rrëke Neurale Konvolucionale (CNN) me një Rrëke Neurale Recurrente (LSTM) për të krijuar një gjenerator përshkrimesh për imazhe.
Grupi i të dhënave: Flickr 8K
Gjuha: Python
Framework: Keras
10. Identifikimi i Mashtrimit me Kartat e Kreditit
Bëni gjithçka që është e mundur duke punuar mbi idenë e projektit të Shkencës së të Dhënave — .
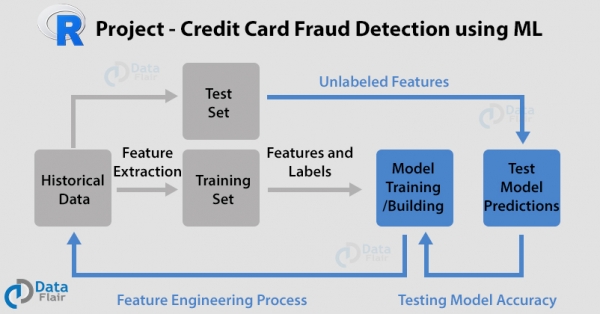
Derisa të arritni tani, ju keni filluar të kuptoni metodat dhe konceptet. Le të kalojmë në disa projekte të avancuara në shkencën e të dhënave. Në këtë projekt, ne do të përdorim gjuhën R me algoritma të tillë si , regresioni logjistik, rrjetet neurale artificiale dhe klasifikuesi i fuqisë gradienti. Ne do të përdorim një grup të dhënash për transaksionet me karta, për të klasifikuar transaksionet e kartave të kreditit si mashtruese dhe të vërteta. Ne do t'i përshtatim atyre modele të ndryshme dhe do të ndjekim kurbat e performancës.
Gjuha: R
Seti i të dhënave/Paketa: Grupi i të dhënave për Transaksionet me Karta
11. Sistemi i Rekomandimeve për Filma
Studio realizimin e projektit më të mirë të Data Science me Kodin Burimor —
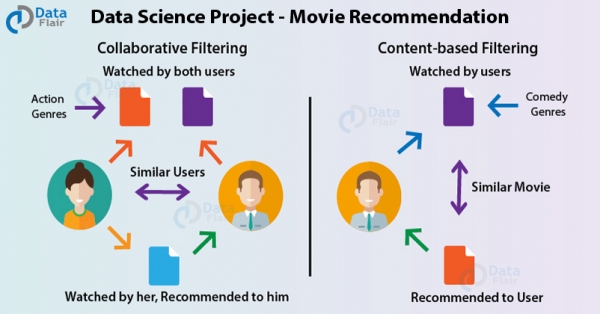
Në këtë projekt të Data Science, ne do të përdorim R për të ofruar rekomandime filmash përmes mësimit të makinerive. Sistemi i rekomandimeve dërgon sugjerime përdoruesve përmes një procesi filtrimi, të bazuar në preferencat e përdoruesve të tjerë dhe historinë e shikimeve. Nëse A dhe B i pëlqen Home Alone, dhe B e do Mean Girls, atëherë mund t'i sugjerohet A — ata gjithashtu mund t'i pëlqejnë. Kjo lejon klientët të interaktin me platformën.
Gjuha: R
Seti i të dhënave/Paketa: Grupi i të dhënave të MovieLens
12. Segmentimi i Klientëve
Bëni një përshtypje tek punëdhënësit me projektin e Data Science (duke përfshirë kodin burimor) — .
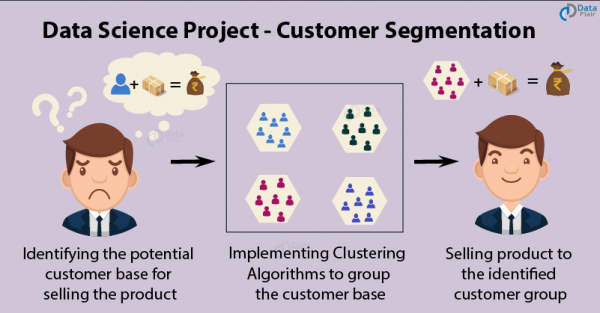
Segmentimi i klientëve është një aplikacion popullor Duke përdorur klasterizimin, kompanitë përcaktojnë segmente klientësh për të punuar me bazën e potenciale të përdoruesve. Ato ndajnë klientët në grupe sipas karakteristikave të zakonshme, si gjinia, mosha, interesat dhe zakonet e shpenzimit, në mënyrë që të mund të shesin produktet e tyre me efikasitet për çdo grup. Ne do të përdorim , si dhe do të vizualizojmë shpërndarjen sipas gjinive dhe moshës. Më pas do të analizojmë të ardhurat vjetore dhe nivelin e shpenzimeve të tyre.
Gjuha: R
Seti i të dhënave/Paketa: Grupi i të dhënave të Mall_Customers
13. Klasifikimi i Kancerit të Gjirit
Shikoni realizimin e plotë të projektit të Data Science në Python — .
Duke u kthyer në kontributin mjekësor të shkencave të dhënave, le të mësojmë të identifikojmë kancerin e gjirit me ndihmën e Python. Ne do të përdorim setin e të dhënave IDC_regular për të identifikuar karcinomën invazive të kanaleve, formën më të zakonshme të kancerit të gjirit. Ai zhvillohet në kanalet e gjirit, duke u përhapur në indin fibror ose yndyror të gjirit përtej kanalit. Në këtë ide të projektit shkencor për mbledhjen e të dhënave do të përdorim dhe bibliotekën Keras për klasifikim.
Gjuha: Python
Seti i të dhënave/Paketa: IDC_regular
14. Njohja e Shenjave Trafiku
Arritja e saktësisë në teknologjinë e vetë-ndihmës për vozitjen e automjeteve përmes një projekti Shkencë të Dhënash për me burim të hapur.
Shenjat e trafikut dhe rregullat e qarkullimit janë shumë të rëndësishme për çdo vozitës për të shmangur aksidentet. Për të ndjekur rregullin, fillimisht duhet të kuptohet se si duket një shenjë trafiku. Njerëzit duhet të mësojnë të gjitha shenjat e trafikut përpara se t'u jepet leja për të drejtuar ndonjë mjet. Por tani numri i automjeteve autonome po rritet, dhe në të ardhmen e afërt njerëzit ndoshta nuk do të drejtojnë makinën më vetë. Në projektin “Njohja e Shenjave Trafikut” do të mësoni si një program mund të identifikojë llojin e shenjave të trafikut duke pranuar një imazh si hyrje. Seti i të dhënave për njohjen e shenjave të trafikut në Gjermani (GTSRB) përdoret për të ndërtuar një rrjet të thellë nervor për të njohur klasën e shenjës së trafikut. Ne gjithashtu krijojmë një ndërfaqe grafike të thjeshtë për ndërveprimin me aplikacionin.
Gjuha: Python
Grupi i të dhënave: GTSRB (Benchmark për Njohjen e Shenjave të Trafikut në Gjermani)
Lexo më shumë
Burimi: habr.com
