

Studiuesit e sigurisë nga Microsoft kanë zhvilluar teknikën e sulmit përmes kanaleve anësore Whisper Leak, e cila mundëson, mbi bazën e analizës pasive të trafikut të enkriptuar të transmetuar përmes një lidhjeje TLS, klasifikimin e temave të kërkesave drejt shërbimeve të bazuara në modele të mëdha gjuhësore. Informacioni për madhësinë e paketave të rrjetit dhe vonesat mes transmetimit të tyre rezultoi i mjaftueshëm për të përcaktuar temat e kërkesave ndaj AI-chatbotëve me saktësi mbi 98%. Në praktikë, metoda e propozuar mund të përdoret për të zbuluar në trafikun transit të përdoruesit tema të caktuara të kërkesave, për shembull përpjekje për të marrë informacion mbi veprime të paligjshme, pa deshifruar përmbajtjen.
Veglat për nxjerrjen e të dhënave nga dump-et e trafikut, trajnimin e modelit dhe testimin e funksionimit të metodës janë publikuar në GitHub. Mundësia e kryerjes së sulmit është demonstruar për 28 modele të mëdha gjuhësore të njohura nga prodhuesit kryesorë. Për shembull, saktësia e identifikimit të kërkesave me temën «pastrim parash» për shumë shërbime AI arriti në 100%, kur në trafikun e analizuar kishte 1 kërkesë të synuar dhe 10000 kërkesa që nuk kishin lidhje me temën përkatëse.
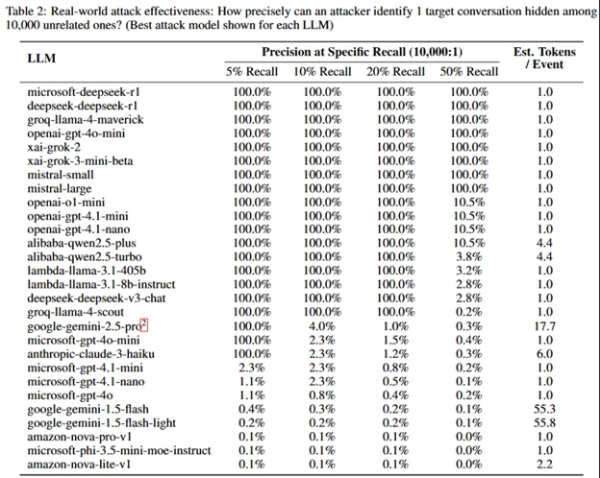
Shkaku i rrjedhjes së informacionit qëndron në faktin se modelet gjenerojnë përgjigjen ndaj kërkesës hap pas hapi, nga një token në të njëjtën kohë, duke përdorur në çdo hap tokenin e mëparshëm si kontekst për të përcaktuar fjalën ose frazën tjetër më të mundshme. Si rrjedhojë, për çdo token dërgohet një paketë e veçantë rrjeti dhe vonesa mes paketave korrespondon me vonesën mes përcaktimit nga modeli të tokenit pasues.
Në TLS, nëse nuk përdoret kompresimi i të dhënave, madhësia e tekstit të enkriptuar është e barabartë me madhësinë e tekstit të paenkriptuar plus një konstante. Gjatë krijimit të një modeli që lidh grupet e synuara të tokenëve me madhësinë e paketave dhe vonesat mes dërgimit të tyre, mund të përcaktohet me saktësi mjaft të lartë prania e temave të kërkuara në trafik. Në kuadër të studimit janë përgatitur tre variante të tilla modelesh të mësimit makinerik, të bazuara në arkitekturat e rrjeteve neurale LightGBM, Bi-LSTM dhe BERT. Për secilin model janë kryer eksperimente për identifikimin e temës së kërkuar duke analizuar vetëm madhësinë e paketave, vetëm vonesat mes paketave dhe të dy kriteret së bashku.
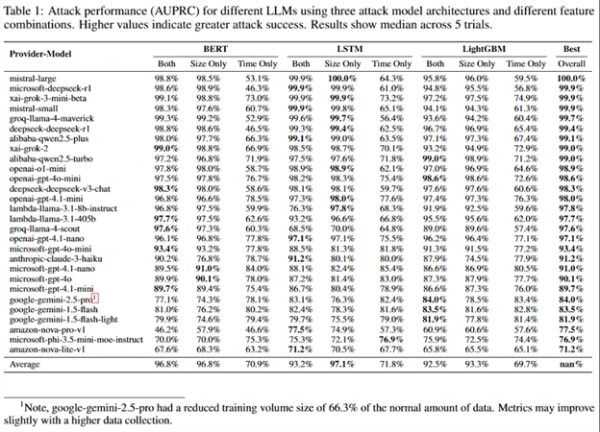
Për të ulur efektivitetin e analizës pasive të tematikës së kërkesave, zhvilluesve të shërbimeve AI u është propozuar të shtojnë mbushje të rastësishme shtesë, të buferojnë transmetimin e tokenëve ose të përdorin paketa fiktive.
Burimi: opennet.ru
