

Nata shkova në një material interesant mbi inteligjencën artificiale në lojëra. Me shpjegime të koncepteve bazë mbi AI në shembuj të thjeshtë, dhe gjithashtu përmban shumë mjete dhe metoda të dobishme për zhvillimin dhe projektimin e tij të përshtatshëm. Si, ku dhe kur t'i përdorësh ato — gjithashtu është aty.
Shumica e shembujve janë shkruar në pseudokod, kështu që njohuri të thella mbi programimin nuk do të nevojiten. Poshtë keni 35 faqe teksti me imazhe dhe GIF-e, kështu që përgatituni.
UPD. Më vjen keq, por kam bërë tashmë një përkthim të këtij artikulli në Habra. . Mund ta lexoni versionin e tij. , por për ndonjë arsye artikulli më ka shpëtuar (kam përdorur kërkimin, por diçka nuk shkoi siç duhet). Dhe duke qenë se shkruaj në një blog të dedikuar zhvillimit të lojërave, vendosa të lë versionin tim të përkthimit për ndjekësit (disa momente janë formuluar ndryshe, disa — janë lënë qëllimisht jashtë sipas këshillave të zhvilluesve).
Çfarë është inteligjenca artificiale?
Inteligjenca artificiale e lojërave përqendrohet në veprimet që një objekt duhet të kryejë, në varësi të kushteve në të cilat ndodhet. Kjo zakonisht quhet menaxhimi i "agjentëve inteligjentë", ku agjenti është një personazh loje, një mjet, një bot, dhe ndonjëherë edhe diçka më abstrakte: një grup i tërë entitetesh ose madje një civilization. Në çdo rast, kjo është diçka që duhet të shohë mjedisin e saj, të marrë vendime në përputhje me të, dhe të veprojë në përputhje me ato. Ky proces quhet cikli Sense/Think/Act (Ndjeni/Mendoni/Vepra):
- Sense: agjenti gjen ose merr informacion mbi gjërat në mjedisin e tij që mund të ndikojnë në sjelljen e tij (kërcënime në afërsi, objekte për t'u mbledhur, vende interesante për tu eksploruar).
- Think: agjenti vendos si të reagojë (vlerëson nëse është mjaft e sigurt të mbledhë objekte ose nëse duhet fillimisht të luftojë/zhvillohet).
- Act: agjenti kryen veprime për të realizuar vendimin e mëparshëm (nisi lëvizjen drejt armikut ose objektit).
- …tani situata ka ndryshuar për shkak të veprimeve të personazheve, kështu që cikli përsëritet me informacion të ri.
AI, në përgjithësi, përqendrohet në pjesën Sense të ciklit. Për shembull, makinat autonome bëjnë fotografi të rrugës, i kombinojnë ato me të dhënat e radarit dhe lidarit, dhe interpretojnë. Zakonisht, kjo bëhet nga mësimi makinerik, i cili përpunon të dhënat hyrëse dhe u jep kuptim atyre, duke nxjerrë informacion semantik si "ka një makinë tjetër 20 hapa përpara jush". Këto quhen probleme klasifikimi.
Lojërat nuk kanë nevojë për një sistem të komplikuar për të nxjerrë informacion, pasi shumica e të dhënave tashmë është një pjesë e pandashme e saj. Nuk ka nevojë të ekzekutohen algoritme njohjeje të imazheve për të përcaktuar nëse ka një armik përpara — loja tashmë e di dhe e transmeton informacionin direkt në procesin e vendimmarrjes. Prandaj, pjesa e ciklit Sense shpesh është shumë më e thjeshtë se Think dhe Act.
Kufizimet e IA në lojëra
IA ka një sërë kufizimesh që duhet të respektohen:
- IA nuk ka nevojë të trajnohet paraprakisht, siç bëhet me algoritmet e mësimit makinerik. Është pa kuptim të shkruash një rrjet nervor gjatë zhvillimit për të vëzhguar dhjetëra mijëra lojtarë dhe për të studiuar mënyrën më të mirë të lojës kundër tyre. Pse? Sepse loja nuk është lëshuar, dhe nuk ka lojtarë.
- Loja duhet të argëtojë dhe të sfidojë, prandaj agjentët nuk duhet të gjejnë qasjen më të mirë kundër njerëzve.
- Agjentët duhet të duken realistikë, në mënyrë që lojtarët të ndihen sikur po luajnë kundër njerëzve të vërtetë. Programi AlphaGo e kaloi njeriun, por hapat e zgjedhur ishin shumë larg kuptimit tradicional të lojës. Nëse loja imiton një kundërshtar njeri, një ndjenjë e tillë nuk duhet të ekzistojë. Algoritmi duhet të ndryshohet për të marrë vendime të besueshme, e jo ideale.
- IA duhet të punojë në kohë reale. Kjo do të thotë se algoritmi nuk mund të monopolizojë përdorimin e procesorit për një kohë të gjatë për të marrë vendime. Edhe 10 milisekonda për këtë — është shumë gjatë, sepse shumicës së lojërave u mjaftojnë nga 16 në 33 milisekonda për të kryer të gjithë përpunimin dhe për t'u kaluar në kadrin e ardhshëm të grafikës.
- Idealisht, ndonjë pjesë e sistemit duhet të drejtohet nga të dhënat, kështu që "not-koduesit" mund të bëjnë ndryshime, dhe që rregullimet të ndodhin më shpejt.
Le të shqyrtojmë qasje të IA që mbulojnë gjithë ciklin Sense/Think/Act.
Marrja e vendimeve bazike
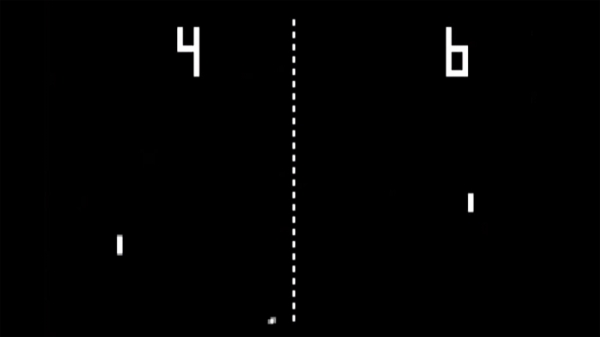
Të fillojmë me lojën më të thjeshtë — Pong. Qëllimi: të lëvizni platformën (paddle) në mënyrë që topi të riciklohet nga ajo dhe të mos kalojë përmes. Kjo është si tenisi, në të cilin humbni nëse nuk e godisni topin. Këtu, AI ka një detyrë relativisht të lehtë — të vendosë në cilën drejtim të lëvizë platformën.
Operatorët e kushtëzuar
Për AI në Pong, zgjidhja më e dukshme është të përpiqet gjithmonë të vendosë platformën poshtë topit.
Një algoritëm i thjeshtë për këtë, i shkruar në pseudokod:
çdo kornizë/përditësim ndërsa lojtaria është duke u luajtur:
nëse topi është në të majtë të paddle:
lëviz platformën në të majtë
ndryshe nëse topi është në të djathtë të paddle:
lëviz platformën në të djathtë
Nëse platforma lëviz me shpejtësinë e topit, atëherë ky është algoritmi ideal për AI në Pong. Nuk ka nevojë ta komplikohet, nëse të dhënat dhe veprimet e mundshme për agentin nuk janë shumë.
Ky qasje është aq e thjeshtë, saqë e gjithë cikli Sense/Think/Act është pothuajse i padukshëm. Por ai është aty:
- Pjesa Sense është në dy operatorët if. Loja di se ku është topi dhe ku është platforma, kështu që AI i referohet asaj për këtë informacion.
- Pjesa Think përfshin gjithashtu dy operatorë if. Ato përfaqësojnë dy zgjidhje, të cilat në këtë rast janë ekskluzive. Si rezultat, përzgjidhet një nga tre veprimet — të lëvizni platformën në të majtë, të lëvizni në të djathtë, ose të mos bëni asgjë, nëse ajo tashmë është pozicionuar siç duhet.
- Pjesa Act ndodhet në operatorët Move Paddle Left dhe Move Paddle Right. Në varësi të dizajnit të lojës, ato mund të lëvizin platformën menjëherë ose me një shpejtësi të caktuar.
Qasje të tilla quhen reaguese — ka një grup të thjeshtë rregullash (në këtë rast operatorë if në kod), të cilat reagojnë ndaj gjendjes aktuale të botës dhe veprojnë.
Pema e vendimeve
Shembulli i lojës Pong në fakt është i barabartë me konceptin formal të AI, të quajtur pema e vendimeve. Algoritmi kalon përmes saj për të arritur në «gjethe» — një vendim se cilin veprim të marrë.
Të bëjmë një diagram rrjedhe për pemën e vendimeve për algoritmin tonë të platformës:
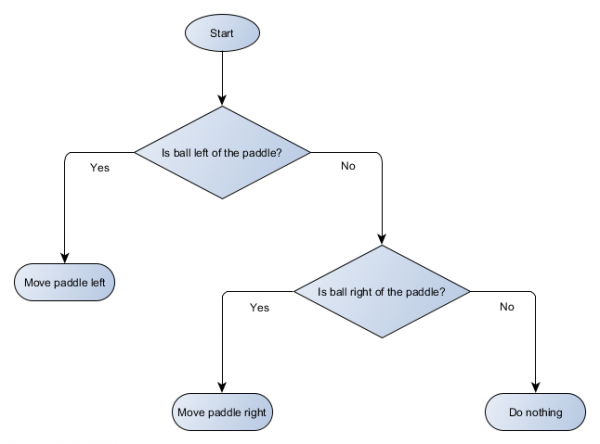
Çdo pjesë e pemës quhet node (nyje) — AI përdor teorinë e grafikëve për të përshkruar struktura të tilla. Ka dy lloje nyjesh:
- Nyjet e vendimmarrjes: zgjedhja midis dy alternativave në bazë të kontrollit të ndonjë kushti, ku çdo alternativë përfaqësohet si një nyje e veçantë.
- Nyjet përfundimtare: veprimi për të kryer, duke përfaqësuar vendimin përfundimtar.
Algoritmi fillon me nodin e parë (“rrënjën” e pemës). Ai ose merr një vendim nëse të kalojë në nodin fëmijë, ose kryen veprimin që është ruajtur në nod, dhe përfundon.
Cilado qoftë përfitimi, nëse pemët e vendimeve bëjnë të njëjtën punë si operatorët if në seksionin e mëparshëm? Këtu ekziston një sistem i përbashkët, ku çdo vendim ka vetëm një kusht dhe dy rezultate të mundshme. Kjo e lejon zhvilluesin të krijojë AI nga të dhënat që përfaqësojnë vendimet në pemë, duke shmangur kodimin e tij të vështirë. Le ta paraqesim në formën e një tabeli:
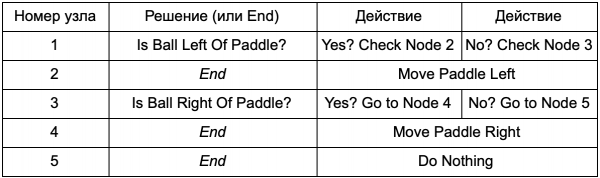
Në anën e kodit do të merrni një sistem për të lexuar rreshta. Krijoni një nod për secilin prej tyre, lidheni logjikën e vendimeve në bazë të kolonës së dytë dhe nodet fëmijë në bazë të kolonave të tretë dhe të katërt. Ju ende duhet të programoni kushtet dhe veprimet, por tani struktura e lojës do të jetë më e komplikuar. Në të, ju shtoni vendime dhe veprime shtesë, dhe më pas konfiguroni tërë AI-në duke redaktuar thjesht një skedë me definicionin e pemës. Pastaj e kaloni skedën dizajnerit të lojës, i cili do të jetë në gjendje të ndryshojë sjelljen pa ribashkimin e lojës dhe ndryshimin e kodit.
Pemët e vendimeve janë shumë të dobishme kur ndërtohen automatikisht mbi bazën e një grupi të madh shembujsh (p.sh. duke përdorur algoritmin ID3). Kjo i bën ato një mjet efektiv dhe të lartë në performancë për klasifikimin e situatave në bazë të të dhënave të marra. Sidoqoftë, ne po dalim jashtë një sistemi të thjeshtë për zgjedhjen e veprimeve nga agjentët.
Skenarët
Ne kemi shqyrtuar sistemin e pemëve të vendimeve, i cili përdorte kushte dhe veprime të krijuara përpara. Njeriu që projektan AI-në mund të organizojë pemën siç dëshiron, por ai ende duhet të mbështetet tek programuesi që e ka koduar atë të gjithë. Çfarë nëse do të mund të jepnim dizajnerit mjete për të krijuar kushtet ose veprimet e tij të veta?
Për të mos bërë që programuesi të shkruajë kod për kushtet Is Ball Left Of Paddle dhe Is Ball Right Of Paddle, ai mund të krijojë një sistem, ku dizajneri do të regjistrojë kushtet për të kontrolluar këto vlera. Atëherë të dhënat e pemës së vendimeve do të duken kështu:
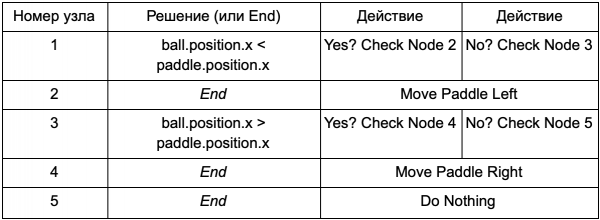
Në thelb, kjo është e njëjtë me tabelën e parë, por zgjidhjet përmbajnë kodin e tyre të brendshëm, paksa të ngjashëm me pjesën kushtore të if-operatorit. Në anën e kodit, kjo do të lexohesh në kolumnën e dytë për node-t e vendimmarrjes, por në vend që të kërkojë një kusht specifik për tu ekzekutuar (A është topi majtas nga paddle), vlerëson shprehjen kushtore dhe kthen true ose false përkatësisht. Kjo bëhet me ndihmën e gjuhëve skriptuese Lua ose Angelscript. Me ndihmën e këtyre, zhvilluesi mund të marrë objektet në lojën e tij (topi dhe paddle) dhe të krijojë variabla që do të jenë të disponueshme në skenar (topi.position). Për më tepër, gjuha e skriptimit është më e thjeshtë se C++. Ajo nuk kërkon një fazë të plotë kompilimi, duke e bërë atë ideale për rregullime të shpejta të logjikës së lojës dhe i lejon "nëbrendësit" të krijojnë vetë funksionet e nevojshme.
Në shembullin e dhënë, gjuha e skripteve përdoret vetëm për vlerësimin e shprehjes kushtore, por ajo mund të përdoret gjithashtu për veprime. Për shembull, të dhënat Move Paddle Right mund të bëhen një operator skenari (topi.position.x += 10). Kështu, që veprimi gjithashtu të përcaktohet në skenar, pa pasur nevojë për programimin e Move Paddle Right.
Mund të shkojmë edhe më larg dhe të shkruajmë plotësisht një pemë vendimmarrjeje në gjuhën e skripteve. Kjo do të ishte kod në formën e operatorëve kushtorë të programuar fort (hardcoded), por ata do të ndodheshin në skedarë të jashtëm të skriptimit, dmth mund të ndryshoheshin pa kompaktimin e tërë programit. Shpesh mund të ndryshoni skedarin e skenarit direkt në lojë, për të testuar shpejt reagimet e ndryshme të AI.
Reagimi ndaj ngjarjeve
Shembujt e mësipërm i përshtaten perfekt Pong. Ata vazhdimisht ekzekutojnë ciklin Sense/Think/Act dhe veprojnë në bazë të gjendjes së fundit të botës. Por në lojëra më të ndërlikuara, duhet të reagosh ndaj ngjarjeve të veçanta, dhe jo të vlerësosh gjithçka menjëherë. Pong, në këtë rast, nuk është më një shembull i mirë. Le të zgjidhim një tjetër.
Imagjinoni një lojë qëllimi, ku armiqtë janë të palëvizur derisa të zbulojnë lojtarin, pas së cilës veprojnë sipas "specializimit" të tyre: dikush do të niset për të "goditur", ndonjë do të sulmojë nga larg. Kjo është ende një sistem reagues themelor — "nëse lojtari është vënë re, bëj diçka" — por mund të ndahet logjikisht në ngjarjen Player Seen (lojtari i zbuluar) dhe reagimin (zgjidhni një përgjigje dhe ekzekutoni atë).
Kjo na kthen në ciklin Sense/Think/Act. Mund të kodojmë pjesën Sense që çdo kornizë do të kontrollojë — a e sheh AI lojtarin. Nëse jo — nuk ndodh asgjë, por nëse e sheh, krijohet një ngjarje Player Seen. Kodi do të ketë një seksion të veçantë, ku thuhet: "kur ndodh ngjarja Player Seen, bëj", ku — është reagimi që ju nevojitet për t'u drejtuar në pjesët Think dhe Act. Kështu do të vendosni reagimet për ngjarjen Player Seen: për një personazh "të ngutshëm" — ChargeAndAttack, dhe për një snajper — HideAndSnipe. Këto lidhje mund të krijohen në skedarin e të dhënave për redaktim të shpejtë pa nevojën për të rifilluar kompaktimin. Dhe gjithashtu mund të përdoren gjuhët e scripting.
Marrja e vendimeve të ndërlikuara
Ndërsa sistemet e thjeshta të reagimit janë shumë efektive, ka shumë situata kur ato janë të pamjaftueshme. Ndonjëherë është e nevojshme të pranoni vendime të ndryshme, duke u bazuar në atë që agjenti po bën në atë moment, por ta paraqitni atë si një kusht është e vështirë. Ndonjëherë ka shumë kushte për t'i paraqitur në mënyrë efektive në një pemë vendimesh ose skript. Ndonjëherë është e nevojshme të vlerësohet përpara se si do të ndryshojë situata, përpara se të merret një vendim për hapat e ardhshëm. Për të zgjidhur këto probleme, janë të nevojshme qasje më të ndërlikuara.
Makinë e Shteteve të Finit
Makinë e Shteteve të Finit ose FSM (finito automat) — është një mënyrë për të thënë se agjenti ynë aktualisht ndodhet në një nga disa shtete të mundshme dhe se ai mund të kalojë nga njëra gjendje në tjetrën. Shumë shtete janë të përcaktuara — prej andej dhe emri. Një shembull më i mirë nga jeta është sinjali i trafikut. Në vende të ndryshme, sekufencat e ndryshme të dritave, por principi është i njëjtë — çdo gjendje përfaqëson diçka (ndal, shko etj.). Sinjali i trafikut është gjithmonë në një gjendje në çdo moment kohor, dhe kalon nga njëra në tjetrën në bazë të rregullave të thjeshta.
Me NPC-të në lojëra është një histori e ngjashme. Për shembull, le të marrim një roje me këto gjendje:
- Patrullues (Patrolling).
- Duke sulmuar (Attacking).
- Duke ikur (Fleeing).
Dhe këto kushte për ndryshimin e gjendjes së tij:
- Nëse roja sheh armikun, ai sulmon.
- Nëse roja sulmon, por nuk sheh më armikun, ai kthehet në patrullim.
- Nëse roja sulmon, por është rëndë i plagosur, ai ikën.
Igualmente, mund të shkruajmë if-operatorë me një variabël-stanjë roje dhe kontrollime të ndryshme: a ka ndonjë armik afër, cilat janë nivelet e shëndetit të NPC-ve, etj. Do të shtojmë disa gjendje të tjera:
- Mosveprimi (Idling) — ndërmjet patrullave.
- Kërkimi (Searching) — kur armiku i parë është fshehur.
- Kërkesa për ndihmë (Finding Help) — kur armiku është parë, por është shumë i fortë për t'u luftuar një me një.
Zgjedhja për secilin prej tyre është e kufizuar — për shembull, rojet nuk do të shkojnë të kërkojnë armikun e fshehur nëse kanë shëndet të ulët.
Në fund të fundit, lista e madhe e "nëse <x и y, но не z>, nuk është e nevojshme, madje, ajo jep një gabim sintaksor <p>", mund të bëhet shumë e ngarkuar, prandaj duhet të formulojmë një metodë që do të na mundësojë të mbajmë mend gjendjet dhe kalimet midis gjendjeve. Për ta bërë këtë, do të marrim parasysh të gjitha gjendjet dhe nën çdo gjendje do të regjistrojmë në një listë të gjitha kalimet në gjendje të tjera, së bashku me kushtet e nevojshme për to.
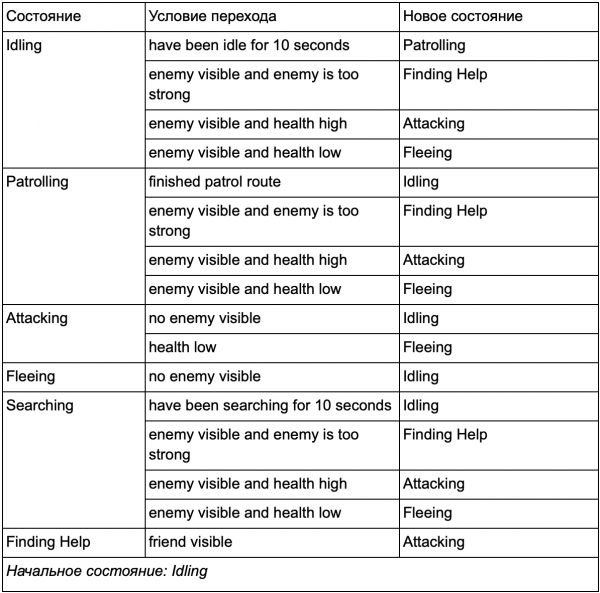
Ky është një tabelë e kalimeve të gjendjeve — një mënyrë komplekse për të paraqitur FSM. Do të vizatojmë një diagram dhe do të marrim një pasqyrë të plotë të sjelljes së NPC-ve.
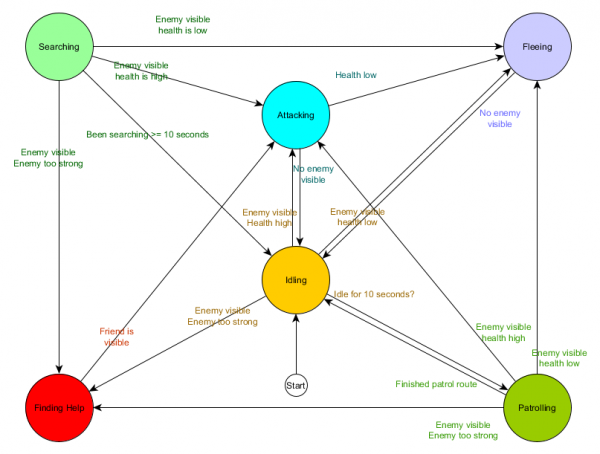
Diagrami reflekton thelbin e marrjes së vendimeve për këtë agjent në bazë të situatës aktuale. Çdo shigjetë tregon kalimin ndërmjet gjendjeve, nëse kushte afër saj janë të vërteta.
Në çdo përditësim ne kontrollojmë gjendjen aktuale të agjentit, shikojmë listën e kalimeve, dhe nëse kushtet për kalim janë të përmbushura, ai merr një gjendje të re. Për shembull, çdo kadër kontrollohet nëse ka mbaruar një timer 10-sekondësh, dhe nëse po, nga gjendja Idling, rojet kalojnë në Patrullim. Në të njëjtën mënyrë, gjendja Sulmimi kontrollon shëndetin e agjentit — nëse është i ulët, ai kalon në gjendjen Ikja.
Kjo është përpunimi i kalimeve ndërmjet gjendjeve, por si për sjelljen e lidhur me vetë gjendjet? Sa i përket implementimit të sjelljes reale për një gjendje të veçantë, zakonisht ka dy lloje «krapi», ku ne disa veprime i atribuojmë FSM:
- Veprimet që ne i kryejmë periodikisht për gjendjen aktuale.
- Veprimet që ne ndërmarrim kur kalojmë nga një gjendje në njërën tjetër.
Shembuj për llojin e parë. Gjendja Patrullimi çdo kadër do të lëvizë agjentin nëpër itinerarin e patrullimit. Gjendja Sulmimi çdo kadër do të përpiqet të fillojë një sulm ose të kalojë në gjendjen kur kjo është e mundur.
Për tipin e dytë, le të shqyrtojmë kalimin «nëse armiku është i dukshëm dhe armiku është shumë i fortë, atëherë të kalojmë në gjendjen e Gjetjes së Ndihmës. Agjenti duhet të zgjedhë se ku të shkojë për ndihmë dhe të ruajë këtë informacion, në mënyrë që gjendja e Gjetjes së Ndihmës të dijë ku të drejtohet. Sapo të gjendet ndihma, agjenti kthehet në gjendjen e Sulmit. Në këtë moment, ai do të dojë të tregojë aleatit për kërcënimin, prandaj mund të ndodhi veprimi InformoAleatinPërKërcënimin.
Përsëri, ne mund ta shohim këtë sistem përmes ciklit Ndjej/Mendoj/Veproj. Ndjeni manifestohet në të dhënat që përdoren nga logjika e kalimit. Mendoj — kalimet që janë të disponueshme në çdo gjendje. Dhe Veprojmë realizohet nga veprimet që kryhen përherë brenda gjendjes ose në kalimet midis gjendjeve.
Ndonjëherë, sondazhi i vazhdueshëm i kushteve të kalimit mund të jetë i kushtueshëm. Për shembull, nëse çdo agjent do të kryejë llogaritje të komplikuara për çdo kornizë për të përcaktuar nëse sheh armikë dhe të kuptojë nëse mund të kalojë nga gjendja e Patrullimit në Sulm — kjo do të kërkonte shumë kohë procesori.
Ndryshimet e rëndësishme në gjendjen e botës mund të konsiderohen si ngjarje që do të përpunohen ndërsa ndodhin. Në vend që FSM të kontrollojë kushtin e kalimit «a mundet agjenti im ta shikojë lojtarin?» çdo kornizë, është e mundur të konfigurohet një sistem i veçantë për të kryer kontrollet më rrallë (për shembull, 5 herë në sekondë). Dhe rezultati do të jetë Lojtari i Dëshmuar, kur kontrolli kalon.
Kjo i kalon në FSM, i cili tani duhet të kalojë në kushtin e përfunduar të ngjarjes Lojtari i Dëshmuar dhe të reagojë në përputhje me rrethanat. Sjellja përfundimtare është e njëjtë përveç një vonese pothuajse të padukshme përpara përgjigjes. Megjithatë, performanca është përmirësuar si rezultat i ndarjes së pjesës së Ndjenjës në një pjesë të veçantë të programit.
Makinë e kufizuar e gjendjes hierarkike
Megjithatë, punimi me FSM të mëdha nuk është gjithmonë i përshtatshëm. Po të dëshironim të zgjerojmë gjendjen e sulmit, duke e zëvendësuar atë me të veçanta MeleeAttacking (sulm a pranë) dhe RangedAttacking (sulm nga larg), do të duhet të ndryshonim kalimet nga të gjitha gjendjet e tjera që çojnë në gjendjen e Sulmit (të tanishmet dhe të ardhshmet).
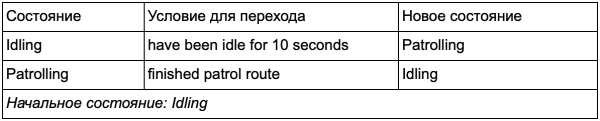
Sigurisht keni vënë re se në shembullin tonë ka shumë kalime të përsëritura. Shumica e kalimeve në gjendjen Idling janë identike me kalimet në gjendjen Patrolling. Do të ishte e mençur të shmangnim përsëritjen, veçanërisht nëse do të shtojmë më shumë gjendje të ngjashme. Ka kuptim të grupojmë Idling dhe Patrolling nën një etiketë të përbashkët "jo-luftarak", ku ka vetëm një grup të përbashkët kalimesh në gjendjet luftuese. Nëse e imagjinojmë këtë etiketë si një gjendje, atëherë Idling dhe Patrolling do të bëhen nën-gjendje. Një shembull i përdorimit të një tabele kalimesh të veçantë për një nën-gjendje jo-luftarake:
Gjendjet kryesore:
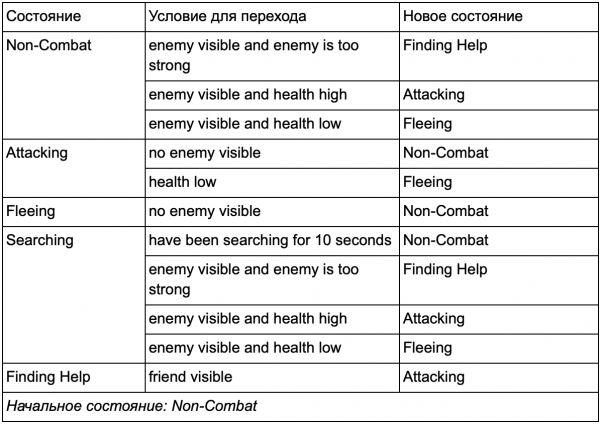
Gjendja jashtë beteje:
Dhe në formën e diagramit:
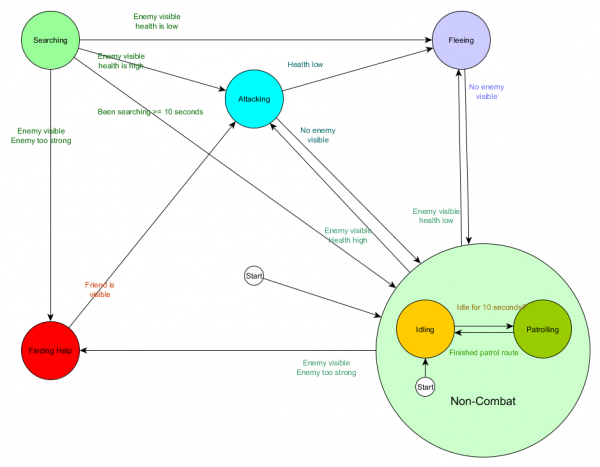
Kjo është e njëjta sistem, por me një gjendje të re jo-luftarake, e cila përfshin Idling dhe Patrolling. Me çdo gjendje që përmban FSM me nën-gjendje (dhe këto nën-gjendje, nga ana e tyre, përmbajnë FSM të veta - sa herë që t'ju nevojitet), ne marrim një Hierarchical Finite State Machine ose HFSM (makinë e mbyllur hierarkike). Duke grupuar gjendjen jo-luftarake, kemi eliminuar një mori kalimesh të tepërta. E njëjta gjë mund të bëhet për çdo gjendje të re me kalime të përbashkëta. Për shembull, nëse në të ardhmen zgjerimi i gjendjes Attacking në gjendjet MeleeAttacking dhe MissileAttacking, ato do të jenë nën-gjendje, duke kaluar nga njëra tek tjetra në bazë të distancës nga armiku dhe disponueshmërisë së municionit. Në përfundim, modelet e komplikuara të sjelljes dhe nën-modelet e sjelljes mund të paraqiten me një minimum kalimesh të përsëritura.
Pema e sjelljeve
Me HFSM krijohen kombinime komplekse të sjelljeve në mënyrë të thjeshtë. Megjithatë, ka një vështirësi të vogël, që marrja e vendimeve në formën e rregullave të kalimit lidhet ngushtë me gjendjen aktuale. Dhe në shumë lojëra, kjo është pikërisht ajo që ne na nevojitet. Dallimi i kujdesshëm në përdorimin e hierarkisë së gjendjeve mund të zvogëlojë numrin e përsëritjeve gjatë kalimit. Por ndonjëherë ne kemi nevojë për rregulla që funksionojnë në mënyrë të pavarur nga gjendja në të cilën ndodhemi ose që aplikohen në pothuajse çdo gjendje. Për shembull, nëse shëndeti i agjentit ka rënë në 25%, do të dëshironit që ai të arratisej pavarësisht nga se ishte në betejë, në një gjendje pasive apo në bisedë - do të duhet të shtoni këtë kusht në çdo gjendje. Dhe nëse dizajneri juaj më vonë dëshiron të ndryshojë pragun e shëndetit të ulët nga 25% në 10%, kjo do të kërkonte përsëri punë.
Idealisht, për këtë situatë nevojitet një sistem ku vendimet "në çfarë gjendje të jemi" janë jashtë vetë gjendjeve, për të bërë ndryshime vetëm në një vend dhe për të mos prekur kushtet e kalimit. Këtu dalin pemët e sjelljes.
Ka disa mënyra për t'i zbatuar ato, por thelbi për të gjitha është pak a shumë i njëjtë dhe i ngjashëm me pemën e vendimeve: algoritmi fillon nga nyja "rrënjore", ndërsa në pemë ka nyje që përfaqësojnë ose vendime, ose veprime. Megjithatë, ka disa dallime kyçe:
- Tani nyjet kthejnë një nga tre vlera: Succeeded (nëse puna është kryer), Failed (nëse nuk mund të nisë) ose Running (nëse ajo ende po ekzekutohet dhe nuk ka një rezultat përfundimtar).
- Nuk ka më nyje vendimesh për të zgjedhur midis dy alternativave. Në vend të tyre, ka nyje Decorator, të cilat kanë vetëm një nyjë fëmijë. Nëse ato arrijnë sukses, ato ekzekutojnë nyjën e tyre të vetme fëmijë.
- Nyjet që ekzekutojnë veprime kthejnë vlerën Running për të përfaqësuar veprimet që po kryhen.
Ky grup i vogël nyjesh mund të kombinohet për të krijuar një numër të madh modelesh të komplikuara të sjelljes. Le të paraqesim HFSM-në e rojeve nga shembulli i mëparshëm si një pemë sjelljeje:
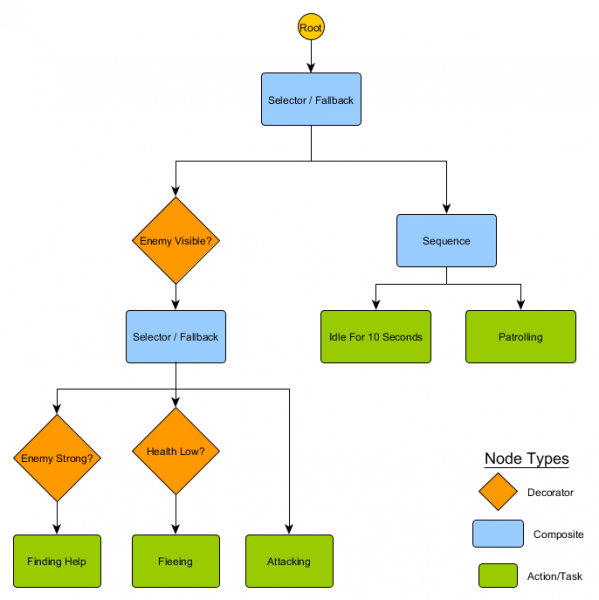
Me këtë strukturë nuk duhet të ketë një kalim të qartë nga gjendjet Idling/Patrolling në gjendjen Attacking ose në ndonjë tjetër. Nëse armiku është i dukshëm dhe shëndeti i personazhit është i ulët, ekzekutimi do të ndalet në nyjën Fleeing, pavarësisht se cila nyjë ka ekzekutuar më parë — Patrolling, Idling, Attacking, ose ndonjë tjetër.
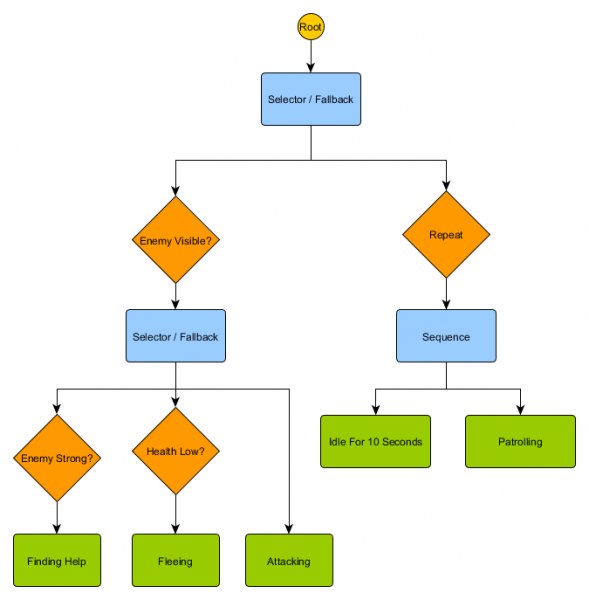
Pemët e sjelljeve janë komplekse — ka shumë mënyra për t'i përbërë ato, dhe gjetja e kombinimit të duhur të dekoratorëve dhe nyjeve përbërëse mund të jetë problematike. Ka gjithashtu pyetje rreth frekuencës së verifikimit të pemës — ne duam ta kalojmë atë çdo pjesë, ose vetëm kur ndonjë nga kushtet ndryshon? Si ta ruajmë gjendjen që lidhet me nyjet — si të dimë kur kemi qenë në gjendjen Idling për 10 sekonda ose si të dimë cilat nyje janë ekzekutuar herën e fundit, për të përpunuar saktë sekuencën?
Kjo është arsyeja pse ekzistojnë shumë implementime. Për shembull, në disa sisteme nyjet dekorator janë zëvendësuar nga dekoratorë të integruar. Ato rishikojnë përsëri pemën kur kushtet e dekoratorit ndryshojnë, ndihmojnë në bashkimin e nyjeve dhe sigurojnë përditësime periodike.
Sistemi i bazuar në utilitet
Disa lojërash kanë shumë mekanika të ndryshme. Është e preferueshme që ato të përfitojnë nga rregulla të thjeshta dhe të përgjithshme kalimi, por nuk është e domosdoshme në formën e një peme të plotë sjelljeje. Në vend që të kemi një grup të qartë zgjedhjesh ose një pemë veprimesh të mundshme, është më e thjeshtë të studiojmë të gjitha veprimet dhe të zgjedhim atë më të përshtatshmen në momentin aktual.
Sistemi i bazuar në dobishmëri (utility-based system) do të ndihmojë pikërisht në këtë. Është një sistem ku agjenti ka shumë veprime dhe ai vetë zgjedh se cilin të kryejë, duke u bazuar në dobishmërinë relative të secilit. Ku dobishmëria është një masë arbitrare e kësaj që është e rëndësishme ose e dëshirueshme për agjentin.
Dobishmërinë e llogaritur të veprimit, bazuar në gjendjen aktuale dhe mjedisin, agjenti mund ta verifikojë dhe të zgjedhë gjendjen tjetër më të përshtatshme në çdo kohë. Kjo është e ngjashme me FSM, përveç se kalimet përcaktohen nga vlerësimi për çdo gjendje potenciale, duke përfshirë gjendjen aktuale. Vini re se ne zgjedhim veprimin më të dobishëm për kalim (ose qëndrojmë, nëse e kemi kryer tashmë). Për më shumë larmi, kjo mund të jetë një zgjedhje e peshuar, por rastësore nga një listë e vogël.
Sistema caktinë një gamë të rastësishme vlerash dobishmërie — për shembull, nga 0 (krejtësisht e padëshirueshme) deri në 100 (plotësisht e dëshirueshme). Çdo veprim ka një sërë parametrash që ndikojnë në llogaritjen e kësaj vlere. Po kthehemi në shembullin tonë me rojen:
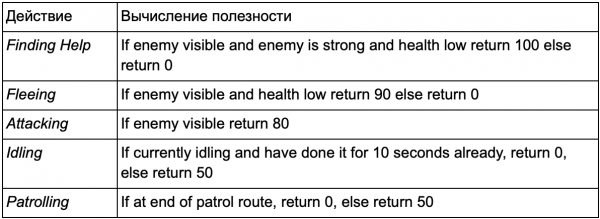
Kalimet midis veprimeve janë të paqartë — çdo gjendje mund të ndjekë çdo tjetër. Prioritetet e veprimeve ndodhen në vlerat e kthyera të dobishmërisë. Nëse armiku është i dukshëm dhe ky armik është i fortë, dhe shëndeti i personazhit është i ulët, atëherë Fleeing dhe FindingHelp do të kthejnë vlera të larta të padëshiruara. Në këtë rast, FindingHelp do të jetë gjithmonë më e lartë. Po ashtu, veprimet jo-luftuese kurrë nuk kthejnë më shumë se 50, kështu që ato gjithmonë do të jenë më të ulëta se ato luftuese. Kjo duhet marrë parasysh kur krijoni veprime dhe llogaritni dobishmërinë e tyre.
Në shembullin tonë, veprimet kthejnë ose një vlerë konstante fiksuar, ose një nga dy vlera fiksuara. Një sistem më realist parashikon kthimin e një vlerës nga një gamë e vazhdueshme vlerash. Për shembull, veprimi Fleeing kthen vlera më të larta të dobishmërisë nëse shëndeti i agjentit është i ulët, ndërsa veprimi Attacking kthen vlera më të ulta nëse armiku është shumë i fortë. Për këtë arsye, veprimi Fleeing ka prioritet mbi Attacking në çdo situatë kur agjenti ndjen se nuk ka mjaft shëndet për të fituar ndaj kundërshtarit. Kjo lejon ndryshimin e prioriteteve të veprimeve në bazë të një numri kriteresh, duke e bërë këtë qasje më fleksibile dhe variative se sa një pemë sjelljeje ose FSM.
Çdo veprim ka shumë kushte për llogaritjen e programit. Ato mund të shkruhen në një gjuhë skenari ose si një seri formulas matematikore. Në The Sims, e cila modelon rutinën e përditshme të karakterit, shtohet një nivel shtesë llogaritjesh — agjenti merr një sërë "motivacionesh" që ndikojnë në vlerësimet e dobishmërisë. Nëse karakteri është i uritur, me kalimin e kohës ai do të ndjehet edhe më i uritur, dhe rezultati i dobishmërisë së veprimit EatFood do të rritet derisa karakteri ta kryejë atë, duke ulur nivelin e urisë, dhe duke kthyer vlerën e EatFood në zero.
Ideja për të zgjedhur veprime bazuar në një sistem vlerësimi është mjaft e thjeshtë, prandaj sistemi i bazuar në dobishmëri mund të përdoret si një pjesë e proceseve të marrjes së vendimeve të AI, dhe jo si një zëvendësim i plotë i tyre. Pema e vendimit mund të kërkojë një vlerësim dobishmërie për dy nyje nënshkruese dhe të zgjedhë atë më të lartë. Në mënyrë të ngjashme, një pemë sjelljeje mund të ketë një nyje përbërëse Utility për të vlerësuar dobishmërinë e veprimeve për të vendosur se cili element nënshkruese të ekzekutohet.
Lëvizja dhe navigimi
Në shembujt e mëparshëm, kishim një platformë që e lëviznim majtas ose djathtas, dhe një roje që patrullonte ose sulmonte. Por si e trajtojmë lëvizjen e agjentit gjatë një periudhe të caktuar kohore? Si e vendosim shpejtësinë, si i shmangim pengesat, dhe si e planifikojmë rrugën, nëse është më e vështirë të arrijmë në destinacion sesa thjesht të lëvizim në një vijë të drejtpërdrejtë? Le të shqyrtojmë këtë.
Menaxhimi
Në fazën fillestare, le të supozojmë se çdo agjent ka një vlerë shpejtësie, e cila përfshin sa shpejt ai lëviz dhe në cilin drejtim. Ajo mund të matet në metra në sekondë, kilometra në orë, pikse në sekondë etj. Duke kujtuar ciklin Sense/Think/Act, mund të përfytyrojmë se pjesa Think zgjedh shpejtësinë, ndërsa pjesa Act e aplikon këtë shpejtësi te agjenti. Zakonisht në lojëra ka një sistem fizik që kryen këtë detyrë për ju, duke shqyrtuar vlerën e shpejtësisë së çdo objekti dhe duke e rregulluar atë. Prandaj, mund t'i lëmë AI-së një detyrë — të vendosë se cila shpejtësi duhet të ketë agjenti. Nëse dihet ku duhet të jetë agjenti, atëherë duhet ta lëvizim atë në drejtimin e duhur me shpejtësinë e vendosur. Një ekuacion shumë trivial:
desired_travel = destination_position – agent_position
Imagjinoni një botë 2D. Agjenti është në pikën (-2,-2), destinacioni ndodhet diku në veri-lindje në pikën (30, 20), dhe rruga e nevojshme për agjentin për t'u ndodhur aty është (32, 22). Le të supozojmë se këto pozita maten në metra — nëse e marrim shpejtësinë e agjentit si 5 metra në sekondë, ne do të bëjmë shkallëzimin e vektorit tonë të lëvizjes dhe do të marrim një shpejtësi të përafërt (4.12, 2.83). Me këto parametra, agjenti do të arrinte në destinacion pas gati 8 sekondash.
Vlerat mund të rivlerësohen në çdo moment. Nëse agjenti ishte në gjysmën e rrugës drejt qëllimit, lëvizja do të ishte gjysma e gjatësi, por pasi shpejtësia maksimale e agjentit është 5 m/s (këtë e vendosëm më sipër), shpejtësia do të mbetet e njëjtë. Kjo gjithashtu funksionon për objektivat në lëvizje, duke lejuar agjentin të bëjë disa ndryshime të vogla ndërsa ato lëvizin.
Por ne duam më shumë variacion — për shembull, të rrisim ngadalë shpejtësinë për të simuluar një karakter që lëviz nga një gjendje qëndruese në një gjendje vrapimi. E njëjta gjë mund të bëhet në fund para ndalimit. Këto karakteristika janë të njohura si steering behaviours, secila prej të cilave ka emra specifikë: Seek (kërkesa), Flee (ikja), Arrival (ardhja) etj. Ideja është se forcat e shpejtimit mund të aplikohen në shpejtësinë e agjentit, duke u bazuar në krahasimin e pozicionit të agjentit dhe shpejtësisë aktuale me pikën e destinacionit, për të përdorur mënyra të ndryshme për të arritur në qëllim.
Çdo sjellje ka një qëllim pak më ndryshe. Seek dhe Arrival janë mënyra për të lëvizur agjentin drejt destinacionit. Obstacle Avoidance (evitimi i pengesave) dhe Separation (ndarja) rregullojnë lëvizjen e agjentit për të shmangur pengesat në rrugën drejt qëllimit. Alignment (përputhja) dhe Cohesion (lidhja) mbajnë agjentët së bashku gjatë lëvizjes. Çdo numër sjelljesh të ndryshme drejtimi mund të mblidhet për të marrë një vektor rruge duke marrë parasysh të gjithë faktorët. Agjenti përdor sjelljet Arrival, Separation dhe Obstacle Avoidance për të qëndruar larg mureve dhe agjentëve të tjerë. Ky qasje funksionon mirë në vende të hapura pa detaje të tepruara.
Në kushte më të vështira, mbledhja e sjelljeve të ndryshme funksionon më keq - për shembull, agjenti mund të ngecë në mur për shkak të konfliktit mes Arrival dhe Obstacle Avoidance. Prandaj, duhen shqyrtuar mundësi që janë më komplekse se thjesht mbledhja e të gjithë vlerave. Një mënyrë e tillë është: në vend që të mbledhim rezultatet e çdo sjelljeje, mund të shqyrtojmë lëvizjen në drejtime të ndryshme dhe të zgjedhim opsionin më të mirë.
Megjithatë, në një ambient të ndërlikuar me rrugë të mbyllura dhe zgjedhje për në cilën anë të shkojmë, do na nevojitet diçka edhe më të avancuar.
Kërkimi i rrugës
Steering behaviours janë ideale për lëvizjen e thjeshtë në një terren të hapur (fushë futbolli ose arenë), ku të arrish nga A në B është një rrugë e drejtpërdrejtë me deviacion të vogla përtej pengesave. Për rrugë më komplekse na nevojitet pathfinding (kërkimi i rrugës), i cili është një mënyrë për të eksploruar botën dhe për të marrë vendime mbi rrugën përmes saj.
Metoda më e thjeshtë është të vendosësh një rrjet mbi çdo katror përreth agentit dhe të vlerësosh në cilat prej tyre është e lejuar të lëvizësh. Nëse ndonjëra prej tyre është destinacioni, atëherë ndiqni rrugën nga çdo katror deri te i mëparshmi, deri sa të arrini fillimin. Ky është itinerari. Në të kundërt, përsëritni procesin me katrorët më të afërt derisa të gjeni destinacionin ose të mbarojnë katrorët (kjo do të thotë se nuk ka asnjë rrugë të mundshme). Kjo formalitet quhet Kërkimi në Gjerësi ose BFS (Breadth-First Search). Në çdo hap, ai shqyrton në të gjitha drejtimet (prandaj gjerësia, „breadth“). Hapsira kërkuese duket si një front vale që lëviz, derisa të arrijë vendin e kërkuar — hapesira kërkuese zgjerohet në çdo hap deri sa të arrijë pikën përfundimtare, pas së cilës mund të ndjekim rrugën deri në fillim.
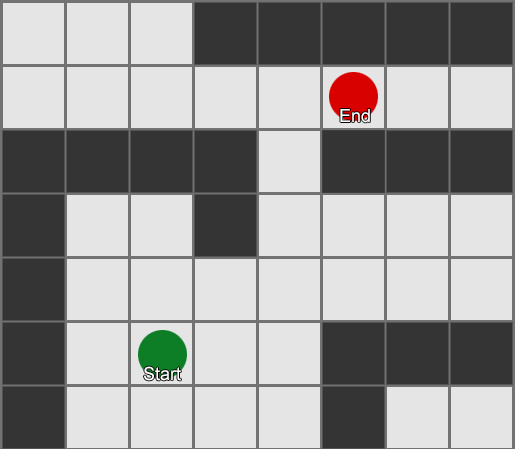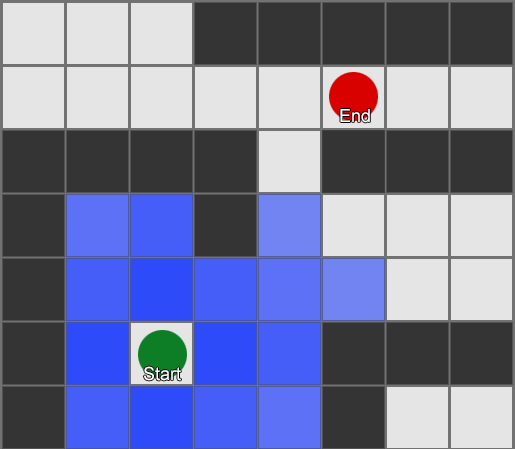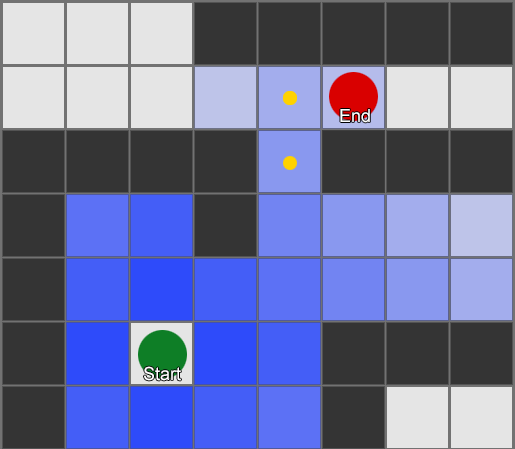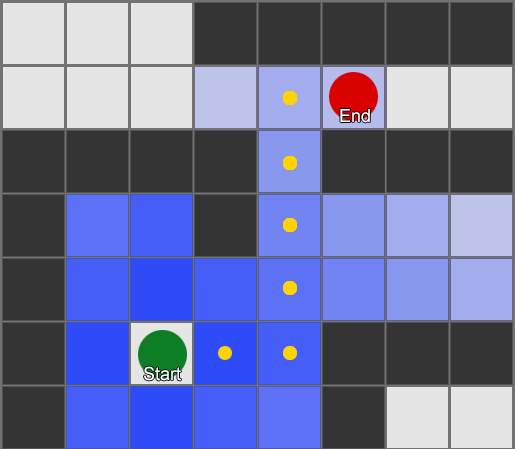
Si rezultat, do të keni një listë katrorësh, mbi të cilat formohet itinerari i dëshiruar. Kjo është rruga (nga këtu, pathfinding) — lista e vendeve që agjenti do të vizitojë, duke ndjekur për në destinacion.
Duke marrë parasysh se ne dimë pozitat e çdo katrori në botë, mund të përdorim sjelljet e manovrimeve për të lëvizur nëpër rrugë — nga nënkategoria 1 në nënkategorinë 2, pastaj nga nënkategoria 2 në nënkategorinë 3 dhe kështu me radhë. Versioni më i thjeshtë është të drejtohemi në qendër të katrorit të ardhshëm, por më mirë është të ndalemi në mes të skajit midis katrorit aktual dhe atij tjetër. Kështu, agjenti do të jetë në gjendje të shkurtojë këndet në kthesa të ashpra.
Algoritmi BFS ka disa disavantazhe — ai eksploron një numër të barabartë katrorësh në drejtimin "e gabuar" dhe në atë "të duhur". Këtu paraqitet një algoritëm më kompleks i quajtur A* (A star). Ai funksionon po ashtu, por në vend që të studiojë verbërisht katrorët fqinj (pastaj fqinjët e fqinjëve, pastaj fqinjët e fqinjëve të fqinjëve dhe kështu me radhë), ai mbledh nodet në një listë dhe i rendit ato kështu që nënkategoria që do të ekzaminon e ardhshme është gjithmonë ajo që do të çojë në itinerarin më të shkurtër. Nodalet renditen në bazë të heuristikës, e cila merr parasysh dy gjëra — "kostot" e itinerarit hipotetik për në katrorin e dëshiruar (duke përfshirë çdo kostum për lëvizje) dhe vlerësimin se sa larg është ky katror nga destinacioni (duke orientuar kërkimin në drejtimin e duhur).
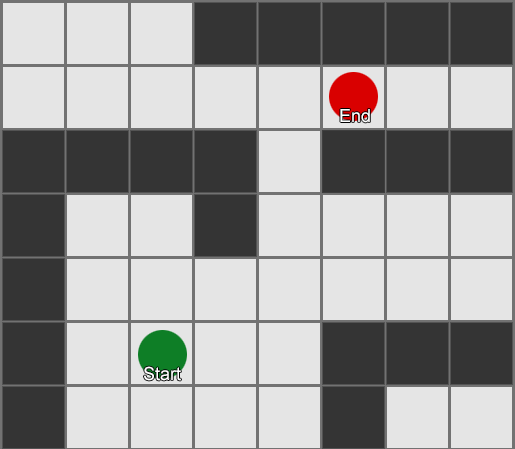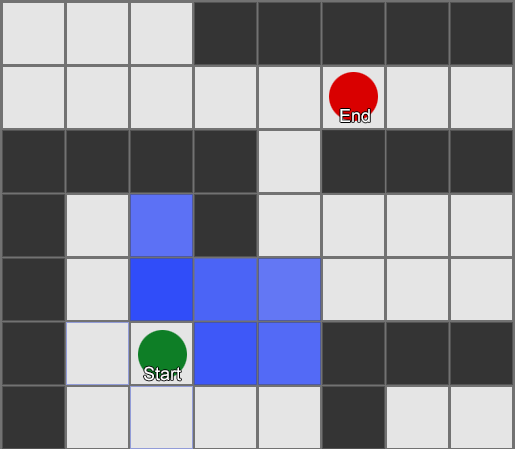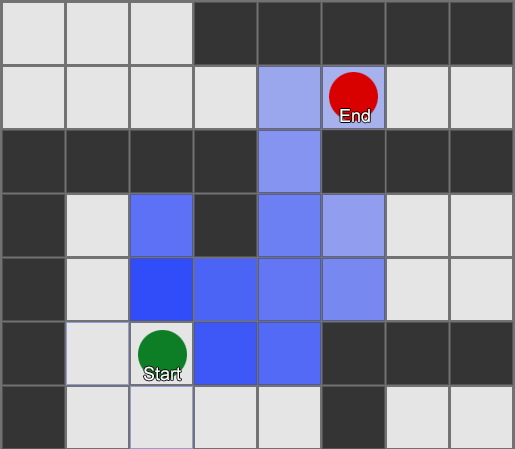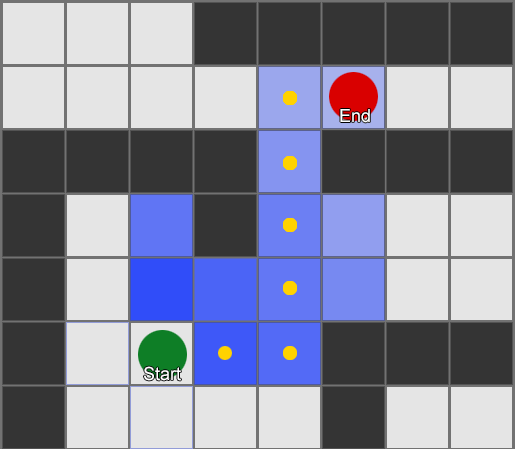
Në këtë shembull tregohet se agjenti eksploron katror për katror, duke zgjedhur çdo herë fqinjin më premtues. Rruga e marrë është e njëjtë si me BFS, por në proces janë shqyrtuar më pak katrorë — dhe kjo ka rëndësi të madhe për performancën e lojës.
Lëvizja pa rrjetë
Por shumica e lojërave nuk janë të rregulluara në një rrjetë dhe shpesh nuk është e mundur ta bësh atë pa dëmtuar realizmin. Kërkohen kompromiset. Cilat duhet të jenë përmasat e katrorëve? Tejshumë të mëdhenj — dhe ata nuk do të jenë në gjendje të paraqesin në mënyrë të saktë korridore të vogla ose kthesa, tejet të vegjël — do të ketë tepër shumë katrorë për t'u kërkuar, që përfundimisht do të marrë një mori kohë.
Gjithçka që duhet të kuptohet është se rrjeta na ofron një grafik të nyjeve të lidhura. Algoritmet A* dhe BFS në fakt funksionojnë mbi grafikat dhe nuk e shqetësojnë fare rrjetën tonë. Ne mund të vendosim nyjet kudo në botën e lojës: me lidhje ndërmjet çdo dy nyjash të lidhur, si dhe ndërmjet pikës fillestare dhe asaj përfundimtare dhe të paktën njërit nga nyjat — algoritmi do të funksionojë po aq mirë si më parë. Kjo shpesh quhet sistem pikash orientimi (waypoint), pasi çdo nyje përfaqëson një pozicion të rëndësishëm në botë, i cili mund të jetë pjesë e çdo numri hipotezash të mundshme.
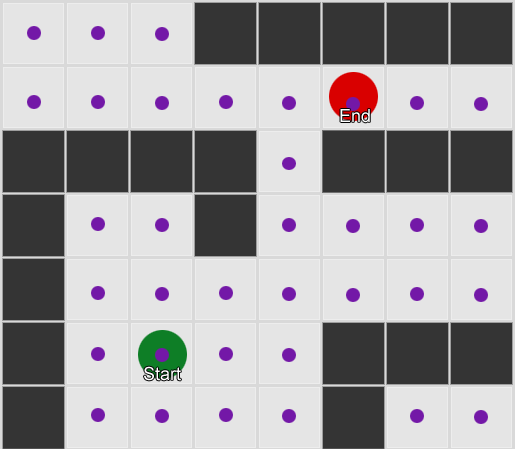
Shembulli 1: një nyje në çdo katror. Kërkimi fillon nga nyja ku ndodhet agjenti dhe përfundon në nyjen e katrorit të nevojshëm.
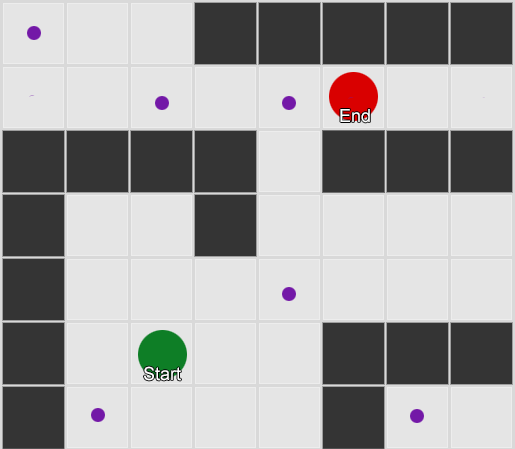
Shembulli 2: një grup më i vogël nyjesh (pikash orientimi). Kërkimi fillon në katrorin me agjentin, kalon përmes një numri të nevojshëm nyjesh, dhe më pas vazhdon deri në destinacion.
Kjo është një sistem mjaft fleksibël dhe i fuqishëm. Por kërkohet ndonjë kujdes në vendosjen e mënyrave të orientimit, ndryshe agjentët mund të mos arrijnë të shohin pikën më të afërt dhe të mos jenë në gjendje të fillojnë rrugën. Do të ishte më e lehtë nëse mund të vendosnim automatikisht pikat orientuese në bazë të gjeometrisë së botës.
Këtu hyn në lojë vetë rrjeta e navigimit ose navmesh. Kjo zakonisht është një rrjetë 2D e trekëndëshave që vendoset mbi gjeometrinë e botës — kudo ku agjentit i lejohet të ecë. Çdo trekëndësh në rrjetë bëhet një nyje në graf dhe ka deri në tre trekëndëshat fqinj që bëhen nyje fqinje në graf.
Kjo pikturë është një shembull nga motori Unity — ai analizoi gjeominë në botë dhe krijoi navmesh (në screenshot me ngjyrë të kaltër të lehtë). Çdo poligon në navmesh është një zonë ku agjenti mund të qëndrojë ose të lëvizë nga një poligon në tjetrin. Në këtë shembull, poligonet janë më të vogla se katet në të cilat ndodhen — kjo është bërë për të marrë parasysh dimensionet e agjentit, i cili do të kalonte përtej vendndodhjes së tij nominale.
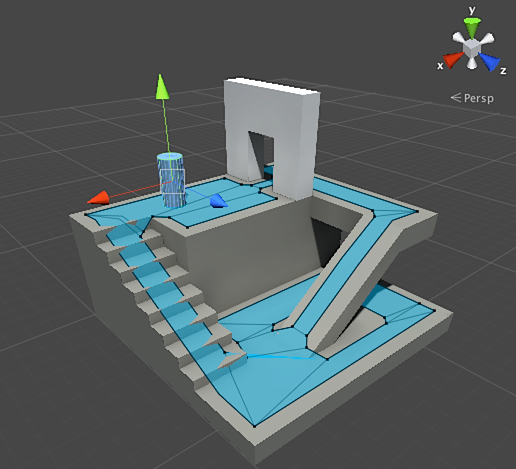
Ne mund të kërkojmë një rrugë përmes kësaj rrjete, duke përdorur përsëri algoritmin A*. Kjo do të na japë një rrugë praktikisht perfekte në botë, që merr parasysh gjithë gjeominë dhe nuk kërkon nyje të tepërta dhe krijimin e pikave të udhëtimit.
Gjetja e rrugës është një temë shumë e gjerë, për të cilën një seksion i vetëm artikulli nuk mjafton. Nëse dëshironi ta studioni atë më thellë, kjo do t'ju ndihmojë .
Planifikimi
Ne e kuptuam nga gjetja e rrugës se ndonjëherë nuk mjafton thjesht të zgjedhësh një drejtim dhe të lëvizësh — ne duhet të zgjedhim një rrugë dhe të bëjmë disa kthesa për të arritur në destinacionin e duhur. Ne mund ta përgjithësojmë këtë ide: arrijtja e qëllimit nuk është thjesht hapi tjetër, por një sekuencë e tërë, ku ndonjëherë kërkohet të shohim përpara disa hapa për të zbuluar si duhet të jetë hapi i parë. Kjo quhet planifikim. Gjetja e rrugës mund të konsiderohet si një nga disa shtesat e planifikimit. Nga perspektiva e ciklit tonë Sense/Think/Act, kjo është ajo ku pjesa Think planifikon disa pjesë nga Act për të ardhmen.
Le të analizojmë me shembullin e lojës së tavolinës Magic: The Gathering. Ne luajmë të parët me këtë set kartash në dorë:
- Swamp — ofron 1 manë të zezë (kartë toke).
- Forest — ofron 1 manë të gjelbër (kartë toke).
- Fugitive Wizard — kërkon 1 manë të blertë për të thirrur.
- Elvish Mystic — kërkon 1 manë të gjelbër për të thirrur.
Kartat e mbetura tre i injorojmë për ta bërë më të lehtë. Sipas rregullave, një lojtari i lejohet të luajë 1 kartë toke në hap, ai mund të "taps" këtë kartë për të nxjerrë manë, dhe pastaj të përdorë magji (përfshirë thirrjen e krijesave) sipas sasisë së manës. Në këtë situatë, lojtari-njeri e di se duhet të luajë Forest, "taps" 1 manë të gjelbër, dhe pastaj të thërrasë Elvish Mystic. Por si ta kuptojë kjo AI e lojës?
Planifikimi i thjeshtë
Qashtimi i thjeshtë — të provosh çdo veprim një nga një, derisa të mos mbetet asnjë i përshtatshëm. Duke parë kartat, AI sheh se mund të luajë Swamp. Dhe e luan. A kanë mbetur veprime të tjera në këtë raund? Ai nuk mund të thërrasë as Elvish Mystic, as Fugitive Wizard, pasi kërkohet mana përkatësisht e gjelbër dhe e kaltër për thirrjen e tyre, dhe Swamp jep vetëm mana të zezë. Dhe ai nuk do mund të luajë më Forest, sepse tashmë ka luajtur Swamp. Pra, AI luajti sipas rregullave, por e bëri keq. Mund të përmirësohet.
Planifikimi mund të gjejë një listë veprimesh që çojnë lojën në gjendjen e dëshiruar. Po ashtu, si çdo katror në rrugë kishte fqinjë (në pathfinding), çdo veprim në plan gjithashtu ka fqinjë ose pasardhës. Mund të kërkojmë këto veprime dhe veprime të ardhshme derisa të arrijmë gjendjen e dëshiruar.
Në shembullin tonë, rezultati i dëshiruar është «thirr një krijesë, nëse është e mundur». Në fillim të raundit ne shohim vetëm dy veprime të mundshme, të lejuara nga rregullat e lojës:
1. Të luajmë Swamp (rezultati: Swamp në lojë)
2. Të luajmë Forest (rezultati: Forest në lojë)
Çdo veprim i sjellë mund të çojë në veprime të tjera dhe të mbyllë disa të tjera, përsëri në varësi të rregullave të lojës. Përfytyroni, se luajmë Swamp — kjo do ta heqë Swamp si hapin e ardhshëm (ne tashmë e kemi luajtur), gjithashtu do ta heqë dhe Forest (për shkak se sipas rregullave mund të luash një kartë toke për raund). Pas kësaj, AI shton si hapin e ardhshëm — marrjen e 1 manas të zezë, sepse nuk ka opsione të tjera. Nëse ai vazhdon dhe zgjidh Tapping the Swamp, ai do të marrë 1 njësi mana të zezë dhe nuk do të mund të bëjë asgjë me të.
1. Të luajmë Swamp (rezultati: Swamp në lojë)
1.1 «Tapo» Swamp (rezultati: Swamp «tapohet», +1 njësi mana e zezë)
Nuk ka veprime të disponueshme – FUND
2. Të luajmë Forest (rezultati: Forest në lojë)
Lista e veprimeve doli e shkurtër, jemi në një kufi. Përsëritim procesin për veprimin tjetër. Ne luajmë Forest, hapim veprimin «merr 1 mana të gjelbër», i cili nga ana e tij do të hapë një veprim të tretë — thirrjen e Elvish Mystic.
1. Të luajmë Swamp (rezultati: Swamp në lojë)
1.1 «Tapo» Swamp (rezultati: Swamp «tapohet», +1 njësi mana e zezë)
Nuk ka veprime të disponueshme – FUND
2. Të luajmë Forest (rezultati: Forest në lojë)
2.1 «Tapo» Forest (rezultati: Forest «tapohet», +1 njësi mana e gjelbër)
2.1.1 Thirr Elvish Mystic (rezultati: Elvish Mystic në lojë, -1 njësi mana e gjelbër)
Nuk ka veprime të disponueshme – FUND
Më në fund, ne studiuam të gjitha veprimet e mundshme dhe gjetëm një plan për të thirrur një krijesë.
Ky është një shembull shumë i thjeshtuar. Preferohet të zgjidhni planin më të mirë të mundshëm, jo thjesht ndonjë që plotëson disa kritere. Në përgjithësi, është e mundur të vlerësohen planet e mundshme përmes rezultatit përfundimtar ose përfitimit të përgjithshëm nga realizimi i tyre. Mund të merrni 1 pikë për të luajtur një kartë toke dhe 3 pikë për të thirrur një krijesë. Të luani Swamp do të ishte një plan që jep 1 pikë. Ndërsa të luani Forest → Tap the Forest → thirrni Elvish Mystic do t'ju japë menjëherë 4 pikë.
Kështu funksionon planifikimi në Magic: The Gathering, por me të njëjtën logjikë kjo aplikohet edhe në situata të tjera. Për shembull, të zhvendosni një pion për të liruar hapësirë për të lëvizur një elefant në shah. Ose të strehoheni pas një muri për të shtënë në XCOM në mënyrë të sigurt. Në përgjithësi, ju kuptuat pikën.
Planifikimi i përmirësuar
Ngjashëm, ndonjëherë ka shumë veprime të mundshme për të shqyrtuar çdo variant të mundshëm. Duke u kthyer te shembulli i Magic: The Gathering: supozoni se në lojë keni disa karta toke dhe krijesash — numri i kombinimeve të mundshme të lëvizjeve mund të arrijë dhjetëra. Ekzistojnë disa zgjidhje për këtë problem.
Mënyra e parë është backwards chaining (formimi i zinxhirit në prapavijë). Në vend që të shqyrtoni të gjitha kombinimet, është më mirë të filloni nga rezultati përfundimtar dhe të provoni të gjeni një rrugë të drejtpërdrejtë. Në vend të rrugës nga rrënja e pemës në një gjethe të caktuar, ne lëvizim në drejtimin e kundërt — nga gjethe te rrënja. Kjo methode është më e thjeshtë dhe më e shpejtë.
Nëse armiku ka 1 pikë shëndeti, mund të gjeni një plan "të shkaktoni 1 ose më shumë pikë dëmi". Për ta arritur këtë, duhet të përmbushni një sërë kushtesh:
1. Dëmi mund të shkaktohet nga një magji — ajo duhet të jetë në dorë.
2. Për të hedhur magjinë — nevojitet mana.
3. Për të fituar mana — duhet të hedhni një kartë toke.
4. Për të hedhur një kartë toke — duhet ta keni atë në dorë.
Mënyra tjetër është best-first search (kerkimi më i mirë i parë). Në vend që të shqyrtoni të gjitha rrugët, ne zgjedhim më të përshtatshmen. Shpesh kjo metodë jep një plan optimal pa shpenzime të tepërta për kërkimin. A* është një formë e kerkimit më të mirë të parë — duke shqyrtuar rrugët më premtuese që nga fillimi, ai mund të gjejë rrugën më të mirë pa pasur nevojë të shqyrtojë opsionet e tjera.
Një variant interesant dhe gjithnjë e më i popullarizuar i kërkimit best-first është Kërkimi i Pemës së Monte Carlo. Në vend që të hamendësojë se cilat plane janë më të mirat për veprimin e ardhshëm, algoritmi zgjedh pasardhës të rastësishëm në çdo hap, derisa të arrijë fundin (kur plani çon në fitore ose humbje). Pastaj, rezultati përfundimtar përdoret për të rritur ose ulur vlerësimin "peshës" së mundësive të mëparshme. Duke e përsëritur këtë proces disa herë, algoritmi jep një vlerësim të mirë se cili hap tjetër është më i mirë, madje edhe nëse situata ndryshon (nëse kundërshtari merr masa për t'i penguar lojtarin).
Në tregimin e planifikimit në lojëra, nuk mund të anashkalohet Planifikimi i Veprimeve të Orientuara ndaj Qëllimeve ose GOAP. Ky është një metodë e përdorur gjerësisht dhe e diskutuar, por përveç disa detajeve dalluese, është në thelb një metodë e zinxhirit të prapë, për të cilën folëm më parë. Nëse detyra ishte "shkatërro lojtarin", dhe lojtarit i ka qëlluar pas një mbrojtjeje, plani mund të jetë: shkatërro me një granatë → merr atë → hedh.
Zakonisht ka disa qëllime, secili me përparësinë e tij. Nëse qëllimi me përparësi më të lartë nuk mund të realizohet (nuk ka asnjë kombinim veprimesh që krijon planin "shkatërro lojtarin", sepse lojtarit nuk i shihet), AI do të kthehet te qëllimet me përparësi më të ulët.
Mësimi dhe adaptimi
Kemi diskutuar tashmë se AI i lojërave zakonisht nuk përdor mësimin e makinerive, sepse kjo nuk është e përshtatshme për menaxhimin e agjentëve në kohë reale. Por kjo nuk do të thotë që nuk mund të merret ndonjëherë diçka nga ky fushë. Ne duam një kundërshtar në një lojë aksionesh nga i cili mund të mësojmë ndonjë gjë. Për shembull, të mësojmë për pozitat më të mira në hartë. Ose një kundërshtar në një luftë që do të bllokonte kombinimet e zakonshme të lojtarit, duke e motivuar atë të përdorë të tjera. Pra, mësimi i makinerive në këto situata mund të jetë shumë i dobishëm.
Statistikat dhe probabilitetet
Para se kalojmë në shembuj të komplikuar, le të shqyrtojmë se sa larg mund të shkojmë duke marrë disa matje të thjeshta dhe duke i përdorur ato për të marrë vendime. Për shembull, strategjia në kohë reale — si mund ta përcaktojmë nëse një lojtar mund të nisë një sulm në minutat e para të lojës dhe çfarë mbrojtjeje do të përgatisim për këtë? Mund të studiojmë përvojën e kaluar të lojtarit për të kuptuar se çfarë mund të jetë reagimi i tij në të ardhmen. Së pari, na mungojnë këto të dhëna të plota, por ne mund t'i mbledhim ato — çdo herë që AI luan kundër një njeriu, ai mund të regjistrojë kohën e sulmit të parë. Pas disa sesionesh, do të marrim mesataren e kohës që lojtarët do të sulmojnë në të ardhmen.
Mesataret kanë edhe një problem: nëse një lojtar ka ‘rush-uar’ 20 herë dhe ka luajtur ngadalë 20 herë të tjera, atëherë vlerat e nevojshme do të jenë diku në mes, që nuk do na ofrojë asgjë të dobishme. Një nga zgjidhjet është kufizimi i të dhënave hyrëse — mund të merret parasysh vetëm 20 të fundit.
Një qasje e ngjashme përdoret për të vlerësuar probabilitetin e veprimeve të caktuara, duke supozuar se preferencat e kaluara të lojtarit do të jenë të ngjashme në të ardhmen. Nëse një lojtar na sulmon pesë herë me topa zjarri, dy herë me rrufe dhe një herë me duar, është e qartë se ai preferon topin e zjarrit. Ne mund ta ekstrapolojmë dhe të shohim probabilitetin e përdorimit të armëve të ndryshme: topi i zjarrit=62.5%, rrufe=25% dhe duar-shqip=12.5%. AI ynë i lojës duhet të përgatitet për mbrojtje nga zjarri.
Një metodë interesante tjetër është të përdorim Naive Bayes Classifier (klasifikuesi naiv Bayes) për të studiuar sasi të mëdha të të dhënave hyrëse dhe për të klasifikuar situatën, në mënyrë që AI të reagojë siç duhet. Klasifikuesit Bayesian janë të njohur për përdorimin e tyre në filtre të spamit të emailit. Aty ata analizojnë fjalët, i krahasojnë ato me vendet ku janë shfaqur këto fjalë më parë (në spam apo jo) dhe nxjerrin përfundime për email-et hyrëse. Ne mund të bëjmë të njëjtën gjë edhe me më pak të dhëna hyrëse. Në bazë të gjithë informacionit të dobishëm që sheh AI (p.sh., cilat njësi armike janë krijuar, apo cilat magji po përdorin, apo cilat teknologji po studiojnë), dhe rezultatin përfundimtar (luftë ose paqe, ‘rush’ ose mbrojtje, etj.) — ne do të zgjedhim comportimin e duhur të AI.
Të gjitha këto metoda të mësimit janë të mjaftueshme, por është e dëshirueshme t'i përdorim ato në bazë të të dhënave nga testimi. AI do të mësojë të adaptohet me strategjitë e ndryshme që kanë përdorur testuesit tuaj. Një AI që adaptohet me lojtarin pas lansimit mund të bëhet tepër i parashikueshëm ose, nga ana tjetër, shumë i vështirë për t'u mposhtur.
Adaptimi në bazë të vlerave
Duke marrë parasysh përmbajtjen e botës sonë loje dhe rregullat, ne mund të ndryshojmë setin e vlerave që ndikojnë në vendimmarrje, në vend që të përdorim thjesht të dhënat hyrëse. Veprojmë kështu:
- Le të mbledhë AI të dhëna rreth gjendjes së botës dhe ngjarjeve kyçe gjatë lojës (siç është përmendur më sipër).
- Do të ndryshojmë disa vlera të rëndësishme në bazë të këtyre të dhënave.
- Do të zbatojmë vendimet tona, të bazuara në përpunimin ose vlerësimin e këtyre vlerave.
Për shembull, një agjent ka disa dhoma për të zgjedhur në një hartë të një loje tirane nga perspektiva e parë. Çdo dhomë ka vlerën e saj, e cila përcakton sa të dëshiruara janë për tu vizituar. AI zgjedh rastësisht se në cilën dhomë të shkojë, në bazë të vlerës së saj. Më pas, agjenti e mban mend në cilën dhomë e vranë dhe ndalon vlerën e saj (probabiliteti që ai do të kthehet atje). Po ashtu në situatën e kundërt — nëse agjenti shkatërron shumë kundërshtarë, atëherë vlera e dhomës rritet.
Modeli Markov
Çfarë ndodh nëse ne përdorim të dhënat e mbledhura për parashikim? Nëse mbajmë mend çdo dhomë ku shohim lojtarin gjatë një periudhe të caktuar kohore, ne do të parashikojmë në cilën dhomë mund të kalojë lojtarin. Duke ndjekur dhe regjistruar lëvizjet e lojtarit nëpër dhoma (vlerat), ne mund të parashikojmë ato.
Le të marim tre dhoma: të kuqe, të gjelbra dhe të blu. Po ashtu dhe vëzhgimet që kemi regjistruar gjatë shikimit të sesionit të lojës:
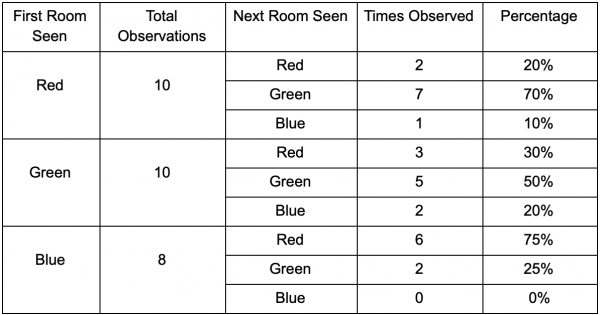
Numri i vëzhgimeve për secilën dhomë është pothuajse i barabartë — ende nuk e dimë ku të bëjmë një vend të mirë për tendë. Grumbullimi i statistikave gjithashtu komplikohet nga rihapjet e lojtarëve, të cilët shfaqen në mënyrë të barabartë në të gjithë hartën. Por të dhënat mbi dhomën e ardhshme, në të cilën ata hyjnë pas shfaqjes në hartë — tashmë janë të dobishme.
Është evidente se dhoma e gjelbër i kënaq lojtarët - shumica e njerëzve nga dhoma e kuqe kalojnë në të, 50% e të cilëve qëndrojnë atje më tej. Përkundrazi, dhoma blu nuk gëzon popullaritet, thuajse nuk vizitohet, dhe nëse vizitohet, atëherë nuk qëndrohet aty.
Por të dhënat na tregojnë diçka më të rëndësishme - kur lojtari ndodhet në dhomën blu, dhoma tjetër ku ne do ta shohim zakonisht është e kuqe, dhe jo e gjelbër. Edhe pse dhoma e gjelbër është më popullore se ajo e kuqe, situata ndryshon nëse lojtari ndodhet në blu. Shteti tjetër (domethënë dhoma në të cilën lojtari do të kalojë) varet nga gjendja e mëparshme (domethënë dhoma në të cilën ndodhet tani lojtari). Për shkak të hulumtimit të varësive, ne do të bëjmë parashikime më të sakta sesa po të numëronim thjesht observimet në mënyrë të pavarur.
Parashikimi i gjendjes së ardhshme mbi bazën e të dhënave të gjendjes së kaluar quhet modeli Markov (Markov model), dhe ato shembuj (me dhomat) quhen zinxhirë Markov. Duke qenë se modelet përfaqësojnë probabilitetin e ndryshimeve mes gjendjeve të njëpasnjëshme, ato paraqiten vizualisht si FSM me probabilitet rreth çdo kalimi. Më parë ne kemi përdorur FSM për të përfaqësuar gjendjen e sjelljes në të cilën ndodhej agjenti, por kjo koncept bëhet e aplikueshme në çdo gjendje, pavarësisht se a është kjo e lidhur me agjentin apo jo. Në këtë rast, gjendjet përfaqësojnë dhomën që zë agjenti:
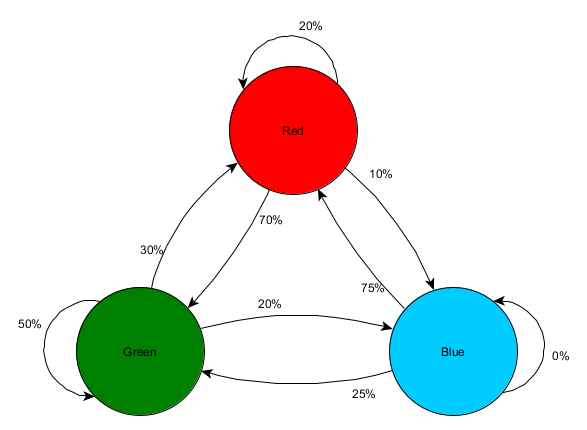
Ky është një variant i thjeshtë për të paraqitur probabilitetin relativ të ndryshimeve të gjendjeve, duke i dhënë AI një mundësi për të parashikuar gjendjen e ardhshme. Mund të parashikohet disa hapa përpara.
Nëse lojtari është në dhomën e gjelbër, ka një 50% mundësi që ai të qëndrojë atje në vëzhgimin e ardhshëm. Por cila është probabiliteti që ai të jetë ende aty edhe më vonë? Ka jo vetëm mundësinë që lojtari të mbetet në dhomën e gjelbër pas dy vëzhgimeve, por edhe një mundësi që ai ka dalë dhe është kthyer. Këtu është një tabelë e re duke marrë parasysh të dhënat e reja:
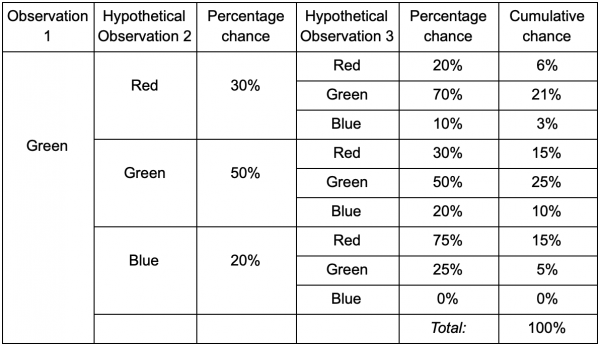
Nga kjo duket se mundësia për të parë lojtarin në dhomën e gjelbër pas dy vëzhgimeve do të jetë 51% - 21% që ai do të vijë nga dhoma e kuqe, 5% nga ata që lojtari do të vizitojë dhomën blu midis tyre, dhe 25% që lojtari nuk do të largohet nga dhoma e gjelbër fare.
Tabeli është thjesht një mjet vizual – procedura kërkon vetëm shumëzimin e probabiliteteve në çdo hap. Kjo do të thotë se mund të shikoni thellë në të ardhmen me një rezervë: ne supozojmë se shansi për të hyrë në dhomë varet plotësisht nga dhoma aktuale. Kjo quhet pronësia Markoviane (Markov Property) – gjendja e ardhshme varet vetëm nga e tashmja. Por kjo nuk është plotësisht e saktë. Lojtarët mund të ndryshojnë vendimet e tyre në varësi të faktorëve të tjerë: niveli i shëndetit ose sasia e municioneve. Duke qenë se ne nuk i regjistrojmë këto vlera, parashikimet tona do të jenë më pak të sakta.
N-Grams
Dhe çfarë ndodh me shembullin e luftimeve dhe parashikimin e kombo-ve të lojtarit? E njëjta gjë! Por në vend të një gjendje ose ngjarjeje, do të studiojmë tërë sekuenca, nga të cilat përbëhet kombo-shkalla.
Një nga mënyrat për ta bërë këtë është të ruani çdo input (p.sh., Kick, Punch ose Block) në një bufer dhe të regjistroni të gjithë buferin si një ngjarje. Pra, lojtari shtyp vazhdimisht Kick, Kick, Punch për të përdorur sulmin SuperDeathFist, sistemi i AI ruan të gjitha inputet në bufer dhe mban mend tre të fundit, që përdoren në çdo hap.
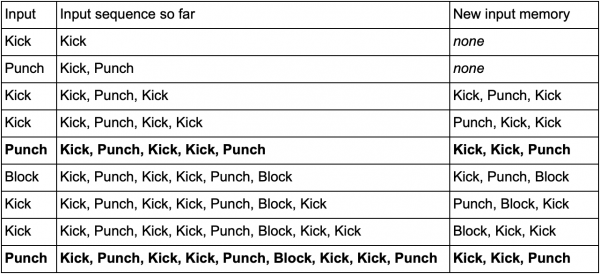
(Me bold janë theksuar rreshtat kur lojtari aktivizon sulmin SuperDeathFist.)
AI do të shohë të gjitha variantet kur lojtari zgjodhi Kick, më pas një tjetër Kick, dhe më pas do të vërë re se inputi i ardhshëm është gjithmonë Punch. Kjo do t'i lejojë agjentit të parashikojë kombo-sulmin SuperDeathFist dhe ta bllokojë atë, nëse është e mundur.
Këto sekuenca ngjarjesh quhen N-grama (N-grams), ku N është numri i elementeve të ruajtur. Në shembullin e mëparshëm ishte një 3-gramë (trigramë), që do të thotë: dy regjistrimet e para përdoren për të parashikuar të tretën. Pra, në një 5-gramë, katër regjistrimet e para parashikojnë të pestën dhe kështu me radhë.
Zhvilluesi duhet të zgjedhë me kujdes madhësinë e N-gramave. Një numër më i vogël N kërkon më pak kujtesë, por gjithashtu ruan një histori më të vogël. Për shembull, një 2-gramë (bigramë) do të regjistronte Kick, Kick ose Kick, Punch, por nuk do të mundte të ruante Kick, Kick, Punch, kështu që AI nuk do të reagonte ndaj kombo-sulmit SuperDeathFist.
Nga ana tjetër, numrat më të mëdhenj kërkojnë më shumë kujtesë dhe AI do të ketë më shumë vështirësi në mësim, pasi do të ketë shumë më tepër variante të mundshme. Nëse kishte tre inpute të mundshme Kick, Punch ose Block, dhe ne përdorim një 10-gramë, do të rezultonte rreth 60 mijë variante të ndryshme.
Modeli i bigramit është një zinxhir i thjeshtë Markov — çdo çift 'shteti i kaluar/shteti aktual' është një bigram, dhe ju mund të parashikoni shtetin e dytë në bazë të atij të parë. Trigrami dhe bigramet më të mëdha gjithashtu mund të shqyrtohen si zinxhirë Markov ku të gjitha elementet (përveç elementit të fundit në N-gramë) së bashku formojnë shtetin e parë, ndërsa elementi i fundit është i dyti. Një shembull me luftim tregon shansin e kalimit nga shteti Kick dhe Kick në shtetin Kick dhe Punch. Duke parë disa regjistra të historikut të hyrjes si një njësi, ne, në thelb, transformojmë sekuencën e hyrjes në pjesë të një gjendjeje të tërë. Kjo na jep pronën Markov që na lejon të përdorim zinxhirët Markov për të parashikuar hyrjen e ardhshme dhe të hamendsojmë se cili do të jetë lëvizja tjetër e kombos.
Përfundim
Diskutuam për mjetet dhe qasjet më të zakonshme në zhvillimin e inteligjencës artificiale. Gjithashtu shqyrtuam situatat në të cilat duhet t'i aplikojmë ato dhe ku janë veçanërisht të dobishme.
Kjo duhet të jetë e mjaftueshme për të kuptuar gjërat themelore në inteligjencën artificiale të lojrave. Por, sigurisht, kjo nuk është të gjitha metodat. Disa që janë më pak popullore, por po aq efektive janë:
- algoritmet për optimizim, duke përfshirë ngjitjen në kodrina, zbritjen gradiente dhe algoritmet gjenetike
- algoritmet konkuruese të kërkimit/planifikimit (minimax dhe alfa-beta pruning)
- metodat e klasifikimit (perceptonët, rrjetet neuronale dhe makinat e dhezjes së mbështetjes)
- sistemet për përpunimin e perceptimit dhe memories së agjentëve
- qasjet arkitekturore në AI (sistemet hibride, nëngrupet e arkitekturave dhe mënyra të tjera për të mbivendosur sistemet e AI)
- mjetet e animacionit (planifikimi dhe koordinimi i lëvizjes)
- faktorët e performancës (niveli i detajeve, algoritmet e çdo kohe, dhe ndarjen e kohës)
Burimet në internet mbi temën:
1. Në GameDev.net ka , si dhe .
2. ka shumë prezantime dhe artikuj mbi një gamë të gjerë lidhur me zhvillimin e AI të lojrave.
3. përfshin tema nga samiti GDC AI, shumë prej të cilave janë të disponueshme falas.
4. Materialet e dobishme gjithashtu mund të gjenden në faqen .
5. Tommy Thompson, një kërkues i AI dhe zhvillues lojërash, bën video në kanalin e YouTube me shpjegime dhe studime të AI në lojrat komerciale.
Libra mbi temën:
1. Seria e librave Game AI Pro përbën koleksione artikujsh të shkurtër që shpjegojnë si të realizoni funksione specifike ose si të zgjidhni probleme specifike.
2. Seria e AI Game Programming Wisdom — paraardhës i serisë Game AI Pro. Ajo përmban metoda më të vjetra, por pothuajse të gjitha janë ende të rëndësishme edhe sot.
3. — është një nga tekstet bazë për të gjithë ata që dëshirojnë të kuptojnë fushën e përgjithshme të inteligjencës artificiale. Ky libër nuk ka të bëjë me zhvillimin e lojërave — ai mëson bazat e inteligjencës artificiale.
Burimi: habr.com
