

Kompani të mëdha që merren me zhvillimin në fushën e mësimit të makinerive kanë paraqitur projektin OpenXLA, i cili synon zhvillimin e përbashkët të mjeteve për kompilimin dhe optimizimin e modeleve për sistemet e mësimit të makinerive. Nën mbrojtjen e projektit, u transferua zhvillimi i mjeteve që lejojnë unifikimin e kompilimit të modeleve, të përgatitura në kornizat TensorFlow, PyTorch dhe JAX, për trajnim dhe ekzekutim efikas në GPU të ndryshëm dhe përshpejtues të specializuar. Në këtë projekt janë angazhuar kompani si Google, NVIDIA, AMD, Intel, Meta, Apple, Arm, Alibaba dhe Amazon.
Pritet që falë bashkimit të përpjekjeve të ekipeve lider për hulumtim dhe përfaqësuesve të komunitetit të arrihet të stimulohet zhvillimi i sistemeve të mësimit të makinerive dhe të zgjidhet problemi i fragmentimit të infrastrukturës për kornizat dhe pajisjet e ndryshme. OpenXLA lejon realizimin e mbështetjes efektive për pajisje të ndryshme, pa marrë parasysh se mbi cilën kornizë është ndërtuar modeli i mësimit të makinerive. Pritet që me OpenXLA të arrihet të reduktohet koha e trajnimit të modeleve, të rritet kapaciteti i kalimit, të zvogëlohen vonesat, të ulen kostot për burimet kompjuterike dhe të shkurtohet koha e nxjerrjes së produktit në treg.
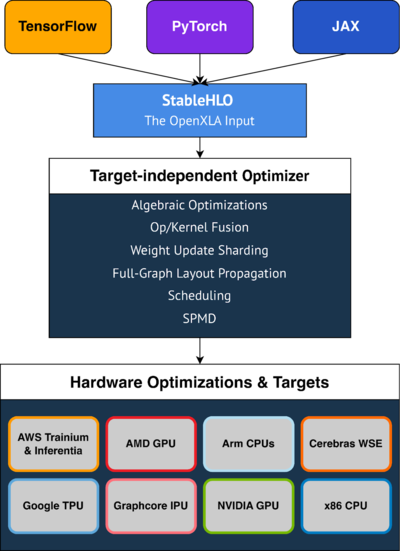
OpenXLA përbëhet nga tre komponentë kryesorë, kodi i të cilëve shpërndahet nën licencën Apache 2.0:
- XLA (Accelerated Linear Algebra) — një kompajler që lejon optimizimin e modeleve të mësimit të makinerive për ekzekutimin e lartë në platforma të ndryshme harduerike, duke përfshirë GPU, CPU dhe përshpejtues të specializuar nga prodhues të ndryshëm.
- StableHLO — specifikimi dhe implementimi bazë i një grupi operacioneve me nivel të lartë (HLO, High-Level Operations) për t’u përdorur në modelet e sistemeve të mësimit të makinerive. Vepron si një ndërfaqe midis kornizave të mësimit të makinerive dhe kompajlerëve që ndërrjnë modelin për ekzekutim në harduerin specifik. Ndërfaqet për gjenerimin e modeleve në formatin StableHLO janë përgatitur për kornizat PyTorch, TensorFlow dhe JAX. Si bazë për StableHLO është përdorur grupi MHLO, i cili është zgjeruar me mbështetje për serializimin dhe versionimin.
- IREE (Mjedisi i Ekzekutimit të Përfaqësimit të Mesëm) — një kompilator dhe runtime që transformon modelet e mësimit të makinerive në një përfaqësim të përbashkët të ndërmjetëm, të bazuar në formatin MLIR (Përfaqësimi Ndërmjetës në Nivel të Shumëfishtë) nga projekti LLVM. Pjesa dalluese është mundësia e kompilimit paraprak (ahead-of-time), mbështetje për menaxhimin e rrjedhës, mundësia e përdorimit të elementeve dinamike në modele, optimizimi për CPU dhe GPU të ndryshme, dhe shpenzime të ulëta të mbështetjes.
Përfitimet kryesore të instrumentit OpenXLA:
- Arrihni performancën optimale pa qenë e nevojshme të thellohem në shkrimin e kodit të specializuar për pajisje të caktuara. Ofrimi i optimizimeve të gatshme, që përfshijnë thjeshtimin e shprehjeve algebraike, vendosjen efikase në memorie, planifikimin e ekzekutimit duke marrë parasysh reduktimin e pikëve maksimale të konsumit të memories dhe mbingarkesave.
- Thjeshtimi i skalimit dhe paralelizimit të llogaritjeve. Programuesi duhet vetëm të shtojë annotimet për një nëngrup kritik të tensoreve, mbi të cilat kompilatori mund të gjenerojë automatikisht kodin për llogaritje paralele.
- Sigurimi i portabilitetit përmes mbështetjes së platformave të ndryshme harduerike, si GPU AMD dhe NVIDIA, CPU të bazuara në arkitekturën x86 dhe ARM, përshpejtuesit ML TPU të Google, IPU AWS Trainium Inferentia, Graphcore dhe Cerebras Wafer-Scale Engine.
- Mbështetje për lidhjen e zgjerimeve me implementimin e mundësive të tjera, si mbështetje për shkrimin e primitiveve të mësimit të thellë me përdorimin e CUDA, HIP, SYCL, Triton dhe gjuhëve të tjera për llogaritjet paralele. Mundësia e rregullimit manual të ngushticave në modele.
Burimi: opennet.ru
