

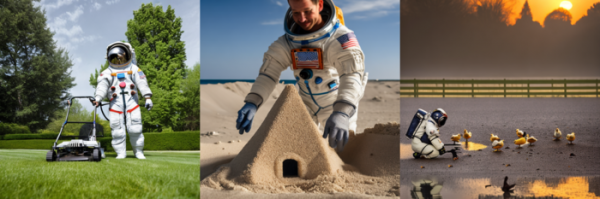
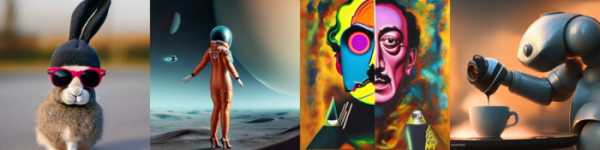
Kompania Stability AI publikoi edicionin e dytë të sistemit të mësimit të makinerive Stable Diffusion, i aftë për të sintetizuar dhe ndryshuar imazhe bazuar në një model të dhënë ose përshkrim tekstual në gjuhën natyrore. Kodi i mjeteve për trajnimin e rrjetit neural dhe gjenerimin e imazheve është shkruar në gjuhën Python duke përdorur kuadrin PyTorch dhe është publikuar nën licencën MIT. Modelet e trajnimit tashmë janë të hapura nën licencën e lejuar Creative ML OpenRAIL-M, e cila lejon përdorimin për qëllime komerciale. Gjithashtu është në dispozicion një gjenerator imazhesh online për demonstrim.
Përmirësimet kryesore në edicionin e ri të Stable Diffusion:
- Është krijuar një model i ri i sintetizimit të imazheve sipas përshkrimit tekstual — SD2.0-v, i cili mbështet gjenerimin e imazheve me rezolucion 768×768. Modeli i ri është trajnuar me koleksionin LAION-5B, i cili përfshin 5.85 miliard imazhesh me përshkrime tekstuale. Modeli përdor të njëjtin set parametrash si modeli Stable Diffusion 1.5, por ndryshon me kalimin në përdorimin e një kodifikuesi tërësisht të ndryshëm OpenCLIP-ViT/H, që ka lejuar përmirësimin e ndjeshëm të cilësisë së imazheve përfundimtare.

- Është përgatitur një variant i thjeshtuar SD2.0-base, i trajnuar në imazhe 256×256 duke përdorur modelin klasik të parashikimit të zhurmës dhe mbështet gjenerimin e imazheve me rezolucion 512×512.

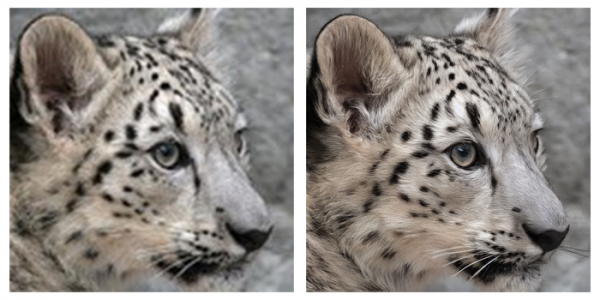
- Është ofruar mundësia e përdorimit të teknologjisë së super-sampling (Super Resolution) për të rritur rezolucionin e imazhit fillestar pa ulur cilësinë, duke përdorur algoritme të shkallëzimit hapësinor dhe rindërtimit të detajeve. Modeli i ofruar për përpunimin e imazheve (SD20-upscaler) mbështet rritjen katërfish, e cila lejon formimin e imazheve me rezolucion 2048×2048.

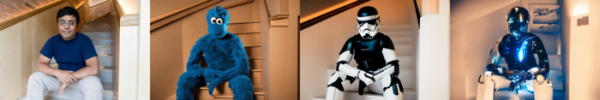
- Është propozuar modeli SD2.0-depth2img, i cili merr parasysh thellësinë dhe vendndodhjen hapësinore të objekteve. Për vlerësimin monokular të thellësisë, përdoret sistemi MiDaS. Modeli lejon që të sintetizohen imazhe të reja, duke përdorur një imazh tjetër si model, të cilat mund të ndryshojnë rrënjësisht nga origjinali, por të ruajnë kompozitën dhe thellësinë e përgjithshme. Për shembull, mund të përdoret pozita e një personi në foto për të formuar një karakter tjetër në të njëjtën pozë.


- Modeli për modifikimin e imazheve është azhurnuar - SD 2.0-inpainting, e cila lejon, me ndihmën e sugjerimeve tekstuale, të zëvendësojë dhe ndryshojë pjesë të imazhit.
- Janë optimizuar modelet për përdorim në sisteme standarde me një GPU.
Burimi: opennet.ru
